CUDA for AMD on Windowsとは何か ZLUDA+HIP/ROCmでAMD GPUにCUDAアプリを動
かす仕組みと手順
Hacker Newsで135ポイントを集めたSpeedstu/CUDA-for-AMD-Windowsを解説。ZLUDA+AMD HIP/ROCmでWindows上のCUDA向けアプリをAMD GPUで動かす再現可能なセットアップの仕組み、検証済みGPU、インストール手順、動くもの・動かないもの、ZLUDA単体やDirectMLなど他手段との違いを整理する。
CUDA for AMD on Windowsとは何か
CUDA for AMD on Windows(GitHub: Speedstu/CUDA-for-AMD-Windows)は、Windows上でCUDA向けに作られたアプリケーションを、NVIDIA GPUなしでAMD GPU上で実行するための「再現可能なセットアップ一式」である。中身はZLUDA(CUDAドライバAPI互換層)とAMDのHIP SDK/ROCmライブラリを組み合わせたスクリプト集で、CUDA対応のLibTorchを使うワークロードなどを主なターゲットにしている。2026年9月にHacker Newsのフロントページに掲載され135ポイント・68コメントを集めた(本文中の数値はいずれも2026年9月14日時点の確認)。
何ができるか — 検証済みの範囲
READMEが明言している通り、このプロジェクトは「すべてのCUDAプログラムやAIモデルが動く」ことを保証するものではない。公開されているのはあくまで、公式配布のZLUDAとAMD HIP SDKだけを使った「アップストリームのみの経路」を実際に動かして検証した記録である。検証済み環境は次の通り。
- ZLUDA v6-preview.69(公式リリース版)
- AMD HIP SDK 6.4
- LibTorch 2.3.0+cu118
- 検証GPU: Radeon RX 9060 XT(gfx1200)
- nvcuda・cuBLAS・cuBLASLt・cuSPARSE・cuFFTがいずれもcuda_checkを通過
- パラメータ数2,216,347のPPOニューラルネットワークがforward/inference・学習・オプティマイザ更新まで完走
- 検証用ワークロードで65,536タイムステップを1イテレーション完走
仕組み — CUDA呼び出しがAMD GPUに届くまで
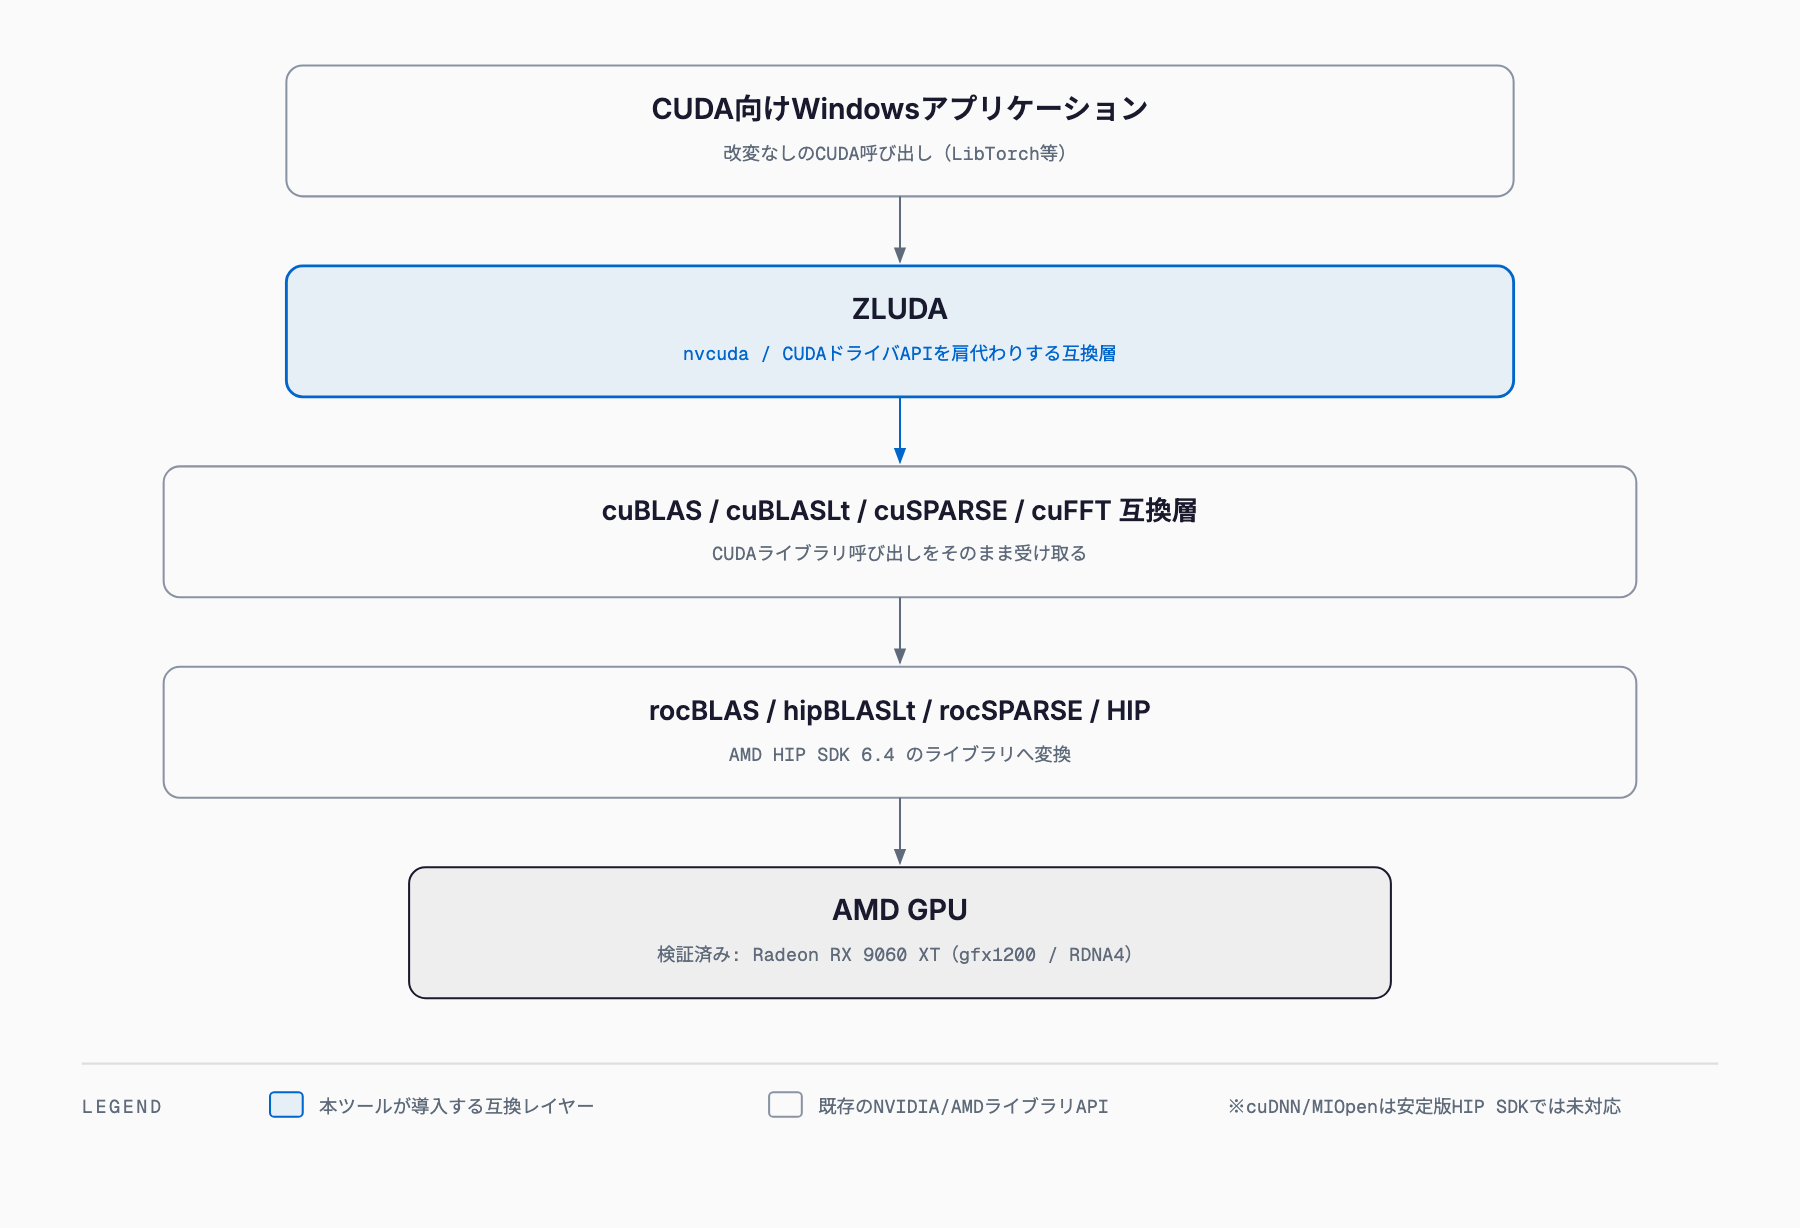
変換の流れはREADMEの図解を踏襲すると次の5段になる。CUDA向けWindowsアプリの呼び出しは、まずZLUDAがCUDAドライバAPI(nvcuda)の代わりを務めて受け取る。次にcuBLAS・cuBLASLt・cuSPARSE・cuFFTといったCUDAライブラリ呼び出しの互換層を通り、AMD HIP SDKが提供するrocBLAS・hipBLASLt・rocSPARSE・HIPへと変換される。最終的にAMD GPU上で実行される、という多段の橋渡しだ。アプリ側からはCUDAを呼んでいるつもりのまま、内部でAMDのライブラリに委譲される形になる。
対応GPU・要件
2026年9月14日時点で、このプロジェクトが「検証済み」としているAMD GPUはRadeon RX 9060 XT(gfx1200、RDNA4)ただ1機種のみである。それ以外のAMD GPUは「候補」であって動作保証はなく、READMEはGPU互換性レポート(成功・失敗いずれも)をIssueとして投稿するよう呼びかけている。
| 項目 | 要件 |
|---|---|
| OS | Windows x64 |
| GPU | AMD Radeon(検証済みはRX 9060 XT / gfx1200のみ、他は候補扱い) |
| GPUドライバ | 最新のAMD GPUドライバ |
| HIP SDK | AMD HIP SDK for Windows(HIP Libraries込み)6.4で検証。新しめのバージョンは未検証扱い |
| ZLUDA | v6-preview.69(インストーラがピン留めして自動取得) |
| LibTorchを使う場合 | LibTorch 2.3.0+cu118(約2.66GBのダウンロードが発生) |
セットアップ手順
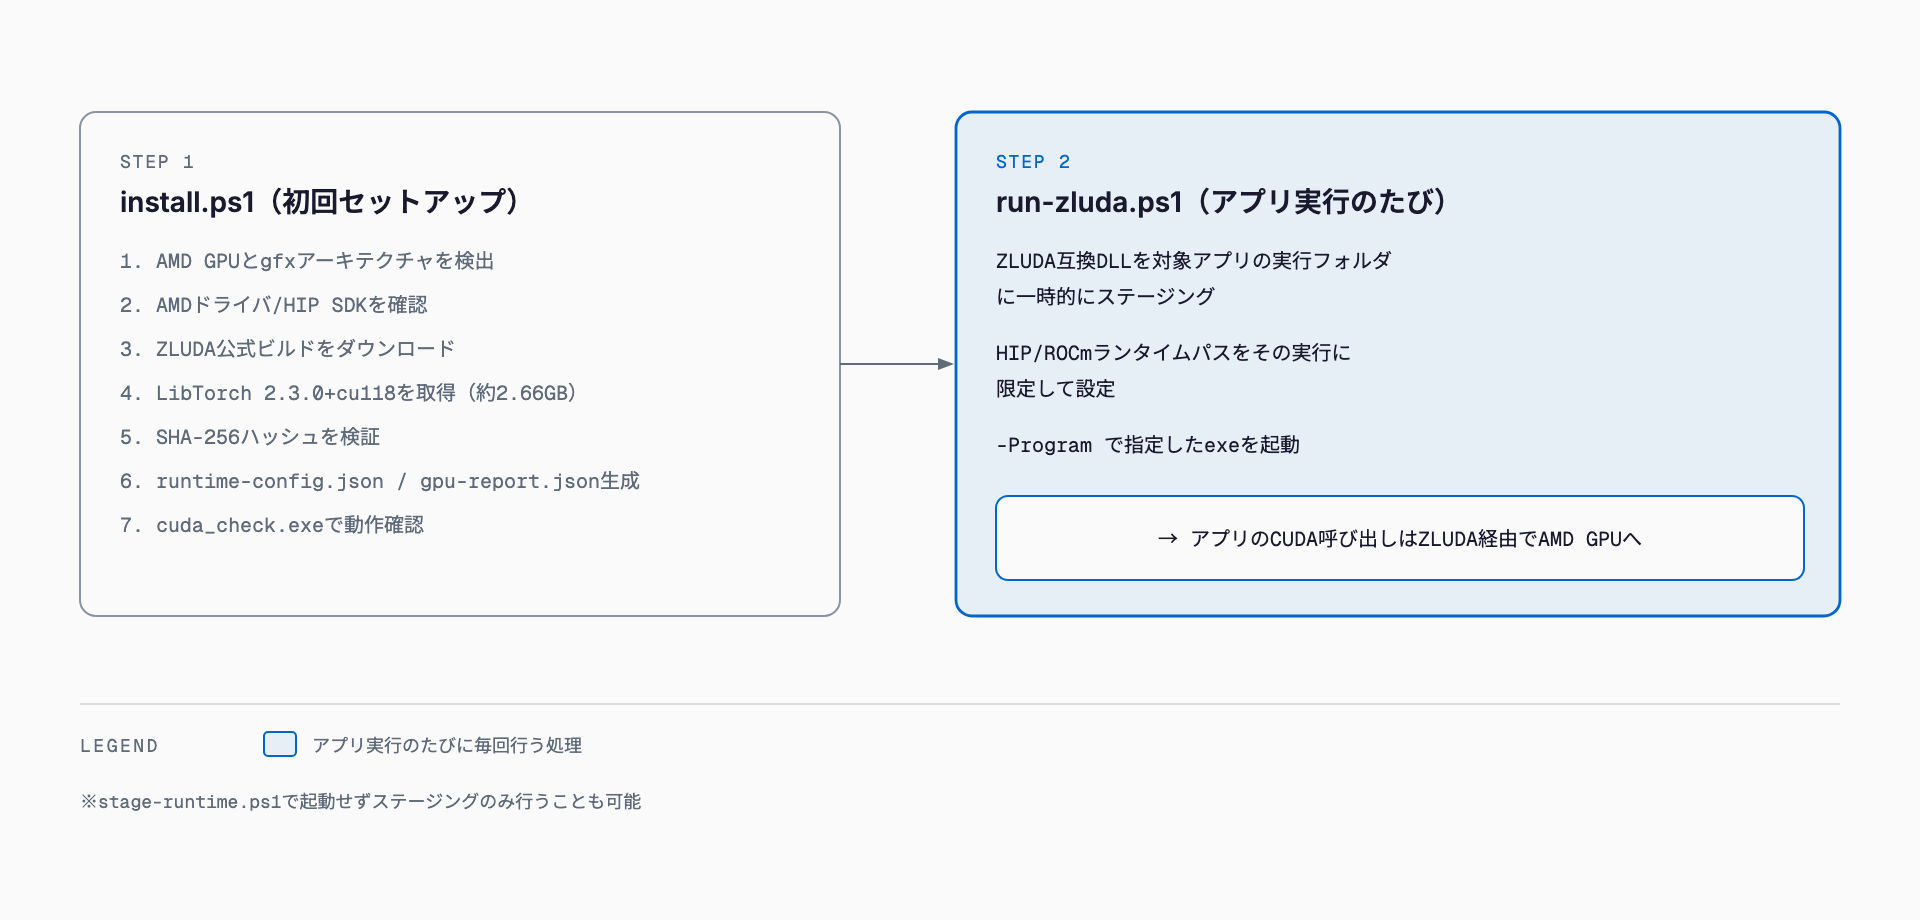
手順は大きく2段階に分かれる。1回だけ行うinstall.ps1によるセットアップと、アプリを起動するたびに使うrun-zluda.ps1によるランチャー実行だ。
# 1. 事前準備: 最新のAMD GPUドライバと AMD HIP SDK for Windows(HIP Libraries込み)を導入

# 2. クローンしてインストーラを実行
git clone https://github.com/Speedstu/CUDA-for-AMD-Windows.git
cd CUDA-for-AMD-Windows
powershell -ExecutionPolicy Bypass -File .\scripts\install.ps1

# LibTorchが不要な場合はスキップ可能
.\scripts\install.ps1 -SkipLibTorchinstall.ps1は、AMD GPUとgfxXXXXターゲットの検出、AMDドライバ/HIP SDKと必要ライブラリの確認、公式ZLUDA Windowsビルドのダウンロード、LibTorch 2.3.0+cu118の取得、ダウンロードしたファイルのSHA-256ハッシュ検証、.runtime\runtime-config.jsonと.runtime\gpu-report.jsonの生成、そしてZLUDA付属のcuda_check.exeによる動作確認までを一括で行う。
# アプリを実行するたびにこのランチャー経由で起動する
.\scripts\run-zluda.ps1 -Program C:\path\to\app.exe

# 起動せずステージングだけ行うことも可能
.\scripts\stage-runtime.ps1 -TargetDir C:\path\to\your-app

# マシンの状態を診断する
.\scripts\doctor.ps1
.\scripts\gpu-scan.ps1
.\scripts\test-runtime.ps1run-zluda.ps1は、対象アプリケーションの実行フォルダにZLUDA互換DLLを一時的に配置し、その実行に限定してHIP/ROCmランタイムパスを設定したうえでアプリを起動する。システム全体の環境変数を恒久的に書き換えるのではなく、起動のたびにアプリの隣にDLLを配置し直す方式である点が、この仕組みの実務上のポイントになる。
動くもの・動かないもの
READMEが確認済みとして挙げているのは、CUDA駆動のライブラリ呼び出し(nvcuda・cuBLAS・cuBLASLt・cuSPARSE・cuFFT)と、CUDA対応LibTorchを使ったGEMM(行列積)中心の学習ワークロードである。実測では約221万パラメータのPPOネットワークが学習・推論とも問題なく完走したとされる。一方、以下は現時点で未対応または不安定とされている。
- cuDNN/MIOpen: 検証済みの安定版HIP SDKには含まれておらず、畳み込み(CNN)中心のワークロードは動かない可能性がある。密結合(GEMM中心)のLibTorch学習はcuDNNを必須としないため、検証済みPPOワークロードはcuDNNなしで完走している
- NCCL・TensorRT: 失敗する可能性があるとREADMEが明記
- 未対応のPTX命令・一部のカスタムCUDA拡張: 失敗しうる
- ZLUDAそのものの限界: READMEも「ZLUDAは完全なCUDA実装ではない」と明言しており、対応範囲はワークロード依存
パフォーマンス — 独自オーバーレイとの比較
開発初期には、非公開のcuBLAS/cuBLASLt/HIP独自オーバーレイも試されていた。しかし2026年9月13日に実施されたA/Bテスト(同一のRX 9060 XT・PPOワークロードで各経路10イテレーション、最初のイテレーションをウォームアップとして除外)の結果、公開されているアップストリームのみの経路が中央値13,278 SPSに対し、独自オーバーレイは12,876 SPSと約3.03%遅かった。この結果を受けて、プロジェクトは公式配布のみで完結するアップストリーム経路をデフォルトとし、独自オーバーレイのバイナリ自体は配布していない(由来が不完全で、サードパーティのAMDバイナリを含むため)。なお、異なる学習設定を使った過去の調整済み計測では、全体スループットが毎秒7万〜10万9千ステップ程度に達した例もあるとされている。
既存の選択肢との違い
AMD GPUでCUDA向けソフトウェアを動かす、あるいは同等の計算をさせる手段は他にも複数ある。それぞれWindows対応の有無、セットアップの複雑さ、検証の粒度が異なる。
| 手段 | 動作OS | 仕組み | 検証範囲 | Windowsでの手軽さ |
|---|---|---|---|---|
| CUDA for AMD on Windows(本記事) | Windows | ZLUDA+AMD HIP SDK 6.4を再現可能なスクリプトで自動セットアップ | RX 9060 XT/LibTorch PPOワークロードで実測・自動検証あり | 高い(インストーラとランチャーが用意されている) |
| ZLUDA単体 | 主にLinux、Windowsは実験的 | CUDAドライバAPIをHIP/ROCmへ変換する互換層そのもの | プロジェクトやワークロードごとに個別検証が必要 | 中程度(手動でのセットアップ・DLL配置が必要) |
| ROCm on Linux | Linux | AMD公式のネイティブGPUコンピューティングスタック(HIPで直接開発) | AMD公式にサポートされたGPU・OSの組み合わせ | Windowsでは非対応(別OSへの移行が前提) |
| DirectML | Windows | DirectX 12を介したGPU非依存の機械学習アクセラレーションAPI | Microsoft/ベンダーがDirectML対応レイヤーとして提供・検証 | 高い(Windows標準、ただしCUDAコードの書き換えが前提) |
| Vulkan経由(llama.cpp等) | Windows/Linux/macOS | Vulkan APIをバックエンドにした推論エンジン実装 | 各推論エンジンのVulkanバックエンドとして個別に検証 | 高い(GPUベンダー非依存だがCUDA資産の流用はできない) |
表から分かる通り、CUDA for AMD on Windowsの特色は「既存のCUDA向けWindowsアプリを改変せずにそのまま動かす」ことを狙っている点にある。DirectMLやVulkanバックエンドはそれぞれのAPIに合わせてコードを書く(または対応済みの推論エンジンを使う)必要があるのに対し、ZLUDA系のアプローチはCUDA呼び出しそのものを下側で肩代わりする方式であり、既存のCUDA依存資産をそのまま活かしたい場合に選択肢になる。
ライセンスとリスクの注意点
プロジェクト自体が公開しているスクリプトとドキュメントはMITライセンスで、自由に利用・改変・再配布できる。ただし、ZLUDA・AMD ROCm/HIP・NVIDIA CUDAコンポーネント・PyTorch/LibTorchはそれぞれ独自のアップストリームライセンスを保持する点に注意が必要だ。プロジェクトのREADMEは制約として次を明記している。
- 現時点で検証済みなのはRX 9060 XT(gfx1200)のみ
- ZLUDAは完全なCUDA実装ではない
- WindowsではROCmエコシステムの一部機能のみが利用可能
- 検証済みの安定版HIP SDK経路ではcuDNN/MIOpenが利用不可
- NCCL・TensorRT・未対応のPTX動作・一部のカスタムCUDA拡張は失敗しうる
- 環境変数ZLUDA_CC=8.6はCUDA互換上の値であり、AMD GPU自体のアーキテクチャを表すものではない
また、GPUスキャナ(gpu-scan.ps1)はGPUモデル・gfxアーキテクチャ・ドライバ・HIP情報を記録するが、ユーザー名やトークン、ユーザーファイルを意図的に収集しないとREADMEに明記されている。とはいえ、サードパーティのバイナリを組み込む性質上、導入前には自組織のソフトウェア利用ポリシーやセキュリティ要件に照らして確認することが望ましい。
関連記事
よくある質問
CUDA for AMD on WindowsはどのAMD GPUで動きますか。
2026年9月14日時点で検証済みなのはRadeon RX 9060 XT(gfx1200・RDNA4)のみです。他のAMD GPUは『候補』として認識されますが、動作は保証されていません。プロジェクトはGitHub Issueでの互換性報告(成功・失敗いずれも)を呼びかけています。
NVIDIA GPUなしで既存のCUDAアプリをそのまま動かせますか。
アプリの改変なしにCUDA呼び出しをZLUDA経由でAMD向けに変換する設計です。ただし『すべてのCUDAプログラムが動く』ことは保証されておらず、cuDNN・NCCL・TensorRT・一部のカスタムCUDA拡張に依存するワークロードは失敗する可能性があります。
セットアップにはどれくらいの手間がかかりますか。
AMD GPUドライバとHIP SDK 6.4を導入した後、install.ps1を1回実行すればZLUDAとLibTorchの取得・検証まで自動で完了します。以降はアプリを起動するたびにrun-zluda.ps1を経由するだけです。
ZLUDA単体を自分でセットアップするのと何が違いますか。
ZLUDA単体はDLLの配置や環境変数の設定を手動で行う必要がありますが、本プロジェクトはHIP SDKのバージョン固定・ハッシュ検証済みのZLUDAビルド取得・GPU検出・動作確認までをスクリプトで自動化し、RX 9060 XTでの実測結果を公開している点が異なります。
性能は独自チューニング版と比べてどうですか。
2026年9月13日のA/Bテストでは、公開されているアップストリームのみの経路が中央値13,278 SPS、独自オーバーレイが12,876 SPSで、アップストリーム経路の方が約3.03%高速でした。プロジェクトはこの結果を受けてアップストリーム経路をデフォルトとしています。
商用利用は可能ですか。
プロジェクト自体のスクリプト・ドキュメントはMITライセンスで商用利用を含め制限は緩やかです。ただしZLUDA・AMD ROCm/HIP・NVIDIA CUDAコンポーネント・PyTorch/LibTorchはそれぞれ別のライセンスに従うため、実際の利用前に各コンポーネントのライセンス条件を確認する必要があります。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ