Whistle解説:16.9MBで動くCactus製の音声認識モデル(日本語は非対応)
Whistleは日本語非対応の音声認識モデル。Cactus Computeが公開した16.9MBの単一ファイルでCPUのみで動作し、Apache 2.0で無料。対応は英独仏西伊蘭波の7言語。Whisper baseとの速度比較、導入手順、向く用途、Hacker Newsの反応を解説(2026年10月)。
TL;DR — Whistleとは
Whistleは、Cactus Computeが2026年10月2日に公開したオープンな音声認識(speech-to-text/ASR)モデルです。最大の特徴は、モデル全体が単一の16.9MBファイルで、CPUだけで依存ライブラリなしに動く点です。ライセンスはApache 2.0、パラメータ数は公開されていません。同社の小型エージェントLLM(Needle 2の解説記事)と同じC++エンジン・同じ.cactコンテナ形式・同じ量子化で動くため、音声認識からツール呼び出しまでを極小のフットプリントでつなげられます。Hacker Newsでは2026年10月8日にフロントページ1位(約768ポイント)になりました。
日本語ユーザーへの重要な注意:Whistleは日本語と中国語に対応していません。 対応は英語・ドイツ語・フランス語・スペイン語・イタリア語・オランダ語・ポーランド語の7言語です。日本語の文字起こしには向かないため、日本語用途ではWhisper系など日本語対応モデルを選んでください(詳しくは後述の比較表)。
スペック早見表
| 項目 | 値 |
|---|---|
| 提供元 | Cactus Compute |
| 公開日 | 2026年10月2日 |
| モデルサイズ | 16.9MB(単一ファイル) |
| パラメータ数 | 非公開 |
| 実行環境 | CPUのみ・依存なし |
| ライセンス | Apache 2.0(重み公開・無料) |
| 対応言語 | 英・独・仏・西・伊・蘭・波の7言語(日本語・中国語は非対応) |
| 1回の入力長 | 最大30秒(16kHzモノラル) |
| 想定デバイス | スマホ、ウェアラブル、ロボット、スマートホーム、車載、マイコン |
何ができるか
- 文字起こし:最大30秒・16kHzモノラルの音声を1回で処理。言語は自動判定、または language="de" のように指定可能
- 単語タイムスタンプ:各単語の開始・終了時刻と確率を取得
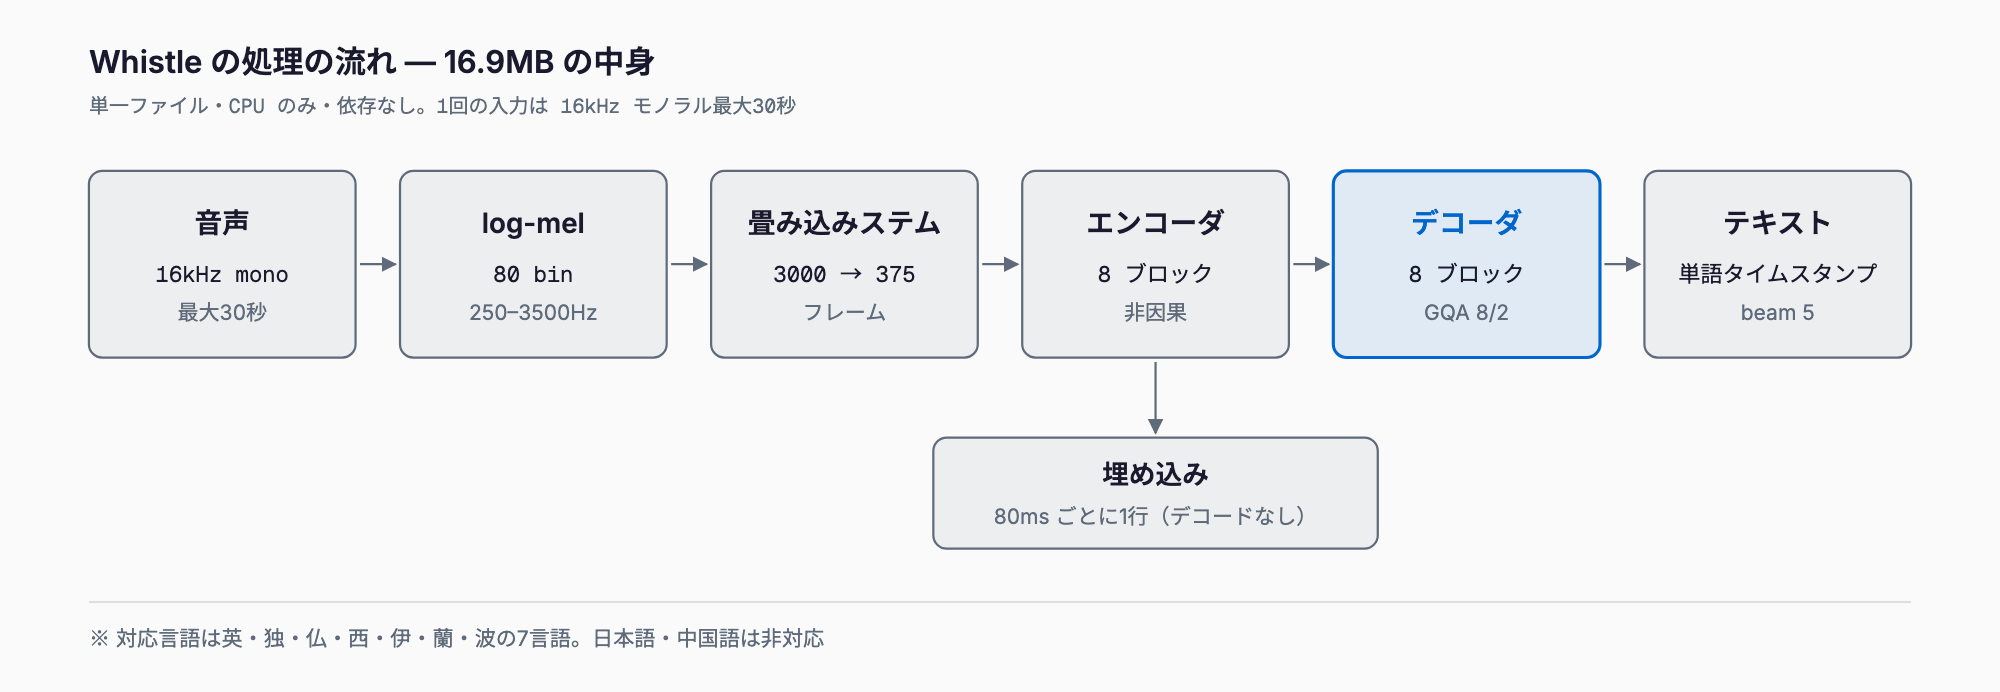
- 音声埋め込み:デコードせずに、80ミリ秒フレームごとに1行のエンコーダ出力を取り出せる
- キーワードバイアス:認識させたい固有名詞やコマンド語を指定して優先的に拾わせる
- 無音検出:無音と判断した場合はデコード前に空の文字起こしを返す
無音検出は、無音区間で幻聴のような文字列が出る問題への対策として有用です。ただし後述のとおり、コミュニティからはテレビ音声などで誤認識が出たという報告もあります。
仕組み(アーキテクチャの要点)
入力音声は80本のログメル特徴(窓25ms・ホップ10ms、250〜3500Hz)に変換され、畳み込みの入り口部分で3000フレームが375フレームに圧縮されます。エンコーダは非因果(未来の音声も参照する)のSimple Attentionブロック8層です。デコーダは幅512のLaddered Simple Attentionブロック8層で、GQA(クエリ8ヘッド/KV2ヘッド)、3層目と7層目のengramルックアップ、全層でのゲート付きクロスアテンションを備えます。探索はビーム幅5、最大320トークン、語彙は8,192に7つの言語トークンを加えたものです。--audio-depthオプションで、ロード時に使うデコーダ層数(最小2)を選べます。
速度比較(Apple M4 Pro・CPU・10秒クリップ)
| モデル | サイズ | TTFT | 生成速度 |
|---|---|---|---|
| Whistle | 16.9MB | 11.1ms | 1,319 tok/s |
| Whisper base | 145.3MB | 73.2ms | 266 tok/s |
| Moonshine tiny v2 | 41.9MB | 22.8ms | 262 tok/s |
いずれもベンダー公表値です。Whistleは5秒クリップでTTFT 5.9ms、30秒クリップで36.3msと報告されています。精度(WER)についてもベンダーは86,174発話で比較しており、LibriSpeech clean/other、SPGISpeech、Earnings-22、FLEURS平均ではWhisper baseとMoonshine tiny v2を上回り、TED-LIUM、AMI、MLS平均ではWhisper baseが上回るとしています。具体的な数値はグラフでのみ示されているため、ここでは傾向のみを紹介します。
対応プラットフォームとインストール
ビルド済みエンジンはmacOS、Linux、Android、iOS、watchOS、Windows on ARM、RISC-V、MIPS、ブラウザ、WASIなど17ターゲットに提供され、それぞれneedleバイナリ、libneedle.a、needle.hが含まれます。重みはHugging Face、エンジンはneedle3のリポジトリ、ソースはGitHubで公開されています。
Pythonからはpipで入れるのが最短です。
pip install cactus-needleマイク入力や16kHz以外の音声を扱う場合は、mic追加パッケージ(soxr、sounddevice)を入れます。
pip install "cactus-needle[mic]"最短の使い方
Pythonでは1行で文字起こしできます。オプションで単語タイムスタンプ、キーワード、言語を指定できます。
import needle

text = needle.transcribe("clip.wav")["text"]

# オプション付き
r = needle.transcribe(
    "clip.wav",
    word_timestamps=True,
    keywords=["Cactus", "Needle"],
    language="de",
)

# 音声埋め込みの取得(デコードなし)
emb = needle.Whistle().embed(audio)
CLIでは、重みのダウンロード、ファイルの文字起こし、マイクでの試用、Whisper・Moonshineとの比較ができます。
needle download whistle
needle --model whistle.cact --audio clip.wav --audio-word-timestamps
needle whistle playground   # マイク入力で試す
needle whistle compare      # Whisper・Moonshineと比較
音声からそのままツール呼び出しにつなげる場合は、Needleと2つのモデルを同時に指定します。
needle --model needle3.cact --model whistle.cact --tools tools.json --audio clip.wavネイティブ環境に配備する場合は、先にプラットフォーム用エンジンを取得してからWhistleを取得します。
needle download macos-arm64
needle download whistle
既存の音声認識モデルとの違い
| モデル | サイズ | 日本語 | 向く用途 |
|---|---|---|---|
| Whistle | 16.9MB | 非対応 | 英語・欧州言語のコマンド認識、極小デバイス |
| Whisper base | 145.3MB | 対応 | 軽量な多言語文字起こし |
| Whisper large-v3-turbo | 大きい(要GPU推奨) | 対応 | 精度重視の文字起こし |
| Moonshine tiny v2 | 41.9MB | 要確認/限定的 | 軽量なエッジ向け英語認識 |
| Parakeet(NVIDIA) | 大きい(要GPU推奨) | 要確認/限定的 | 高精度・高速な英語中心の認識 |
Whistleの強みは、サイズと初回応答の速さに尽きます。一方で汎用の文字起こし精度では、より大きなモデルに分があります。日本語のローカル文字起こしを試したい場合は、TypeWhisperの解説記事で紹介しているようなWhisper系のアプリが現実的です。認識後の読み上げまで含めて日本語で完結させたいなら、Irodori-TTS v4の解説も参考になります。
コミュニティの反応(Hacker News)
Hacker Newsでは、サイズと速度への驚きと同時に、冷静な指摘も多く出ました。多くの投稿者は、素のままの精度がWhisper LargeやWhisper large-v3-turbo、Parakeetに及ばないと感じています。無音やテレビ音声での幻聴(存在しない文字列の出力)の報告があり、公開デモにはストリーミング出力がありません。また、既存のAndroidアプリ「Whistle」と名前が衝突して混乱したという声もありました。
一方で、用途を絞った使い方では評価が変わります。あるユーザーは、コマンド文170件のテストで、素のWhistleは70件正解、Qwen ASR 1.7Bは168件正解だったと報告しました。しかし、1万件の生成発話でテンプレートに制限する小さなネットワークを追加学習させると164件まで改善し、別のフレーズ集では208件中206件正解(Vosk smallは184件)になったとのことです。つまり最も有望なのは、一般的な口述ではなく、固定コマンドの音声操作(例:Echo ShowのようなデバイスでのHome Assistant)といった小型デバイス用途だと読み取れます。
向いている用途・向かない用途
- 向いている:英語・欧州言語での固定コマンド認識、ウェアラブル・ロボット・車載・マイコンでの音声操作、音声から直接ツール呼び出しへつなぐ構成
- 向かない:日本語・中国語の文字起こし、会議録など長時間・高精度が必要な用途、ストリーミング出力が必須の用途
日本語の音声入力が目的なら、Whisper系や日本語対応を明記したモデルを選ぶのが安全です。Whistleは英語・欧州言語のデバイス内コマンド認識に絞って検討してください。
FAQ
Whistleは日本語に対応していますか?
いいえ。対応は英語、ドイツ語、フランス語、スペイン語、イタリア語、オランダ語、ポーランド語の7言語で、日本語と中国語は非対応です。日本語の文字起こしにはWhisper系など日本語対応モデルを使ってください。
商用利用できますか?
重みはApache 2.0ライセンスで公開されており、ライセンス条件に従えば商用利用が可能で、利用は無料です。
GPUは必要ですか?
不要です。モデルは16.9MBの単一ファイルで、CPUだけで依存ライブラリなしに動作します。
長い音声も文字起こしできますか?
1回の処理で扱えるのは最大30秒(16kHzモノラル)です。それより長い音声は、区切って処理する必要があります。
WhisperやMoonshineと比べて精度はどうですか?
ベンダーのWER比較では、LibriSpeech、SPGISpeech、Earnings-22、FLEURS平均でWhisper baseとMoonshine tiny v2を上回り、TED-LIUM、AMI、MLS平均ではWhisper baseが上回ります。コミュニティではWhisper Large系やParakeetより精度が低いという声が多く、用途に合わせた検証が必要です。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ