Claude Haiku 5.5 徹底解説 — 料金$0.10/$0.50・1Mコンテキスト・移行ガイド
Claude Haiku 5.5(2026年10月7日公開)は input $0.10 / output $0.50、1Mコンテキストで Haiku 4.5 の約10分の1の単価。2026年10月時点の100K超で5倍になる料金帯、新トークナイザーの約30%増、破壊的変更10項目と移行手順をコード例つきで解説する。
Claude Haiku 5.5 は、Anthropic が2026年10月7日に公開した最小・最速クラスのモデルです。価格は input $0.10 / output $0.50(1Mトークンあたり)で、前世代の Haiku 4.5($1 / $5)の約10分の1の単価、コンテキストは Haiku 4.5 の 200K から 1M トークンに拡大しました。Anthropic は平均で約75%の低コスト化と説明しています。要約・分類・ルーティング・抽出・チケット仕分け・サブエージェントなど、量が多く低遅延が要る処理に向く一方、複雑なエージェント的コーディングは Sonnet 5.5 / Opus 5.5 の領域です。ただし新トークナイザーで同じ文章が約30%多いトークンになる点と、プロンプト100K超で単価が5倍になる二段料金に注意が必要です。
本コラムでは、仕様・ベンチマーク・実コストの見積もり方・ラインナップ内での使い分け・Haiku 4.5 からの移行(破壊的変更10項目)を整理します。ベンチマークはすべて Anthropic の公表値(ベンダー報告)で、第三者の再現検証ではありません。上位モデルは Claude Sonnet 5.5 の解説 と Claude Opus 5.5 の解説 も参照してください。
Claude Haiku 5.5 のスペック一覧
| 項目 | 内容 |
|---|---|
| 公開日 | 2026年10月7日 |
| モデル ID | claude-haiku-5-5(Claude API / Google Cloud Vertex / Microsoft Foundry / Claude Platform on AWS)。日付サフィックスなし |
| Amazon Bedrock の ID | anthropic.claude-haiku-5-5 |
| コンテキストウィンドウ | 1M トークン(Haiku 4.5 は 200K) |
| 最大出力 | 128K トークン(Batch API は beta ヘッダー付きで最大 300K) |
| 入力 | テキスト・画像 |
| 知識カットオフ | 2026年6月 |
| 料金(プロンプト100K以下) | input $0.10 / output $0.50(1Mトークンあたり) |
| 料金(プロンプト100K超) | input $0.50 / output $2.50 |
| キャッシュ(100K以下) | 読み込み $0.01 / 5分書き込み $0.125 |
| キャッシュ(100K超) | 読み込み $0.05 / 5分書き込み $0.625 |
| Batch API | 50%割引 |
| Thinking | adaptive thinking 対応。Haiku として初めて effort を調整可能(既定 medium) |
| Priority Tier | 非対応 |
Haiku として初めて effort を指定できるようになったのが大きな変化です。low では単純なリクエストで思考を省略できるため、分類や抽出のような軽い処理では、思考トークンを払わずに最安・最速で回せます。既定は medium なので、何も指定しないと思考が走る点には注意してください。
ベンチマーク:Haiku 4.5・Sonnet 5.5 との比較
以下は Anthropic が公表している数値です(ベンダー報告)。Haiku 5.5 / Haiku 4.5 / Sonnet 5.5 の順に並べています。
| ベンチマーク | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 39.2% | 0.0% | 70.6% |
| FrontierCode 1.1(Main) | 46.4% | 該当なし | 52.1%(xhigh) |
| OSWorld 2.1(オフラインサブセット) | 72.4% | 15.7% | 83.9% |
| Humanity's Last Exam(ツールなし) | 45.9% | 10.2% | 56.9% |
| GDPval-AA v2.1(Elo) | 1620 | 735 | 1840 |
Haiku 4.5 からの伸びは極めて大きく、特に Terminal-Bench 4.0 は 0.0% から 39.2%、OSWorld 2.1 は 15.7% から 72.4% になっています。ただし読み方には注意が要ります。OSWorld 2.1 の72.4%は部分点を含む数値で、すべてのチェックポイントを達成した完全完了率は 37.1% とされています。「ブラウザ操作の7割が成功する」という意味ではありません。Haiku 4.5 側の 0.0% や 15.7% は評価条件が異なる可能性もあるため、倍率そのものより「実用ラインに入ったかどうか」で捉えるのが安全です。
一方で Sonnet 5.5 との差は依然としてあります。Terminal-Bench 4.0 は 39.2% 対 70.6% と大きく開いており、長いターミナル作業を完遂するようなエージェント的コーディングでは、Haiku 5.5 は Sonnet 5.5 の代わりにならないと見るべきです。FrontierCode 1.1 は 46.4% 対 52.1%(Sonnet 側は xhigh)と近いですが、設定が異なるため単純比較はできません。第三者評価では、Artificial Analysis の Intelligence Index が high effort で 38、max effort で 43 と報告されています。
料金と実コスト:100K境界とトークナイザーの罠
単価だけ見ると Haiku 4.5 の10分の1ですが、実際の請求額は2つの要因で変わります。
- 100Kトークンの境界: プロンプトが100K以下なら input $0.10 / output $0.50、100K超になるとリクエスト全体が input $0.50 / output $2.50(5倍)になります。1Mコンテキストを使い切る設計は、安さの前提を崩します
- 新トークナイザー: 同じテキストでも Haiku 4.5 より約30%多いトークンになります。単価が下がっても、トークン数が増える分で削減幅は縮みます
- キャッシュ: 読み込みは $0.01(100K超でも $0.05)と非常に安く、長いシステムプロンプトやツール定義を持つ用途ではキャッシュ設計が支配的になります
試算例です(私の計算で、公式の保証値ではありません)。月に入力 1,000万トークン・出力 200万トークン(Haiku 4.5 換算)を使い、すべてのリクエストが100K以下だとします。
- Haiku 4.5: 入力 10M × $1 + 出力 2M × $5 = $20
- Haiku 5.5(トークン数が同じと仮定): 10M × $0.10 + 2M × $0.50 = $2
- Haiku 5.5(トークナイザーで約30%増を織り込む): 入力 13M × $0.10 + 出力 2.6M × $0.50 = 約 $2.60(Haiku 4.5 比 約87%減)
- 同じ量がすべて100K超のプロンプトだった場合: 13M × $0.50 + 2.6M × $2.50 = 約 $13(Haiku 4.5 比 約35%減)
- 参考として Sonnet 5.5($2 / $10)で同じ量を処理すると $40
このように、100K以下に収まる処理なら削減幅は大きく、長文を丸ごと投入する設計では想定より効果が小さくなります。見積もりの際は、必ず新モデルでトークン数を数え直し、プロンプトがどちらの料金帯に入るかをリクエスト単位で確認してください。Batch API は50%割引なので、非同期で問題ない分類・抽出ならさらに半額になります。
ラインナップ比較:Opus 5.5 / Sonnet 5.5 / Haiku 5.5 / Haiku 4.5
| モデル | Input / Output($/1M) | コンテキスト | 位置づけ |
|---|---|---|---|
| Claude Opus 5.5 | $4 / $20 | 1M | 計画・レビュー・難しい自由度の高い作業 |
| Claude Sonnet 5.5 | $2 / $10 | 1M | エージェント的コーディングの標準 |
| Claude Haiku 5.5 | $0.10 / $0.50(100K超は $0.50 / $2.50) | 1M | 大量・低遅延・サブエージェント |
| Claude Haiku 4.5 | $1 / $5 | 200K | 旧世代(移行元) |
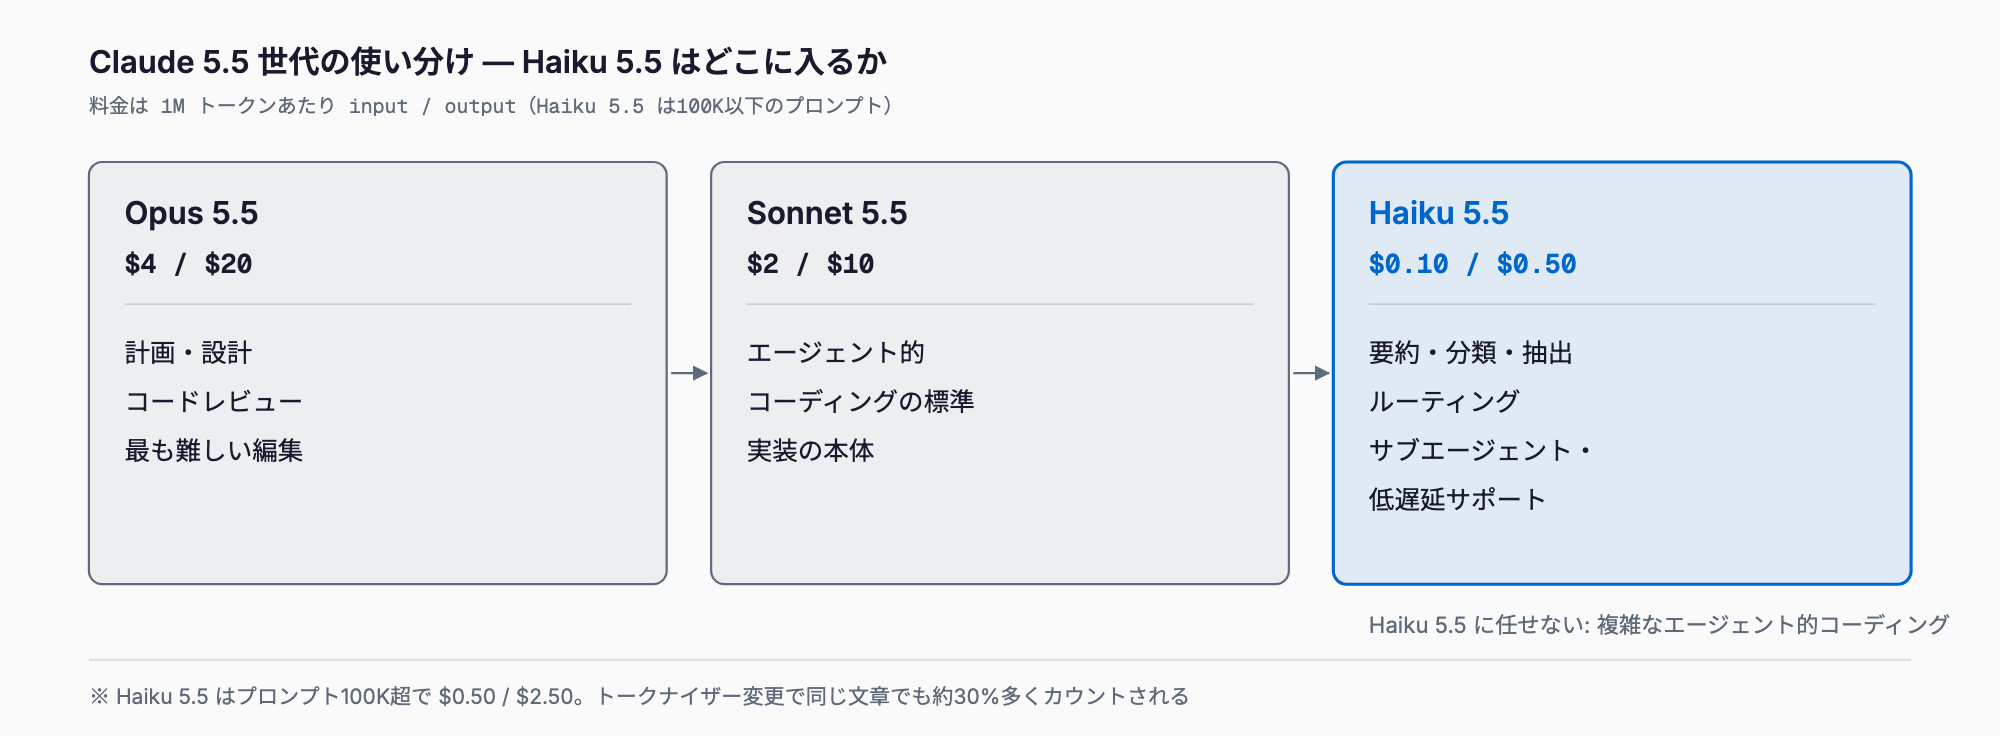
Anthropic は複雑なエージェント的コーディングでは Sonnet 5.5 / Opus 5.5 のほうが優れているとしています。典型的な構成は、Opus 5.5 が計画とレビュー、Sonnet 5.5 が実装、Haiku 5.5 がサブエージェントやルーターを担当する分担です。詳しくは Claude Code と Agent SDK の解説 のようなマルチエージェント構成の考え方と組み合わせると設計しやすくなります。
Haiku 5.5 に任せるタスク・任せないタスク
向いている用途として Anthropic が挙げているのは次の通りです。
- 要約と会話履歴の compaction(長い履歴を圧縮する処理)
- 分類とルーティング(問い合わせの振り分け、どのモデルに渡すかの判定)
- 構造化データの抽出
- データベースへのクエリ生成
- サポートチケットの仕分け(トリアージ)
- サブエージェント(短い報告を返す調査・検索役)
- 遅延に敏感なサポートチャット
- ブラウザ操作(browser use)
向かない用途は、複雑なエージェント的コーディングです。長時間の自律作業や、判断を積み重ねる設計・デバッグは Sonnet 5.5 か Opus 5.5 に回し、Haiku 5.5 は周辺の高頻度・軽量な処理に使うのが現実的です。判断基準は「失敗したときのやり直しコストが安いか」です。分類やトリアージは間違えても再試行が安く、Haiku の低単価が活きます。
ルーターとして使う場合のコツは、effort を low にして出力を短く固定することです。出力のトークン数が支配的なので、ラベルだけを返す設計にすれば1リクエストあたりの費用はごくわずかになります。
Haiku 4.5 からの移行:破壊的変更10項目
最初の一歩はモデル ID を claude-haiku-4-5 から claude-haiku-5-5 に変えることですが、モデル文字列の書き換えだけでは動かない箇所が複数あります。テスト環境で切り替え、エラーの出る順に直すのが早道です。
- 1. モデル ID の更新: claude-haiku-5-5(Bedrock は anthropic.claude-haiku-5-5)
- 2. トークンの再計測: 新トークナイザーで約30%増になるため、max_tokens とコスト見積もりを見直す
- 3. thinking の指定方法: thinking: {"type": "enabled", "budget_tokens": N} は 400 エラー。{"type": "adaptive"} にして、effort は output_config で指定する。thinking トークンは max_tokens に含まれる
- 4. コンテンツブロックは位置でなく type で選ぶ: 先頭が text とは限らない(thinking ブロックが前に来る)
- 5. サンプリングパラメータ: top_k、既定値以外の temperature / top_p(または両方同時指定)は 400 エラー
- 6. assistant の prefill は 400 エラー: 出力の書き出しを固定する手法は使えない。structured outputs などに置き換える
- 7. Computer use のツール定義: 旧 computer_20250124 は 400。computer_toolset_20260801 に更新
- 8. thinking ブロックはアカウントに紐づく: 別アカウントが生成したブロックは使えない
- 9. 会話履歴は追記のみ(append-only): system・tools・過去メッセージを書き換えたあとに、以前の thinking ブロックを再送しない
- 10. 拒否応答の処理: stop_reason: "refusal" を処理する。サーバー側の自動フォールバックはない
特に見落としやすいのは3・5・6です。 共通ラッパーで一律に temperature を渡している実装や、JSON 出力を { の prefill で誘導していた実装は、移行後に一斉に 400 になります。また4は、これまで content[0].text と書いていたコードが、thinking ブロックが先頭に来た途端に壊れる典型例です。
コード例:adaptive thinking と effort の指定
Python SDK での移行前後の例です(パラメータの渡し方は SDK のバージョンで異なる場合があるため、公式ドキュメントで最新の書式を確認してください)。
# Haiku 4.5 の書き方(Haiku 5.5 では 400 エラー)
response = client.messages.create(
    model="claude-haiku-4-5",
    max_tokens=1024,
    temperature=0.3,
    thinking={"type": "enabled", "budget_tokens": 512},
    messages=[
        {"role": "user", "content": "次の問い合わせを分類してください: ..."},
        {"role": "assistant", "content": "{"},  # prefill も 400
    ],
)
text = response.content[0].text  # 位置指定も危険
# Haiku 5.5 での書き換え
response = client.messages.create(
model="claude-haiku-5-5",
max_tokens=2048, # thinking トークンも含まれるので余裕を持たせる
thinking={"type": "adaptive"},
output_config={"effort": "low"}, # 分類など単純な処理は low
messages=[
{"role": "user", "content": "次の問い合わせを分類し、JSON だけを返してください: ..."},
],
)
if response.stop_reason == "refusal":
handle_refusal(response) # サーバー側のフォールバックはない
else:
# 位置ではなく type で text ブロックを選ぶ
text = next(b.text for b in response.content if b.type == "text")temperature の指定をやめ、prefill を指示文に置き換え、stop_reason の分岐とブロックの type 選択を入れました。effort は low から始めて、精度が足りないタスクだけ medium(既定)や上位に上げる運用が扱いやすくなります。
移行チェックリスト
- モデル ID を claude-haiku-5-5(Bedrock は anthropic.claude-haiku-5-5)に変更した
- 代表的なプロンプトでトークン数を再計測し、max_tokens とコスト見積もりを更新した
- プロンプトが100Kを超えるリクエストの割合を把握した(超えると単価5倍)
- thinking: enabled + budget_tokens を adaptive + output_config の effort に置き換えた
- top_k と既定値以外の temperature / top_p を削除した
- assistant prefill を廃止し、指示文か structured outputs に置き換えた
- 応答の読み取りを content[0] から type 指定に変えた
- Computer use を computer_toolset_20260801 に更新した
- 会話履歴が append-only で、system・tools を書き換えたあとに thinking ブロックを再送していない
- stop_reason: "refusal" のハンドリングを追加した
- effort を low / medium で振って、成功率・トークン数・所要時間を評価した
評価は、代表的な20〜50件のタスクで effort を変えて成功率とコストを並べると判断しやすくなります。成功率が横ばいなら低い effort を採用するだけで、コストとレイテンシの両方が改善します。
よくある質問
Claude Haiku 5.5 の料金はいくらですか?
プロンプトが100K以下なら input $0.10 / output $0.50(1Mトークンあたり)、100K超なら input $0.50 / output $2.50 です。キャッシュ読み込みは $0.01(100K超は $0.05)、Batch API は50%割引です。Haiku 4.5($1 / $5)に対し、Anthropic は平均で約75%安いと説明しています。
Haiku 4.5 より本当に75%安くなりますか?
単価は約10分の1ですが、新トークナイザーで同じテキストが約30%多いトークンになり、100K超のプロンプトは単価が5倍になります。実際の削減幅はこの2点で変わるため、新モデルでトークン数を数え直して見積もってください。
Haiku 5.5 は Sonnet 5.5 の代わりに使えますか?
軽量な処理では代替できますが、複雑なエージェント的コーディングでは難しいです。Terminal-Bench 4.0 は Haiku 5.5 が39.2%、Sonnet 5.5 が70.6%(いずれも Anthropic の公表値)で、Anthropic も Sonnet 5.5 / Opus 5.5 のほうが優れているとしています。
Haiku 4.5 のコードはモデル ID を変えるだけで動きますか?
動かない場合があります。thinking の enabled + budget_tokens、top_k や既定値以外の temperature / top_p、assistant の prefill、旧 computer use ツール定義はいずれも 400 エラーになります。テスト環境で切り替えて、エラーに沿って修正してください。
どんな用途に向いていますか?
要約、compaction、分類、ルーティング、データ抽出、DB クエリ、チケット仕分け、サブエージェント、遅延に敏感なサポートチャット、ブラウザ操作が推奨されています。複雑なエージェント的コーディングは Sonnet 5.5 / Opus 5.5 向きです。
お気軽にご相談ください
お問い合わせ