Claude Sonnet 5.5 徹底解説 — 料金$2/$10・Sonnet 5との違い・移行ガイド
Claude Sonnet 5.5(2026年9月28日公開)は input $2 / output $10 で Sonnet 5 と同額、1Mコンテキスト。Terminal-Bench 4.0 は70.6%に向上。2026年9月時点の料金・ベンチマーク・破壊的変更5つと移行手順をコード例つきで解説する。
Claude Sonnet 5.5 は、Anthropic が2026年9月28日に公開した中位モデルです。価格は input $2 / output $10(1Mトークンあたり)で Sonnet 5 と同額、コンテキストは 1M トークン、最大出力は 128K。Anthropic の公表値では Terminal-Bench 4.0 が 10.3% から 70.6% へ、CursorBench 4.0 が 34.1% から 55.5% へ、OSWorld 2.1 が 57.0% から 80.1% へ大きく伸び、出力は30%以上高速で、ツール呼び出し回数の減少によりタスクあたりコストは最大30%低下するとされています。エージェント的なコーディングやコンピュータ操作で Sonnet 5 を使っているチームは、乗り換えで得られるものが大きい一方、API には破壊的変更が5つあり、モデル文字列を書き換えるだけでは動かないケースがあります。
本コラムでは、仕様・料金・ベンチマークを整理したうえで、Sonnet 5 からの移行手順を実装者向けに解説します。数値はいずれも Anthropic の公式ページと公式ドキュメントの公表値で、第三者による再現検証ではない点に注意してください。上位の Claude Opus 5.5 や Claude Fable 5.1 との使い分けも扱います。
Claude Sonnet 5.5 のスペック一覧
| 項目 | 内容 |
|---|---|
| 公開日 | 2026年9月28日 |
| モデル ID | claude-sonnet-5-5(Claude API / Google Cloud / Microsoft Foundry / Claude Platform on AWS) |
| Amazon Bedrock の ID | anthropic.claude-sonnet-5-5 |
| 利用できる場所 | 上記の各プラットフォーム、Claude アプリ、Claude Code |
| コンテキストウィンドウ | 1M トークン |
| 最大出力 | 128K トークン(Batch API は beta ヘッダー output-300k-2026-03-24 で最大 300K) |
| 入出力 | 入力はテキスト・画像、出力はテキスト |
| 知識カットオフ | 2026年6月 |
| 料金 | input $2 / output $10(1Mトークンあたり) |
| キャッシュ | 5分書き込み $2.50 / 1時間書き込み $4 / 読み込み $0.20 |
| Batch API | 50%割引 |
| Thinking | adaptive thinking が既定でオン、effort の既定値は high |
| トークナイザー | Sonnet 5 と同じ(同じ入力なら同じトークン数) |
| 提供期間 | 2027年9月28日より前の提供終了はなし |
価格表は公式ドキュメントで「Claude Sonnet 5 と同じ価格」と明記されており、トークナイザーも変わらないため、同じプロンプトなら1リクエストあたりの単価は変わりません。変わるのは、同じ仕事を終えるまでに使うトークンとツール呼び出しの量です。
ベンチマーク:Sonnet 5 との比較
Anthropic が公表している Sonnet 5.5 と Sonnet 5 の比較は次の通りです。
| ベンチマーク | Sonnet 5.5 | Sonnet 5 | 差 |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | +60.3pt |
| FrontierCode 1.1(Main, Max effort) | 46.2% | 42.4% | +3.8pt |
| CursorBench 4.0 | 55.5% | 34.1% | +21.4pt |
| GDPval-AA v2.1 | 1844 | 1449 | +395 |
| AA-Briefcase v1.1 | 1811 | 1359 | +452 |
| OSWorld 2.1 | 80.1% | 57.0% | +23.1pt |
最も目を引くのは Terminal-Bench 4.0 の伸びです。ターミナルを操作しながら長い作業を完遂する種類のタスクで、Sonnet 5 の10.3%から70.6%へと跳ねています。差が大きすぎるため、Sonnet 5 側の数値は評価条件が異なる可能性も含めて読む必要があり、自社のワークロードで実測するまでは「この倍率で速く・賢くなる」とは考えないのが安全です。一方で FrontierCode 1.1 は +3.8pt と控えめで、コーディング系の全指標が同じ幅で伸びたわけではありません。
CursorBench 4.0 では、上位の Opus 5.5 との差が2ポイント以内に収まっているとされています。ただし Anthropic 自身が、Opus 5.5 は「持続的な判断を要する複雑で自由度の高い作業でより強い」と位置づけており、指標上の近さがそのまま置き換え可能を意味するわけではありません。OSWorld 2.1 の +23.1pt はコンピュータ操作エージェントにとって重要ですが、後述のとおりツール定義の変更も伴います。
料金とタスクあたりコスト
トークン単価は Sonnet 5 と同一なので、コスト削減は単価ではなく「タスクを終えるまでの消費量」から生まれます。Anthropic は、より速く、ツール呼び出しが少なくなることで、タスクあたりコストが最大30%下がると説明しています。「最大」であり、常に30%下がる保証ではありません。
月間の試算例です。入力 1,000万トークン・出力 200万トークンを毎月使うワークロードを考えます。
- 通常利用: 入力 10M × $2 = $20、出力 2M × $10 = $20、合計 $40
- Batch API(50%割引): 合計 $20(非同期処理で問題ない用途のみ)
- 入力の8割(8M)がキャッシュ読み込みになる場合: 未キャッシュ 2M × $2 = $4、キャッシュ読み込み 8M × $0.20 = $1.60、出力 $20 で合計 $25.60(キャッシュ書き込み費用は含まない簡易計算)
- タスクあたりコストが上限の30%下がった場合: 通常利用の $40 が約 $28 に(あくまで上限での仮定)
キャッシュ読み込みが $0.20 と入力単価の1割なので、システムプロンプトやツール定義が長いエージェント用途ではキャッシュ設計がコストを最も左右します。Sonnet 5.5 では最小キャッシュ可能プロンプトが Sonnet 5 の 1,024 トークンから 512 トークンに下がったため、これまでキャッシュ対象にならなかった短めのプロンプトも対象になります。
ラインナップ比較:Fable 5.1 / Opus 5.5 / Sonnet 5.5 / Haiku 4.5
| モデル | Input / Output($/1M) | 速度 | 既定 effort | コンテキスト / 最大出力 |
|---|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | 遅め | high | 1M / 128K |
| Claude Opus 5.5 | $4 / $20 | 中程度 | medium | 1M / 128K |
| Claude Sonnet 5.5 | $2 / $10 | 速い | high | 1M / 128K |
| Claude Haiku 4.5 | $1 / $5 | 最速 | — | 200K / 64K |
選び方の目安は次の通りです。各モデルの詳細は Fable 5.1 の解説 と Opus 5.5 の解説 を参照してください。
- まず Sonnet 5.5 から始める: コーディング補助、コード生成、コンピュータ操作、社内ナレッジ検索など、量が多く速度も欲しい用途の標準候補です。Opus 5.5 の半額の単価で、CursorBench では2ポイント以内の差とされています
- Opus 5.5 に上げる: 長時間の自律作業や、判断の積み重ねが必要な複雑で曖昧なタスク。Sonnet 5.5 で失敗が続く場合の次の選択肢です
- Fable 5.1 は最難関だけ: 単価は Sonnet 5.5 の5倍で速度も遅めです。最上位の性能が本当に必要な処理に絞ります
- Haiku 4.5 は大量・低遅延: 分類や抽出など、最速と最安を優先する処理向け。ただしコンテキストは 200K、最大出力は 64K です
実務では、Sonnet 5.5 を標準にして、失敗率の高いタスクだけ上位モデルへルーティングする構成がコスト面で扱いやすくなります。
Sonnet 5 からの移行:5つの破壊的変更
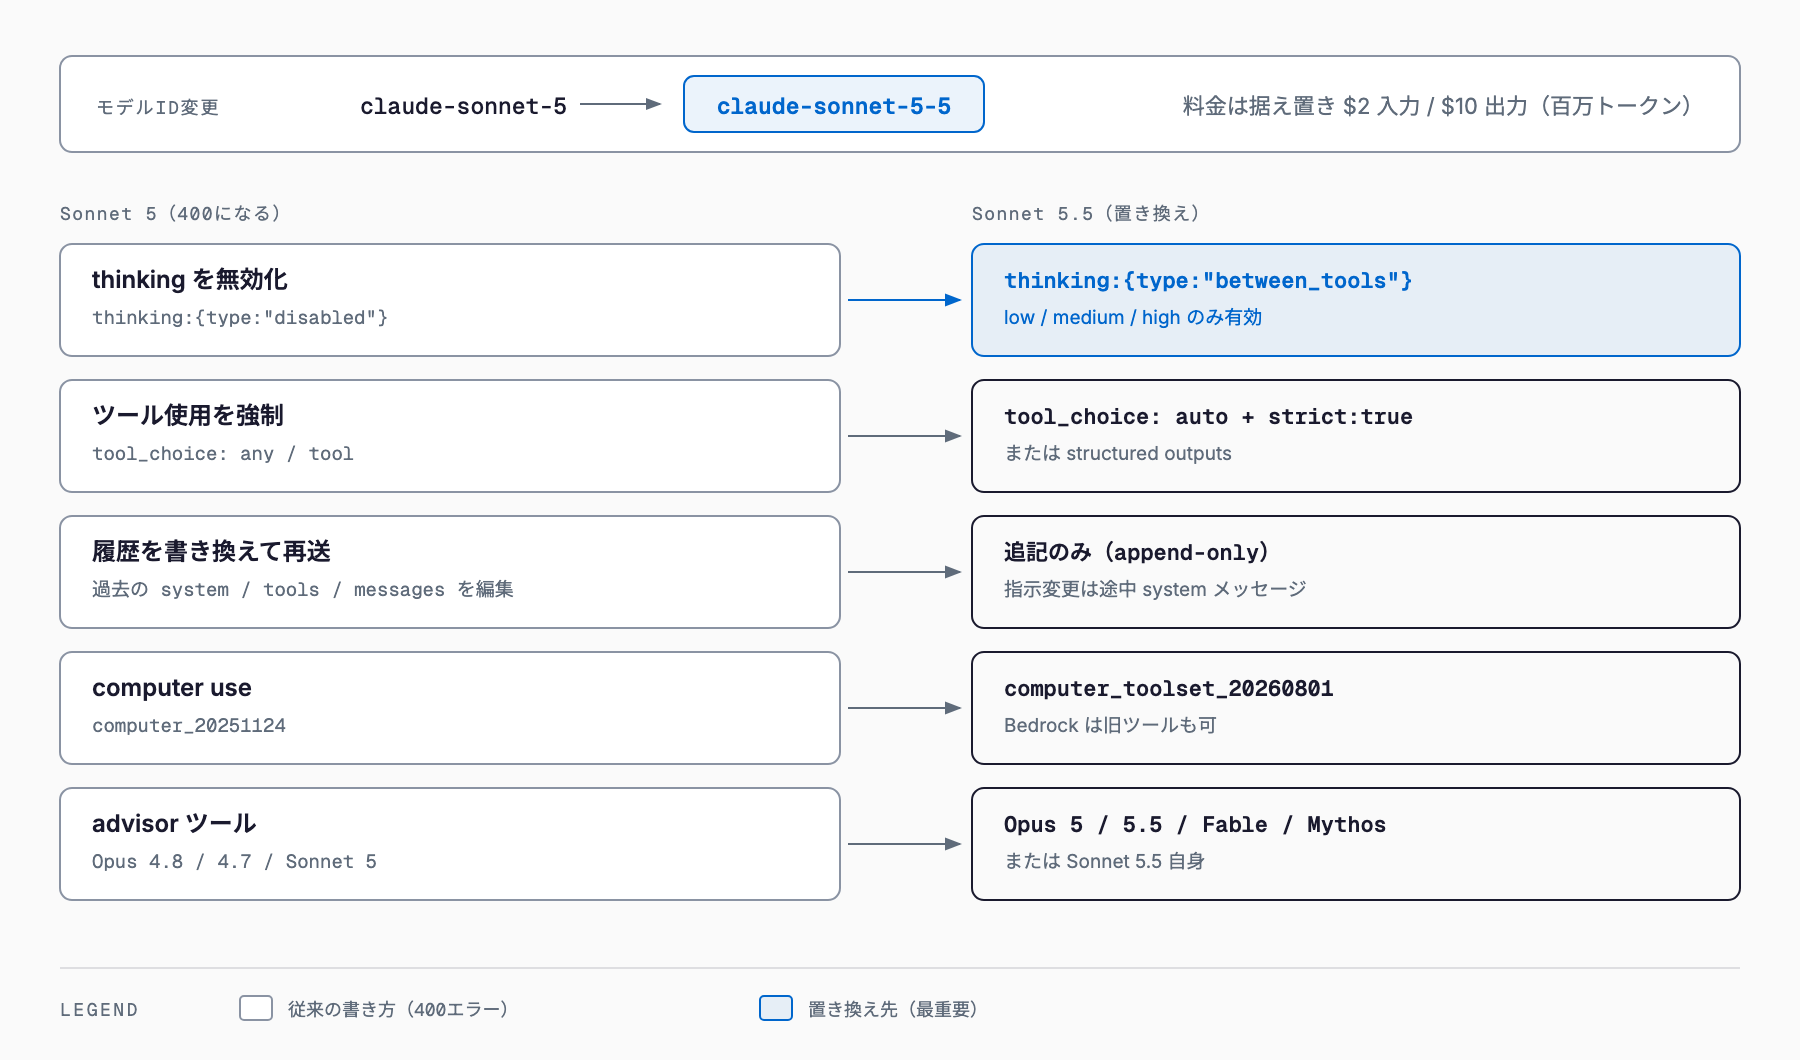
最初の一歩は、モデル文字列を claude-sonnet-5 から claude-sonnet-5-5 に変えることです。ただし Sonnet 5.5 には、既存コードが 400 エラーになる変更が5つあります。テスト環境でモデル文字列だけ切り替えて、エラーが出る箇所から順に直していくのが早道です。
1. thinking: {"type": "disabled"} と手動 budget_tokens は 400 エラー。thinking を完全に無効化することはできなくなりました。代わりに thinking: {"type": "between_tools"} を使います。これは最小の設定で、最初に行う思考をオフにし、ツール呼び出しの合間だけ考えさせるものです。指定できるのは effort が low / medium / high のときだけで、xhigh / max と組み合わせると 400 になります。
2. 強制的なツール利用は非対応。tool_choice に {"type": "any"} や {"type": "tool", ...} を指定すると「このモデルでは tool と any はサポートされない」という 400 エラーになります。auto に切り替え、ツール定義に strict: true(strict tool use)を付けるか、structured outputs でスキーマを保証します。抽出パイプラインなど「必ず特定のツールを呼ばせる」設計は要見直しです。
# Sonnet 5 の書き方(Sonnet 5.5 では 400 エラー)
response = client.messages.create(
    model="claude-sonnet-5",
    max_tokens=2048,
    thinking={"type": "disabled"},
    tool_choice={"type": "tool", "name": "extract_invoice"},
    tools=tools,
    messages=messages,
)
# Sonnet 5.5 での書き換え
response = client.messages.create(
model="claude-sonnet-5-5",
max_tokens=2048,
thinking={"type": "between_tools"}, # 最小設定。effort は low / medium / high のみ
tool_choice={"type": "auto"},
tools=[{**t, "strict": True} for t in tools], # strict tool use でスキーマを保証
messages=messages,
)3. thinking ブロックがモデルと会話に紐づく。以前の system・tools・messages を書き換えたうえで、Sonnet 5.5 が返した thinking ブロックを含む履歴を再送すると 400 になります。2026年8月31日以降に作成されたアカウントでは既定で強制されます。thinking ブロックは生成したアカウントにも紐づき、別アカウントのブロックは破棄されます。会話履歴は追記のみ(append-only)で管理し、途中で指示を変えたいときは後述の会話途中の system メッセージを使います。過去メッセージを要約・削除して圧縮している実装は特に注意が必要です。
4. Computer use のツール定義が変わる。computer_20251124 は Claude API と Google Cloud で拒否されるため、computer_toolset_20260801 に置き換えます。Amazon Bedrock は現時点で旧ツールも受け付けます。OSWorld 2.1 の伸びを活かしたい場合の必須作業です。
5. Advisor tool の組み合わせ制限。Sonnet 5.5 を executor にした場合、Opus 4.8・Opus 4.7・Sonnet 5 を advisor に指定すると拒否されます。advisor には対応する新しいモデルを選び直してください。
エラーにはならない変更にも注意が必要です。ツール呼び出しの合間のテキストが、thinking の進捗更新ブロックとして返るようになりました。既定の表示設定(display が omitted)では中身が空のため、ストリーミング UI が途中で静かになったように見えます。thinking.display を設定するか between_tools を使って対処してください。また、拒否応答は HTTP 200 で stop_reason: "refusal" として返り、stop_details に cyber / bio / frontier_llm / reasoning_extraction / general_harms のカテゴリが付きます。HTTP エラーだけを見ている実装では拾えないので、ハンドリングを追加してください。
温度まわりも変わっています。temperature・top_p・top_k を既定値以外にすると 400 エラーになります。Sonnet 5 の時点から同じ制約が残っているコードは少ないかもしれませんが、共通ラッパーで一律に温度を渡していないか確認しておくと安全です。
移行チェックリスト
- モデル文字列を claude-sonnet-5-5(Bedrock は anthropic.claude-sonnet-5-5)に変更した
- thinking: disabled と budget_tokens を削除し、必要なら between_tools に置き換えた(xhigh / max との併用なし)
- tool_choice の any / tool を auto + strict: true または structured outputs に変更した
- 会話履歴が append-only で、system・tools を書き換えたあとに古い thinking ブロックを再送していない
- Computer use を computer_toolset_20260801 に更新した(Claude API / Google Cloud)
- Advisor tool の advisor に Opus 4.8 / 4.7 / Sonnet 5 を使っていない
- temperature / top_p / top_k を既定値以外にしていない
- ストリーミング UI が thinking の進捗ブロックで止まって見えないか確認した
- stop_reason: "refusal" のハンドリングを追加した
- effort を再調整した(下の節を参照)
Sonnet 5.5 の新機能
- メッセージ単位の effort(beta): 会話の途中でも、リクエストごとに effort を切り替えられます。簡単な問い合わせは low、難所だけ high、といった動的な調整に向きます
- 会話途中の system メッセージ: 履歴を書き換えずに指示を追加できます。破壊的変更3の append-only 運用と組み合わせて使う機能です
- 会話途中のツール変更(beta): 会話の途中でも利用可能なツールを入れ替えられます
- オンデマンドの compaction: beta ヘッダー compact-2026-09-04 で、長くなった会話の圧縮を必要なタイミングで実行できます
- メッセージ内でのツール定義(beta): beta ヘッダー inline-tools-2026-09-15 で、ツールをメッセージ内で定義できます
- 512 トークンからのキャッシュ: 最小キャッシュ可能プロンプトが Sonnet 5 の 1,024 から 512 トークンに下がりました
beta 機能は仕様が変わる可能性があるため、本番投入前に公式ドキュメントの最新の記載を確認してください。
effort の調整のコツ
Sonnet 5.5 では effort の段階が Sonnet 5 から再調整されています。同じ high でも挙動が同じとは限らないため、移行後は必ず effort を振って評価し直してください。公式の目安は次の通りです。
- エージェント的なコーディング: medium から始め、難しいタスクで足りなければ high
- チャットなど遅延に敏感な用途: medium または low
- thinking を最小にしたい: low などと between_tools を組み合わせる
- 既定は high: 何も指定しない場合、Opus 5.5(既定 medium)より深く考える設定になるため、コストとレイテンシを見ながら下げる
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    effort="medium",  # 未指定なら high。エージェント的なコーディングは medium から試す
    messages=[{"role": "user", "content": "失敗しているテストを直してください"}],
)
評価は、代表的な20〜50件のタスクで effort を low・medium・high と変えて、成功率・トークン数・所要時間を並べると判断しやすくなります。成功率が横ばいなら、低い effort を採用するだけでコストと速度の両方が改善します。
よくある質問
Claude Sonnet 5.5 の料金はいくらですか?
input $2 / output $10(1Mトークンあたり)で、Sonnet 5 と同額です。キャッシュは5分書き込み $2.50、1時間書き込み $4、読み込み $0.20 で、Batch API は50%割引です。Anthropic は、より速くツール呼び出しが減ることでタスクあたりコストが最大30%下がると説明しています。
Sonnet 5.5 と Sonnet 5 の違いは何ですか?
価格とトークナイザーは同じで、性能と挙動が変わりました。公表値では Terminal-Bench 4.0 が10.3%から70.6%、CursorBench 4.0 が34.1%から55.5%、OSWorld 2.1 が57.0%から80.1%に向上し、出力は30%以上高速とされています。API には thinking の無効化や強制ツール利用などの破壊的変更が5つあります。
Sonnet 5 のコードはモデル文字列を変えるだけで動きますか?
動かない場合があります。thinking: disabled、tool_choice の any / tool、コンピュータ操作の旧ツール、旧モデルの advisor などを使っていると 400 エラーになります。テスト環境でモデル文字列だけ切り替え、エラーに沿って修正するのが効率的です。
thinking を無効にしたい場合はどうすればよいですか?
完全な無効化はできません。thinking に type: between_tools を指定すると、最初の思考をオフにしてツール呼び出しの合間だけ考えさせる最小設定になります。effort が low / medium / high のときだけ使え、xhigh や max と組み合わせると 400 エラーになります。
Opus 5.5 ではなく Sonnet 5.5 を選ぶべきなのはどんなときですか?
量が多く速度とコストを重視するコーディング補助やコンピュータ操作では、Sonnet 5.5 が第一候補です。単価は Opus 5.5 の半分で、CursorBench では差が2ポイント以内とされています。長時間の自律作業や持続的な判断が要る複雑なタスクは Opus 5.5 のほうが強いと Anthropic は説明しています。
お気軽にご相談ください
お問い合わせ