GPT-6 Sol/Luna vs Grok 4.7 料金比較【2026年9月】
OpenAIは2026年9月22日にGPT-6 Sol($2/$10)とGPT-6 Luna($0.10/$0.50、いずれも1Mトークンあたり)を、xAIは前日にGrok 4.7($2/$6、20万トークン超は$4/$12)を発表した。Claude Opus 5.5($4/$20)も含めた料金比較表・月額コスト試算・ベンチマークを整理する。
OpenAIは2026年9月22日にGPT-6 Sol(入力$2・出力$10、1Mトークンあたり)とGPT-6 Luna(入力$0.10・出力$0.50)を、xAIは前日9月21日にGrok 4.7(入力$2・出力$6、20万トークン超は$4/$12)を発表した。大量処理はGPT-6 Lunaが圧倒的に安く、汎用コーディングはGPT-6 SolかGrok 4.7が中間コストで拮抗し、最難関タスクだけClaude Opus 5.5やGPT-6 Astraのような高単価モデルに回す、という3層構成が2026年9月時点の実務的な結論である。
主な変更点
- GPT-6 Sol/Lunaが恒久的に50%値下げ — GPT-5.6 Sol($4/$20)からSolは正確に50%、GPT-5.6 Luna($0.20/$1.20)からLunaは入力50%・出力58.3%の値下げで、いずれもプロモーション価格ではなく恒久価格とOpenAIは説明している
- Grok 4.7は単価据え置きで性能のみ向上 — xAIはGrok 4.6と同じ$2/$6(20万トークン以下)を維持したまま、DeepSWE v1.1やTerminal-Bench 4.0などコーディング系ベンチマークを底上げした
- 3社が同一週内に新モデルを投入 — Claude Opus 5.5(9月22日、$4/$20)がGrok 4.7の翌日・GPT-6 Sol/Lunaのわずか約90分前に発表されており、フロンティアモデルの値下げ競争が激化している
いずれもGPT-6 Astra($10/$50、9月3日発表)より安価な中位〜軽量モデルという位置づけで、OpenAIは3段階(Astra/Sol/Luna)、xAIはGrok 4.7とその高速版Grok 4.7 Fastという構成を取っている。2026年7月時点のGPT-5.6とGrok 4.5の料金比較と比べても、わずか2か月で主要モデルの単価が軒並み下がっていることが分かる。
料金比較表
1Mトークンあたりの料金は以下の通りである(1ドル=約150円換算)。
| モデル | インプット | キャッシュ入力 | アウトプット | コンテキスト長 | 備考 |
|---|---|---|---|---|---|
| GPT-6 Sol | $2 | $0.20 | $10 | 約105万トークン | 2026-09-22公開・恒久価格 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | 約105万トークン | 2026-09-22公開・恒久価格 |
| Grok 4.7(20万トークン以下) | $2 | $0.50 | $6 | 50万トークン | 2026-09-21公開 |
| Grok 4.7(20万トークン超) | $4 | $1 | $12 | 50万トークン | リクエスト全体に適用 |
| Grok 4.7 Fast | 上記の2倍 | — | 上記の2倍 | 50万トークン | Cursor・Grok Build限定 |
| Claude Opus 5.5(参考) | $4 | $0.20 | $20 | 100万トークン | 2026-09-22公開 |
| GPT-5.6 Sol(旧・参考) | $4 | — | $20 | — | 値下げ前の価格 |
注意点が2つある。ひとつはGrok 4.7の「20万トークンの崖」で、プロンプトがこの閾値を超えるとリクエスト全体の単価が2倍になる(GPT-6 Astraの272Kトークンの崖と似た構造)。もうひとつはキャッシュ入力の割引率で、GPT-6 Sol/Lunaは通常単価の約90%オフ(10%の単価)なのに対し、Grok 4.7は75%オフ(25%の単価)と割引率が異なる。
月額コスト試算
目安として、月間で入力1億トークン・出力2000万トークンを処理するワークロードを想定すると、概算費用は次のようになる(公表単価ベースの単純試算で、キャッシュ入力の割引は考慮していない)。
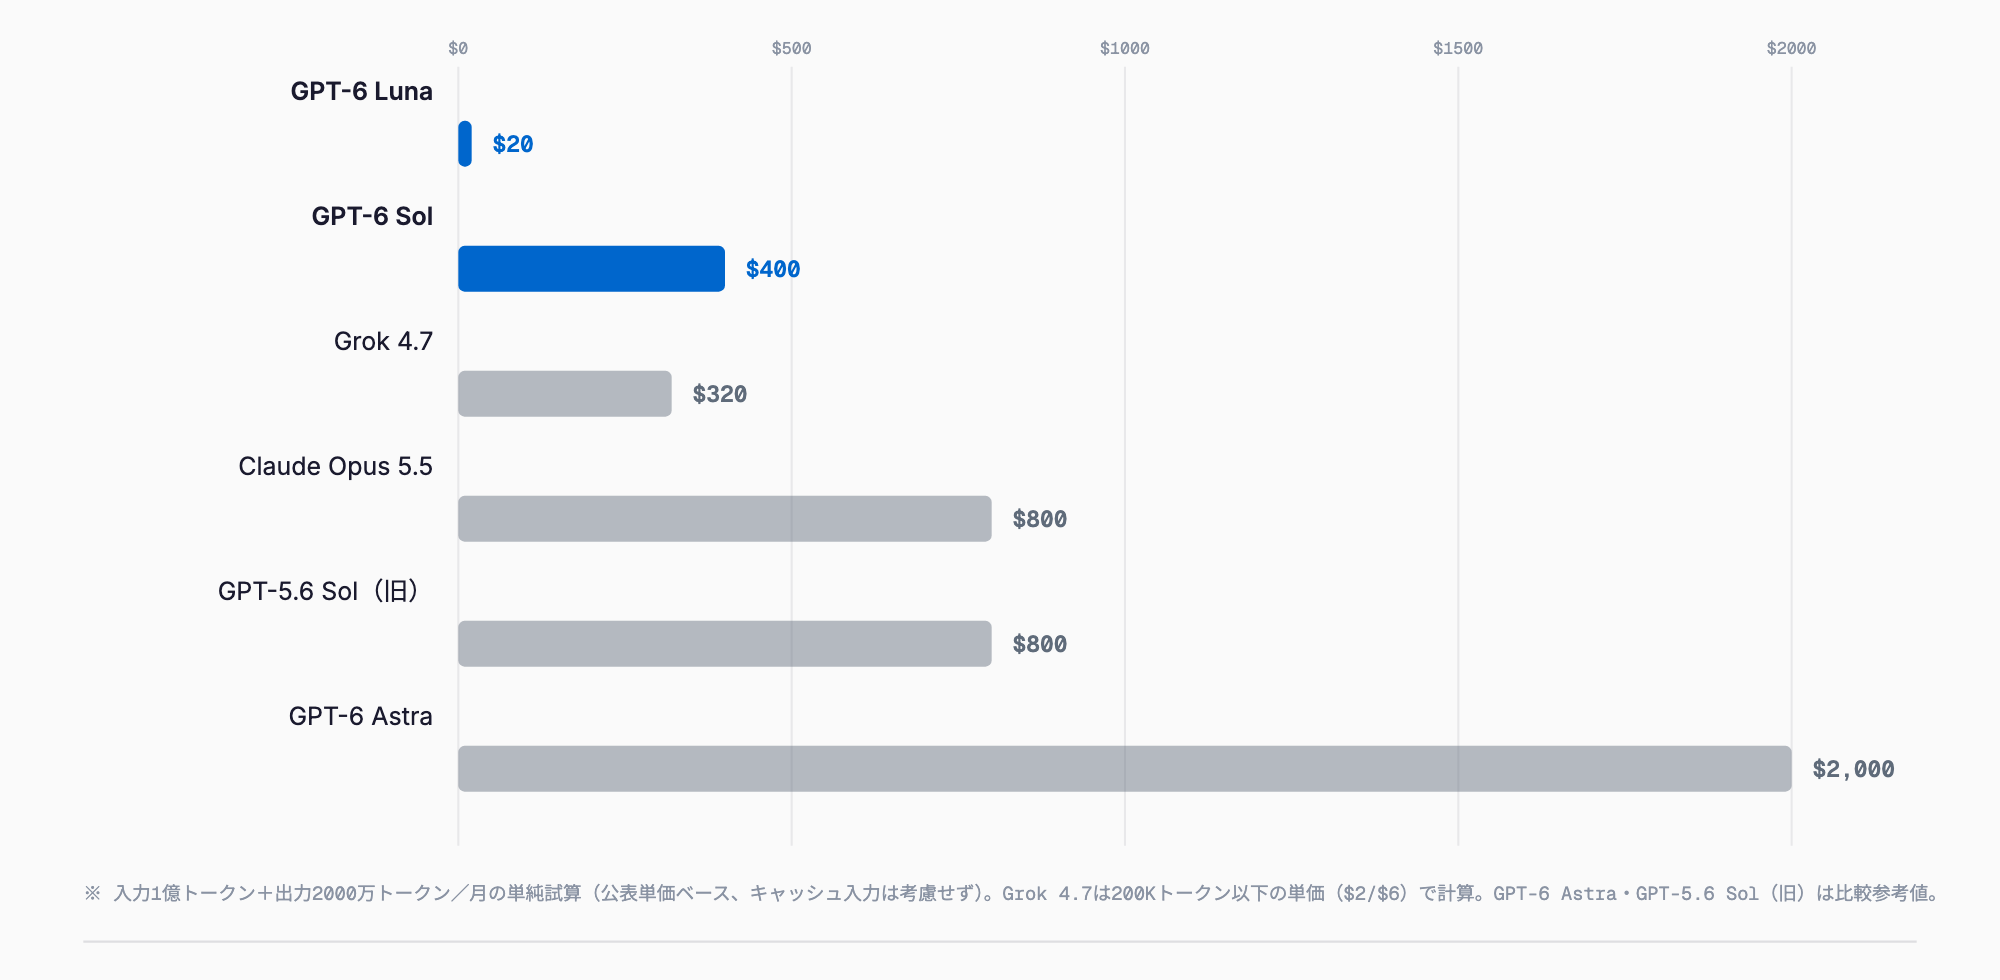
| モデル | 月間概算費用 | 概算円換算 | 想定用途 |
|---|---|---|---|
| GPT-6 Luna | $20 | 約3,000円 | 定型処理・大量バッチ |
| Grok 4.7(20万トークン以下) | $320 | 約48,000円 | エージェント型コーディング |
| GPT-6 Sol | $400 | 約60,000円 | 汎用コーディング・調査 |
| Claude Opus 5.5 | $800 | 約120,000円 | 高精度エージェントタスク |
| GPT-5.6 Sol(旧価格・参考) | $800 | 約120,000円 | 値下げ前の水準 |
| GPT-6 Astra | $2,000 | 約300,000円 | 最高難度タスク限定 |
この試算ではLunaはSolの約20分の1、Grok 4.7の約16分の1のコストに収まる。ただし精度が伴わなければ再実行コストで相殺されるため、後述のベンチマークと合わせて用途ごとに検討する必要がある。
ベンチマーク比較
OpenAIとxAI、それぞれの発表資料に基づく主要ベンチマークは以下の通りである。測定方法(reasoning effort・エージェントの実行環境など)が各社・各ベンチマークで異なるため、数値は目安として捉えたい。
| ベンチマーク | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| AutomationBench 1.0.6 | 33.2%(xhigh) | 20.7%(max) |
| DeepSWE v1.1 | 68.8%(max) | 66.6%(max) |
| FrontierCode 1.1 | 49.3%(max) | 42.4%(max) |
| OSWorld 2.0 | 64.4%(max) | 52.7%(max) |
| Agents' Last Exam v1 | 56.4%(max) | 50.9%(max) |
| Artificial Analysis Intelligence Index | 48(#18/211) | 37 |
| ベンチマーク | Grok 4.7 | Grok 4.6からの変化 |
|---|---|---|
| DeepSWE v1.1(high effort) | 71.0% | +5.8pt |
| CursorBench 4.0 | 46.3% | +5.9pt |
| Senior SWE-Bench(pass@3) | 40.0% | +1.1pt(38.9%→40.0%) |
| Terminal-Bench 4.0(Grok Build併用) | 33% | +15pt(18%→33%) |
| Artificial Analysis Coding Agent Index(Grok Build併用) | 56 | +9(47→56) |
GPT-6 SolはDeepSWE v1.1・FrontierCode 1.1・OSWorld 2.0のいずれでもLunaを上回り、Artificial Analysis Intelligence Indexでも48対37とスコア差がはっきり出ている。一方でGrok 4.7は単体の絶対スコアよりもGrok 4.6からの伸び幅が特徴で、特にTerminal-Bench 4.0(Grok Build併用、+15pt)とDeepSWE v1.1(high effort、+5.8pt)の改善が大きい。ただしOpenAIのAutomationBenchとxAIのArtificial Analysis Coding Agent Indexは評価軸も採点方法も異なるため、この2系統のスコアをそのまま横に並べて優劣を断定することはできない。
使い分け
- GPT-6 Lunaが向く場面: 大量の定型分類・要約・簡易Q&Aなど、1タスクあたりの単価がそのまま損益に直結する高ボリューム処理
- GPT-6 Sol・Grok 4.7が向く場面: 汎用的なコーディング支援やエージェント的なタスクで、Lunaでは精度不足だがAstraやOpus 5.5ほどのコストは避けたい中間層。500Kトークンの長文コンテキストを活かした一括レビューにはGrok 4.7が有利
- 高単価モデルが向く場面: FrontierMathやGPQA Diamondのような高難度の数学・科学的推論、セキュリティリサーチのように誤りの許容度が低いタスクには、単価の高いOpus 5.5やAstraを検討する。GitHub CopilotでのGPT-6 Astra GAのように、開発ツール側の統合状況も選定材料になる
- コスト管理の実務: Grok 4.7は20万トークン、GPT-6 Astraは272Kトークンとそれぞれ異なる「価格の崖」を持つため、プロンプト設計時にどちらの境界に該当するかを事前に見積もる
API の始め方
いずれのモデルも既存のSDKからモデル名を切り替えるだけで利用できる。
OpenAI: GPT-6 Sol / Luna
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-sol",  # 軽量な処理には "gpt-6-luna"
    input="このコードのバグを修正してください",
    reasoning={"effort": "medium"},
)
print(response.output_text)
xAI: Grok 4.7
from openai import OpenAI

# Grok APIはOpenAI互換のエンドポイントを提供
client = OpenAI(api_key="XAI_API_KEY", base_url="https://api.x.ai/v1")

response = client.chat.completions.create(
    model="grok-4.7",
    messages=[
        {"role": "user", "content": "このリポジトリの失敗しているテストを直してください"}
    ],
    reasoning_effort="high",  # 省略時のデフォルト
)
print(response.choices[0].message.content)
Anthropic: Claude Opus 5.5(参考)
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=4096,
    effort="medium",
    messages=[
        {"role": "user", "content": "同じタスクをOpus 5.5で実行してコストと精度を比較したい"}
    ],
)
print(response.content)
注意点
ベンチマーク数値はいずれもOpenAI・xAI・Anthropic各社の発表資料に基づくものであり、第三者による独立検証ではない。特にGrok 4.7の「Grok Build併用」スコアはAPI単体の性能ではなくエージェント実行環境込みの数値である点に注意が必要である。また知識カットオフはGPT-6 Solが2026年4月20日、GPT-6 Lunaが2026年5月18日と公表資料で確認できる一方、Grok 4.7については出典により2026年5月〜6月と幅があり、xAIの一次情報では明記が見当たらなかった。Grok 4.7 Fastは公開APIでは提供されておらずCursor・Grok Build限定であること、料金・提供モデルは今後変更される可能性があることも踏まえ、実際の導入前には各社の公式ドキュメントで最新の料金・提供状況を確認したい。
よくある質問
GPT-6 SolとGPT-6 Lunaの料金はいくらですか。
OpenAIの発表資料によれば、1Mトークンあたり GPT-6 Sol が入力$2・キャッシュ入力$0.20・出力$10、GPT-6 Luna が入力$0.10・キャッシュ入力$0.01・出力$0.50である。いずれも恒久価格(プロモーション価格ではない)とされ、旧世代のGPT-5.6 Sol($4/$20)・GPT-5.6 Luna($0.20/$1.20)からそれぞれ50%前後値下げされている。
Grok 4.7の料金体系はどうなっていますか。
xAIの発表によれば、1Mトークンあたりプロンプトが20万トークン以下の場合は入力$2・キャッシュ入力$0.50・出力$6、20万トークンを超えるとリクエスト全体で入力$4・キャッシュ入力$1・出力$12に切り替わる。前世代のGrok 4.6と同じ単価で、値上げなしに性能のみが向上している。
GPT-6 Sol/Luna・Grok 4.7・Claude Opus 5.5のうち最も安いのはどれですか。
単価・月間コストとも最も安いのはGPT-6 Lunaである。入力1億トークン+出力2000万トークンの試算では、Lunaが約20ドルに対し、Grok 4.7(20万トークン以下)は約320ドル、GPT-6 Solは約400ドル、Claude Opus 5.5は約800ドルとなる。
Grok 4.7 Fastはどこで使えますか。
Grok 4.7 Fastは通常の2倍の単価で2倍の速度を狙ったモードだが、公開のxAI APIでは提供されておらず、CursorとGrok Buildからのみ利用できる。
GPT-6 Sol・LunaとClaude Opus 5.5はどう使い分ければよいですか。
大量の定型処理や単価最優先のタスクにはLuna、汎用的なコーディング・エージェントタスクにはSolやGrok 4.7、失敗コストが高い専門領域やFable 5.1級の性能が必要な場面には単価の高いOpus 5.5やGPT-6 Astraを検討するのが実務的な使い分けである。
お気軽にご相談ください
お問い合わせ