Graphify とは — コード・ドキュメント・PDFをナレッジグラフにしてコーディングエージェントに引かせるOSS(
Claude Code・Cursor・Codex対応、ベクトルRAG・Serena・OpenViking・Hindsightとの違い)【2026年版】
Graphifyは、コード・ドキュメント・SQLスキーマ・PDFを問い合わせ可能なナレッジグラフに変換し、Claude Codeなど20超のエージェントから引かせるOSS。コード解析はLLM不要でローカル完結。インストール、使い方、ベクトルRAG・Serena等との違いを整理。2026年10月更新。
Graphify(Graphify-Labs/graphify)は、コードベースとそのドキュメント・SQLスキーマ・設定・PDFを「問い合わせ可能なナレッジグラフ」に変換し、Claude Code・Cursor・CodexなどのコーディングエージェントからスキルやCLI、MCP経由で引けるようにするPython製のオープンソースツールである。結論として、大規模リポジトリで「エージェントが毎回ファイルをgrepして全体像を取り違える」問題に対する、ベクトル検索とは別系統の解決策であり、コードの解析はLLMなしでローカル完結する点が実務上の要点になる。
GitHub上の星は2026年10月時点で約13.5万と非常に大きく、AIエージェント向け開発ツールの中でも注目度が高い。公式READMEの記述を元に、仕組み・インストール・料金・既存手法との違いを整理する。
Graphifyとは
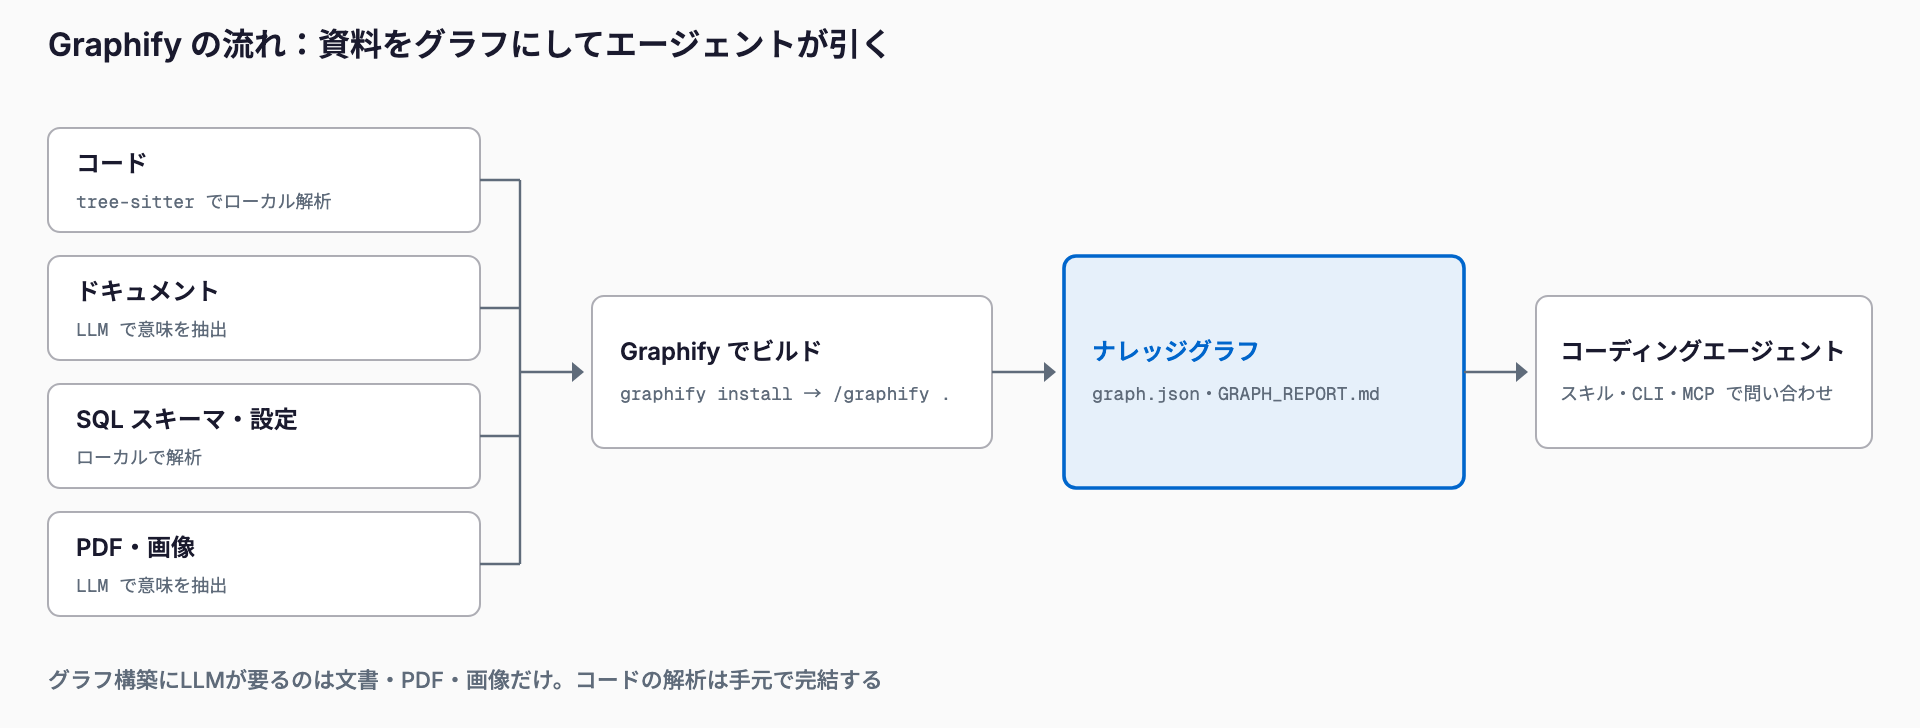
リポジトリ内のソースコードをtree-sitterで構文解析し、関数・クラス・呼び出し・importなどの関係をノードとエッジにしてグラフ化する。ドキュメント・PDF・画像などは、使っているエージェントのモデル(または設定したAPIキー)で意味抽出し、同じグラフに統合する。エッジには「ソースに明示されている(EXTRACTED)」か「Graphifyが推論した(INFERRED)」かの印が付き、根拠の強さを区別できる。
| 項目 | 内容 |
|---|---|
| 提供元 | Graphify-Labs(GitHubリポジトリ Graphify-Labs/graphify) |
| ライセンス | Apache-2.0 と MIT のライセンスファイルを同梱(二次情報ではMITとのみ書くものもあり、利用前にリポジトリで確認) |
| 言語・要件 | Python 3.10以上。インストールはuv推奨(pipx・pipも可) |
| 解析対象 | 約40のプログラミング言語(tree-sitter)、ドキュメント、PDF、画像、音声・動画(faster-whisperでローカル文字起こし)、SQLスキーマ、設定、Terraform/HCL、docx・xlsx |
| 出力 | graphify-out/ に graph.html・GRAPH_REPORT.md・graph.json |
| ストレージ | JSONファイルが基本。ベクトルストア・埋め込みは使わない。Neo4j・FalkorDBへの書き出しは任意 |
| クラスタリング | Leiden法(leiden extra未導入時はnetworkxのLouvain) |
| 問い合わせ手段 | スキル(/graphify)、CLI(query・path・explain)、MCP stdioサーバー、graph.jsonの直接読み取り |
| 対応エージェント | Claude Code、Cursor、Codex、Gemini CLI、GitHub Copilot CLI、VS Code Copilot Chat、Aider、OpenClaw、Kiro、Amp、OpenCode、Kilo Codeなど20超+汎用Agent Skills |
| 料金 | OSS本体は無料。ホスト版「Graphify Cloud」は14日間の無料トライアルのみ公式READMEに記載、有料プランの価格は未公表 |
何ができるか
| 機能 | 内容 |
|---|---|
| コードのグラフ化 | tree-sitterによる決定的な解析。LLMは使わず、コードが外部に出ない |
| 文書・PDF・画像の統合 | エージェントのモデルかAPIキーで意味抽出し、コードのノードと結ぶ |
| 設計意図の取り込み | # NOTE: # WHY: コメントやADR・RFCの引用をノード化し、コードにひも付ける |
| 経路・説明の問い合わせ | query(質問)、path(2点間の経路)、explain(1ノードの説明) |
| 増分更新 | --update で変更分だけ再構築、graphify hook install でGit連携 |
| 可視化・レポート | graph.html(インタラクティブ表示)とGRAPH_REPORT.md(要約) |
| 複数グラフの統合 | graphify merge-graphs で複数リポジトリのグラフを結合 |
| ローカル完結モード | GRAPHIFY_BACKEND=none でLLMバックエンド無効、ollama なら意味抽出もローカルで実行 |
インストール・料金
uv tool install graphifyy      # または: pipx install graphifyy / pip install graphifyy
graphify install               # プロジェクト単位にする場合: graphify install --project
PyPI上のパッケージ名は graphifyy(yが2つ)である点に注意。PDF・Office・動画・MCP・SQL・Leidenなどは extras(pdf office video mcp sql leiden all)で追加する。料金はOSS本体が無料で、LLMを使う意味抽出の費用は自分のエージェントのモデルやAPIキーの利用料として別にかかる。ホスト版のGraphify Cloudは常時更新のグラフ、モノレポ・クロスリポジトリ対応、コードレビュー、Sentry・Jira連携をうたい、公式READMEでは「トークン消費を80%削減」と主張しているが、独立した検証は見当たらないため鵜呑みにしない。
使い方(最短手順)
- 1. uv tool install graphifyy でCLIを入れ、graphify install で使っているエージェントにスキルを登録する
- 2. エージェントを開き、プロジェクトのルートで /graphify . を実行してグラフを作る(Codexでは $graphify)
- 3. graphify-out/GRAPH_REPORT.md と graph.html で全体像とコミュニティ(まとまり)を確認する
- 4. 以降は質問のたびに /graphify query や path・explain で引く。コードを変えたら --update で差分だけ更新する
/graphify .
/graphify query "what connects auth to the database?"
/graphify path "UserService" "DatabasePool"
/graphify explain "RateLimiter"
/graphify ./docs --update
graphify hook install
既存ツールとの違い
| ツール | 何を保持・検索するか | 主な構造 | LLMの要否 | 向く場面 |
|---|---|---|---|---|
| Graphify | コード・文書・スキーマ・PDFの関係(呼び出し、依存、設計意図) | ナレッジグラフ(JSON、任意でNeo4j) | コード解析は不要、文書・PDFは必要 | 「AとBはどうつながるか」を大規模リポジトリで辿りたい |
| 素朴なベクトルRAG | 文書やコードの断片を埋め込みで類似検索 | ベクトルDB | 埋め込みモデルが必要 | 曖昧な言い回しの文書検索、FAQ |
| OpenViking | エージェントの文脈(記憶・資料・スキル)を階層管理 | コンテキストDB | 利用形態による | エージェント全体の文脈をまとめて管理したい |
| Hindsight | 会話・作業から学んだ記憶 | エージェントメモリ | 記憶の抽出に使用 | 過去のやり取りを次回に活かしたい |
| Serena(MCP) | シンボル単位の検索・編集・リファクタ(LSPベース、40超の言語) | 言語サーバー(グラフではない) | 不要 | 定義・参照の精密な検索と編集。ライセンスはGPL-3.0-or-later(一部MIT) |
| Sourcegraph | 組織横断のコード検索とコードインテリジェンス | 検索インデックス | 機能による | 複数リポジトリの横断検索(ホスト・商用が中心) |
| akitaonrails/ai-memory | セッション間の引き継ぎ(どこまで進み、何が失敗し、何が残るか) | gitバックのMarkdown wiki+SQLiteインデックス(Rust、MIT) | 既定は不要 | エージェントを切り替えても作業を続けたい |
選び分けの目安は、層で考えると分かりやすい。Graphifyは「コードベースの構造地図」、ai-memoryやHindsightは「作業の記憶・引き継ぎ」、OpenVikingは「文脈全体の置き場」、Serenaは「シンボル単位の精密な検索・編集」である。ai-memoryはコードの関係を解析するツールではなく、セッション間のハンドオフを担う別レイヤーなので、Graphifyと競合せず併用できる。小さなリポジトリならSerenaや通常のgrepで足りることも多く、横断的な依存や設計意図まで辿る必要が出たところでGraphifyが効く。
注意点・向いていない用途
- 文書・PDF・画像の意味抽出ではLLMを使うため、機密文書を扱う場合は送信先(エージェントのモデル/APIキー)を確認する。外部送信を避けるなら GRAPHIFY_BACKEND=ollama か none を使う
- 「トークン80%削減」はGraphify Cloud側の主張で、第三者の検証は未確認。自分のリポジトリで効果を測ってから判断する
- 公式が示すベンチマーク(LOCOMO recall@10 0.497、LongMemEval-S QA 76%など)は主に記憶・QA系の指標で、コーディング成果を直接保証するものではない
- INFERRED(推論)エッジは誤りを含みうる。重要な判断はEXTRACTEDの根拠か実コードで裏取りする
- 星が多い分、Issue・PRも非常に多く(2026年10月時点で数百件ずつ)、挙動やコマンドが頻繁に変わる可能性がある。バージョンを固定して使う
- クエリログが ~/.cache/graphify-queries.log に残る。不要なら GRAPHIFY_QUERY_LOG_DISABLE=1 で止める
- 数十ファイル程度の小規模プロジェクトでは、グラフ構築の手間に見合わないことが多い
エージェントの文脈管理や記憶まわりの関連記事として、OpenViking(エージェント向けコンテキストデータベース)、Hindsight(エージェントメモリ)、archify(エージェントスキルで設計図を描く)もあわせて読むと、各ツールの担当範囲を比べやすい。
よくある質問
Graphifyは無料で使えるか。
OSS本体は無料で、uv・pipx・pipで導入できる。文書やPDFの意味抽出にエージェントのモデルやAPIキーを使う場合は、その利用料が別にかかる。ホスト版のGraphify Cloudは14日間の無料トライアルが公式READMEに載っているが、有料プランの価格は確認できず未公表として扱う。
コードを外部のLLMに送ることになるか。
公式の説明では、コードはtree-sitterでローカル解析し、LLMは使わない。LLMを使うのはドキュメント・PDF・画像などの意味抽出で、GRAPHIFY_BACKEND=none でLLMバックエンドを無効化、ollama を指定すれば意味抽出もローカルで完結する。
どのコーディングエージェントで使えるか。
Claude Code、Cursor、Codex、Gemini CLI、GitHub Copilot CLI、VS Code Copilot Chat、Aider、OpenClaw、Kiro、Amp、OpenCode、Kilo Codeなど20超に対応し、汎用のAgent Skills向けもある。MCP stdioサーバー(mcp extra)経由でも使える。
ベクトルRAGの代わりになるか。
用途が違う。Graphifyは埋め込みやベクトルストアを使わず、呼び出し・依存・設計意図といった関係を辿るのが得意。曖昧な言い回しでの文書検索はベクトルRAGの得意分野なので、置き換えというより補完と考えるのが妥当である。
SerenaやSourcegraphとはどう違うか。
Serenaは言語サーバー(LSP)を使ったシンボル単位の検索・編集ツール、Sourcegraphは組織横断のコード検索基盤で、どちらもグラフを構築して文書やPDFまで統合する用途ではない。Graphifyはコードと文書・スキーマを一つのグラフにまとめて関係を辿る点が異なる。
ai-memoryやHindsightと併用できるか。
役割が別なので併用できる。Graphifyはコードベースの構造地図、ai-memory(Rust製)はセッション間の引き継ぎ、Hindsightは学んだ記憶の保持を担う。どれか一つで全部を賄おうとせず、層ごとに選ぶ。
お気軽にご相談ください
お問い合わせ