Irodori-TTS-v4-Large とは
3.29Bパラメータの日本語TTS。声クローン・Voice Design・絵文字制御の使い方、v4.1-Smallとの違い、ライセンス【2026年9月公開】
Irodori-TTS-v4-LargeはAratako氏が2026年9月に公開した3.29B・日本語専用のTTS。声クローン・Voice Design・絵文字制御に対応し、重みはGemma Terms of Use。v4.1-Smallとの使い分け、使い方、VRAMの扱い、ライセンスの注意点を整理する。
Irodori-TTS-v4-Large は、Aratako 氏が Hugging Face で公開した約 3.29B パラメータの日本語専用 Text-to-Speech モデルだ。リポジトリの作成日は 2026 年 9 月 27 日。入力文・参照音声・キャプション文の 3 条件を 1 つのモデルに統合し、ゼロショットの声クローン、テキストで声を作る Voice Design、参照音声にスタイル指定を重ねる使い方ができる。入力文に絵文字を入れて話し方や非言語音を制御することもできる。
本記事は 2026 年 10 月 1 日時点の公式モデルカード、量子化版モデルカード、GitHub の README に基づいて整理する。必要な VRAM など公式に明記のない点は「公式に明記なし」と書く。ベンチマークの数値はすべて開発者による自動評価で、大規模な人手評価は行われていない点を前提に読んでほしい。
Irodori-TTS-v4-Large とは — 3条件を1モデルにまとめた日本語TTS
モデルカードによれば、v4 系のアーキテクチャを約 766M から約 3.29B パラメータへ約 4.3 倍に大型化したモデルだ。方式は Rectified Flow Diffusion Transformer(RF-DiT)で、設計は Echo-TTS を参考にしたと謝辞に明記されている。音声は 32 次元の連続潜在を持つコーデックで表現し、48kHz で出力する。基本仕様は次のとおり。
| 項目 | 内容 |
|---|---|
| 開発者 | Aratako 氏(モデルカードの引用表記は Chihiro Arata) |
| 公開日 | リポジトリ作成日は 2026-09-27(量子化版・デモ Space も同日作成) |
| パラメータ数 | 約 3.29B(24 層・2,048 次元の Diffusion Transformer) |
| 方式 | Rectified Flow Diffusion Transformer(RF-DiT)、Flow Matching 系 |
| 対応言語 | 日本語のみ |
| 出力 | 48kHz。Aratako/Semantic-DACVAE-Japanese-32dim コーデック(32 次元の連続潜在)で表現 |
| テキストエンコーダ | T5Gemma 2(google/t5gemma-2-1b-1b のテキストエンコーダをファインチューニング)。入力文とキャプションで共有 |
| 参照音声の上限 | 合計 120 秒 |
| 電子透かし | Sony の SilentCipher による不可視の透かしを自動付与(依存とモデルファイルが利用可能な場合) |
| ライセンス | モデル重みは Gemma Terms of Use、コードは MIT |
| 配布サイズ | フル精度 model.safetensors は 13,152,893,348 バイト(約 13.15GB) |
- ゼロショット声クローン: 参照音声を渡すだけで、その話者に近い声で読み上げる
- Voice Design: 声の説明文(キャプション)だけで、参照音声なしに声を作る
- スタイル制御つき声クローン: 参照音声にキャプションを重ね、感情・話し方・環境を指定する
加えて、入力文の絵文字で笑い・咳・ため息などの非言語音や話し方を制御できる(後述)。
仕組み(アーキテクチャ)— 5つの構成要素
モデルカードと README の記述では、v4-Large は次の 5 つの構成要素からなる。入力文とキャプションを同じエンコーダで読み、参照音声から話者の特徴を取り出し、それらを条件として Diffusion Transformer が音声の潜在表現を生成する、という流れだ。
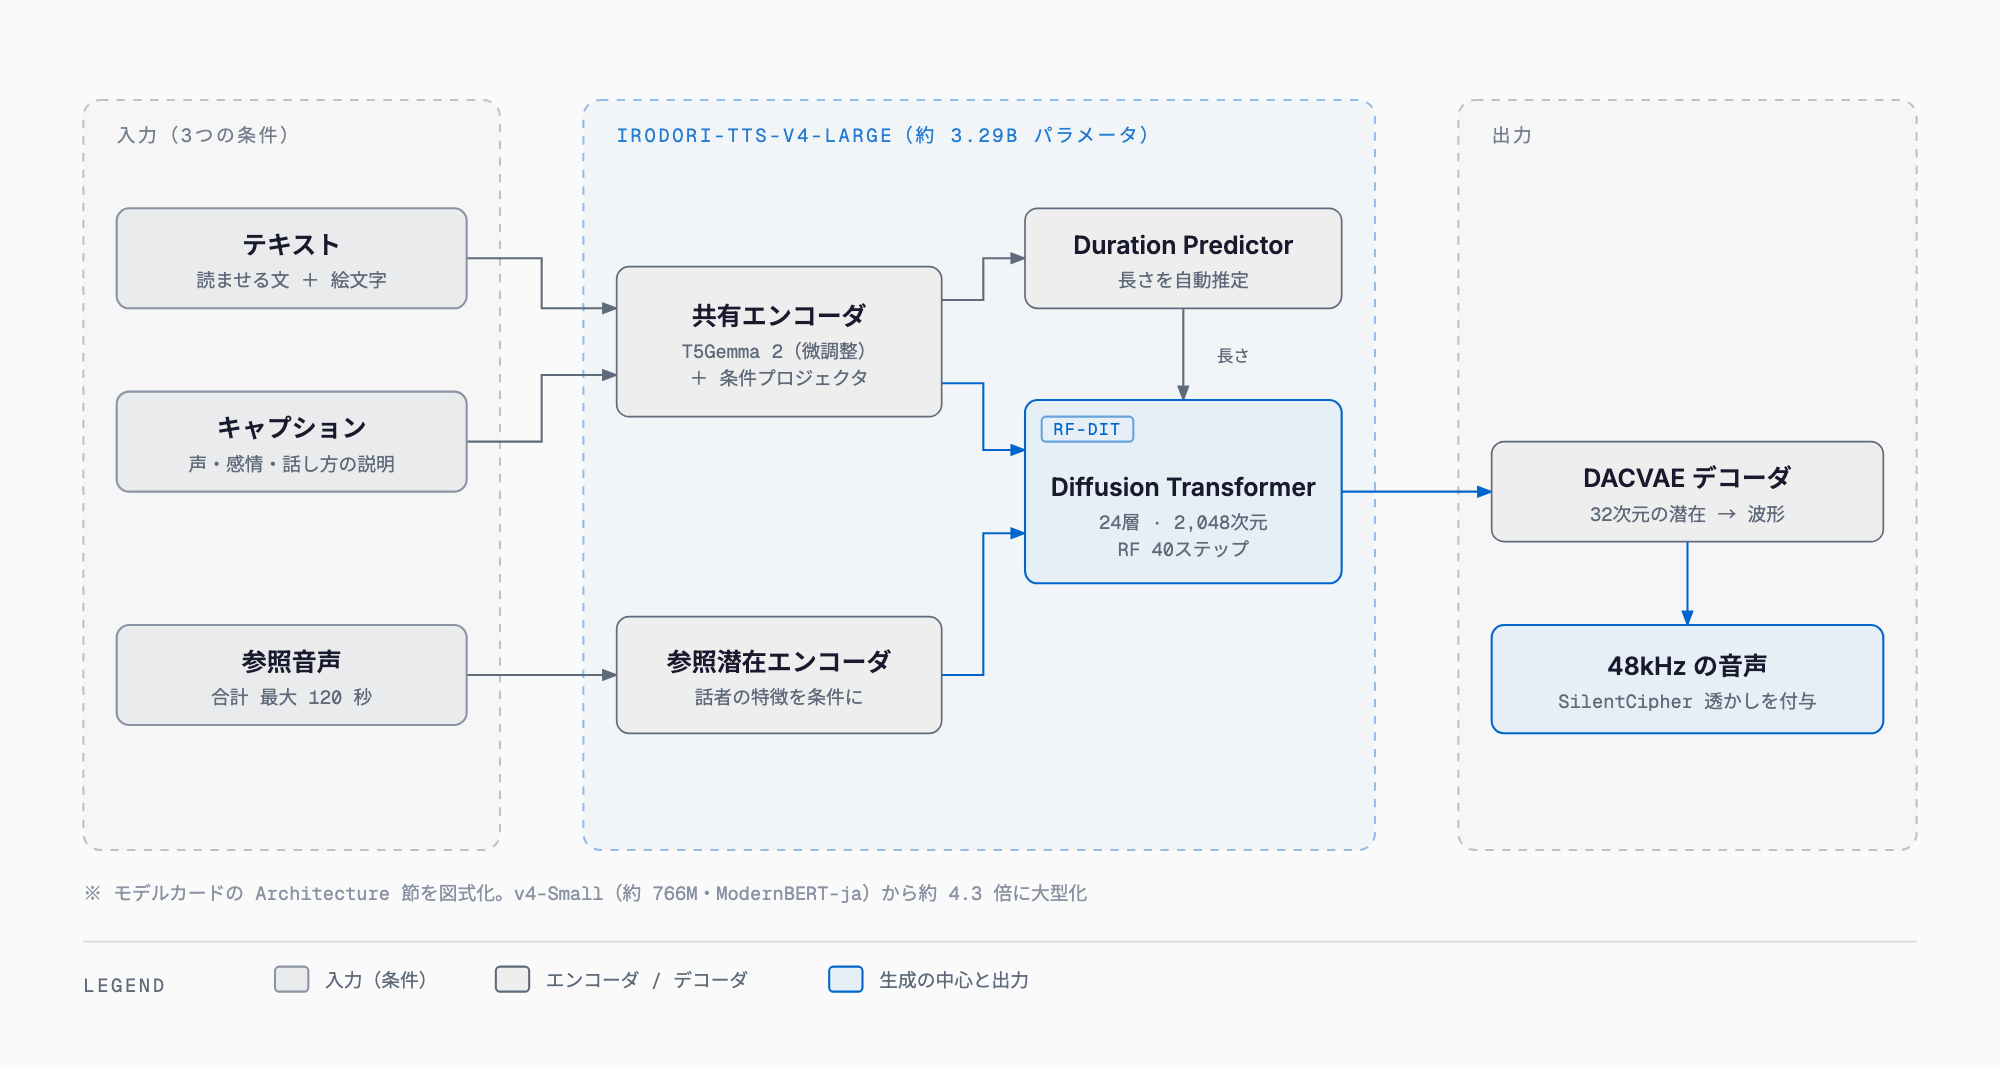
- 共有テキスト/キャプションエンコーダ: ファインチューニング済みの T5Gemma 2。入力文とキャプションの両方を読む
- 条件プロジェクタ: テキスト用とキャプション用を別々に学習する
- 参照潜在エンコーダ: 話者の同一性を条件づける。参照音声は合計最大 120 秒
- Diffusion Transformer: Joint-attention DiT。Low-Rank AdaLN、half-RoPE、SwiGLU MLP を採用
- Duration Predictor: 出力音声の長さを自動推定する。SwiGLU MLP ブロックで構成
v4-Small のテキストエンコーダは ModernBERT-ja(sbintuitions/modernbert-ja-310m)だったが、v4-Large ではこれを T5Gemma 2 のテキストエンコーダ由来のものに置き換えた。この置き換えが、後述するライセンスの違いの原因でもある。Duration Predictor は、本体の学習後に他のパラメータを凍結して別に学習する方式で、v4.1-Small と同じ方式だとモデルカードに書かれている。
v4-Large で変わった点 — v4.1-Small との違い
モデルカードの「What's New」が挙げる変更点は、大型化、T5Gemma 2 エンコーダ、別学習の Duration Predictor、Voice Design スコアの向上の 4 つだ。同じ Irodori-TTS シリーズの小型モデル v4.1-Small(v4-Small のマイナーアップデート)との確定値を並べる。
| 項目 | v4-Large | v4.1-Small |
|---|---|---|
| パラメータ数 | 約 3.29B | 約 766M(v4-Small のモデルカード記載値) |
| テキストエンコーダ | T5Gemma 2(ファインチューニング) | ModernBERT-ja(ファインチューニング) |
| モデル重みのライセンス | Gemma Terms of Use | MIT |
| フル精度ファイル | 約 13.15GB | 約 3.06GB |
| INT8(weight-only) | 3,662 MiB | 872 MiB |
| INT4(weight-only) | 2,818 MiB | 813 MiB |
| 読み正解率(Joyo Parakeet 版) | 92.80% | 93.42% |
| 少ステップ蒸留版 | 公式に明記なし | あり(v4.1-Small-MF、4 ステップ) |
| 参照音声の上限 | 合計 120 秒 | 合計 120 秒 |
注意点として、Voice Design と声クローンのベンチマークは v4-Large と v4-Small(v4.1 ではない)との比較である。シリーズの経緯は、500M(2026-02-25)、500M-v2(03-23)、500M-v2-VoiceDesign(03-30)、500M-v3(05-12)、600M-v3-VoiceDesign(05-31)、v4-Small(08-01)、v4.1-Small(08-11)、v4.1-Small-MF(09-12)、v4-Large(09-27)の順だ(日付は Hugging Face のリポジトリ作成日)。
ベンチマーク — 読みは Small、表現力と声の再現は Large
評価条件はモデルカードによれば、FP32 推論、RF 40 ステップ、text CFG 3.0 で、5 シード(0〜4)の平均±母標準偏差だ。Joyo・JSUT・Coco-Nut・JVS は学習データに含まれない。すべて開発者による自動評価で、大規模な人手 MOS 評価は行っていないと明記されている。まず日本語の読み(参照音声・キャプションなし)から見る。
| ベンチマーク | 指標 | v4.1-Small | v4-Large |
|---|---|---|---|
| 常用漢字読み Parakeet Edition(13,536 文・4,512 の漢字-読みペア) | 読み正解率↑ | 93.42 ± 0.04% | 92.80 ± 0.08% |
| 同上 | Target Kana-CER↓ | 6.88 ± 0.08% | 7.96 ± 0.36% |
| 同上 | Sentence Kana-CER↓ | 1.25 ± 0.01% | 1.51 ± 0.06% |
| 同上 | Text CER↓ | 4.68 ± 0.06% | 4.87 ± 0.08% |
| JSUT BASIC5000 | Sentence Kana-CER↓ | 3.43 ± 0.01% | 3.67 ± 0.03% |
| JSUT BASIC5000 | Standard CER↓ | 7.22 ± 0.12% | 7.30 ± 0.01% |
モデルカードは、読みの誤り率は両ベンチとも v4-Large のほうが v4.1-Small よりわずかに高いと明記している。読みの正確さだけを見れば Small のほうが上だ。次に Voice Design(キャプション追従)。Coco-Nut テストセットの公開声説明 2,890 件に短・中・長の 3 テキストを組み合わせ、1 モデルあたり 8,670 クリップ(参照音声なし)を Gemini 3.6 Flash が 1〜5 で採点した。シード 0 の単一実行だ。
| モデル | 平均スコア↑ | スコア 1–2↓ | スコア 4–5↑ |
|---|---|---|---|
| 600M-v3-VoiceDesign | 4.2096 | 17.09% | 73.30% |
| v4-Small | 4.2339 | 16.78% | 74.12% |
| v4-Large | 4.2991 | 14.63% | 76.24% |
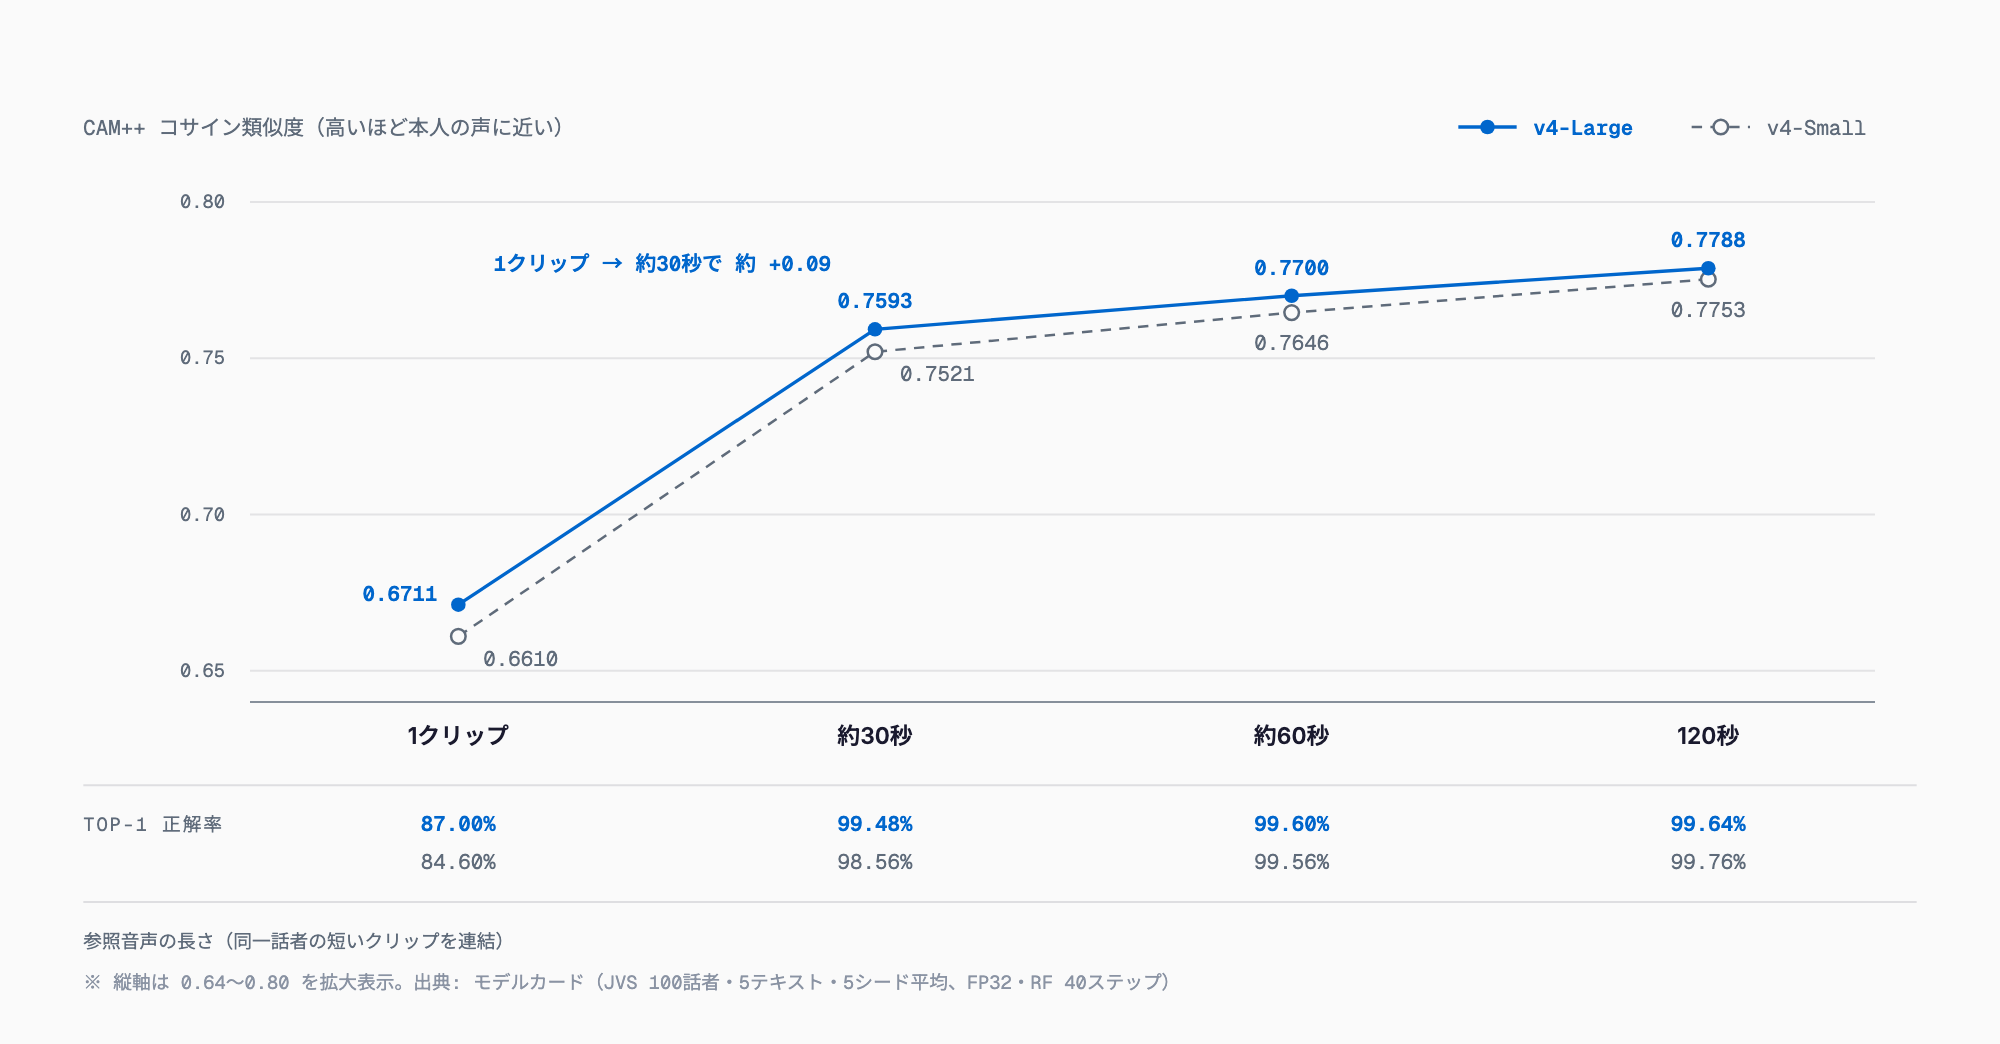
v4-Small との差は +0.0652(95% 信頼区間 [+0.0353, +0.0955])。最も伸びたのは長文テキストで、3.9851 から 4.1343 になった。モデルカード自身が、単一の自動ジャッジによる軽量な内部比較で人手検証はなく、研究グレードのベンチマークではないと注記している。声クローンの評価は JVS の全 100 話者・5 テキスト・5 シード、speaker CFG 5.0 で、参照音声の長さ別に見ている。
| 参照音声 | v4-Small CAM++ cosine↑ | v4-Small top-1↑ | v4-Large CAM++ cosine↑ | v4-Large top-1↑ |
|---|---|---|---|---|
| 1 クリップ | 0.6610 | 84.60% | 0.6711 | 87.00% |
| 約 30 秒 | 0.7521 | 98.56% | 0.7593 | 99.48% |
| 約 60 秒 | 0.7646 | 99.56% | 0.7700 | 99.60% |
| 120 秒 | 0.7753 | 99.76% | 0.7788 | 99.64% |
読み取り方は次のとおり。コサイン類似度は 4 条件すべてで v4-Large が上だが、120 秒の top-1 だけは v4-Large がわずかに下で、差は小さい。伸びの大半は約 30 秒の参照音声で得られており、短い 1 クリップだけだと類似度は大きく下がる。可能なら約 30 秒以上のクリーンな参照音声を使うのが無難だ。繰り返しになるが、これらは自動評価で人手評価はなく、声クローンの比較相手も v4-Small である。
必要スペックと量子化版 — 公式の VRAM 要件は明記なし
モデルカードと量子化版のモデルカードのどちらにも、必要な VRAM は記載されていない(公式に明記なし)。分かるのはチェックポイントのファイルサイズだけで、フル精度の model.safetensors は約 13.15GB。torchao による学習後量子化版は次の 5 種類が公開されている。ファイルサイズは目安であり、実行時は参照音声、CFG の分岐、デコードの分だけ上乗せされるため、ファイルサイズから必要 VRAM を断定することはできない。
| バリアント | 量子化 | サイズ | GPU 対応 | 備考 |
|---|---|---|---|---|
| int8-weight-only | W8A16 | 3,662 MiB | NVIDIA CUDA | 汎用の推奨 INT8 |
| int8-dynamic | W8A8 | 3,662 MiB | NVIDIA CUDA | 活性も動的 INT8 |
| int4-weight-only | W4A16(group size 128) | 2,818 MiB | NVIDIA Ampere 以降(compute capability 8.0+) | 最小 |
| float8-weight-only | FP8 重み・BF16 活性 | 3,665 MiB | NVIDIA Ada / Hopper / Blackwell(8.9+) | |
| float8-dynamic | FP8 重み・動的 FP8 活性 | 3,659 MiB | 同上(8.9+) |
量子化版の実行検証は NVIDIA CUDA のみで、CPU・ROCm・Intel XPU は PyTorch / torchao のカーネル次第でこのリリースでは未検証とされている。推論時は --model-precision bf16 を指定する。まず試すだけなら、ZeroGPU 上で動くデモ Spaceをブラウザで開くのが手軽だ。
使い方 — インストールから声クローン・Voice Design まで
コードは GitHub で公開されており、README は uv を使う手順になっている。まずリポジトリを取得し、バックエンドに合わせた extra で同期する。
```bash
git clone https://github.com/Aratako/Irodori-TTS.git
cd Irodori-TTS
uv sync --extra cu128
```
バックエンドの extra は排他で、cu128(NVIDIA CUDA 12.8、Linux / Windows)、rocm(AMD、Linux / WSL)、xpu(Intel、Linux / Windows)、cpu(CPU のみ、または macOS の CPU / MPS)から選ぶ。同期後は uv run --no-sync で実行する。次は量子化版モデルカードに載っている、int8 版での推論コマンドだ(参照音声なし)。
```bash
uv run --no-sync python infer.py \
  --hf-checkpoint Aratako/Irodori-TTS-v4-Large-Quantized/int8-weight-only \
  --model-precision bf16 \
  --text "こんにちは、私はAIです。これは音声合成のテストです。" \
  --no-ref \
  --output-wav outputs/sample.wav
```フル精度版を使う場合は、--hf-checkpoint を Aratako/Irodori-TTS-v4-Large に差し替える。README の例は v4.1-Small のリポジトリ ID で書かれているため、v4-Large で使うときは ID を読み替える必要がある。README に記載の主なオプションは次のとおり(例は v4.1-Small 表記)。
| オプション | 用途 |
|---|---|
--ref-wav path/to/reference.wav | 参照音声で声クローン |
--ref-wavs ref_01.wav ref_02.wav ref_03.wav | 複数クリップを順に連結(上限 120 秒で切り詰め) |
--caption "落ち着いた、近い距離感の女性話者" と --no-ref | キャプションだけで Voice Design |
--ref-wav と --caption | スタイル制御つき声クローン |
--seconds | 省略時は Duration Predictor が長さを自動推定。--duration-scale で倍率調整 |
| 既定値 | --num-steps 40(RF)、--cfg-scale-text 3.0、--cfg-scale-caption 3.0、--cfg-scale-speaker 5.0 |
ブラウザ操作用の Gradio UI として、声クローン用の gradio_app.py(ポート 7860)と Voice Design 用の gradio_app_voicedesign.py(7861)がある。README 時点では両 UI の既定モデルは v4.1-Small だ。2026 年 10 月 1 日時点で GitHub の最新コミット(2026-09-12)のメッセージは「Add MeanFlow distillation and v4-Large support」で、configs に train_v4_large.yaml と train_v4_large_duration.yaml がある。一方、OpenAI 互換サーバ(Irodori-TTS-Server)、LoRA 微調整、MeanFlow 蒸留版の v4-Large 対応は、README 上は v4-Small / v4.1-Small が対象で、v4-Large への対応は公式に明記なしだ。
絵文字で話し方を制御する
入力文に絵文字を入れると、話し方・感情・非言語音(笑い、咳、ため息など)を制御できる。EMOJI_ANNOTATIONS.md には全 45 種が載っており、以下はその抜粋 12 個だ。
| 絵文字 | 意味 |
|---|---|
| 👂 | 囁き、耳元の音 |
| 😮💨 | 吐息、溜息 |
| ⏸️ | 間、沈黙 |
| 🤭 | 笑い(くすくす、含み笑い) |
| 📢 | エコー、リバーブ |
| 📞 | 電話越し、スピーカー越しのような音 |
| ⏩ | 早口 |
| 🐢 | ゆっくりと |
| 😊 | 楽しげに、嬉しそうに |
| 😠 | 怒り、不満げに |
| 😭 | 嗚咽、泣き声、悲しみ |
| 📖 | ナレーション、独白 |
README の例文は「あははっ🤭、それ本当に言ってるの?…😮💨まぁ、君らしいけどね。」で、キャプションは「余裕のある大人の男性。親しい相手に対して、くだけた雰囲気で呆れながらも楽しそうに話している。」だ。同じ絵文字を重ねると効果を強調できる。ただし公式は、制御は完璧ではなく、文脈によって効き方が変わり一貫しないことがあると明記している。
ライセンスと倫理的制限 — Small は MIT、Large は Gemma Terms of Use
v4-Large の最大の注意点はライセンスだ。モデルカードによれば、共有エンコーダが google/t5gemma-2-1b-1b 由来であるため、v4-Large のモデル重みは Gemma Terms of Use の対象になり、利用・再配布は同規約と Gemma Prohibited Use Policy に従う必要がある。リポジトリには GEMMA_TERMS_OF_USE.md、GEMMA_PROHIBITED_USE_POLICY.md、NOTICE が同梱されている。コードが MIT でも重みは別の規約なので、「オープンソース」とひとくくりにはできない。Gemma ファミリー自体についてはGemma 4 入門も参照してほしい。
| 対象 | ライセンス |
|---|---|
| v4-Large のモデル重み | Gemma Terms of Use |
| v4-Small / v4.1-Small / v4.1-Small-MF のモデル重み | MIT |
| コード(GitHub) | MIT |
- Google は出力(Outputs)に対する権利を主張しない
- 再配布時は、利用制限を契約に含め、規約の写しを渡し、改変を明示し、NOTICE を付ける義務がある
- 規約違反と合理的に判断した利用を、Google がリモートその他の手段で制限する権利を留保する
- 商用利用を禁じる条項はないが、上記のように条件つきである(規約の最終更新は 2026-04-01)
- 本人の明示的な同意なく、声優・著名人・公人などの声をクローン・なりすましに使わない
- ディープフェイクや誤情報を目的とした生成をしない
- 参照音声なしの生成でも、実在人物に偶然似る可能性がある(確率的な結果で、特定個人の再現を意図した学習ではない)
- 悪用について開発者は責任を負わず、法令順守は利用者の責任である
以上は法的助言ではない。商用利用や再配布を考える場合は、最終判断の前に Gemma Terms of Use と Prohibited Use Policy の原文を確認すること。声クローンは、参照する本人の同意を得たうえで使うことが前提だ。
どちらを選ぶか — 用途別の目安
| 用途/重視点 | 向くモデル | 理由 |
|---|---|---|
| 読みの正確さ、軽さ、MIT ライセンス | v4.1-Small | 読み正解率が高く(93.42%)、INT8 で 872 MiB、重みは MIT |
| 生成速度 | v4.1-Small-MF | 4 ステップ生成の蒸留版がある(v4-Large の蒸留版は公式に明記なし) |
| Voice Design の追従、声の再現 | v4-Large | v4-Small 比で Voice Design の平均スコアが +0.0652、声クローンの類似度も 4 条件で上 |
v4-Large は読みの正確さでは Small に及ばないため、「大きいほうが常に良い」わけではない。声の指定や再現を重視する場面で選ぶモデルだ。位置づけとしては、ローカルで動かせる点でVoiceStudioのようなローカル音声ツールに近い。一方、クラウドの TTS API の例にはxAI Grok 音声 APIがあり、料金・対応言語・遅延は各公式を参照してほしい。逆方向の音声入力(STT)をローカルで完結させる例はTypeWhisperで扱っている。
業務で使うときの注意点
- 読み誤りは人が聞いて確認する。 公式も、珍しい固有名詞、専門用語、文脈依存の読みは誤ることがあると明記している
- 参照音声は本人の同意を得て、約 30 秒以上のクリーンな素材を使う。 短い 1 クリップだけだと話者類似度が大きく下がる
- キャプションと参照音声を矛盾させない。 矛盾すると不安定・不自然になったり、片方が優先されたりする。キャプションは感情・スタイル・環境の指定に使い、声質は参照音声に合わせる
- 電子透かしを外さない。 合成音声であることが分かるよう、公開時は合成である旨を開示する
- ライセンスを確認する。 v4-Large の重みは Gemma Terms of Use の対象で、再配布時には義務がある
- 日本語のみ対応である。 他言語のナレーションには使えない
電話応対のような業務用途を検討する場合は、読み誤りと合成音声の開示が特に問題になる。費用面の整理はAI 電話自動応答の費用相場にまとめている。
よくある質問
商用利用はできますか?
v4-Large のモデル重みは Gemma Terms of Use の対象で、商用利用を禁じる条項はないが、再配布時の義務など条件がある。最終判断は規約原文を確認すること。これは法的助言ではない。コードは MIT で、v4.1-Small など Small 系の重みも MIT だ。
必要な VRAM はどれくらいですか?
公式に明記なし。参考になるのはファイルサイズで、フル精度は約 13.15GB、量子化版は 2,818〜3,665 MiB。ただし実行時は参照音声・CFG の分岐・デコードの分が上乗せされるため、ファイルサイズから必要 VRAM は断定できない。まずはデモ Space で試すとよい。
Mac で動きますか?
README には、cpu extra が CPU のみ、または macOS の CPU / MPS 向けと書かれており、導入手段はある。ただし量子化版の実行検証は NVIDIA CUDA のみで、CPU などは未検証。Mac での速度は公式に明記なし。
v4.1-Small とどちらがよいですか?
読みの正確さ・軽さ・MIT ライセンスを重視するなら v4.1-Small、Voice Design の追従や声の再現を重視するなら v4-Large。読み正解率は v4.1-Small が 93.42%、v4-Large が 92.80%。
声クローンに必要な参照音声の長さは?
合計最大 120 秒。公式の評価では伸びの大半が約 30 秒で得られており、短い 1 クリップだけだと類似度は大きく下がる。可能なら約 30 秒以上のクリーンな音声を使う。
英語は話せますか?
いいえ。日本語テキストのみ対応と公式に明記されている。
電子透かしとは何ですか?
Sony の SilentCipher による、人には聞こえない透かしで、生成音声に自動付与される(依存とモデルファイルが利用可能な場合)。検出の方法は SilentCipher(sony/silentcipher)の公式リポジトリを参照してほしい。
出典
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ