Open Code Reviewとは何か
Alibaba製・決定論的パイプライン×LLMエージェントのAIコードレビューCLI
Open Code Reviewは、Alibabaが社内で2年運用した決定論的パイプラインとLLMエージェントのハイブリッド型AIコードレビューCLIだ。Apache-2.0のOSSで、インストール・設定・CI連携からCodeRabbit等競合との違いまで解説する。
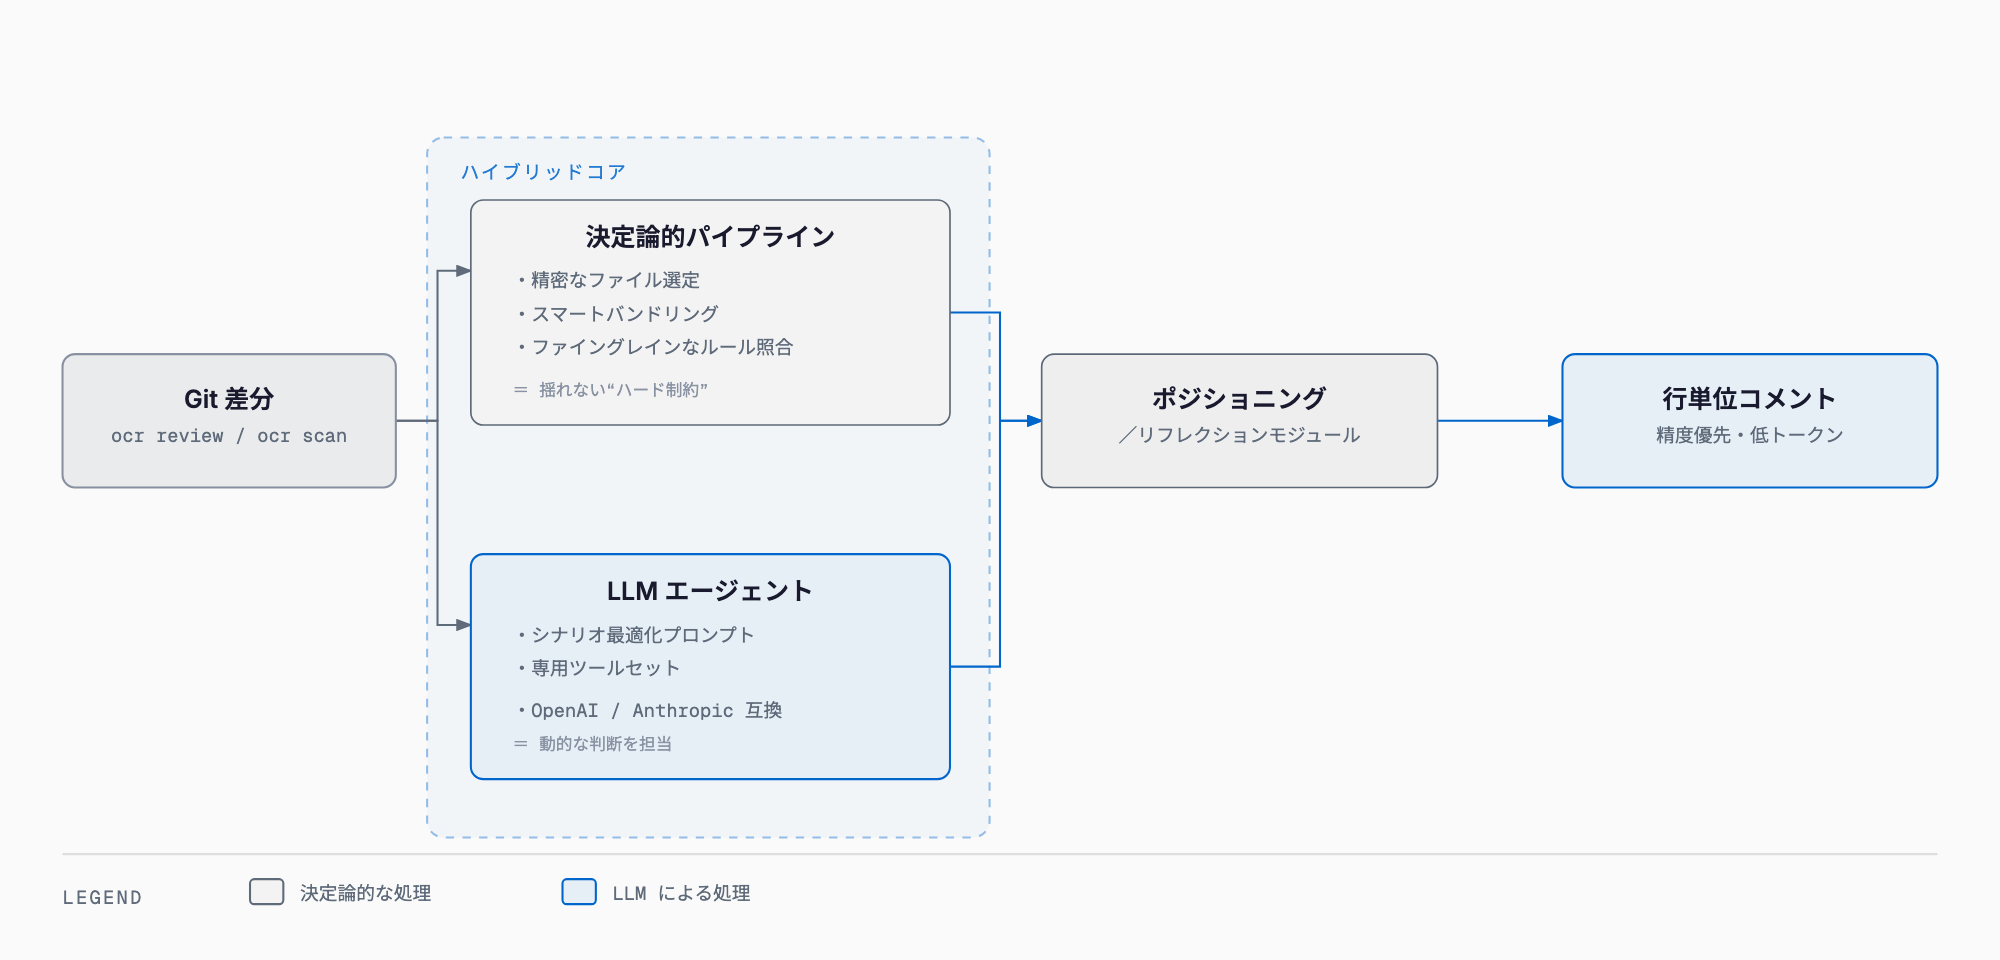
Open Code Reviewは、Alibabaが社内で2年間運用してきたAIコードレビュー用CLIツールを、2026年5月にオープンソース公開したものだ。決定論的なパイプライン(ファイル選定・バンドリング・ルール照合)とLLMエージェントを組み合わせるハイブリッド構成が特徴で、Git差分を読み込み、行単位で精度の高いレビューコメントを返す。
開発元はAlibaba Group、ライセンスはApache-2.0、実装言語はGo。npm経由でocrコマンドとして配布され、OpenAI・Anthropic互換のLLMエンドポイントを設定して使う。本稿執筆時点(2026年9月22日)でGitHubスター数は約39,400、フォーク数は約2,800、2026年9月15日にはGitHub Trendingの全言語部門で1位を記録した(Trendshift調べ)。同月20日には技術メディアInfoQでも取り上げられている。
基本情報
| 項目 | 内容 |
|---|---|
| 開発元 | Alibaba Group |
| 公開日 | 2026年5月18日(GitHub上のリポジトリ作成日) |
| ライセンス | Apache-2.0 |
| 実装言語 | Go |
| 配布形態 | npmパッケージ(@alibaba-group/open-code-review)、インストールスクリプト・GitHub Releaseバイナリ・ソースビルドにも対応 |
| GitHubスター数 | 約39,400(本稿執筆時点) |
| 対応OS | Windows / macOS / Linux |
| 対応LLM | OpenAI互換API・Anthropic互換API |
| 連携先 | GitHub Actions・GitLab CI・GitFlic CI・Gerrit・VS Code・MCP |
| 統合対応エージェント | Claude Code・Codex・Cursor・Kimi Code |
| 公式サイト | open-codereview.ai |
何ができるか
Open Code Reviewの核となる設計思想は「決定論的エンジニアリング×エージェントのハイブリッド」だ。公式READMEは、Claude CodeのようなSkillsベースの汎用AIエージェントでコードレビューを行う場合の課題として、①大規模な差分で一部ファイルしか見ない「カバレッジの欠落」、②指摘位置が実際のコードとずれる「ポジションドリフト」、③プロンプトの微妙な違いで品質が変動する「不安定さ」の3点を挙げている。この根本原因を「言語駆動アーキテクチャにはレビュー工程へのハード制約がないこと」だとし、絶対に間違えてはいけない工程(ファイル選定・バンドリング・ルール照合・位置決め)はエンジニアリングロジックで固定し、動的な判断が必要な部分(コード分析)だけをLLMエージェントに任せる設計を採っている。
| 機能 | 内容 |
|---|---|
ocr review | ワークスペース内のステージ済み・未ステージ・未追跡の変更をまとめてレビュー |
ocr review --from --to | ブランチ間(マージベース)の差分をレビュー |
ocr review --commit | 単一コミットをレビュー |
ocr scan | Git履歴がなくてもファイル全体を監査(未知のコードベース調査向け) |
ocr session list / --resume | 中断したレビューをセッション単位で再開 |
ocr delegate | Delegation Mode。手元のAIコーディングエージェント自身にレビューを実行させ、OCRはファイル選定とルール解決だけを担当(OCR側のLLM設定が不要) |
| Session Viewer | ブラウザでレビュー結果を閲覧し、指摘を「対応済み」「無視」にマークできる |
| Telemetry | OpenTelemetry対応で運用状況を可観測化 |
内蔵ルールセット
公式READMEおよびGitHub上のリポジトリ説明文では、内蔵ルールとしてNPE(null-pointer exception)・スレッド安全性・XSS・SQLインジェクションの多言語ルールセットを持つと明記されている。個々のルールの全リストや対応言語ごとの詳細は、本稿執筆時点でリポジトリ内のドキュメントディレクトリではなく公式サイトの「Review Rules」ページに集約されており、パスフィルタリングでルールの適用範囲を絞れる設計になっている。ルールの完全な一覧は公式サイト側の更新に依存するため、導入時は必ず最新のドキュメントで確認してほしい。
- ファイル種別・パスに応じたルールの絞り込み(テンプレートエンジンベースのマッチングで安定動作)
- NPE・スレッド安全性など言語共通の欠陥パターン
- XSS・SQLインジェクションなどWebアプリのセキュリティ欠陥
- ルール適用はモデルへの丸投げではなく、決定論的な照合ロジックが担う
インストール
前提としてGit 2.41以上が必要(差分生成・コード検索・リポジトリ操作に利用するため)。公式にはnpm経由のインストールが案内されている。
```bash
# npm でグローバルインストール
npm install -g @alibaba-group/open-code-review

# インストール後、ocr コマンドが使えるようになる
ocr --version
```
インストールスクリプトやGitHub Releaseのバイナリ配布、ソースからのビルドにも対応しているが、具体的な手順は公式サイトの「Installation」ページで案内されている。
設定
通常モード(OCR自身がLLMを呼び出すモード)では、レビュー実行前にLLMプロバイダーの設定が必須になる。対話式のセットアップコマンドでプロバイダー選択・APIキー入力・モデル選択・接続テストまで行える。
```bash
# 組み込みプロバイダーを選ぶか、カスタムプロバイダーを追加
ocr config provider

# 選んだプロバイダーで使うモデルを選択
ocr config model
```
OpenAI互換・Anthropic互換のエンドポイントであればカスタムプロバイダーとして登録できる。環境変数や設定ファイルによる詳細設定は公式サイトの「Configuration」ページに記載されている。
使い方
最短ルートは、プロジェクト直下でocr reviewを叩くだけだ。ステージ済み・未ステージ・未追跡の変更をまとめて確認してくれる。
```bash
cd your-project

# ワークスペースの変更をまとめてレビュー
ocr review

# ブランチ間の差分をレビュー(mainからの分岐後の変更)
ocr review --from main --to feature-branch

# 単一コミットをレビュー
ocr review --commit abc123

# 中断したレビューを再開
ocr session list
ocr review --from main --to feature-branch --resume <session-id>

# Git履歴に依存しないファイル全体スキャン
ocr scan
ocr scan --path internal/agent

# 結果をJSONで保存(AIホストエージェント連携向け)
ocr review --format json --output result.json
```
手元でClaude CodeやCodex、Cursorなどのコーディングエージェントを既に使っている場合は、Delegation Modeが有効だ。OCR自体はLLMを呼ばず、ファイル選定・ルール解決だけを担当し、実際のレビューはユーザーが使っているエージェントのLLMで実行される。OCR用のAPIキー設定が不要になる。
```bash
# Delegation Mode でレビュー対象をプレビュー
ocr delegate preview

# 特定ファイルに適用されるルールを確認
ocr delegate rule src/main.go src/handler.go
```
CI/CDへの組み込み
公式ドキュメントではGitHub Actions・GitLab CI・GitFlic CI・Gerritへの統合が案内されている(具体的なYAML設定例は公式サイトの「CI/CD Integration」ページに掲載されており、本稿執筆時点でREADME本体には記載がない)。PR作成時に自動でレビューを走らせ、結果をコメントとして返す運用が想定されている。CI組み込みを検討する場合は、まずローカルでocr reviewを試し、ルール適用範囲やノイズの量を確認してからパイプラインに組み込むのが安全だ。
既存ツールとの違い
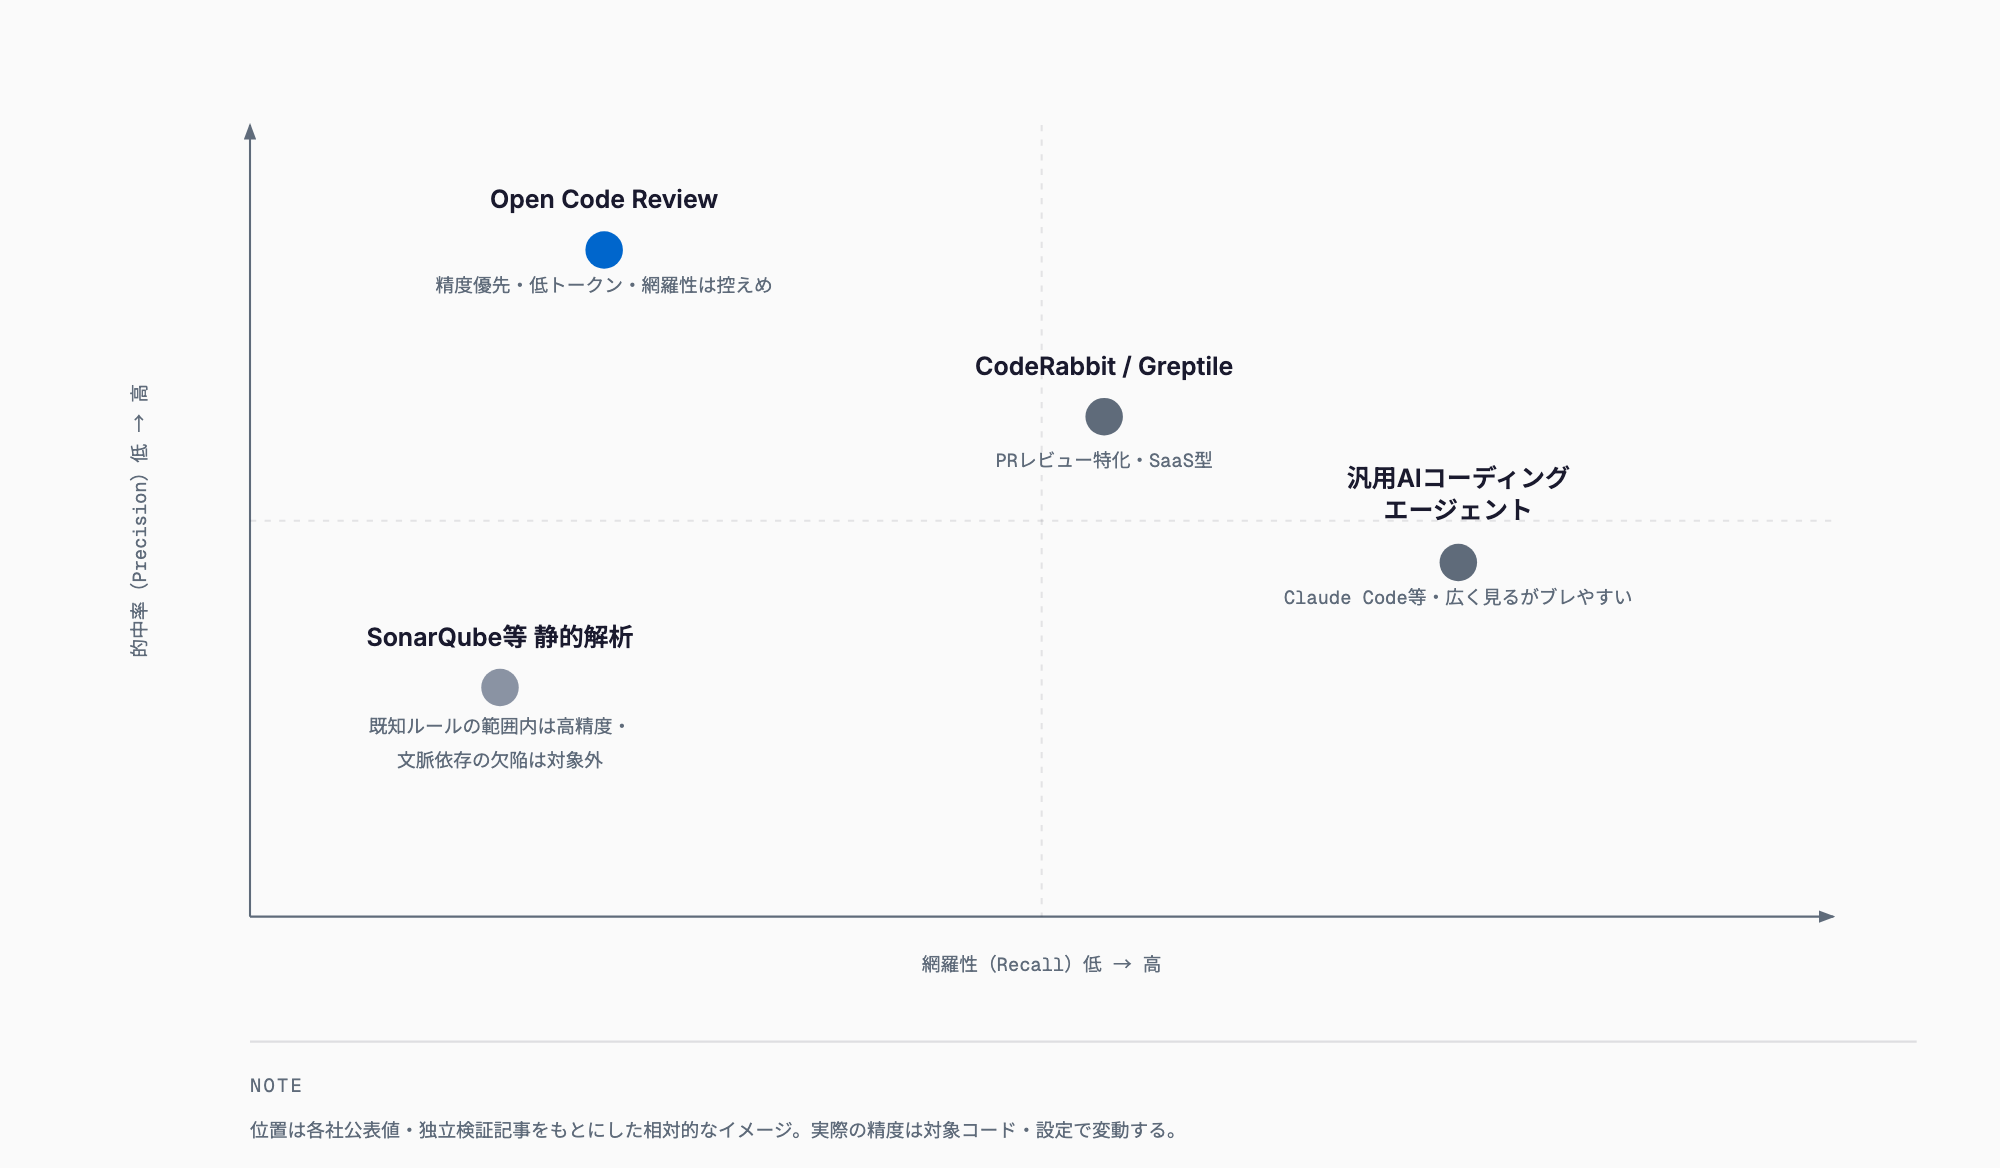
AIコードレビューのカテゴリにはすでにCodeRabbit・GitHub Copilotのコードレビュー機能・Greptileなどの選択肢があり、従来型の静的解析ツールであるSonarQubeも根強く使われている。Open Code Reviewの立ち位置を掴むには、これらとの違いを押さえておくとよい。
| ツール | 方式 | 強み | 弱み・注意点 |
|---|---|---|---|
| Open Code Review | 決定論的パイプライン+LLMエージェント(OSS・セルフホスト) | 的中率(誤検知の少なさ)とトークン効率を優先。自社のLLMを持ち込める | 網羅性(Recall)は意図的に控えめ。独立検証では公式値より厳しい結果も報告されている |
| CodeRabbit | AIエージェント(SaaS) | GitHub/GitLab連携が手厚く導入が容易。要約・チャット機能も充実 | クラウドSaaS前提で、自社LLMの持ち込みやオンプレ運用の自由度はOCRより低い |
| GitHub Copilot コードレビュー | AIエージェント(GitHub純正機能) | GitHub上でシームレスに使え追加ツール不要 | GitHubエコシステム外では使えず、レビュー観点のカスタマイズ幅は限定的 |
| Greptile | コードベース理解特化のAIエージェント(SaaS) | リポジトリ全体の文脈を踏まえた指摘が得意 | SaaS型でOSSではなく、料金体系は商用プラン前提 |
| SonarQube等の静的解析 | ルールベースの静的解析(非LLM) | 既知パターンに対する的中率が高く実行が高速・安定 | 新規パターンや文脈依存の欠陥は検出できず、ルール整備の運用負荷がある |
注意点・向いている人/向いていない人
公式ベンチマーク(50リポジトリ・200件のPR・10言語・80人以上のエンジニアによる1,505件の正解アノテーション、通称AACR-Bench)では、同じモデルを使った場合にClaude Codeより高い的中率とF1スコアを、約1/9のトークン消費で達成したとされる一方、網羅性(Recall)は汎用エージェントより低いことが公式に明示されている。Shopifyのシニアエンジニア Tom Rochette 氏はこの構成を「実際のエージェントの失敗パターンを狙った設計」だと評価しつつ、独立した検証(The Martian Benchmark、10件のPR)では的中率が約12%に留まったと指摘している(開発元はツール呼び出しの異常が原因だとして修正済みとしているが、本稿執筆時点で修正後の独立検証は確認できていない)。HCLTechのDaniel Vaughan氏も、AACR-Bench上で最良設定でも網羅性は20%にとどまり、専門家が見つける欠陥の8割は検出できない計算になると指摘している。数値はいずれも各社・各記事の公表値であり、自社のコードベースで検証することが前提になる。
- 向いている人:誤検知(ノイズ)を減らしてレビューコストを下げたいチーム/LLMのAPIコストを抑えたいチーム/自社インフラでセルフホストしたい・特定のLLMプロバイダーを使いたいチーム/すでにClaude Code等のコーディングエージェントを使っておりDelegation Modeで追加費用なく導入したいチーム
- 向いていない人:見逃しを極力ゼロに近づけたい(網羅性最優先の)チーム/CIへのYAML組み込み例など手厚いサポート付きSaaSを求めるチーム/エンジニアリングリソースをかけずにすぐ本番導入したいチーム
FAQ
Open Code Reviewは無料で使えるか。
ツール自体はApache-2.0ライセンスのオープンソースで無料で使える。ただしOpenAIやAnthropicなどLLMプロバイダーへのAPI利用料は別途発生する(Delegation Modeを使えばOCR用のLLM費用は不要になる)。
導入にはどんな前提条件が必要か。
Git 2.41以上が必要。Windows・macOS・Linuxに対応しており、npmでのグローバルインストールのほか、インストールスクリプトやバイナリ配布にも対応している。
Claude CodeやGitHub Copilotのレビュー機能と何が違うのか。
汎用AIエージェントは網羅的に見ようとする分、大規模差分でのカバレッジ欠落や指摘位置のズレが起きやすい。Open Code Reviewはファイル選定・ルール照合・位置決めを決定論的ロジックで固定し、的中率とトークン効率を優先する設計になっている。
CIに組み込むことはできるか。
GitHub Actions・GitLab CI・GitFlic CI・Gerritとの統合が公式に案内されている。具体的なYAML例は公式サイトのCI/CD Integrationページを参照する必要がある。
独立した検証での評価はどうか。
本稿執筆時点(2026年9月22日)で、独立系の検証では公式ベンチマークより厳しい結果(的中率・網羅性ともに低め)が報告されている。開発元は一部を「異常」として対応中としているが、修正後の独立した再検証はまだ確認できていない。導入前に自社のコードベースで試すことを推奨する。
まとめ
Open Code Reviewは、決定論的パイプラインとLLMエージェントを組み合わせることで、AIコードレビューにありがちな「カバレッジの欠落」「位置ズレ」「品質のブレ」に正面から対処しようとするツールだ。的中率とトークン効率を優先する代わりに網羅性を抑える設計思想は、CodeRabbitやGitHub Copilotのコードレビュー機能、SonarQube等の静的解析とは異なる立ち位置にある。一方で独立検証の結果にはばらつきがあり、公式ベンチマークの数値をそのまま鵜呑みにせず、自社のコードベースで試してから本番導入を判断するのが安全だ。AIエージェントの活用事例はOrcaによる並列開発環境の記事でも紹介している。セキュリティ観点でのIT対策全般は脆弱性診断・ペネトレーションテストの費用相場も参考になる。社内へのAIツール導入や開発体制づくりはソフトウェア開発・AIコンサルティングでも支援している。相談はお問い合わせから。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ