Hindsightとは — RAGを超えて「学習するAIエージェント」を作るVectorize製メモリ層の使い方
Hindsightは、会話履歴の呼び出しではなく「学習するエージェント」を目指す、Vectorize製のMITライセンス・オープンソースAIエージェント用メモリ層だ。LongMemEventベンチマークでSOTAを記録し、GitHub週間トレンド3位(今週+11,089スター)を獲得した本ツールのRetain・Recall・Reflectという3操作、4つのメモリ種別、インストール・料金・既存ツールとの違いを公式README・ドキュメントのみで解説する。
Hindsightは、AIエージェント向けの記憶(メモリ)システムだ。多くの類似ツールが「会話履歴の呼び出し」にとどまるのに対し、Hindsightは「学習するエージェント」を作ることに焦点を当てている。開発元はVectorize(vectorize-io)、ライセンスはMIT、実装はPython製で、RAGやナレッジグラフといった既存手法の弱点を解消し、長期記憶タスクで最先端の性能を出すと公式に説明されている。
本稿執筆時点(2026年9月28日)でスター数は約39,777・フォーク5,295。GitHub週間トレンドでは3位(今週だけで+11,089スター、2位はエージェント組織管理ツールのPaperclip)に入っている急成長のプロジェクトだ。最新リリースはv0.10.1(2026-09-21公開)。リポジトリは2025年10月30日に作成されている。本稿ではHindsightの主要機能、インストール方法、基本的な使い方、既存ツールとの違いを、公式README・GitHubリポジトリの情報だけをもとに整理する。
Hindsightとは — 「記憶」ではなく「学習」を目指すエージェントメモリ
READMEは「Most agent memory systems focus on recalling conversation history. Hindsight is focused on making agents that learn, not just remember.(多くのエージェントメモリシステムは会話履歴の呼び出しに主眼を置くが、Hindsightは単に覚えるのではなく学習するエージェントを作ることに主眼を置く)」と述べている。長期記憶タスクを評価するLongMemEvalベンチマークで最先端の性能を達成しており、この結果はVirginia TechのSanghani Center for Artificial Intelligence and Data AnalyticsとThe Washington Postの研究協力者によって独立に再現されたとされる。Fortune 500企業や複数のAIスタートアップで本番利用されているという。
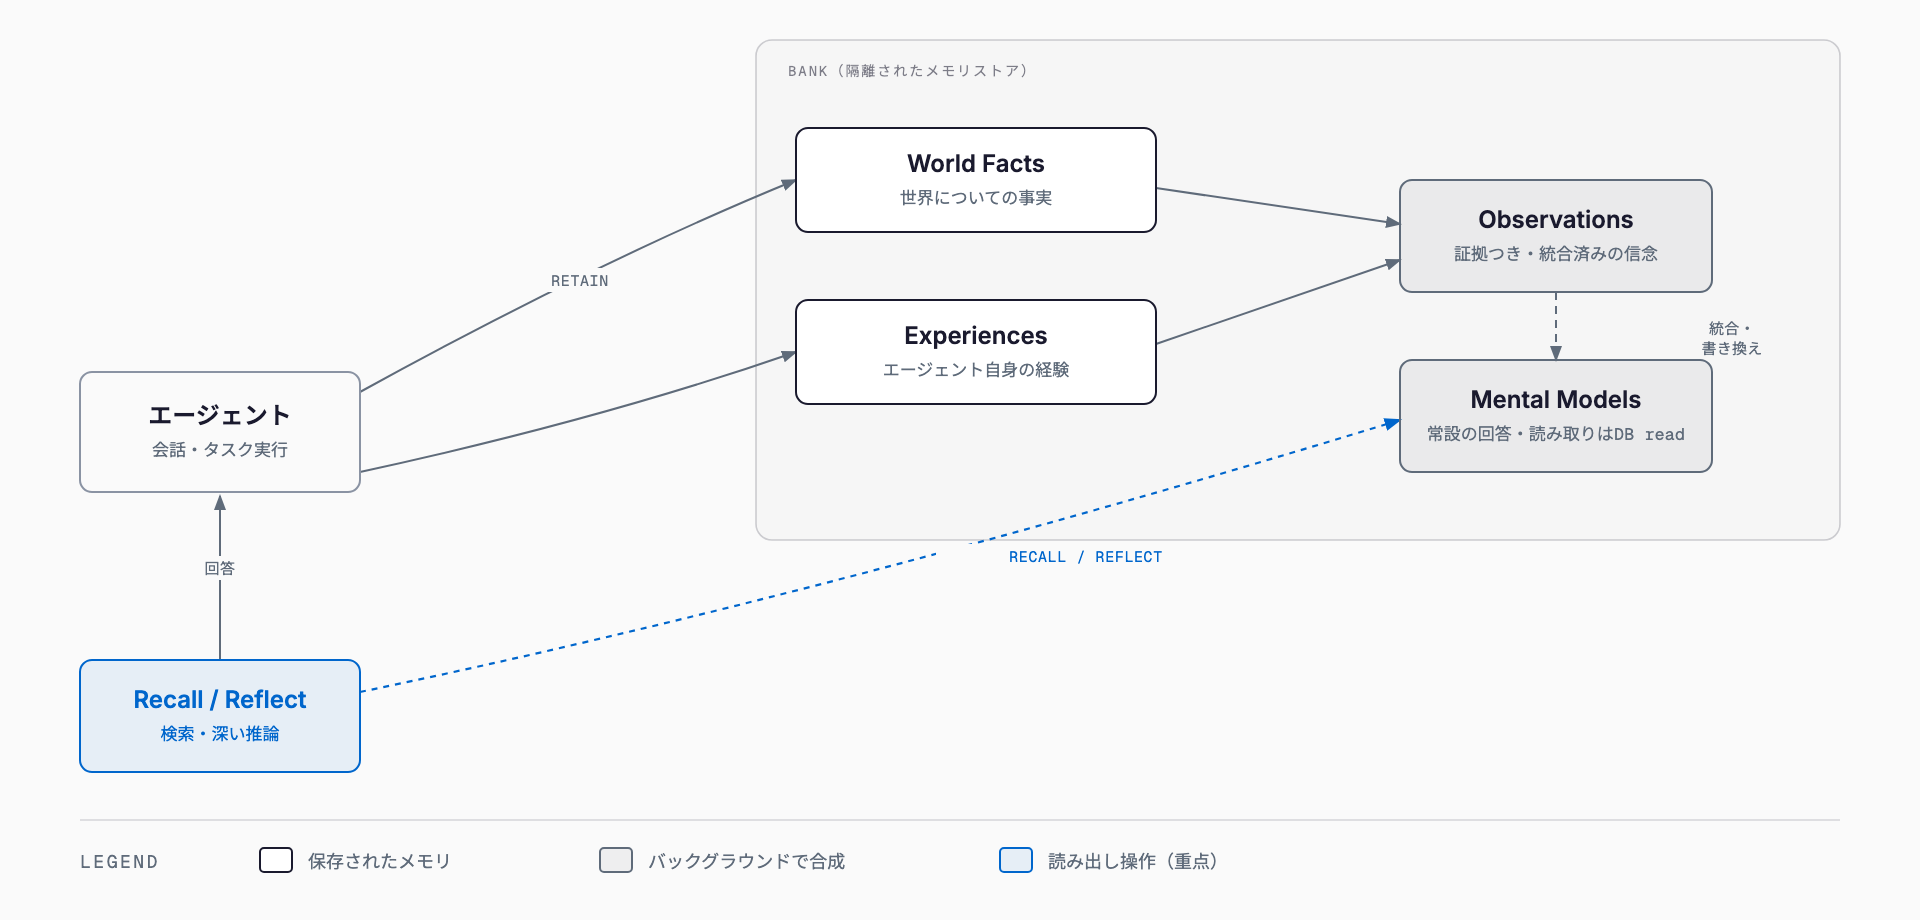
コアコンセプト — Retain・Recall・Reflectと4つのメモリ種別
Hindsightは人間の記憶に近い形でメモリを組織化するとしており、記憶は「bank」という隔離されたストアに保存される。新しいメモリはWorld Facts(世界についての事実、例「ストーブは熱くなる」)かExperiences(エージェント自身の経験、例「ストーブに触ったら本当に痛かった」)のいずれかの経路に入り、エンティティ・関係・時系列とスパース/デンスのベクトル表現の組み合わせとして格納される。ここから、多くの記憶を集約した証拠付きの信念であるObservations、そしてObservations・World Factsから合成される学習済みの理解であるMental Modelsが生まれる。
| 操作 | 内容 |
|---|---|
| Retain(保持) | 新しい情報をHindsightに取り込む操作。LLMで事実・時系列データ・エンティティ・関係を抽出し、正規化して正準エンティティ・時系列・検索インデックスに変換する |
| Recall(想起) | メモリを検索して取り出す操作。意味的類似度(ベクトル)・キーワード(BM25)・グラフ(エンティティ/時系列/因果のリンク)・時間範囲フィルタの4戦略を並列実行し、逆数順位融合とクロスエンコーダの再ランキングで統合、トークン上限に収める |
| Reflect(省察) | 既存の記憶をより深く分析し、新しい結びつきを見つけたり、単純な検索では答えられない問いに答えたりする操作。プロジェクトリスクの洗い出しや、返信率の高い営業文面の傾向分析などに使える |
取り込まれた事実は積み上げられるだけでなく、バックグラウンドで関連する事実同士がObservationsへと統合される。各Observationは正確な引用と証拠件数を伴う根拠つきの信念であり、新しい証拠が来ると上書きではなく「洗練」される(既存の信念を強めたり弱めたり拡張したりする)。さらに一歩進んだ概念がMental Models(メンタルモデル)だ。「このユーザーの好みは?」のような問いへの常設の回答として、一度定義すればHindsightが背景でその答えを書き続け、読み取りはLLM呼び出しなしの単純なデータベース読み取りで済む。メンタルモデルの仕組みを隠し、フォルダ分けされたMarkdown文書として扱えるようにしたものがKnowledge Pages(ナレッジページ)だ。
bankは「隔離されたメモリストア」であり、ユーザー・エージェント・プロジェクトごとに1つ用意し、他のbankへの情報漏洩は起きない設計になっている。bankは懐疑性・文字通り解釈・共感性といった「性格特性(disposition traits)」を持ち、reflectがそのbankの記憶をどう解釈するかに影響する。入力言語は自動検出・保持され、固有名詞もネイティブ表記のまま扱われる多言語対応、そして機密情報・個人情報を45パターンに照らして検出し、マスキングまたはブロックするオプトインの「Memory Defense」機能も備える。
インストールと料金
| 項目 | 内容 |
|---|---|
| 開発元 | Vectorize(vectorize-io) |
| ライセンス・料金 | MITライセンスのオープンソース・無料(セルフホスト)。マネージドの「Hindsight Cloud」は使用量課金・無料クレジットあり、固定の月額・シート課金なし |
| 実装 | Pythonサーバー(hindsight-api)。Python/Node.js/Go/CLIのクライアントを提供 |
| 対応LLM | 25種類以上のプロバイダ(OpenAI・Anthropic・Gemini・Groq・Bedrock・Vertex AI・MiniMax・DeepSeekほか)、完全ローカルのOllama/LM Studio/llama.cpp、OpenAI互換エンドポイント、LiteLLM等のゲートウェイに対応。ChatGPT Plus/Pro・Claude Pro/Max・Cursor・GitHub Copilotの既存契約はAPIキー不要で使える |
| 対応プラットフォーム | Linux(x86_64/ARM64)、macOS(Apple Silicon/Intel)、Windows(x86_64)。Docker・pipインストール・埋め込みDB(pg0)のいずれかに対応(Intel Macはpip配布時にhindsight-all-slimが必要) |
| ストレージ | PostgreSQL+pgvector、またはOracle AI Database 23ai(機能パリティあり) |
| 最新版 | v0.10.1(2026-09-21) |
| 参考文献 | LongMemEvalベンチマーク論文(arXiv:2512.12818)、公開ベンチマークページ |
サーバーはDocker・pip(ベアメタル)・Helm(Kubernetes)・埋め込みDB(サーバー不要)のいずれかで起動できる。もっとも手軽なのはDockerだ。
export OPENAI_API_KEY=sk-xxx

docker run -it --pull always --name hindsight --restart unless-stopped -p 8888:8888 -p 9999:9999 \
  -e HINDSIGHT_API_LLM_API_KEY=$OPENAI_API_KEY \
  -v hindsight-data:/home/hindsight/.pg0 \
  ghcr.io/vectorize-io/hindsight:latest

# API: http://localhost:8888
# UI:  http://localhost:9999
pipでベアメタル起動する場合は次の通り。
pip install hindsight-api
export HINDSIGHT_API_LLM_API_KEY=sk-xxx
hindsight-api
使い方 — 最短手順
サーバーが立ち上がったら、Pythonクライアントをインストールして接続する。
pip install hindsight-client -U

from hindsight_client import Hindsight

client = Hindsight(base_url="http://localhost:8888")

# Retain: 情報を保持する
client.retain(bank_id="my-bank", content="Alice works at Google as a software engineer")

# Recall: メモリを検索する
client.recall(bank_id="my-bank", query="What does Alice do?")

# Reflect: 性格特性を反映した回答を生成する
client.reflect(bank_id="my-bank", query="Tell me about Alice")
既存のエージェントに最短で記憶を足したいだけなら、LLMクライアントをラップするだけの「LLM Wrapper」が用意されている。既定ではHindsight Cloudに接続し、hindsight_api_urlを渡せばセルフホストサーバーにも切り替えられる。
pip install hindsight-litellm

from openai import OpenAI
from hindsight_litellm import wrap_openai

client = wrap_openai(
    OpenAI(),
    bank_id="user-123",
    hindsight_api_url="http://localhost:8888",
)

# 呼び出し前にrecallで関連記憶を取得し、呼び出し後にretainで会話を保持する
response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "What do you know about me?"}],
)wrap_anthropic()も同様に使え、LiteLLMを土台にしているため100以上のモデルが対象になる。より細かく「いつ保存し、いつ想起するか」を制御したい場合はSDK/REST APIを直接使う。連携は60以上あり、Claude Code・Codex・Cursor・GitHub CopilotなどのコーディングエージェントやLangGraph・CrewAI・OpenAI Agents SDKなどのフレームワークはほとんどコード変更不要で接続できる。コーディングエージェント向けには、リポジトリのgit履歴と過去セッションから自動でプロジェクト記憶を作る専用パッケージも用意されている。
npx @vectorize-io/hindsight-coding-agents install all          # 検出された全エージェントに導入
npx @vectorize-io/hindsight-coding-agents install claude-code # 1つだけ導入する場合さらに、すべてのサーバーはbankごとにhttp://localhost:8888/mcp/{bank_id}/というMCPエンドポイントを標準搭載しており、任意のMCPクライアントからretain・recall・reflectをツールとして呼び出せる。MCPの基本や活用シーンについてはMCP公式ロードマップ2026年8月更新の解説も参考にしてほしい。
既存ツールとの違い
| Hindsight | mem0 | Letta | Zep(Graphiti) | |
|---|---|---|---|---|
| 主眼 | 「学習するエージェント」向けの記憶層。retain/recall/reflectの3操作と4種のメモリ表現 | パーソナライズされたAI向けメモリレイヤー。ユーザー・セッション・エージェントの3階層でコンテキストを保持 | メモリブロックを自己書き換えしながら学習・適応する「ステートフルエージェント」基盤(旧MemGPT系、Letta Code) | 時間とともに変化する事実を追跡する時制知識グラフ。GraphitiはOSSのコアフレームワーク、Zepはそれを基盤にした商用マネージド製品 |
| 検索方式 | 意味的・キーワード(BM25)・グラフ・時間範囲の4戦略を並列実行しRRF+リランキングで統合 | 意味検索・BM25キーワード・エンティティマッチングを並列実行し統合する「マルチシグナル検索」(2026年4月の新アルゴリズムから) | READMEに複数戦略検索の明記なし。エージェント自身がメモリブロックを書き換えて適応し、/searchで全メッセージ・全エージェントを横断検索 | 意味検索・BM25キーワード・グラフ探索を組み合わせたハイブリッド検索に、事実の有効期間を管理する双時制(bi-temporal)トラッキングを付加 |
| ベンチマーク | LongMemEvalでSOTA、Virginia Tech・Washington Postが再現。公開ベンチマークページで他ツールとも比較 | 公表値: LoCoMo 92.5点/LongMemEval 94.4点(2026年4月発表の新アルゴリズム。マネージドPlatform版のスコアで、OSS版は近い傾向になる見込みとmem0自身が注記) | ―(READMEにLongMemEval/LoCoMoの公表値なし) | ―(READMEにLongMemEval/LoCoMoの公表値なし。独自のDMRベンチマークを論文で報告) |
| ライセンス | MIT(セルフホスト無料)+使用量課金のHindsight Cloud | Apache 2.0。ライブラリ・セルフホストサーバーは無料、Mem0 Platformは有料のマネージド版 | Apache 2.0(Letta Code)。CLI・セルフホストは無料、既定バックエンドのLetta Cloudは一部機能でログインが必要 | Graphiti(OSSコア)はApache 2.0で無料・セルフホスト限定。Zep本体はプロプライエタリな商用製品(フルマネージドまたは自社クラウド配備) |
| 導入方法 | Docker/pip/Helm/埋め込みDB/マネージドクラウド | ライブラリ(pip/npm)/セルフホストサーバー(Docker Compose)/クラウドプラットフォーム(app.mem0.ai)の3段階 | npmでCLIを導入しローカルサーバーまたはLetta Cloudで実行。デスクトップアプリ・ブラウザ・Slack/Telegram/Discord連携にも対応 | Graphitiは自前でNeo4j/FalkorDB/Amazon Neptune等のグラフDBを用意してセルフホスト。Zepはフルマネージドまたは自社クラウドへの配備を選べる |
mem0・Letta・Zepはいずれもエージェントメモリ/エージェント状態管理の分野で知られるOSSで、それぞれ公式README・GitHubリポジトリの情報で上表を作成した。mem0はApache 2.0ライセンスのライブラリ・セルフホストサーバーに加え、有料のマネージドPlatformを持つ3段階構成で、2026年4月に発表した新しい抽出アルゴリズムでLoCoMo 92.5点・LongMemEval 94.4点を自己公表している(マネージドPlatformでの数値)。Lettaは旧MemGPTの系譜で、エージェント自身がメモリブロックを書き換えて学習する「ステートフルエージェント」というアプローチを取り、明示的な複数戦略検索よりも自己編集的なコンテキスト管理に重点を置く。Zepは時制知識グラフを扱う商用マネージド製品で、そのOSSコアであるGraphiti(Apache 2.0)はNeo4jなど外部グラフDBを自前で用意するセルフホスト専用のフレームワークだ。Hindsightの独自性としてREADMEが強調するのは、ベクトル検索単体でもナレッジグラフ単体でもなく、World Facts・Experiences・Observations・Mental Modelsという複数の表現を組み合わせ、証拠つきで信念を「洗練」させ続ける点、そしてLongMemEvalという第三者評価が可能なベンチマークで独立再現された結果を公開している点だ。RAGとの違いについては公式の比較ページ(RAG vs Hindsight)で詳しく説明されている。RAG基盤の構築事例についてはWeKnora徹底解説も参照してほしい。
導入時の注意点・向いている人
- LLM呼び出しが必要な処理(Retain時の事実抽出、Observations・Mental Modelsの合成など)があるため、使用するLLMプロバイダのAPI利用料が別途発生する
- READMEは「n8nのようなシンプルなAIワークフローでは過剰装備(overkill)になりうる」と明言しており、オープンエンドなタスクをこなし、フィードバックで行動を変え、複雑な作業を学習していく「AI従業員」的なエージェントで真価を発揮するとしている
- Intel Mac(x86_64)でpipインストールする場合はhindsight-all-slimを使う必要があり、通常のhindsight-allとは異なる
- Memory Defenseはオプトインのため、機密情報・個人情報の保護が必要な用途では明示的に有効化する必要がある
- セルフホストの運用にはPrometheusによる監視、管理用CLI、Webhookなど本番運用向けの機能一式が用意されているが、これらの設定は別途必要になる
個人ごとの好み・会話履歴を覚えるだけのチャットボットから、プロジェクトの状況を継続的に学習していくコーディングエージェント、顧客対応の傾向を振り返る営業・サポートエージェントまで、「セッションをまたいで賢くなっていくエージェント」を作りたい場合に向いたツールだ。単純な質問応答だけで長期記憶が不要なワークフローには、必ずしも必要ない。
よくある質問
Hindsightは無料で使えますか。
サーバー本体はMITライセンスのオープンソースで、セルフホストであれば無料だ。マネージドの「Hindsight Cloud」は使用量ベースの課金で、開始時に無料クレジットが付与されるが固定の月額・シート課金はないと公式サイトは説明している。
どのLLMプロバイダに対応していますか。
OpenAI・Anthropic・Gemini・Groq・Bedrock・Vertex AIなど25以上のホスト型プロバイダに加え、Ollama・LM Studio・llama.cppといった完全ローカル実行、OpenAI互換エンドポイント、LiteLLM等のゲートウェイに対応する。ChatGPT Plus/Pro・Claude Pro/Max・Cursor・GitHub Copilotの既存契約もAPIキーなしで使えるとされている。
RAGとは何が違いますか。
公式は、単純なベクトル検索やナレッジグラフに頼るRAGに対し、Hindsightは複数のメモリ表現(World Facts・Experiences・Observations・Mental Models)を組み合わせ、証拠つきで信念を継続的に洗練させる点が異なると説明している。詳細は公式のRAG比較ページを参照してほしい。
Claude CodeやCursorのようなコーディングエージェントでも使えますか。
使える。専用パッケージ@vectorize-io/hindsight-coding-agentsをインストールすると、リポジトリのgit履歴や過去セッションから自動でプロジェクト記憶が構築され、アーキテクチャや規約をまとめたナレッジページとともにエージェント起動時に読み込まれる。
日本語など英語以外の言語にも対応していますか。
公式ドキュメントは「Multilingual by default」を明記しており、入力言語は自動検出・保持され、固有名詞もネイティブ表記のまま扱われる(例として中国語の人名がそのまま保持される旨が挙げられている)。
まとめ
Hindsightは、会話履歴を検索するだけの記憶ではなく、証拠つきの信念を継続的に洗練させ、常設の回答(Mental Models)まで育てていく「学習するエージェント」向けのメモリ層だ。LongMemEvalでの第三者再現つきSOTAスコアと、retain・recall・reflectというシンプルなAPI、60以上の既製連携が組み合わさっている点が特徴と言える。
一方で、LLM呼び出しを伴う処理には別途プロバイダの利用料がかかり、単純なワークフローには過剰装備になりうるとREADME自身が述べている。まずはDockerか埋め込みDBで小さなbankを1つ作り、retain・recallの挙動を確かめてから、Mental ModelsやMemory Defenseなど本番向け機能を段階的に有効化していくのが無理のない進め方になりそうだ。
参考リンク(一次ソース)
- https://github.com/vectorize-io/hindsight
- https://hindsight.vectorize.io
- https://hindsight.vectorize.io/developer/rag-vs-hindsight
- https://benchmarks.hindsight.vectorize.io
- https://arxiv.org/abs/2512.12818
- https://github.com/vectorize-io/hindsight/releases/tag/v0.10.1
- https://github.com/mem0ai/mem0
- https://github.com/letta-ai/letta-code
- https://github.com/getzep/graphiti
- https://www.getzep.com
- https://github.com/trending?since=weekly
お気軽にご相談ください
お問い合わせ