Llmspeedとは — ローカルLLMの生成速度を買う前に体感できる無料ツール、推定の仕組みとVRAM計算・which
llm・LapTimeとの違い
Llmspeedは、GPU・Macとモデルを選ぶとローカルLLMの回答が推定tok/sとTTFTで流れる、無料のMITライセンスWebツール。使い方、速度推定の仕組み、HNでの精度評価、whichllm・llmfit・LapTime・VRAM計算ツールとの違いを解説【2026年10月】
Llmspeed(llmspeed.dev)は、GPUまたはMacとモデルを選ぶと、ローカルLLMの回答が推定速度で流れる様子を、最初の1トークンが出るまでの待ち時間も含めてブラウザ上で体感できる無料のオープンソース(MIT License)ツールです。「買う前に、そのハードで何トークン/秒出るのか」を数字ではなく体感で確かめられます。
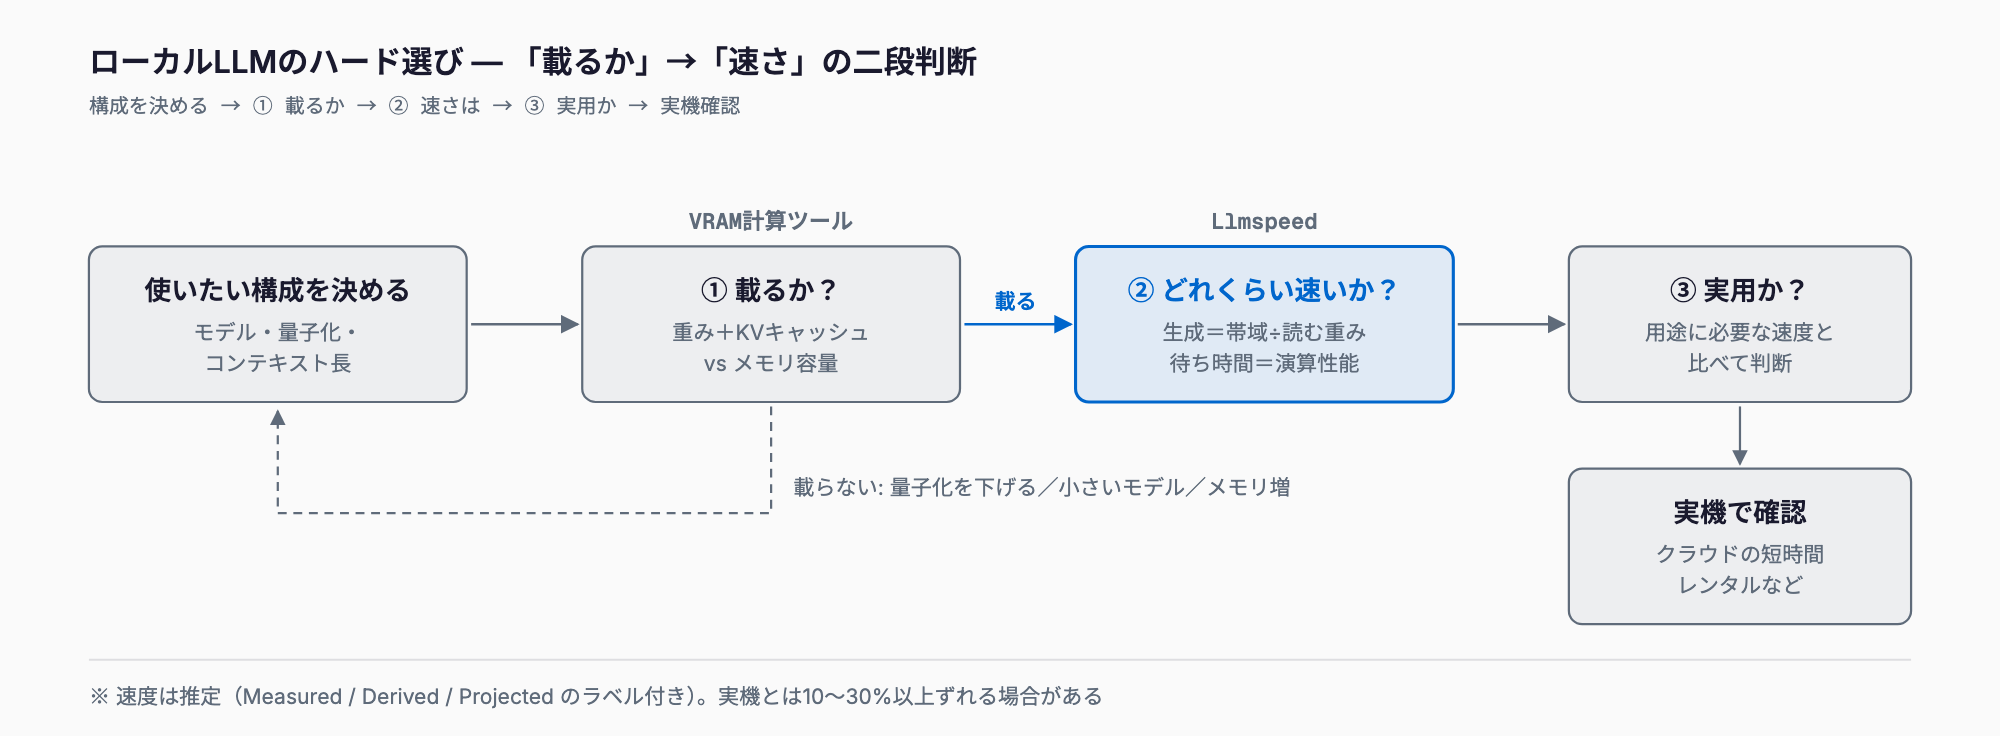
結論として、Llmspeedが答えるのは「どれくらいの速さか」であり、「モデルが載るか」は別の問いです。載るかどうかはVRAM計算ツール(モデル×量子化×コンテキスト長から必要VRAMを試算)で先に確認し、載る構成についてLlmspeedで速さを見る、という二段で使うと判断を誤りにくくなります。ただし数値はあくまで推定で、Hacker Newsでは「実機より楽観的/悲観的」という指摘も複数出ています。購入の決め手ではなく、候補を絞る道具として使うのが安全です。
Llmspeedでできること
2026年10月17日にHacker NewsのShow HNとして公開され、話題になりました(記事執筆時点で321ポイント・86コメント)。READMEとサイトで確認できる機能は次のとおりです(2026年10月19日時点)。
- ストリーミング再生: 予測したtokens/秒で文字が流れ、プロンプト長に応じた最初のトークンまでの待ち時間(TTFT)も再現する
- レース機能: 2つの構成を並べて同時に走らせる(READMEの例はRTX 5090とMac Studio)
- メモリ適合の判定: 量子化ごとに、載る/システムRAMへの一部オフロードが必要/動かない、を表示する
- 対象: READMEによると30種類のGPU・Mac・CPU×15種類の人気モデル。バックエンドはCUDA・Metal・ROCm・Vulkan・CPU
- 共有リンク: 構成やレースをURLで共有できる
サイトにはRTX 3060〜5090などのNVIDIA GPU、AMD GPU、Apple Siliconの各Mac、Strix HaloやDGX Spark、CPUのみの構成、クラウドのH100・H200が並びます。モデルはQwen、Gemma 4、GPT-OSS、DeepSeek V4、GLM-5.3、Llama 3.1 8B、Nemotron 3.5などです。個々のデバイス名の完全な一覧はREADMEには書かれていません。
使い方と料金
- llmspeed.dev をブラウザで開く(インストール不要)
- デバイス(GPUまたはMac)とモデルを選ぶ
- 量子化とプロンプトの長さを調整し、再生して速度と待ち時間を体感する
- 比較したい場合はレースで2構成を並べる。結果はURLで共有できる
料金やアカウント登録に関する記載は、READMEにもサイトにもありません。ソースはGitHubで公開され、ライセンスはMITです。静的サイトとして作られており(Vite・Preact・TypeScript、GitHub Pagesで配信)、予測値はdata/app-data.jsonに生成されたデータとして収められています。なお、紹介されているgithub.com/albinstman/llmspeedは、現在はgithub.com/nicorobinreal/llmspeedへリダイレクトされます(2026年10月19日確認)。
速度推定の仕組み — メモリ帯域とモデルサイズ
ローカルLLMの速度は、大きく2つに分けて考えます。1つは回答を1トークンずつ作る生成(デコード)、もう1つは入力を読み込むプロンプト処理(プリフィル)です。両者は律速になる資源が違います。
生成は、1トークンを作るたびにモデルの重みをメモリから読み出すため、多くの場合メモリ帯域が上限を決めます。一般論として、次の式が目安になります。
生成速度の上限(tok/s) ≒ メモリ帯域(GB/s) ÷ 1トークンあたりに読む重み(GB)たとえば帯域が100GB/sのデバイスで、1トークンあたり10GBの重みを読むモデルなら、上限は約10 tok/sです(説明用の仮の数値)。量子化で重みを半分にすれば、読む量も減るため理論上は約2倍になります。実際の速度はここから、実装の効率やコンテキストの長さの分だけ下がります。
Mixture of Experts(MoE)モデルは、トークンごとに使うのが一部の専門家だけなので、読む重みは総パラメータではなくアクティブパラメータ分です。だから総サイズが大きくても速いモデルがあります。一方で、載せるメモリは総パラメータ分が必要です(ここが「載るか」と「速さ」を別々に見る理由です)。
プロンプト処理は並列に計算できるため、帯域ではなく演算性能(FP16 TFLOPSなど)が律速になります。長い資料を貼り付けたときの待ち時間(TTFT)はこちらで決まります。READMEでも、生成は帯域、プロンプト処理は計算量を基準にすると説明されています。
さらに、コンテキストが長くなるとKVキャッシュの読み出しが増えて速度が落ち、メモリも消費します。詳しい計算はKVキャッシュとコンテキスト長のVRAMで解説しています。Llmspeedは、こうした原理に、実測ベンチマークから当てはめた効率係数と、コンテキスト増による減速を組み合わせたものです。
推定の信頼度ラベル
Llmspeedの特徴は、数値ごとに根拠の強さを示すことです。READMEによると、各推定は次の3種類のいずれかです。
- Measured(実測): そのハード・モデル・量子化で実際にベンチマークされた値
- Derived(導出): 近い構成の実測値から補間した値
- Projected(予測): 発表済み・未発売のハードなどを、スペックから計算した値
実測データがない場合は、上記の原理(帯域・演算性能)による計算にフォールバックします。部分オフロードの場合は、GPUに載った分をGPU帯域で、あふれた分をシステムRAMの実効帯域で読む、という混合モデルで推定します。メモリ適合の判定では、Macではユニファイドメモリの約75%、単体GPUではVRAMの約93%を使える量として扱います。実測の出典は、r/LocalLLaMA、localscore.ai、llama.cppのディスカッションなどです。
精度の限界 — Hacker Newsでの評価
READMEは、ドライバ、エンジンのバージョン、flash attention、電力制限、熱によって実測が10〜30%ずれうると明記しています。単一デバイスのみで、マルチGPU構成はまだシミュレーションできません。Hacker Newsのコメントでも、同じ点が具体的に指摘されました(いずれも投稿者の自己申告で、筆者は再現していません)。
- 推定が実機と合わないという報告: M2 Ultra 128GBの実機がM3 Ultra 512GBの表示値の約2倍速い、RTX 5090で27Bクラスの4bitモデルが表示より速い、RTX 4090で投機的デコード(ドラフトモデル)を使うと表示の数倍出る、など。あるコメントは、特定モデルの上限値が「feels kinda optimistic」だと評した
- 設定の差: 投機的デコード、KVキャッシュの量子化、並列推論、コンテキスト長などの調整を反映できていない
- 要望: マルチGPU(2×4090など)、PCIeやNVLink、GPU検索、AMDやQualcommの追加、プリフィル性能(エージェント的コーディングでは出力速度より重要という意見)
- 運用面の指摘: 実運用では60k〜140kトークン級の長いプロンプトが多く、短い入力のベンチマークの半分〜3分の1になりがち。単一チャット前提のため、並列利用では性能が下がる
- 別の選択肢: 数分間クラウドのGPUを借りて実機で試す方が確実という意見も多かった
一方で、「数万円〜数十万円の機材を買う前に、量子化を変えると何トークン/秒変わるかが見える」「ダウンロードして試す手間を省ける」という評価もありました。要するに、絶対値ではなく、構成同士の相対的な差と桁感をつかむ道具として評価されています。
既存ツールとの違い
近い目的のツールはいくつかあります。入力と出力が違うので、重ねて使えます。
| ツール | 形態 | 答えてくれること | 速度の扱い | 注意点 |
|---|---|---|---|---|
| Llmspeed | Webサイト(静的・MIT) | 選んだ構成で、回答がどんな速さで流れるか | tok/sとTTFTを体感再生。実測/導出/予測のラベル付き | 30デバイス×15モデル、単一デバイス、推定は10〜30%ずれうる |
| whichllm | CLI(MIT) | 手元(または指定GPU)で動き、性能の良いモデルは何か | メモリ帯域から生成速度を推定し、ベンチマークスコアと合わせて順位付け | --gpu "RTX 4090"で未所有GPUもシミュレート。主眼はモデル選び |
| llmfit | TUI/CLI/Web(MIT) | 手元のハードで動くモデルと、その適合度・速度・品質 | メモリ帯域モデルを実測で補正。llmfit benchで実機計測も可 | 自分のハードの検出が前提。購入前の比較は別途 |
| LapTime | ブラウザのシミュレータ(Hugging Face Space) | ハードとモデルの組み合わせでのプリフィル・TTFT・生成速度の比較 | ベンチマーク裏付けの行、モデル推定、コミュニティ参照を分けて表示 | 対象構成はサイト内のデータに依存 |
| VRAM計算ツール(当サイト) | Web(無料・登録不要) | モデル×量子化×コンテキスト長で必要VRAMと、動くGPU・Mac | 扱わない(載るかの判定) | 速度は出さない |
whichllmとllmfitは「自分のマシンに合うモデルを選ぶ」ことが中心で、LapTimeとLlmspeedは「買う前に構成同士の速度を比べる」ことが中心です。そのうえで、Llmspeedは体感再生に振った点が個性です。なお、VRAM計算ツールは速度ではなく必要メモリを出すため、Llmspeedとは補完関係にあります。載るかは当サイトのVRAM計算、速さはLlmspeed、という分担です。
買う前の使い分け
- 1. 載るかを確認: VRAM計算ツールで、使いたいモデルと量子化、必要なコンテキスト長のVRAM(重み+KVキャッシュ)を見る。個別モデルはGemma 4 必要スペック早見表のような記事でも確認できる
- 2. 速さを確認: Llmspeedで、載る構成同士のtok/sとTTFTを比べる。Apple Siliconを検討する場合はoMLXのようなMLX系のエンジンでも変わる点を意識する
- 3. 実機で検証: エンジンの違いで速度が変わるため、推論エンジン比較を参考に、可能なら短時間のクラウド環境や知人のマシンで実測する
使うときの注意点
- 表示は短いプロンプトの単一チャットが前提。長文のエージェント用途や並列利用では、実際はもっと遅くなる
- Projectedの値(未発売ハード)は、実測が出ると置き換わる。購入判断では実測ラベルの値を優先する
- モデルやGPUの追加はGitHubのIssueで受け付けている。自分のllama-benchの結果は、benchmarks/submissions.csvへのPull Requestで提供できる
- ソフトウェア側の最適化で数字は急に変わる。HNでも、最新のエンジンでは推定より速い例が報告された
よくある質問
Llmspeedは無料ですか?
READMEとサイトに料金の記載はなく、ソースコードはMIT Licenseで公開されています。ブラウザで開いて使う静的サイトで、インストールは不要です(2026年10月19日時点)。
表示される速度はどれくらい正確ですか?
READMEは、実機の結果がドライバ、エンジンのバージョン、flash attention、電力制限、熱によって10〜30%ずれうると明記しています。Hacker Newsでは、実機のほうが速いという報告が目立ちました。候補を絞る目安として使い、購入前に実機または短時間のクラウド環境で確かめるのが安全です。
速度はどんな原理で推定されていますか?
READMEによると、実測がない構成は、生成速度をメモリ帯域、プロンプト処理を演算性能(FP16 TFLOPS)で見積もり、実測から当てはめた係数とコンテキスト増による減速で補正します。MoEモデルはアクティブパラメータ分だけを読む前提です。
VRAM計算ツールとの違いは何ですか?
VRAM計算ツールは、モデル・量子化・コンテキスト長から必要メモリを出し、載るかどうかを判断します。Llmspeedは載る構成でどれくらいの速さが出るかを見ます。先にVRAM計算で候補を絞り、次にLlmspeedで速さを比べると効率的です。
複数GPUの構成はシミュレーションできますか?
できません。READMEは、現時点では単一デバイスのみで、テンソル分割やレイヤー分割のマルチGPU構成は未対応と説明しています。Hacker Newsでも要望が多く出ていました。
whichllmやllmfitと何が違いますか?
whichllmとllmfitは、自分のマシンを検出して動くモデルを推薦するCLIが中心です(どちらもMIT)。Llmspeedは、持っていないハードを含めて、構成ごとの速度を体感再生で比べるWebサイトです。目的が違うため併用できます。
まとめ
- Llmspeedは、GPU・Macとモデルを選ぶと推定tok/sとTTFTで回答が流れる、無料・MITのWebツール
- 速度の原理は、生成=メモリ帯域、プロンプト処理=演算性能、MoEはアクティブパラメータ。載るかは別の問い
- 数値は推定で、実測ラベル(Measured/Derived/Projected)つき。実機と10〜30%以上ずれる報告もある
- 使い分けは、載るか=VRAM計算ツール、速さ=Llmspeed、最終確認=実機または短時間のクラウド
ハードの購入は金額が大きい判断です。まず載るかを確かめ、次に速さの桁感をつかみ、最後に実機で確認するという順に進めると、後悔を減らせます。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ