Nemotron 3.5 Transcribe とは
プロンプトで制御できるNVIDIAの音声認識モデル。日本語対応・必要GPU・使い方【2026年】
Nemotron 3.5 Transcribeは2026年10月28日公開のNVIDIA製音声認識モデル。34B(有効4.3B)のMoEで日本語対応、ライセンスはOpenMDW-1.1。プロンプトで逐語・話者分離を制御。推奨H100 80GB、量子化版はRTX 5090も対応。使い方とベンチマーク。
Nemotron 3.5 Transcribe は、NVIDIAが2026年10月28日に公開した、プロンプトで挙動を制御できる多言語の音声認識(ASR)モデルです。 総パラメータ34B(有効約4.3B)のMoE構成で、モデルカードでは日本語が文字起こし・英語翻訳・複数話者ASRに対応(Production-ready)と明記されています。ライセンスはOpenMDW-1.1で商用・非商用とも利用可能。推奨環境は H100 80GB 1枚で、量子化版(FP8/NVFP4)ならRTX 5090などの個人向けGPUも対応表に載っています。録音済み音声(最長1時間)の高精度な文字起こしを自前環境でやりたいエンジニア向けです。
Nemotron 3.5 Transcribe とは
Nemotron 3.5 Transcribe(チェックポイント名 nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B)は、音声エンコーダとMamba-2とTransformerのハイブリッド構成のMoE言語モデルを組み合わせた音声認識モデルです。Hugging Faceブログでは「30B・有効約4B」、モデルカードでは「34B・有効約4.3B(音声エンコーダ約800Mを含む)」と表記が分かれており、ブログ側にその差の説明はありません。本記事ではモデルカードの数値を主に使います。
従来のASRが「音声を入れると文字が出る」だけだったのに対し、このモデルは自然言語の指示(プロンプト)でタスクと出力スタイルを切り替えます。同時に、学習に使われたデータ群の公開版として Granary v2 データセットも公開されました。
何ができるか
- プロンプトで文字起こし/翻訳/音声への質問応答(英語で学習)を切り替える
- 逐語(フィラーや言い直しを含む)か、整えた文章かといったスタイルを指定する
- 表記の仕方の指定や、専門用語リストを渡しての語彙補強
- 単語レベルのタイムスタンプ
- 話者ラベル付きの文字起こし(最大8話者)
- 最長1時間の録音を1回で処理(ブログでは録音済み音声向けで、ライブのストリーミング用途は想定外と説明)
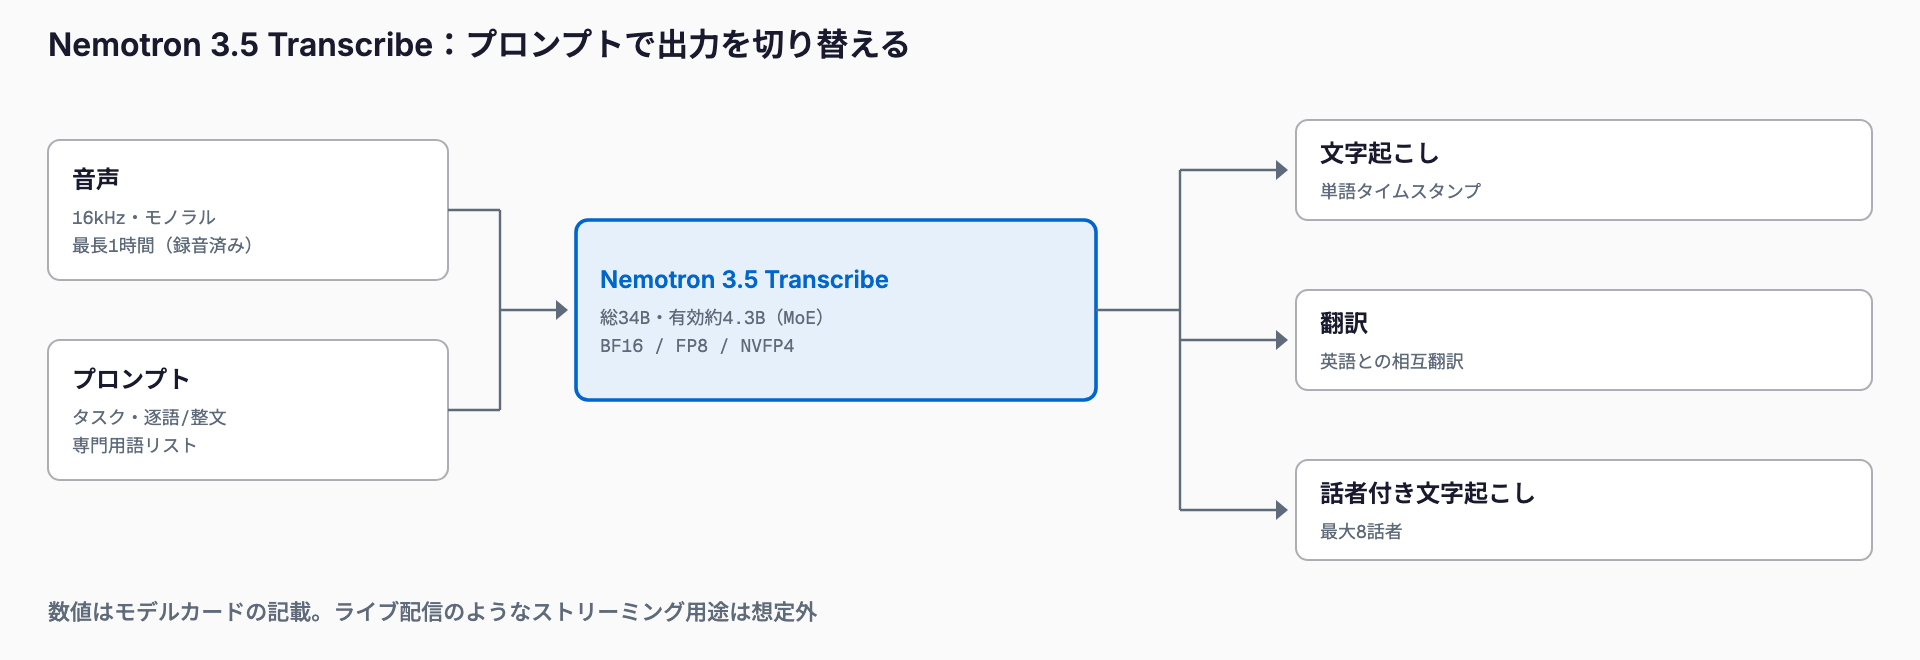
入力はモデルカード上 16kHz・モノラルの .wav/.flac/.mp3/.ogg、コンテキスト長は65,536トークンです。プロンプトの例として、モデルカードには「Audio transcription. Language: as spoken. Wording: verbatim, including fillers and repetitions.」という指示が載っています(句読点や大文字小文字、文字起こしのみを返す指定も含む完全版はモデルカード参照)。
対応言語と日本語
ブログでは、文字起こし40言語、英語との翻訳31言語、話者付与13言語と説明されています。ブログ自体は言語一覧を載せず、対応はタスクごとに異なるとしてモデルカードの対応表を案内しています。モデルカードの対応表では 日本語はASR・英語との翻訳・複数話者ASR・コードスイッチングに対応し、品質レベルは「Production-ready」 とされています。複数話者ASRの対象言語には日本語のほか、アラビア語、中国語(北京語)、英語、フランス語、ドイツ語、ヒンディー語、イタリア語、韓国語、ポルトガル語、ロシア語、スペイン語、タイ語が含まれます。
ただし、日本語単体のWER/CER(文字誤り率)は、私が確認できた範囲のブログ本文と要約にはありませんでした。日本語の精度は公表値からは判断できないため、自社の録音で検証することをおすすめします。なお、日本語非対応の小型モデルとの違いは Whistle の解説記事 が参考になります。
スペックとライセンス
| 項目 | 内容 |
|---|---|
| 提供元 | NVIDIA |
| 公開日 | 2026年10月28日 |
| パラメータ数 | 総計34B/有効約4.3B(言語バックボーン有効約3.5B+音声エンコーダ約800M)。ブログ本文は「30B・約4B」表記 |
| アーキテクチャ | 音声エンコーダ+Mamba-2/Transformerハイブリッド MoE(Parallel Expert Encoder) |
| 精度 | BF16(基準重み)、FP8版、NVFP4版 |
| ライセンス | OpenMDW-1.1(商用・非商用利用可) |
| 入力 | 16kHzモノラル、最長1時間、コンテキスト65,536トークン |
| 推奨GPU | H100 80GB 1枚 |
| 対応ランタイム | vLLM 0.32.0、Hugging Face Transformers、GGML、SGLang-Omni 0.2.0 |
ライセンスのOpenMDW-1.1はモデルカードの記載で、ブログ本文にはライセンスの言及がありません。実際に商用利用する場合は、モデルカードとライセンス本文を必ず原典で確認してください。Granary v2 側は、元コーパスごとのライセンスに従って音声を取得し、公開物の利用条件に従うよう案内されています。
必要VRAMの目安(推定を含む)
公式に明記されているVRAMの数値はありません。モデルカードが示すのは推奨構成(H100 80GB×1)と、対応GPUの表です。対応表にはA100 80GB、H100、H200、B200、GB200、GB300、RTX PRO 6000 Blackwell、DGX Spark、Jetson Thorに加え、RTX 5090(NVFP4のみ)、L40S(FP8のみ) が挙がっています。
以下は、パラメータ数から機械的に計算した推定です(実測ではなく、KVキャッシュや活性化の分は含みません)。BF16は34B×2バイトで約68GB、FP8は約34GB、NVFP4は約17GB強が重みだけの下限になります。MoEは有効パラメータが少なくても、全エキスパートをメモリに載せる必要がある点に注意してください。GPUを選ぶ際の考え方は Nemotron 3.5 Bolt の必要スペック記事 とも共通します。
| 精度 | 重みの目安(推定) | 公式の対応GPU例 |
|---|---|---|
| BF16 | 約68GB | H100 80GB(推奨)、A100 80GB |
| FP8 | 約34GB | L40S |
| NVFP4 | 約17GB | RTX 5090 |
使い方の最短手順
モデルカードには複数のロード方法が載っています。NeMoなら nemo_asr.models.ASRModel.from_pretrained("nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B")、Transformersなら AutoModelForMultimodalLM.from_pretrained(..., device_map="auto") が紹介されています。サーバーとして動かすなら vLLM が最短です。
- 1. vLLM 0.32.0 と、モデルカードが案内するNeMo音声プラグインをインストールする
- 2. 環境変数 VLLM_PLUGINS=nemo_speechlm を設定する
- 3. vllm serve ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B でサーバーを起動する(完全なコマンドと引数はモデルカード参照)
- 4. OpenAI互換のクライアントから音声とプロンプトを送る(Pythonクライアントの完全版もモデルカード参照)
- 5. プロンプトで逐語/整形、用語リスト、タイムスタンプの有無を調整する
ホスト型の利用もでき、ブログではBaseten、DeepInfra、Simplismartのエンドポイントが挙げられています。ローカル向けにはNeMo-Speech.cppによる量子化版の実行にも触れられています。
ベンチマークの読み方
以下はいずれもNVIDIA側が公表した値です(モデルカード/ブログ)。測定条件が異なる値が混在するため、数字同士を単純に比較しないでください。
| 指標 | 結果 | 備考 |
|---|---|---|
| Open ASR 英語(9データセット平均) | WER 4.71 | モデルカード。次点は Qwen3-ASR-1.7B の 4.94 |
| Open ASR 英語 | 平均WER 5.33、RTFx 462.09 | ブログ記載。モデルカードの4.71とは集計条件が異なる可能性あり |
| Open ASR 多言語(7言語) | 平均WER 4.62 | 次点は Qwen3-ASR-1.7B の 6.49 |
| Open ASR ロングフォーム | 平均WER 10.98 | 次点は Parakeet-TDT-0.6B-v3 の 13.37 |
| 複数話者 cpWER(4セット) | 15.80 | 次点は DiCoW v3.3 + DiariZen の 16.83 |
| Artificial Analysis AA-WER | 2.8% | オープンウェイトで首位タイ |
| 処理速度 | 音声100時間を3分未満 | RTX PRO 6000 Blackwell 1枚、近日公開のNVFP4版、30秒クリップ・高並列 |
ブログには、インドの医療音声での事例も載っています。標準のままではWER 30.8%、プロンプト改善で23.8%、約14 GPU時間(GB300 1枚)のファインチューニングで11.8%まで下がったという報告です。一方で LibriSpeech test-clean は1.54%から1.69%へわずかに悪化しており、特化チューニングの代償も示されています。
既存ASRとの違い
OpenAIのWhisper large-v3/turboとの直接比較は、確認できた一次情報にはありませんでした。そのため表では不明を「ー」としています。比較対象はNVIDIA自身が示した競合(Qwen3-ASR、Parakeet、Canary-Qwen)です。
| モデル | 規模 | 日本語 | 公表されている比較値 |
|---|---|---|---|
| Nemotron 3.5 Transcribe | 34B/有効約4.3B | 対応(Production-ready) | 英語WER 4.71、多言語7言語 4.62、ロングフォーム 10.98 |
| Whisper large-v3 | ー | ー(本記事では未確認) | ー |
| Whisper turbo | ー | ー(本記事では未確認) | ー |
| Parakeet-TDT-0.6B-v3 | 0.6B | ー | ロングフォーム 13.37(NVIDIA比較表) |
| Qwen3-ASR-1.7B | 1.7B | ー | 英語 4.94、多言語 6.49(NVIDIA比較表) |
| Canary-Qwen | ー | ー | Preference-ASR 8.16/8.36(既定/指示あり)。本モデルは7.56/6.16 |
最大の違いはサイズと制御性です。0.6B〜1.7B級のモデルより桁違いに大きく、導入にはGPUが必要ですが、プロンプトで逐語・整形・用語補強・話者分離まで一つのモデルで扱えます。小さくプライベートに動かしたい用途なら TypeWhisper のようなローカル音声入力ツールが向きます。会議の文字起こしから議事録を作る流れは 議事録AIの解説記事 も参照してください。
向いている用途と注意点
- 会議・コールセンター・インタビューなど、話者ラベルが必要な長尺の録音の文字起こし
- 医療や法務など、専門用語リストとファインチューニングで精度を詰めたい領域
- 日本語と他言語が混在する録音(コードスイッチング対応と記載)
- リアルタイムの字幕生成には不向き(ブログが録音済み音声向けと明記)
- GPUなしのPCやスマホで動かす用途には重い
よくある質問
Nemotron 3.5 Transcribe は日本語に対応していますか。
はい。モデルカードの対応表で、日本語はASR・英語との翻訳・複数話者ASR・コードスイッチングに対応し、品質は「Production-ready」とされています。ただし日本語単体のWER/CERは、確認できた範囲では公表されていません。
ライセンスは商用利用できますか。
モデルカードにはOpenMDW-1.1で、商用・非商用とも利用可能と記載されています。実利用の前に必ずライセンス本文を原典で確認してください。なおGranary v2は元コーパスごとのライセンスに従う必要があります。
必要なVRAMはどのくらいですか。
公式にVRAMの数値は明記されていません。推奨はH100 80GB 1枚で、RTX 5090はNVFP4版のみ、L40SはFP8版のみ対応と記載されています。重みだけの計算では、BF16で約68GB、FP8で約34GB、NVFP4で約17GBが目安(推定)です。
ライブのリアルタイム文字起こしに使えますか。
ブログでは録音済み音声向けのモデルで、ストリーミング用ではないと説明されています。最長1時間の録音を処理する設計のため、リアルタイム用途には別のモデルを検討してください。
Granary v2 とは何ですか。
NVIDIAが公開した音声データセットで、公開版は48言語・16コーパス・463,062時間です(ブログ記載。学習に使った全データではなく公開版の数値)。転写3形式(tn_raw/itn_raw/itn_clean)や翻訳、音声Q&Aなどのラベルを含みます。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ