Qwen-Image-2.1 必要スペック・使い方
7Bで生成と編集を統合、透過PNG・10枚参照編集【2026年9月】
Qwen-Image-2.1は、画像生成7Bと画像編集を1モデルに統合したAlibaba製オープンウェイトモデルで、2026年9月20日に公開された。透過PNG出力・10枚参照編集・領域指定編集に対応し、10月9日には8ステップの高速版Turboも登場している。VRAM要件は公式未公開で目安十数GB、ライセンスは非商用研究限定という制約に注意しておきたい。
Qwen-Image-2.1 は、Alibaba Qwenチームが2026年9月20日にオープンウェイトを公開した画像生成モデルで、視覚生成部7B+テキストエンコーダ(Qwen3-VL)8Bという構成で、テキストからの画像生成と画像編集を1つのモデルに統合している。結論から言うと、公式のVRAM要件表は公開されておらず、コミュニティ報告ではある構成で約15.6GB前後という数字があるものの、パラメータ規模から計算上はbf16フルロードで合計30GB前後が目安になる。ライセンスはQwen Research License Agreementで非商用研究・評価用途に限定されており、業務利用には別途契約が必要という点にも注意したい。透過PNGのネイティブ出力や最大10枚の参照画像を使った編集など、単体の生成モデルというより「生成+編集ツール」として設計されているのが特徴だ。以下、必要スペックの目安と使い方をまとめる。なお、2026年10月9日に8ステップの高速版 Qwen-Image-2.1-Turbo が公開されたため、後半に追記している。
必要スペック早見表
| 構成 | VRAM目安 | RAM目安 | 速度目安 | 用途 |
|---|---|---|---|---|
| bf16フルロード(計算上の目安) | 約30GB前後(7B≈14GB+8Bテキストエンコーダ≈16GB) | 32GB以上推奨 | RTX 4090級で1MP画像あたり約5秒(コミュニティ報告) | 24GB超の単一GPUでの快適な運用 |
bf16+CPUオフロード(enable_model_cpu_offload()) | コミュニティ報告で15.6GB前後というケースあり | 32〜64GB推奨 | フルロードより低速(オフロード分の転送が発生) | 24GB以下のコンシューマGPUでの動作 |
| FP8量子化(vLLM-Omni想定) | 計算上はbf16の半分程度、15GB前後が目安 | 32GB以上推奨 | 実測未公開。TensorRT/FP8最適化次第で高速化が期待できる | VRAMが限られる環境・複数リクエスト処理 |
| CPUのみ | VRAM不要 | 32GB以上必須 | コミュニティ報告でノートPC CPUのみ約3分/枚 | GPUなし環境での動作確認・検証用途 |
上記の「計算上の目安」は、視覚生成部7B・テキストエンコーダ8Bというパラメータ数からbf16(1パラメータ2バイト)で単純計算した値であり、実際のアクティベーションメモリやVAE分は含んでいない。実測に近い数字を知りたい場合は、同じ手法で計算したMiniMax H3の必要スペック早見表も参考にしてほしい。あちらは動画・音声生成モデルのため規模は大きく異なるが、公式VRAM要件が未公開のモデルで目安をどう見積もるかという考え方は共通している。
Qwen-Image-2.1 とは(アーキテクチャ)
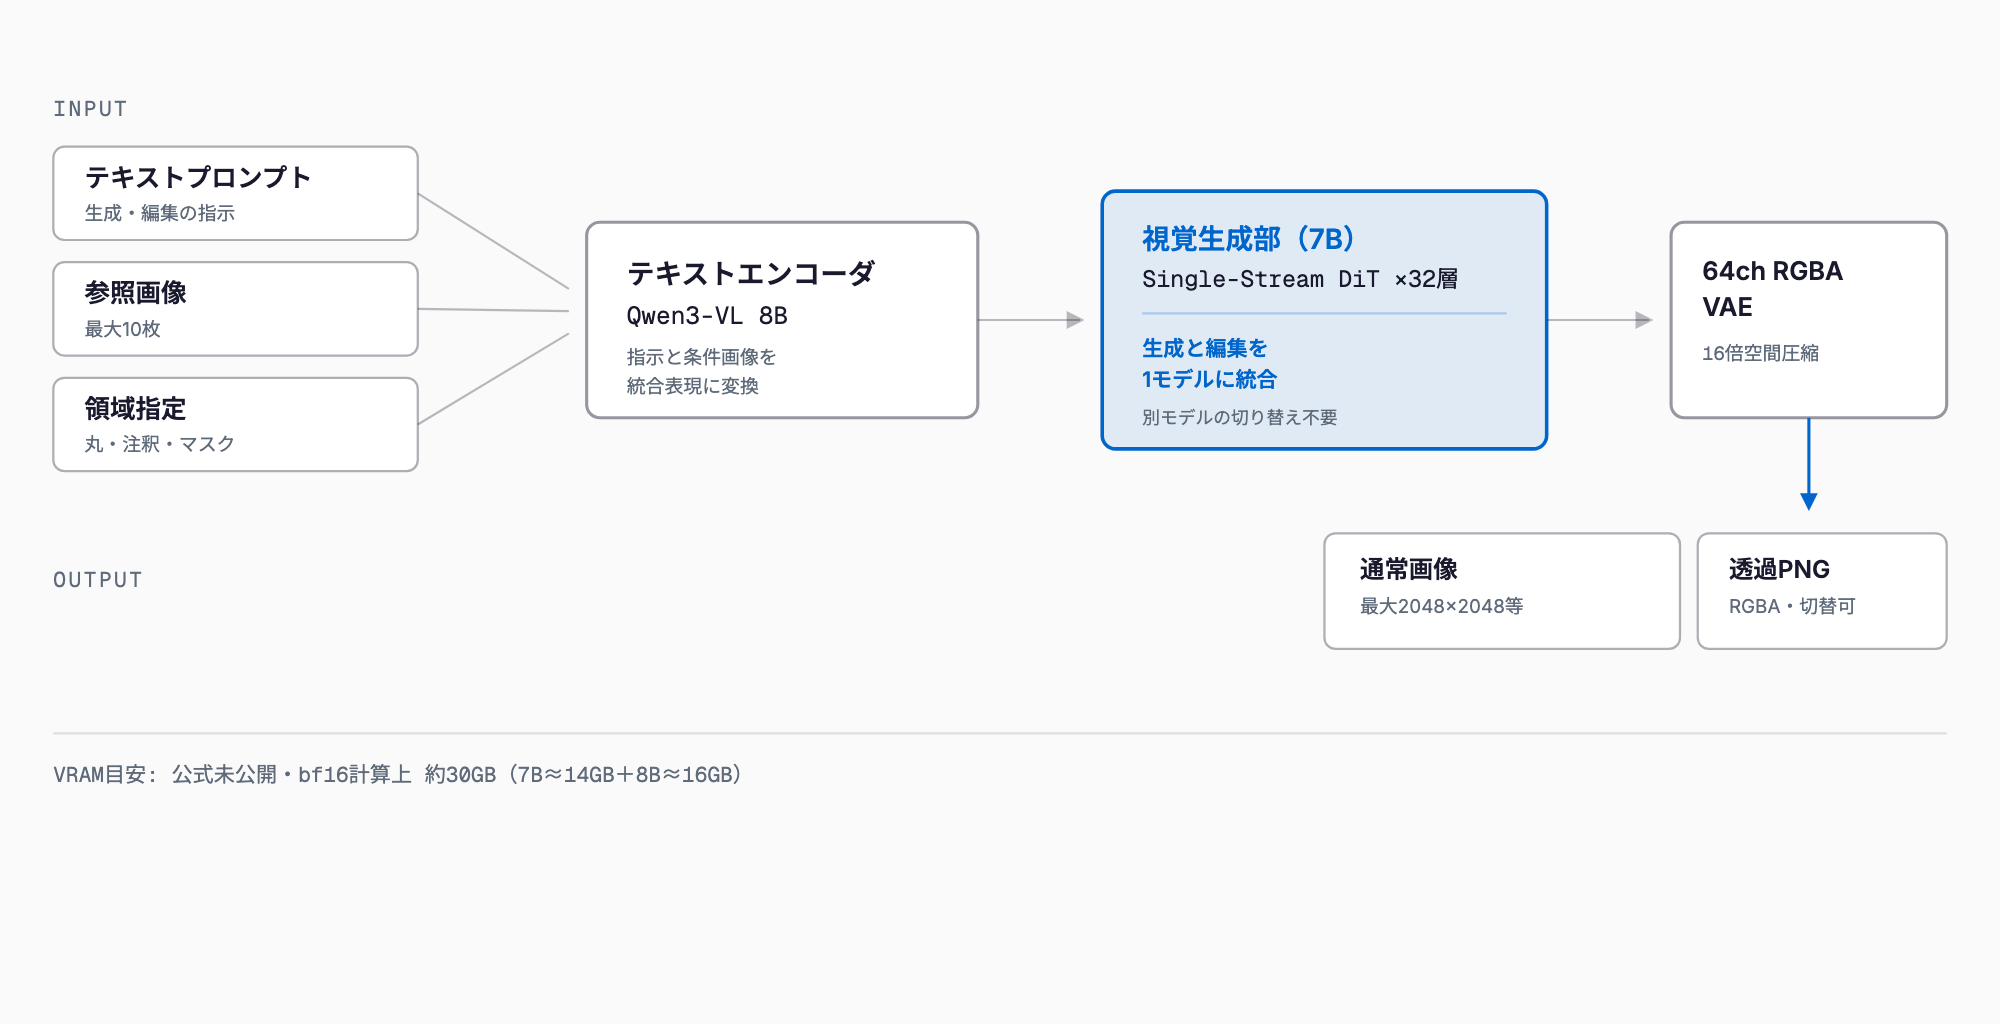
Qwen-Image-2.1は、視覚生成コンポーネントとテキストエンコーダの2階建て構成を取る。視覚生成部は7Bパラメータで、32層のSingle-Stream DiT(Diffusion Transformer)レイヤーに、粒度の異なるアテンションを混在させる「mixed-granularity attention」を採用している。テキストエンコーダにはQwen3-VL 8Bを用い、テキスト指示だけでなく編集対象となる条件画像(condition images)もエンコードできる点が、単純な生成専用モデルとの違いだ。画像のエンコード・デコードには64チャンネルのRGBA VAEを使用し、16倍の空間圧縮を行う。RGBAチャンネルを持つVAEを採用していることで、透明背景を含む画像をネイティブに扱える設計になっている。前身であるQwen-Imageは約20Bパラメータの生成専用モデルだったが、2.1では生成部を7Bまで縮小しつつ編集機能を統合しており、パラメータ効率という観点でも大きな方向転換と言える。
できること
- テキストから画像生成と画像編集の統合: 1つのモデルで新規生成と既存画像の編集を両方こなせる。
- 透過PNGのネイティブ出力: 64チャンネルRGBA VAEにより、プロンプトの内容次第で背景を透明にした画像をそのまま出力できる。
- 最大10枚の参照画像を使った編集: 複数の参照画像を条件として渡し、それらの要素を組み合わせた編集ができる。
- 写真からの被写体抽出: 元画像から特定の被写体だけを切り出すような編集に対応。
- 円・注釈・マスクによる領域指定編集: 画像上に丸で囲む・注釈を入れる・マスクを描くといった方法で、編集したい領域を明示的に指定できる。
対応解像度
| アスペクト比 | 解像度 |
|---|---|
| 1:1 | 2048×2048 |
| 4:3 | 2400×1792 |
| 3:4 | 1792×2400 |
| 3:2 | 2528×1696 |
| 2:3 | 1696×2528 |
| 16:9 | 2752×1536 |
| 9:16 | 1536×2752 |
ベンチマーク
以下はQwenチーム独自のベンチマーク「Qwen-Image-Bench」によるベンダー報告値であり、第三者による再現・検証はまだ確認できていない点に注意してほしい。
| モデル | Qwen-Image-Bench スコア | 公開形態 | パラメータ |
|---|---|---|---|
| GPT Image 2.5 Sunburst | 67.01(1位) | 非公開(クローズド) | 非公開 |
| Qwen-Image-2.1 | 60.28 | オープンウェイト | 7B(生成部) |
| Nano Banana 2.0 | 59.82 | 非公開(クローズド) | 非公開 |
| FLUX 2 Max | 55.33 | オープンウェイト | 32B |
インストールと使い方
最短で動かすにはDiffusersを使う。必要なパッケージは torch>=2.4.0、transformers>=5.17、GitHub最新版のdiffusers(pip install git+https://github.com/huggingface/diffusers)、accelerate、pillowの5つ。インストール後は次のようなコードで生成できる。
- pip install torch>=2.4.0 でPyTorchをインストール
- pip install transformers>=5.17 でtransformersをインストール
- pip install git+https://github.com/huggingface/diffusers でDiffusers最新版をインストール(2026年9月時点でQwen-Image-2.1対応のQwenImage21PipelineはGitHub版にのみ含まれる)
- pip install accelerate pillow で残りの依存パッケージをインストール
- Pythonから from diffusers import QwenImage21Pipeline としてパイプラインを読み込み、Qwen/Qwen-Image-2.1 を torch_dtype=torch.bfloat16 で .to("cuda") にロードし、pipe(prompt="...", num_inference_steps=40).images[0] で画像を生成する
- VRAMが厳しい場合は pipe.enable_model_cpu_offload() を呼んでからロードすることで、GPUメモリの使用量を抑えられる(速度は低下する)
ComfyUI / vLLM-Omni / SGLang での動かし方
Qwen-Image-2.1はDay-0で複数の推論フレームワークに対応している。ComfyUIはネイティブ対応で、公式のサンプルワークフローが配布されている。本格運用に向けては、Diffusersのほかにも以下の選択肢がある。
- ComfyUI: ネイティブ対応。公式のexampleワークフローをロードするだけでノードベースの生成・編集が試せる。
- Diffusers: QwenImage21Pipeline を通じて最も手軽にPythonから利用できる方法。
- vLLM-Omni: prefix KVキャッシュ、テンソル並列、FP8量子化に対応しており、複数リクエストをまとめて処理するサーバー運用に向く。
- SGLang: マルチGPU構成での高速推論を想定した対応が示されている。
Qwen-Image-2.1-Turbo(2026年10月)— 8ステップの高速版
2026年10月9日、Qwenチームは標準モデルの加速版チェックポイント Qwen-Image-2.1-Turbo をHugging Faceで公開した。視覚生成部は標準モデルと同じ7Bアーキテクチャで、サンプリングを標準の40ステップから8ステップに短縮したものだ。8ステップ用のsigmaスケジュールはチェックポイントに保存されており自動で読み込まれるため、num_inference_steps だけを指定しても上書きされない(通常のDiffusersの流儀とは異なる点に注意)。CFGは既定で1、use_kv_cache=True を指定するとテキストや参照画像の文脈(プレフィックス)をステップ間で再利用できる。なお、蒸留の具体的な手法はモデルカードに記載がない。
| 項目 | Qwen-Image-2.1(標準) | Qwen-Image-2.1-Turbo |
|---|---|---|
| 推論ステップ数 | 40(本記事のサンプルコード) | 8(スケジュール固定) |
| 速度目安 | 基準。RTX 4090級で1MPあたり約5秒(コミュニティ報告) | ステップ数は5分の1。ただし公式の実測値はなく、テキストエンコーダとVAEの処理は残るため、実時間の短縮は5倍より小さい |
| 品質 | Qwen-Image-Benchで60.28(ベンダー報告) | ベンチマーク未公開。公式はサンプル画像のみで、標準との差は未検証 |
| CFG | 通常のガイダンス設定 | 既定で1 |
| ライセンス | Qwen Research License(非商用の研究・評価用途) | 同じくQwen Research License |
| 向く用途 | 品質優先の最終出力・精密な編集 | 構図の試行錯誤、プロンプト検証、大量のドラフト生成 |
メモリ面では、Hugging Faceのリポジトリは標準モデルと同様に7B生成部+Qwen3-VL 8Bテキストエンコーダの構成で、重みの合計は約32.4GBと報告されている(二次情報)。ステップ数が減ってもモデルのロード量は変わらないため、必要VRAMは標準モデルと同程度とみるのが妥当だ。Turbo向けのVRAM要件は公式に公開されておらず、24GB以下のGPUでは enable_model_cpu_offload() や量子化が前提になる。速くなるのは1枚あたりの計算時間であって、必要メモリではない。
使い方はDiffusersの QwenImage21Pipeline に Qwen/Qwen-Image-2.1-Turbo を torch.bfloat16 で読み込み、pipe(prompt=..., width=1696, height=2528, use_kv_cache=True) のように呼ぶだけでよい(標準版のようにステップ数を指定しなくてよい)。Diffusersは、パイプライン側で設定されたサンプリングsigmaに対応した最新のGitHub版が必要で、transformers>=5.17 も要る。ComfyUIでの対応はモデルカードに記載がなく、本記事の執筆時点では確認できていない。標準版のワークフローを流用できるかは、各自で検証してほしい。
ライセンスは標準モデルと同じQwen Research Licenseで、商用利用はできない(別途Alibabaとの契約が必要)。Turboが速いからといって業務利用の扱いが変わるわけではない。同日にTurboとProのAPIが発表されたと伝えられているが、料金・レート制限・提供リージョンは確認できていない。商用で使うなら、ライセンス条項とAlibaba Cloud Model Studioの最新情報を確認したい。
ライセンスと商用利用の注意
Qwen-Image-2.1はQwen Research License Agreementのもとで公開されており、非商用の研究・評価目的での利用に限定されている。商用利用には別途Alibabaとのライセンス契約が必要とされ、2026年9月の公開時点で公開されている料金プランはない。API利用についても、Alibaba Cloud側の正式な価格発表はまだなく、前身のQwen-Image 2.0のAPIが1枚あたり0.035〜0.075米ドルだったことが参考情報としてある程度だ。中国本土向けには wuli.art で無料アクセスが提供されている。業務での導入を検討する場合は、ライセンス条項を必ず確認し、必要であれば別モデル(例:GPT Image 2.5のような商用利用が明確なAPIモデル)との比較も行いたい。
既存モデルとの違い
| モデル | 公開形態 | パラメータ | 編集機能 | 透過出力 | ライセンス |
|---|---|---|---|---|---|
| Qwen-Image-2.1 | オープンウェイト | 7B(生成部)+8B(テキストエンコーダ) | 統合(最大10枚参照) | ネイティブ対応 | 非商用研究限定 |
| 初代Qwen-Image | オープンウェイト | 約20B(生成専用) | 非対応 | 非公開 | 非公開 |
| FLUX 2 Max | オープンウェイト | 32B | 一部対応 | 非公開 | 非公開 |
| Nano Banana 2.0 | クローズド | 非公開 | 対応 | 非公開 | 非公開(API提供) |
| GPT Image 2.5 Sunburst | クローズド | 非公開 | 対応 | 非公開 | 非公開(API提供) |
トラブルシューティング
- VRAM不足でロードに失敗する: まず pipe.enable_model_cpu_offload() を有効にしてロードする。それでも不足する場合はFP8量子化に対応したvLLM-Omni経由の利用を検討する。
- QwenImage21Pipeline が見つからないというエラーが出る: PyPI版のdiffusersにはまだ含まれていない可能性がある。pip install git+https://github.com/huggingface/diffusers でGitHub最新版に切り替える。
- transformersのバージョン不整合エラー: transformers>=5.17 を満たしているか確認し、古いバージョンが混在していないか pip list でチェックする。
- 生成が極端に遅い: CPUのみでの実行になっていないか確認する。GPUが認識されているか torch.cuda.is_available() で確認し、.to("cuda") が正しく効いているかを見直す。
- 透過PNGにならない: プロンプトが透明背景を暗示する内容になっているか確認する。背景を明示的に指定していると、モデルが不透明画像として出力する場合がある。
よくある質問
Qwen-Image-2.1の必要VRAMは公式に発表されていますか?
いいえ。2026年9月20日の公開時点で、Qwen team(Alibaba)による明示的なVRAM要件表は示されていません。本記事のVRAM目安は、視覚生成部7B・テキストエンコーダ8Bというパラメータ規模からの計算上の見積もりと、コミュニティの実測報告(ある構成でVRAM約15.6GB、RTX 4090で1MP画像あたり約5秒という報告)を整理したものです。
Qwen-Image-2.1は商用利用できますか?
公開時点ではQwen Research License Agreementのもとで提供されており、非商用の研究・評価用途に限定されています。商用利用にはAlibabaとの別途契約が必要とされ、2026年9月時点で公開されている料金体系はありません。業務での利用を検討する場合はライセンス条項を必ず確認してほしい。
Qwen-Image-2.1と初代Qwen-Imageの違いは何ですか?
初代Qwen-Imageは約20Bパラメータの生成専用モデルでしたが、Qwen-Image-2.1は視覚生成部を7Bに縮小しつつ、Qwen3-VL 8Bのテキストエンコーダと組み合わせることで、画像生成と画像編集(10枚までの参照画像対応)を1モデルに統合した点が最大の違いです。
透過PNGはどうやって出力しますか?
特別な設定は不要で、プロンプトの内容から透明背景が適切と判断された場合にモデルが自動的にRGBA透過PNGを出力する。64チャンネルのRGBA VAEを採用しているため、背景を透明にしたいアイコンやロゴ生成のプロンプトを与えるだけで対応できる。
Macで動かせますか?
2026年9月時点で公式のMLX対応やApple Silicon向けの動作報告は見当たらない。CPUオフロードを使えば動作自体は可能とみられるが、コミュニティ報告ではノートPCのCPUのみで1枚あたり約3分かかるとされており、実用的な速度を求めるならNVIDIA GPU環境か、今後のコミュニティ移植版を待つのが無難だろう。
Qwen-Image-2.1-Turboとは何ですか?標準モデルとどう違いますか?
2026年10月9日に公開された、Qwen-Image-2.1の加速版チェックポイントです。7Bの生成部は標準モデルと同じで、推論を40ステップから8ステップに短縮し、CFGは既定で1、プレフィックスKVキャッシュにも対応します。必要VRAMは標準モデルと同程度とみられ、ライセンスも同じQwen Research License(非商用)です。品質の公式ベンチマークは公開されていません。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ