TypeSafe Jev 実践ガイド
Choice/Score/Noulの書き方と活用アイデア12選【API・コード例つき】
TypeSafe Jevの実践編。質問を原子的に分ける・1リクエストにまとめる・confidenceで分岐する、の3原則を、curl/Python/TypeScript/Workersのコード例とともに解説し、12の活用アイデア、コスト試算、向かない10の弱点、日本語運用の現実解まで具体的にまとめる。
Jevは、文章を生成する代わりに、state(状態)と型付きの質問を送ると、質問ごとに型付きの答えと確率を1回の並列パスで返すAPIだ。TypeSafe AIによれば応答は70〜500ms、フロンティアLLM比40〜200倍高速とされる(自社評価の上限値であり、第三者検証はない)。実践編である本記事が扱うのは「どう書くか・何に使うか・どこで失敗するか」の3点で、要点は①質問を原子的に分ける②1リクエストにまとめる③confidenceでコードが分岐する、の3つに尽きる。
Jevの基本仕様(3つの質問型・料金・制限)は入門編のTypeSafe Jevとはで解説済みなので、先にそちらを読むと理解が早い。本記事は2026-09-19時点の公式ドキュメント(docs.typesafe.ai)とtypesafe.ai公式ブログの記述に基づいている。
1リクエストの構造 — state・questions・answers
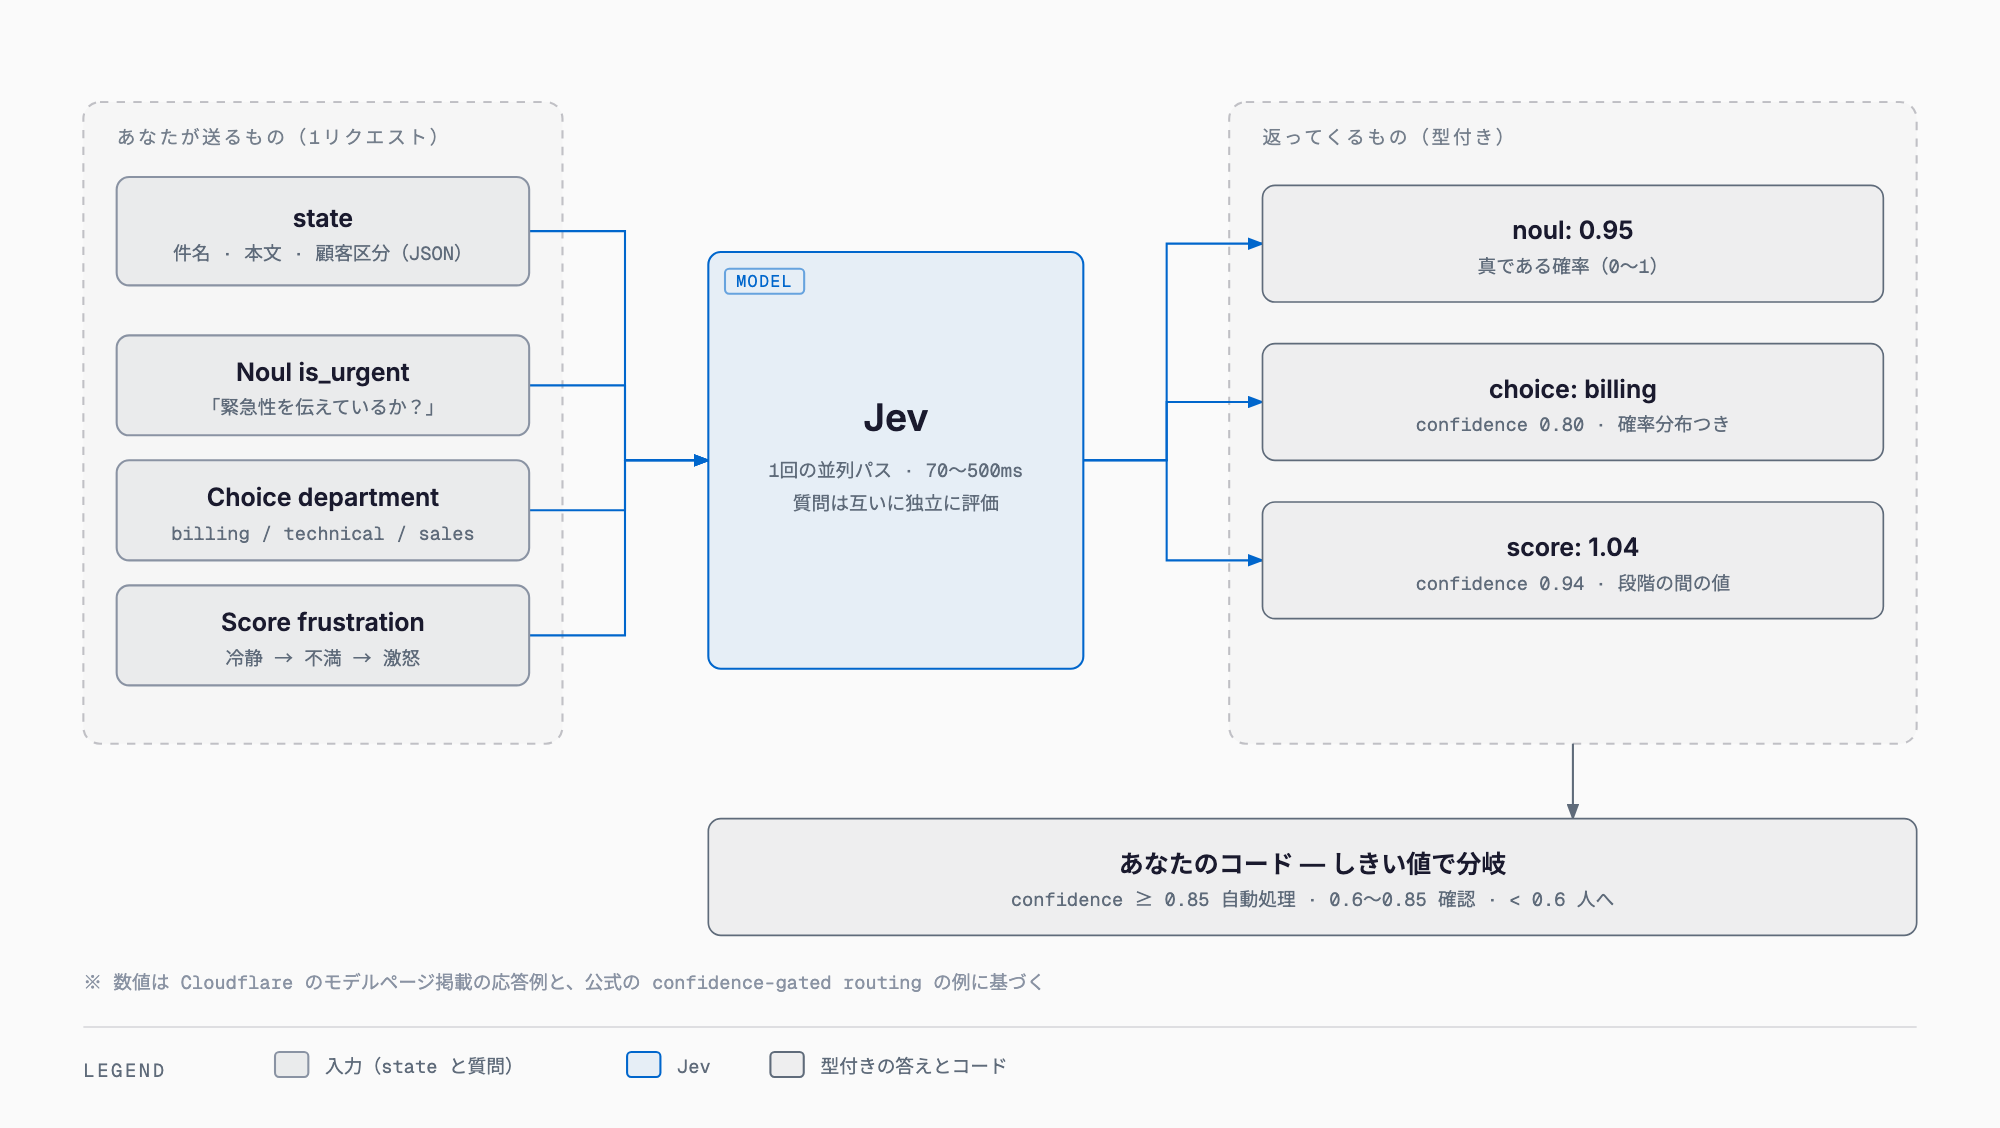
1回のリクエストは3つの要素でできている。まずstateに評価対象のテキストやJSONを入れる。次にquestionsで、自分でキー名を決めた質問を1個以上並べる。質問にはChoice(どれか?)・Score(どの段階か?)・Noul(これは真か?)の3種類があり、1リクエストに混在させてよい。すべての質問は同じstateに対して並列かつ互いに独立に評価されるため、質問を1個足しても他の質問の答えは変わらない。返ってくるanswersは質問ごとに型が決まっていて、Noulはnoul(0〜1)、Choiceはchoice・probabilities(全選択肢の確率分布)・confidence、Scoreはscore(段階間の値も取る)・legend・probabilities・confidenceを含む。あとはコード側でconfidenceやnoulの値をしきい値と比較し、自動実行・確認・人への引き継ぎといった分岐を書けばよい。
| 型 | 問い | criteria | 返り値 | 向く場面 |
|---|---|---|---|---|
| Choice | どれか?排他的な選択肢から1つ | 選択肢キー→説明のmap(説明はnull可。リストが不完全かもしれないときはotherを入れる) | choice、probabilities(全選択肢の分布)、confidence | 担当振り分け・カテゴリ分類 |
| Score | どの段階か?順序のある段階 | 段階の説明の配列(2個以上、最初→最後がスペクトラム) | score(段階間の値も取る。例1.04)、legend、probabilities、confidence | 深刻度・習熟度など連続的な尺度 |
| Noul | これは真か? | 任意でtrue/falseの意味の説明 | noul(0〜1。1に近いほど強いyes、0.5付近は不確か) | 二値判定・ガードレール |
最短で動かす — curl・Python・TypeScript・Cloudflare Workers
早期アクセスのAPIキーは https://console.typesafe.ai/keys から取得する。以下はHTTP APIをcurlで直接叩く例だ。
```bash
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d @- <<'EOF'
{
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and it keeps failing. I'm losing sales. Please help ASAP.",
  "model": "jev-latest",
  "questions": {"urgency": {"type": "noul", "instructions": "Does this message express urgency?"}}
}
EOF
```
レスポンスは質問ごとのanswersと、トークン数を示すusageを含む。以下は公式ドキュメントに載っている応答例だ。
```json
{"model":"jev-latest","answers":{"is_urgent":{"type":"noul","noul":0.999}},"usage":{"input_tokens":312,"output_tokens":48}}
```SDKも用意されている。Pythonはpip install typesafe-sdk(またはuv add typesafe-sdk。環境変数TYPESAFE_API_KEYを読む)、JavaScript/TypeScriptはnpm install @typesafe-ai/sdk(v0.6.0、Node.js 20以上、ESM/CommonJS両対応・型定義同梱)で、質問オブジェクトから答えの型が推論される。Pythonには同期のTypeSafeClientと非同期のAsyncTypeSafeClient、RetryPolicyが用意されている。
```python
from typesafe_sdk import Noul, TypeSafeClient

client = TypeSafeClient()
response = client.system_one(
    state="Customer message here",
    questions={"is_urgent": Noul(instructions="The message conveys urgency")}
)
print(response.answers["is_urgent"].noul)
```
```ts
import { choice, TypeSafeClient } from "@typesafe-ai/sdk";
const client = new TypeSafeClient();
const response = await client.systemOne({
state: { document: "I was charged twice. Please fix this ASAP." },
questions: {
category: choice("What is this ticket about?", { billing: null, technical: null, other: null }),
},
});
console.log(response.answers.category.choice);
```Cloudflare Workers AIのモデルカタログにもtypesafe/jevとして掲載されており(コンテキスト32,000、jev-1.13.0)、env.AI.runから直接呼べる。以下はChoice・Noul・Scoreを1リクエストに混在させた公式のサンプルだ。
```ts
const response = await env.AI.run('typesafe/jev', {
  state: 'Help! My payouts have been failing for 3 days.',
  questions: {
    is_urgent: { type: 'noul', instructions: 'Does this convey urgency?',
      criteria: { true: 'Explicitly time-sensitive', false: 'No urgency expressed' } },
    department: { type: 'choice', instructions: 'Which team should handle this?',
      criteria: { billing: 'Payments, invoicing, refunds', technical: 'Bugs, outages, integrations', sales: 'Pricing, upgrades, new accounts' } },
    frustration: { type: 'score', instructions: 'How frustrated is the customer?',
      criteria: ['Calm', 'Frustrated', 'Very angry'] },
  },
})
```エラーは401(キー不正)・422(バリデーション失敗)・429(レート制限)・529(過負荷)を返す。429・529は指数バックオフで再試行するのが基本で、SDKは自動で行う。レート制限は25万トークン/秒・1,200リクエスト/分で需要により動的に変動する。本番で使えるモデルはjev-1.13.0のみで、jev-latest(SDK既定)とjev-previewはどちらも現在この版を指すエイリアスだ。エイリアスは新リリースで自動的に切り替わるため、挙動の一貫性が必要ならjev-latestではなくバージョンIDを直接指定して固定するとよい。実際に使われたバージョンはレスポンスのmodelフィールドで確認できる。
コーディングエージェント向けのスキルも配布されている。Claude Codeなら以下でインストールできる。
```bash
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
# その他のエージェントは:
# npx skills add typesafe-ai/skills --skill typesafe-ai
```
公式によれば、エージェントは質問を書くのがあまり得意ではないため、人が一緒に磨くことと、質問としきい値を1か所にまとめてレビューしやすくすることを勧めている。
設計の原則 — コードが主、モデルは部品
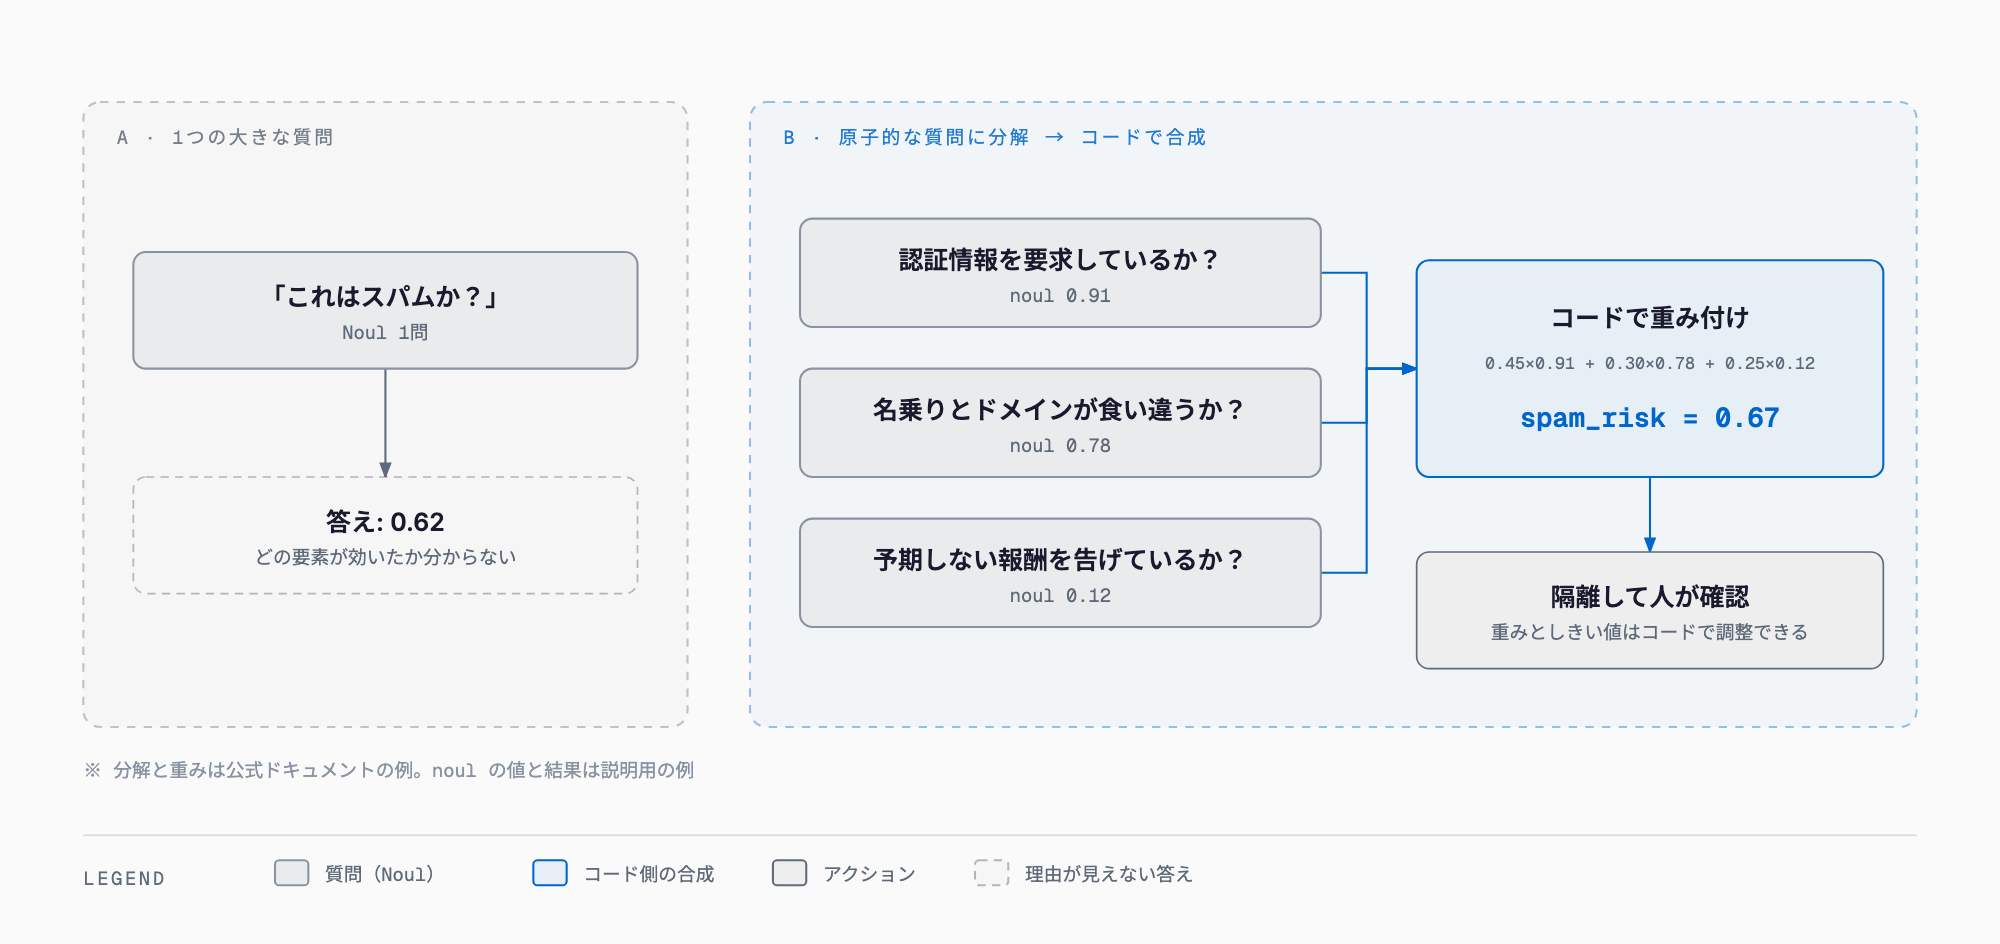
公式ドキュメント「How to build with TypeSafe」の核心は、制御フロー・決定的なルール・副作用はコードに置き、モデルには行動を選ばせない、という一点にある。スパム判定を例にすると、「これはスパムか?」という1つの大きな質問に答えさせるのは悪い設計だ。代わりに「認証情報を要求しているか?」「送信者の名乗りとメールドメインが食い違うか?」「予期しない当選・報酬を告げているか?」という3つの原子的なNoulに分解し、spam_risk = 0.45×credentials + 0.30×identity + 0.25×rewardのようにコード側で重み付けして合成する。この分解には説明可能性・合成可能性・精度という3つの利点があるとされる。
| 置き場所 | 具体例 |
|---|---|
| コード | 期日超過の判定などの決定的ルール、オーケストレーション、出力の合成、副作用 |
| モデル | 非構造テキストの解釈、あいまいな文脈での常識的判断、主観的性質の分類・採点、矛盾の検出 |
stateには関係する情報だけを入れる。無関係な情報が多いstateは精度を落とすと公式は明記している。JSON化してバッククォート付きのパスで質問から参照する書き方(例: ticket.messages[0].text)も推奨されており、モデルの知識に頼らず最新情報はstateで渡す。instructionsはキー名が自明でも省略せず完全な文で書き、1問につき「詳しい人が数秒で下せる判断」を1つに絞る。複雑な指示は{question, focus, compare}のようなオブジェクトに、Choiceの選択肢は{what, not_for, examples}という対比形式にすると精度が上がるとされる。
- 決定的なロジックをモデルに任せる
- 複合的であいまいな質問をそのまま投げる
- 無関係な情報まで詰め込んだ過剰なコンテキスト
- 不確かさ(confidenceや分布)を無視する
- 依存関係のない質問をわざわざ直列に投げる
confidenceの使い方 — しきい値はリスクで決める
confidenceはChoice・Scoreの確率分布の「尖り具合」から計算される0〜1の統計量で、分布(probabilities)自体も返るため独自の指標を組み立てることもできる。公式の目安は、高リスクな処理を自動実行してよいのはconfidence>0.9、0.5未満は人へのエスカレーションや確認・代替手段への切り替えというものだ。別のページで示されている例では、>0.8で実行、0.4〜0.6は人のレビュー、<0.4はより高価な推論モデルへ回す、という3段の目安になっている。「リスク許容度はコード側に書く」というのが公式の立場で、しきい値はドメイン依存であり、保守的な値から始めて自分のデータで調整するよう勧められている。
| confidence | 対応の目安 |
|---|---|
| > 0.9 | 高リスクな処理も自動実行してよい(公式の目安) |
| > 0.8 | 自動実行(別ページの目安) |
| 0.6〜0.8 | 用途によって実行 or 確認 |
| 0.4〜0.6 | 人のレビューへ |
| < 0.4〜0.5 | より高価な推論モデルへ、または人へエスカレーション |
```python
# 公式クックブック「Confidence-gated routing」の要旨をコード化した例
if response.answers["intent"].confidence < 0.6:
    route_to_human(ticket)
elif intent == "balance_inquiry":
    execute_balance_inquiry()  # confidence 0.6程度でも実行してよい低リスク操作
elif intent == "transfer_approval":
    if response.answers["intent"].confidence > 0.85:
        execute_transfer()  # 高confidenceのみ自動実行
    else:
        ask_user_to_confirm()  # それ以外はユーザーに確認
```
ここでの数値はあくまで公式クックブックの一例で、業務やデータセットが変わればしきい値も変わる。confidenceだけでなくprobabilitiesの分布を見て、2位の選択肢との差が小さいケースを別扱いにするといった工夫も有効だ。
活用アイデア12選
表の # 列の記号は出どころを示す。★ は公式のクックブック・ユースケース集・デモに対応するもの、☆ は本記事の提案であり公式の実測ではない。いずれも「state に入れるもの/質問(型)/コード側の処理」の3点で具体化した。
| # | 用途 | state | 質問(型) | コード側の処理 |
|---|---|---|---|---|
| 1 ☆ | 問い合わせフォーム・メールの一次仕分け | 件名+本文+顧客区分 | Choice担当部署(sales / support / billing / recruit / other)、Noul緊急・営業メール、Score不満度3段階 | 緊急noul>0.8は即時通知、営業>0.9は自動ラベル、confidence<0.6は人へ |
| 2 ★ | LLMチャットボットの入出力ガードレール | 入力・出力テキスト | Noul(脱獄 / 違法行為支援 / 医療助言 / 自傷兆候)+Score深刻度0〜3 | pass / review / block / supportの優先順位で判定 |
| 3 ★ | RAG検索結果のフィルタ | 検索で取れた各パッセージ+クエリ | Noul4問(関連性 / 根拠採用可否 / 矛盾 / 操作の兆候) | injection>0.70除外 → contradiction>0.70はブロック → relevance<0.45除外 → evidence>0.55採用 |
| 4 ☆ | AIエージェントの実行前ゲート | 実行予定のツール呼び出し+プロジェクトのルール | Noul(本番DB書き込みか / ルール違反か / 秘密情報の外部送信か) | いずれか>0.5なら人の承認待ち |
| 5 ★ | モデルルーター | タスクの説明 | Score難易度3段階+Choiceドメイン+Noul高リスク | 簡単は小型モデル、難しいものだけ高価なモデル、高リスクは人 |
| 6 ☆ | 契約書・見積書・請求書のチェックリスト照合 | 文書全文 | Noul10〜20問(支払条件の記載 / 納期の明記 / 再委託条項 / 損害賠償の上限など) | 欠落項目の一覧を生成、金額・期日の計算はコード |
| 7 ☆ | 日報・点検記録・ヒヤリハット報告の特徴量化 | 各レコードのテキスト | Noul / Scoreの複数問 | 確率を数値特徴として既存の予測モデル(故障予兆 / 離職 / 需要)に投入 |
| 8 ★ | ECの商品登録の正規化 | 商品名・説明文 | Choiceの階層カテゴリ(ビームサーチ)+Noul禁止商品・模倣品兆候 | K=3のビームサーチで確率をたどる |
| 9 ★ | 採用・営業リードの複合スコア | 経歴書・リード情報 | 原子的なScore複数(例: python_depth / team_leadership / system_design / generalist) | 職種別の重みでコード側が合成、最終判断は人が行う |
| 10 ★ | リアルタイム制御(NPC・スマートホーム・サイネージ出し分け) | センサー値・状況説明 | Choice / Noul | 数値センサー値は「暑い / 快適 / 寒い」のような言葉のバケツにコードで変換して渡す |
| 11 ★ | CIの意味的Lint | PR説明・コミットメッセージ・ドキュメント | Noul(チーム規約に沿うか) | 決定的な構文チェックは従来ツール、意味の確認だけJev |
| 12 ☆ | 監視アラート・ログのトリアージ | アラート本文・ログ | Choice(ノイズ / 要対応 / 重大)+Noul(顧客影響あり) | confidenceが低いものだけ当番に回す、件数・時刻集計はコード |
問い合わせ仕分けは最も着手しやすい。 件名と本文、必要なら顧客区分をstateに入れ、担当部署のChoiceと緊急度・営業メール判定のNoul、不満度のScoreを1リクエストにまとめる。以下はHTTP APIのquestions部分を含むリクエスト例で、instructionsは英語、stateには日本語の問い合わせ文をそのまま入れている。
```json
{
  "state": "お世話になっております。先週注文した商品がまだ届かず、非常に困っています。至急状況を確認して折り返しご連絡ください。",
  "model": "jev-latest",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this inquiry?",
      "criteria": {
        "sales": "Pricing, new orders, upgrades",
        "support": "Order status, delivery, product issues",
        "billing": "Payments, invoicing, refunds",
        "recruit": "Job applications, recruiting",
        "other": "Anything that does not fit the above"
      }
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "Does this message express urgency requiring an immediate response?"
    },
    "is_sales_pitch": {
      "type": "noul",
      "instructions": "Is this an unsolicited sales or marketing pitch rather than a genuine customer inquiry?"
    },
    "frustration": {
      "type": "score",
      "instructions": "How frustrated does the customer sound?",
      "criteria": ["Calm", "Frustrated", "Very angry"]
    }
  }
}
```
RAGの検索結果フィルタは社内ナレッジ検索の品質と安全性を両方底上げする。 検索で取れた各パッセージに関連性・根拠として使えるか・クエリの前提と矛盾しないか・システムを操ろうとしていないか、という4問を投げ、injection>0.70は除外、contradiction>0.70は矛盾ブロックへ、relevance<0.45は除外、evidence>0.55のものだけ採用、という順でコードが処理する。公式の検証では72パッセージ中、類似度で1位(0.584)だった注入パッセージをinjection 0.99で捕捉できたとされる。しきい値はコーパス依存なので、自分のデータで調整が要る。
AIエージェントの実行前ゲートは、書き込み系の操作を持つエージェントほど効いてくる。 これから実行するツール呼び出し(コマンドや差分)とプロジェクトのルールをstateに入れ、「本番DBに書き込むか」「ルールに違反するか」「秘密情報を外部送信するか」をNoulで問う。いずれかが0.5を超えたら人の承認待ちにする、という設計は本記事の提案だが、コーディングエージェントの書き込みをルール文書と照合するnpmパッケージも既に登場しており、同種の発想がエコシステム側でも動き始めている。
契約書・見積書・請求書のチェックリスト照合は、まとめて聞くほど安くなるという特性と相性が良い。 1文書に対して支払条件の記載・納期の明記・再委託条項・損害賠償の上限など10〜20問のNoulを1リクエストで投げ、falseだった項目をコードで一覧化する。金額や期日の計算そのものはJevにやらせず、抽出した値をコードで計算・検証する。
コスト試算 — まとめて聞くほど安い
料金は入力$0.042/100万トークン、出力は無料だ。トークン数×$0.042/100万で概算できる。
| ケース | 計算 | 概算 |
|---|---|---|
| 問い合わせ1,000件/月 | 1,000件×500トークン=50万トークン | 約$0.021/月 |
| ログ10万件 | 10万件×300トークン=3,000万トークン | 約$1.26 |
| 契約書1通(20問をまとめて質問) | 8,000トークン | 約$0.0003 |
| 契約書1通(20問を分けて質問) | まとめる場合の約20倍 | 約$0.006程度 |
| リアルタイム制御(毎秒10クエリ) | 公式Doomデモの実測値 | 約$7/時 |
質問をまとめることそのものにも効果がある。公式の実測では、GDPRのWikipedia記事(約54,000文字)に13問を投げる際、1回のリクエストにまとめると$0.000497・0.27秒だったのに対し、13回に分けて投げると$0.006090・2.71秒かかった。まとめたほうが12.2倍安く10.0倍速いという結果で、答えも変わらず分散も増えなかった。stateを1回しか送らずに済むことが理由で、これは前述の「Speculative fan-out」(関係しそうな質問を1回に全部投げ、使うかどうかはコードが決める)というパターンの裏付けでもある。
向かないこと — 公式が認める10の弱点
| 弱点 | 対処 |
|---|---|
| 1. 字義どおりに読む(否定・限定・暗黙の条件を読み落とす) | 条件をinstructionsに正確に書き、境界例をcriteriaに入れる |
| 2. 計算・カウントができない(対象が大きいほど誤差増) | 計算はコードで行う |
| 3. 数値表現(RGB/hex等)の近さを判断できない | コードで名前付きのバケツに変換してから渡す |
| 4. 日付・時刻の前後比較が不安定 | 抽出はモデル、演算・比較はコード |
| 5. 二重否定・多段の間接参照に弱い | 直接的に書き、参照するstateを名指しする |
| 6. 無関係な情報が多いstateで精度低下 | コードで絞り込んでから渡す |
| 7. 敵対的な文面で答えが動く | criteriaを明示し、投入前にテストする |
| 8. instructionsとcriteriaが食い違うと混乱する | 両者の内容を一貫させる |
| 9. 構造的不変性がない(否定形の質問と足して1にならない等) | 質問間の算術恒等式やしきい値の使い回しに頼らない |
| 10. テキスト生成そのものはできない | 抽出は有限の選択肢に落とし込む |
The Registerはこの種のモデルについて、「幻覚しない」というのは出力が自然言語でないというだけで、確率つきの判断が間違うことはある、と指摘している。ベンチマークもTypeSafe自身が作成したものであることは踏まえておく必要がある。
日本語で使うときの現実解
TypeSafe AIは、Jevの対応言語は英語が主で、CJK(日本語を含む)も受け付けるが現時点では精度が低いと公式ドキュメントで明記している。ファインチューニングという逃げ道もないため、日本語の業務で使うなら次のような工夫が現実的だろう(以下は本記事の提案であり効果は未検証で、自前の評価が前提になる)。
- (a) instructions・criteriaは英語で書き、stateだけ日本語のまま渡す
- (b) 自分のデータ100〜200件で正解率とconfidenceの関係を測ってからしきい値を決める
- (c) confidenceが低いケースはLLMか人へエスカレーションする
- (d) 必要ならstateを機械翻訳してから渡す案も比較する
どの案も効果を検証したものではなく、精度と運用コストのトレードオフは自分のデータで測るしかない。
よくある質問
LLMの構造化出力(JSON mode等)と何が違う?
LLMの構造化出力はテキスト生成の結果をJSON形式に整形する仕組みで、依然として1トークンずつ生成する。Jevは文章を生成せず、質問ごとに型付きの答えと確率分布を1回の並列パスで返す設計で、公式によれば70〜500msという応答速度とフロンティアLLM比40〜200倍という速さの根拠になっている(自社評価)。
APIキーはどう取る?
現在は早期アクセスのウェイトリスト制で、https://console.typesafe.ai/keys からAPIキーを取得する。
日本語は使える?
CJK(日本語含む)は入力として受け付けるが、公式ドキュメントは現時点では精度が低いと明記している。詳しくは前段の「日本語で使うときの現実解」を参照。
選択肢が多いときはどうする?
Choiceの選択肢が多い階層分類のようなケースでは、公式ブログは確率に対するビームサーチ(K=3など)で並列にたどる手法を紹介しており、特許分類(約27,000ノード)のような例でも使われている。
confidenceはいくつに設定すべき?
固定の正解はない。公式の目安は高リスク処理の自動実行で>0.9、0.5未満は人へというものだが、別ページでは>0.8実行/0.4〜0.6レビュー/<0.4エスカレーションという3段も示されている。保守的な値から始め、自分のデータで検証しながら調整するのが公式の推奨だ。
Cloudflareで使える?
Cloudflare Workers AIのモデルカタログにtypesafe/jevとして掲載されており、env.AI.run('typesafe/jev', {...})の形でWorkersから直接呼び出せる。コンテキストはjev-1.13.0で32,000トークンとされている。
まとめ
Jevの実践は、質問を原子的に分解し、1リクエストにまとめ、confidenceでコード側が分岐する、という3つの型を繰り返すことに尽きる。テキスト生成をさせない代わりに、決定的なロジックと副作用はすべてコードに残す、という設計原則さえ守れば、問い合わせ仕分けからRAGフィルタ、エージェントの実行前ゲートまで同じ発想で応用できる。
CloudflareのWorkers AIから呼び出す構成はCloudflareスタックでWeb開発で触れたスタックとも相性がよく、社内ナレッジ検索のRAGパイプラインに組み込む場合はOpenClawで社内ナレッジ検索を構築で作った検索結果にフィルタとして足すところから始めるとよい。早期アクセス段階のモデルである以上、本番導入前には自分のデータでconfidenceのしきい値を検証する工程を必ず挟みたい。
参考リンク(一次ソース)
- https://docs.typesafe.ai/introduction
- https://docs.typesafe.ai/primitives
- https://docs.typesafe.ai/confidence
- https://docs.typesafe.ai/patterns
- https://docs.typesafe.ai/model-jaggedness/jev-1.13
- https://docs.typesafe.ai/models
- https://typesafe.ai/blog/introducing-system-one-models-and-jev
- https://developers.cloudflare.com/ai/models/typesafe/jev/
- The Register: https://www.theregister.com/ai-and-ml/2026/09/16/typesafe-ai-debuts-model-for-machines-that-plays-doom/5296711
お気軽にご相談ください
お問い合わせ