TypeSafe Jevとは — LLMの100倍速い「System One」判断モデル最速解説
TypeSafe AIが2026年9月15日に発表した「Jev」は、文章ではなく型付きの選択肢と確率を出力する新カテゴリ「System One Model」。応答150ms・入力$0.042/Mトークン・出力無料。HNで1,500pt超・早期アクセス中。LLMとの違い・料金試算・使い方パターンを最速で整理する。
TypeSafe AIは2026年9月15日、「Jev」を発表した。同社が「System One Model」と呼ぶ新カテゴリの第一弾で、ソフトウェアが直接呼び出す高速・構造化判断に特化したモデルである。発表はHacker Newsで1,500ポイント超を集め、早期アクセスのウェイトリストが公開された。約2年間のステルス期間を経ての公開で、報道によるとDCVC主導のシード資金4,000万ドルを調達しているという。本記事ではJevの仕組み・料金・使い方を最速で整理する。
Jevとは何か
Jevは自由形式の文章を生成するLLMではない。あらかじめ定義したスキーマに沿った「型付きの値」を出力する点が最大の特徴だ。出力は事前に定義した選択肢の中から選ばれ、それぞれに較正された確率(calibrated probability)と信頼度スコアが付与される。スキーマの外側の値を返すことは構造上あり得ないため、TypeSafe AIは「型エラーは数学的に不可能」と説明している。ただし、これはあくまで選択肢の中で正しい判断ができるという意味ではなく、Jevの判断自体が間違っている可能性は残る点に注意したい。あくまで確率的な判断モデルであり、「ハルシネーション(スキーマ外の出力)」が起きないことと「判断が常に正しい」ことは別問題である。
内部的には、トークンを1つずつ生成する自己回帰型のLLMとは異なり、全ての出力候補を単一パスで並列に生成する「パラレルサンプラー」という方式を採用している。学習方法もLLM標準のRLHF(人間フィードバックによる強化学習)やRLVR(検証可能な報酬による強化学習)ではなく、TypeSafe AI独自の「RLCD(Reinforcement Learning for Calibrated Decisions、較正済み判断のための強化学習)」を用いる。この学習方式により、出力される確率がモデルの実際の正解率とよく一致する(=較正されている)ことを重視した設計になっているという。
何ができるか
- ワークフロー中の「賢いif文」— 条件分岐をハードコードせず、状態を渡して型付きの判断を得る
- 大量データに対するmap-reduce型の分類 — サポートチケットやログを一件ずつ高速に仕分け
- リアルタイムアプリケーションでの意思決定 — 数百ms以内の応答が要求される場面
- LLM出力の検証・ガードレール・ジェイルブレイク検知 — LLMが生成した内容を型付き判断でチェック
- デモ: Doom内のボット操作(毎秒10クエリ、稼働コスト約7ドル/時間)、Wikipediaのリンクだけを辿るWikiracing
共通するのは「自由文の生成」ではなく「決められた選択肢からの高速な判断」が必要な場面である。これはチャットボットのような対話用途ではなく、ソフトウェアのロジックの一部として組み込むことを想定した設計だ。例えばDoom内のボット操作デモでは、ゲーム内の状況(敵の位置、体力、弾薬など)を状態として渡し、「前進」「攻撃」「回避」といった限られた行動の中からJevが毎秒10回のペースで判断を返す。稼働コストは約7ドル/時間とされ、LLMベースのエージェントでは実現しづらいレイテンシとコストの水準だとTypeSafe AIは主張している。
LLMとの違い
「構造化出力」や「JSON mode」を備えたLLMと何が違うのか、という疑問は自然だろう。大きな違いは、LLMの構造化出力があくまで自由形式の生成プロセスの後段にJSONへの整形ルールを課しているのに対し、Jevは生成プロセスそのものが型付きの選択肢空間に限定されている点にある。従来の分類器(classic MLモデル)とも異なり、Jevは自然言語で書かれた未整形の状態(テキストの塊やイベントログなど)をそのまま入力として受け取れる柔軟性を持つ。3方式の違いを整理すると次のようになる。
| 項目 | Jev(System One Model) | LLMの構造化出力/JSON mode | 従来型MLの分類器 |
|---|---|---|---|
| 出力の性質 | 定義済み選択肢から型付きの値 | 自由生成後にJSON整形(逸脱の可能性あり) | 学習時に固定したクラスラベル |
| 入力の柔軟性 | 未整形の自然言語状態をそのまま受け取れる | 未整形の自然言語状態をそのまま受け取れる | 通常は特徴量エンジニアリングが必要 |
| 較正された確信度 | 標準搭載(確率+信頼度スコア) | モデル依存、通常は非公式 | モデルにより異なる |
| レイテンシ | 70〜500ms(目安150ms) | 数秒〜数分 | ミリ秒〜数十ms級が多い |
| 生成方式 | 全候補を1パスで並列生成 | トークンを逐次生成(自己回帰) | 通常は単一のフォワードパス |
| スキーマ外出力 | 構造上発生しない | プロンプト遵守に依存し逸脱し得る | 発生しない(学習済みクラスの範囲内) |
料金とコスト試算
Jevの料金は入力1Mトークンあたり0.042ドル(10億トークンあたり42ドル)で、出力は無料と発表されている。LLMの多くが入出力の両方に課金するのに対し、判断結果(選択肢+確率)のみを返すJevの用途特性上、出力トークン量自体がごく小さいため無料化しやすいという設計思想が読み取れる。
| 項目 | 料金 |
|---|---|
| 入力 | $0.042 / 1Mトークン($42 / 10億トークン) |
| 出力 | 無料 |
| 選択肢の上限 | 1判断あたり最大255個(超える場合は2段階スコアリング) |
| 画像入力 | 現時点では非対応 |
| コンテキスト長・言語・パラメータ数 | 非公開 |
具体例として、サポートチケット100万件を1件あたり約500トークンとして分類する場合を試算する。総入力トークン数は100万件×500トークン=5億トークン。単価は1Mトークンあたり0.042ドルなので、5億トークン÷100万×0.042ドル=約21ドルとなる(出力は無料のため加算不要)。同じ100万件をLLMで処理する場合、入出力両方に課金される上、1件あたりの処理時間も数秒〜数十秒単位になりやすく、コストとレイテンシの両面でJevとの差が開きやすい計算になる。TypeSafe AI自身が公開したワークフロー評価では、Jevは比較対象のLLMベースの処理に対して193.6倍高速、444.6倍安価だったと報告されている。ただしこの評価はTypeSafe AI自身のチームが設計したものであり、参照回答としてGPT-6 AstraとFable 5.1の出力平均を用いている点は留意が必要だ。第三者による独立検証ではない点を踏まえ、あくまで参考値として受け止めるのが妥当だろう。
使い方(概念パターン)
具体的なSDKやAPI名はまだ広く固まっていないため、ここでは概念的な利用パターンとして整理する(以下は概念的な擬似コードであり、実在のAPI仕様を示すものではない)。
- ステップ1: 判断させたい選択肢(choice)の集合をスキーマとして定義する(例: 「緊急」「通常」「スパム」など)
- ステップ2: 未整形のテキストやイベントログなど、状態(state)をそのままJevに渡す
- ステップ3: Jevは定義済みスキーマの中から型付きの選択肢と、確率分布・信頼度スコアを返す
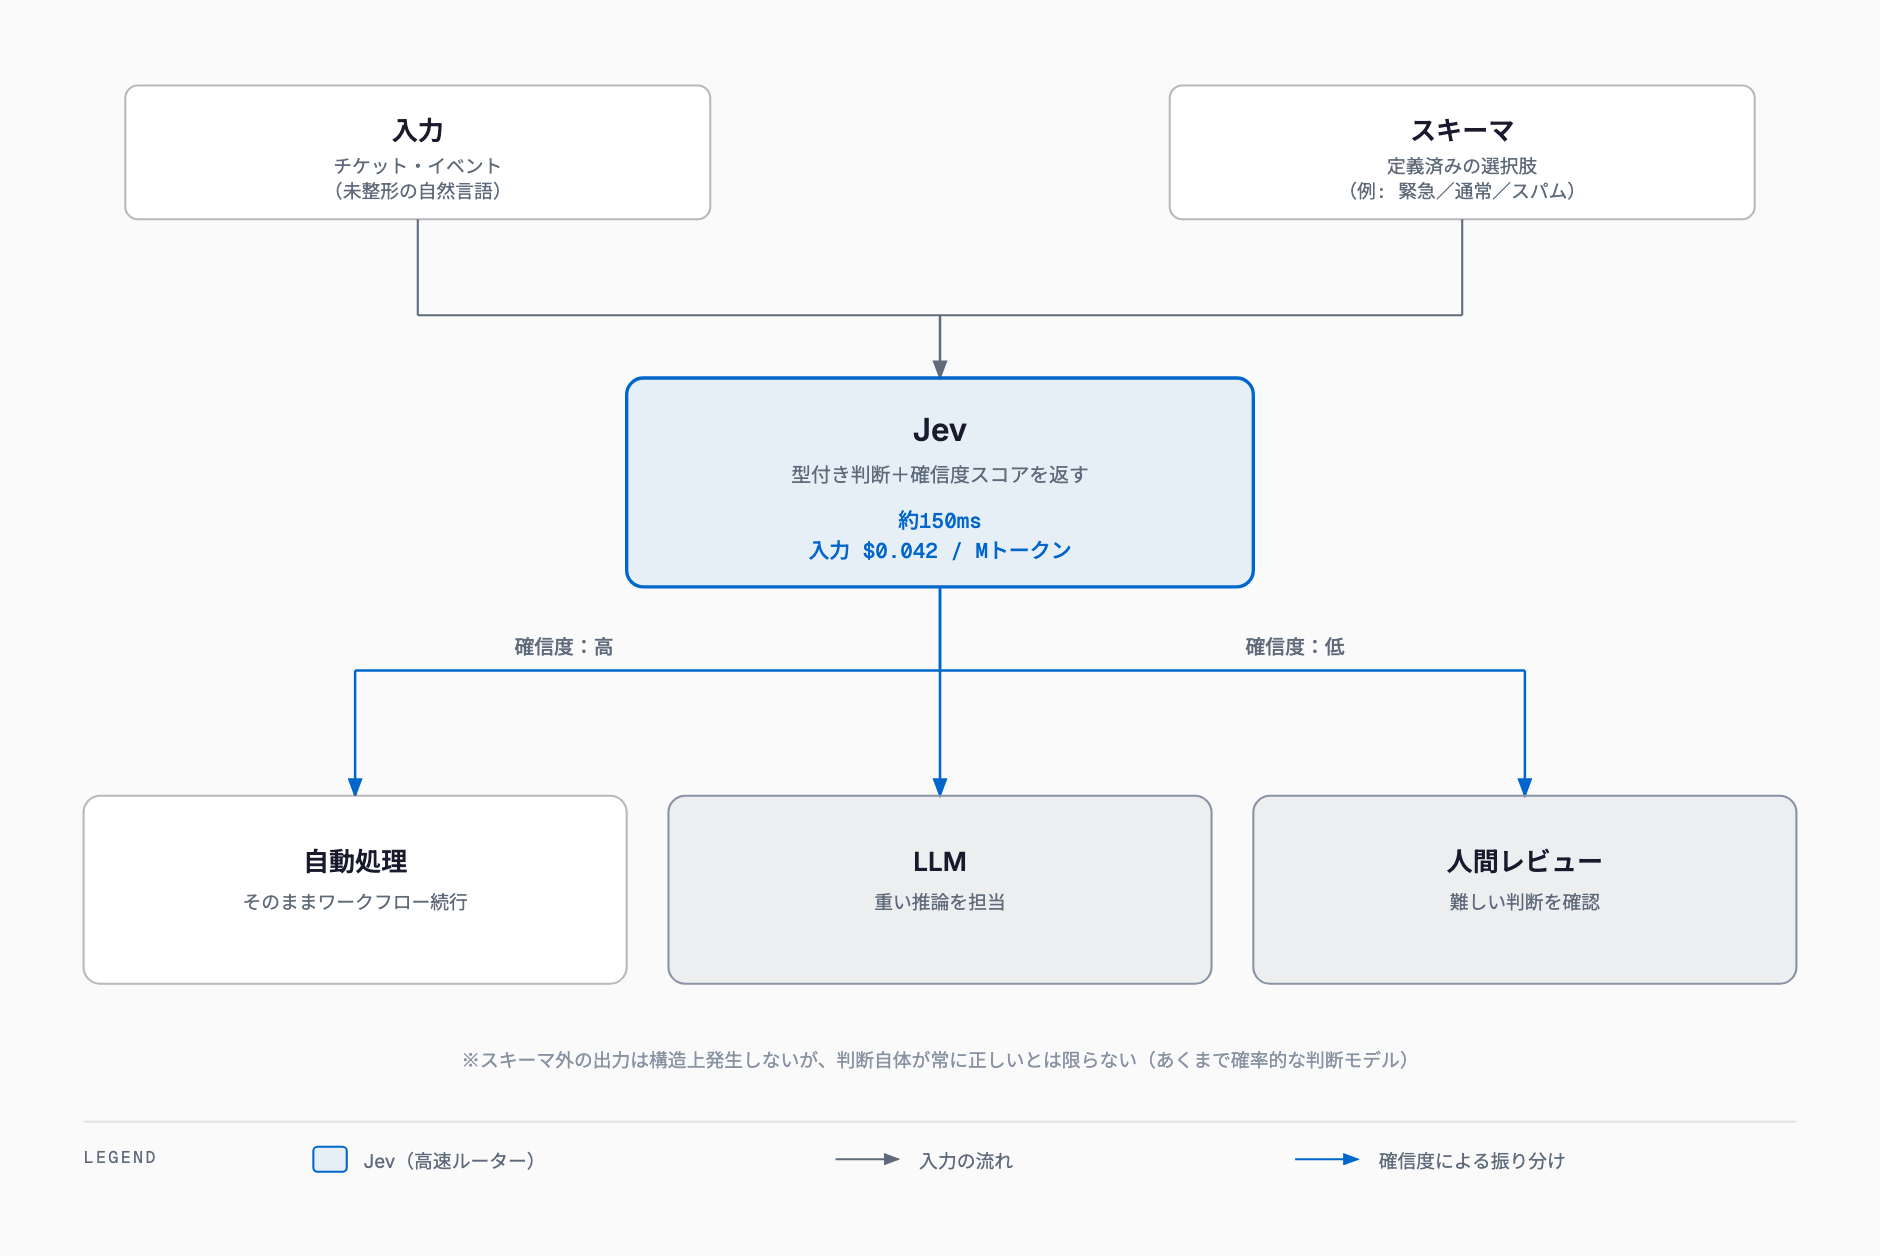
- ステップ4: 信頼度が閾値を下回る場合は、その案件だけをLLMや人間のレビューに回す(ルーティング)
- ステップ5: 信頼度が高い大多数の案件は、そのままワークフローの分岐条件として処理を継続する
アーキテクチャパターン: 高速ルーターとしてのJev
実運用で語られやすい構成は、Jevを「高速な一次ルーター」、LLMを「重い推論を担当する二次処理」として組み合わせるパターンだ。大量に流れてくるイベントやリクエストをまずJevで型付き判断にかけ、確信度が高いものは即座に処理を確定する。確信度が低い、あるいはそもそもJevのスキーマでは表現しきれない複雑な判断だけを、より高コスト・低速だが柔軟なLLMや人間のレビューに委ねる。この「ラフな振り分けは高速・低コストなモデルで、難しい判断だけ重いモデルへ」という設計は、LLM出力自体の検証(ガードレールやジェイルブレイク検知)にJevを使う場合にも同様に当てはまる。LLMが生成した回答をそのままユーザーに返す前に、Jevで「安全」「要注意」「ブロック」のような型付き判断を挟むことで、LLM単体では検知しづらい逸脱をレイテンシへの影響を抑えつつチェックできるという発想である。この種の構成は、判断ロジックをアプリケーションコードに直書きする従来のif-else分岐と比べて、条件の追加や調整をモデルの再学習・プロンプト調整側に寄せられる点も利点として語られる。
導入を検討する際は、まず既存のワークフローの中で「if文で条件分岐しているが、その条件判定自体があいまいで人手やLLMに頼っている箇所」を洗い出すのが実務的な出発点になるだろう。そうした箇所は選択肢が有限で、かつ入力が未整形の自然言語であることが多く、Jevの想定用途と重なりやすい。
留意点
- 現時点では早期アクセスのウェイトリスト制であり、一般提供時期は未定
- 高速化・低コスト化を示すベンチマークはTypeSafe AI自身が作成したものであり、第三者による独立検証はまだない
- コンテキスト長・対応言語・パラメータ数などの詳細仕様は非公開
- 画像入力は現時点で非対応
- 日本語入力での判断精度は公式に確認されておらず、実務投入前に自前の評価が必要
よくある質問
JevはLLMを置き換えるものですか。
いいえ。TypeSafe AI自身も、自由文の生成や複雑な多段階の推論はLLMの領域として位置づけており、Jevは型付きの高速判断に特化した補完的な存在です。実運用ではJevを高速ルーター、LLMを重い推論の担当として組み合わせる構成が想定されています。
料金体系はどうなっていますか。
入力は1Mトークンあたり0.042ドル、出力は無料です。判断結果(選択肢+確率)のみを返す性質上、出力トークンが小さく済むためこの体系になっていると考えられます。
日本語でも使えますか。
対応言語は公式に公開されていません。日本語での判断精度は本記事執筆時点で未検証のため、実務利用前に自前でのテストが推奨されます。
どんな用途に向いていますか。
ワークフロー内の条件分岐、大量データの分類、リアルタイムアプリの意思決定、LLM出力の検証・ガードレールなど、あらかじめ定義した選択肢からの高速判断が必要な場面に向いています。チャット対話のような自由形式のやり取りには向きません。
選択肢の数に制限はありますか。
1つの判断につき最大255個の選択肢まで対応します。それを超える場合は2段階のスコアリング方式が用いられます。
まとめ
Jevは「文章を書くAI」ではなく「型付きの判断を高速に返すAI」という新しいカテゴリを提示するモデルである。ミリ秒級のレイテンシと安価な入力課金、無料の出力という組み合わせは、ワークフロー内の条件分岐や大量データの分類、LLM出力の検証といった用途で既存の選択肢を補完し得る。一方で、公表ベンチマークはベンダー自身によるものであり、コンテキスト長や対応言語などの仕様も非公開の部分が多い。早期アクセス段階の技術であることを踏まえ、自社のユースケースでの精度・コストを実際に検証した上での採用判断が望ましい。
お気軽にご相談ください
お問い合わせ