Google AI Edge Gallery Mac版でGemma 4 12Bを動かす
必要スペック・インストール・実測速度【16GB Mac対応】
Google AI Edge GalleryのMac版なら16GBメモリのApple Silicon MacでGemma 4 12B(約6.9GB)を完全オフラインで実行できる。必要スペックの見極め方やインストール手順、実測速度(MacBook Air M4で15 tok/s)まで解説する。2026年9月更新。
結論から言えば、Google AI Edge GalleryのMac版を導入すれば、16GBメモリのApple Silicon MacでGemma 4 12B(モデルサイズ約6.9GB)をインターネット接続なしで完全にローカル実行できる。Googleの公式ベンチマークでは、MacBook Air M4 16GB構成でdecode速度15 tok/s、初回応答までのTTFTは約9.13秒という実測値が公表されている。
配布DMGは2026年6月3日公開のv0.1.0からアップデートを重ね、2026年9月16日にv0.3.0へ更新された(ファイルサイズは約42MBから約51MBへ増加)。モデル自体の技術的な特徴はGemma 4 12B 徹底解説で詳しく解説しているので、まずはMac版アプリの動かし方から見ていく。
必要スペック早見表 — Gemma 4 12B を Mac で動かす条件
Gemma 4シリーズ全体のハードウェア要件はGemma 4 必要スペック早見表にまとめてあるが、ここではMac版Gallery×Gemma 4 12Bに絞って条件を整理する。
| 項目 | 内容 |
|---|---|
| メモリ | 16GB以上(Googleは「16GBの一般的なノートPCで動く」と説明。AppleInsiderは8GB構成のMacBookは対象外と指摘) |
| ストレージ | モデル約6.9GB(gemma-4-12B-it.litertlm)+アプリ約51MB |
| チップ | Apple Silicon(公式ベンチマークはすべてApple Silicon機。Intel Mac対応可否は公式に明記なし) |
| macOSバージョン | 公式に明記なし |
| ネット接続 | モデルの初回ダウンロード時のみ必要。取得後は完全オフラインで動作 |
| 費用 | 無料(Gemma 4はApache 2.0ライセンス) |
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。Gemma 4 12Bもモデル一覧から選択できる。
Google AI Edge Gallery とは — Mac 版の位置づけ
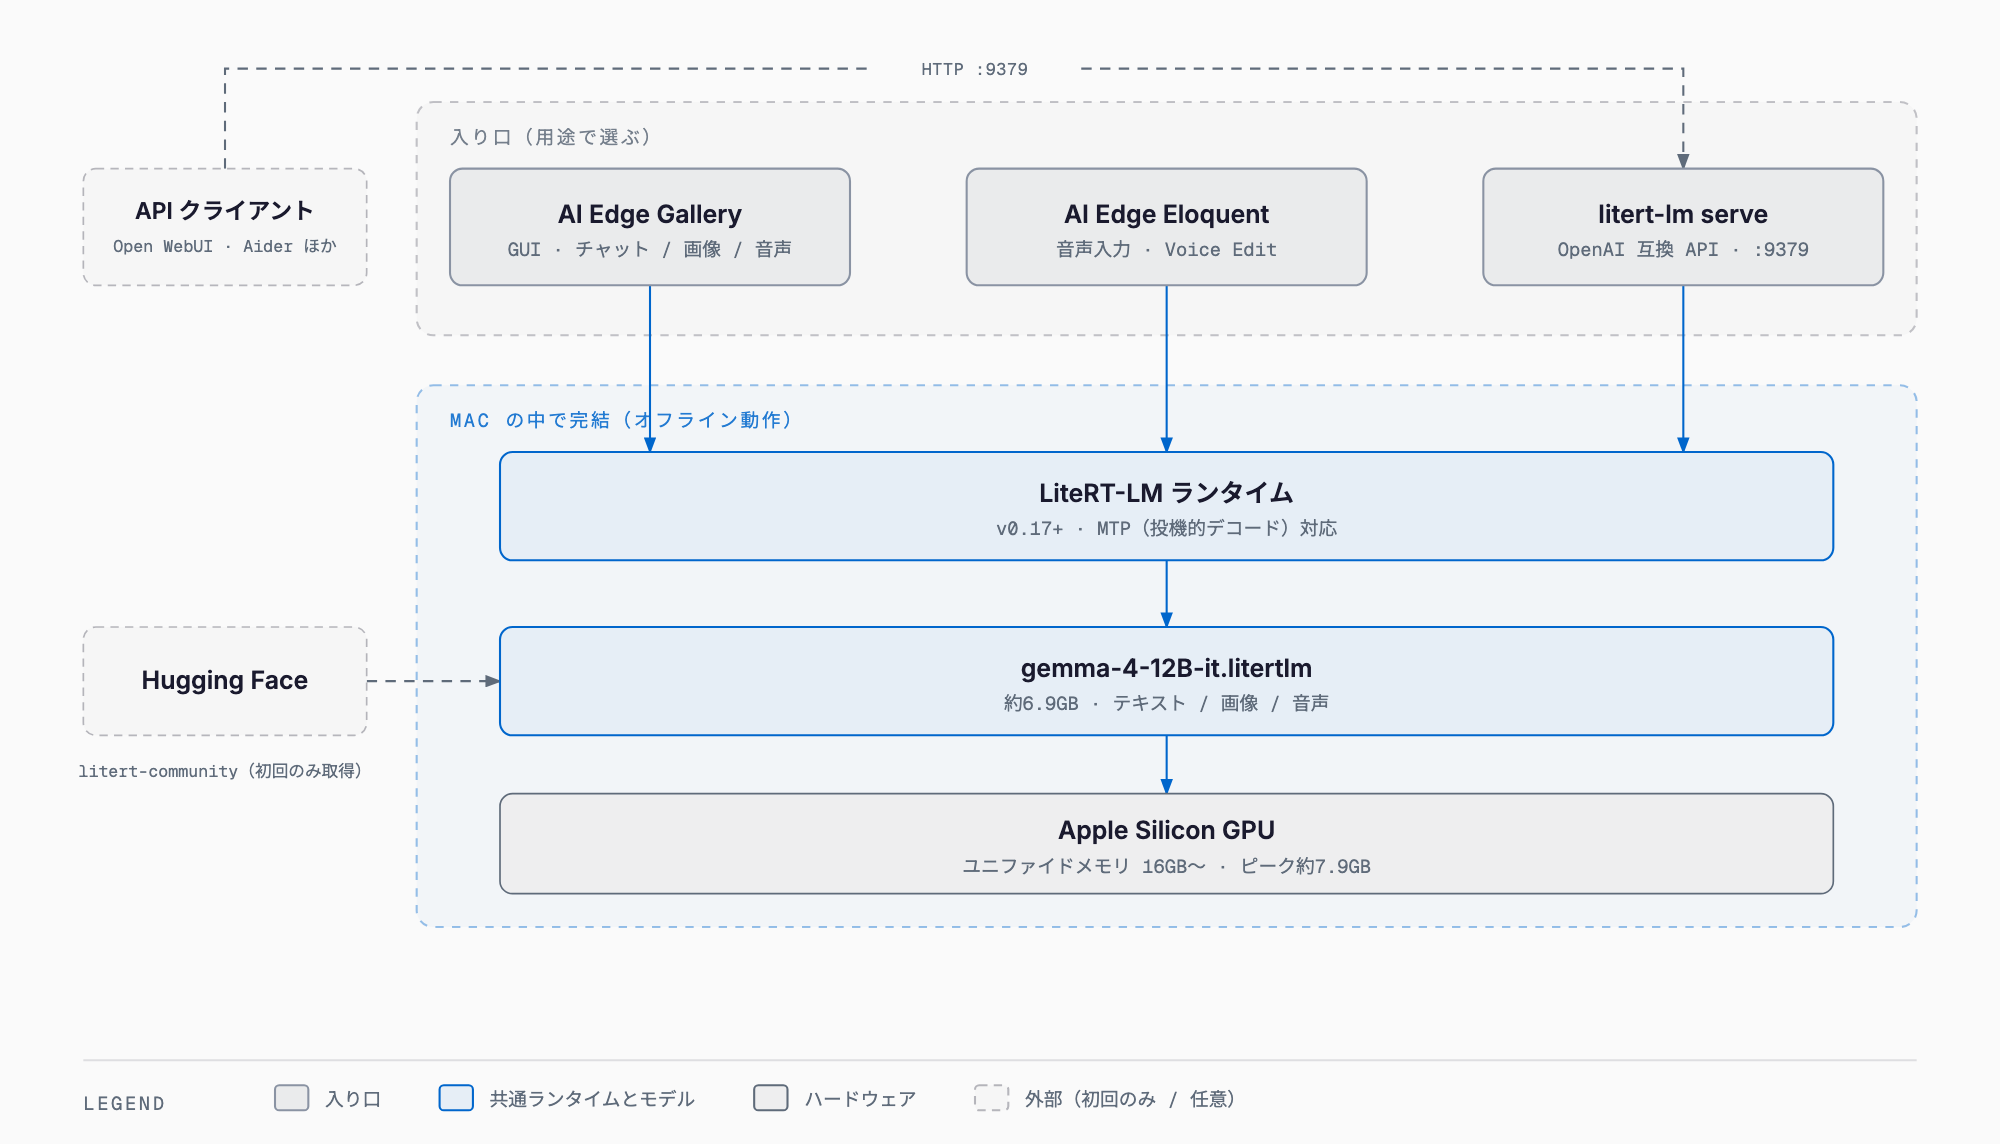
Google AI Edge Galleryは、Googleが公開している「オンデバイスでオープンモデルを動かす」ためのショーケースアプリで、公式ページのキャッチコピーは"Discover private, offline models on device"だ。公式は「すべての推論は端末のハードウェア上で直接実行される」と説明しており、推論はモデルダウンロード後は外部サーバーに一切依存しない。Mac版アプリ本体、音声入力アプリのAI Edge Eloquent、そして開発者向けのlitert-lm serveコマンドという3つの入り口は、いずれも共通のランタイムであるLiteRT-LMと、Apple SiliconのGPU上で動作する点で同じ基盤を共有している。
| OS | 配布方法 | 条件 |
|---|---|---|
| Android | Google Play | Android 12以上 |
| iOS | App Store | iOS 17以上 |
| macOS | 公式ページからDMGを直接ダウンロード(Mac App Store配布ではない) | 明記なし |
| バージョン | 公開日 | 概要 | ファイルサイズ |
|---|---|---|---|
| v0.1.0 | 2026年6月3日 | Mac版Gallery初公開。同時にAI Edge Eloquent(macOS版)とlitert-lm serveコマンドも公開 | 約42MB |
| v0.2.0 | 2026年8月20日 | 配布サーバー上の更新を確認 | 約45MB |
| v0.3.0 | 2026年9月16日 | 現行版。リリースノートは公式に公開されておらず変更点は不明 | 約51MB |
インストール手順 — DMG から Gemma 4 12B の初回ダウンロードまで
1. 公式ページ(developers.google.com/edge/gallery)を開き、Download for macOSからDMGを取得する
2. ダウンロードしたDMGを開き、アプリをApplicationsフォルダへドラッグする
3. アプリを起動し、モデル一覧からGemma-4-12B-itを選んでダウンロードする(約6.9GB、Wi-Fi推奨)
4. AI Chat機能を開き、実際にプロンプトを入力して応答を試す
5. Wi-Fiを切ってオフライン状態でもチャットが動くことを確認する
インストール画面のUI詳細はバージョンによって変わる可能性がある。Gallery macOS版はMac App Store配布ではなく公式ページからの直接配布のため、必ず上記の公式リンクから入手すること。
実測速度 — M4 Air 16GB で 15 tok/s、M4 Pro で 29 tok/s
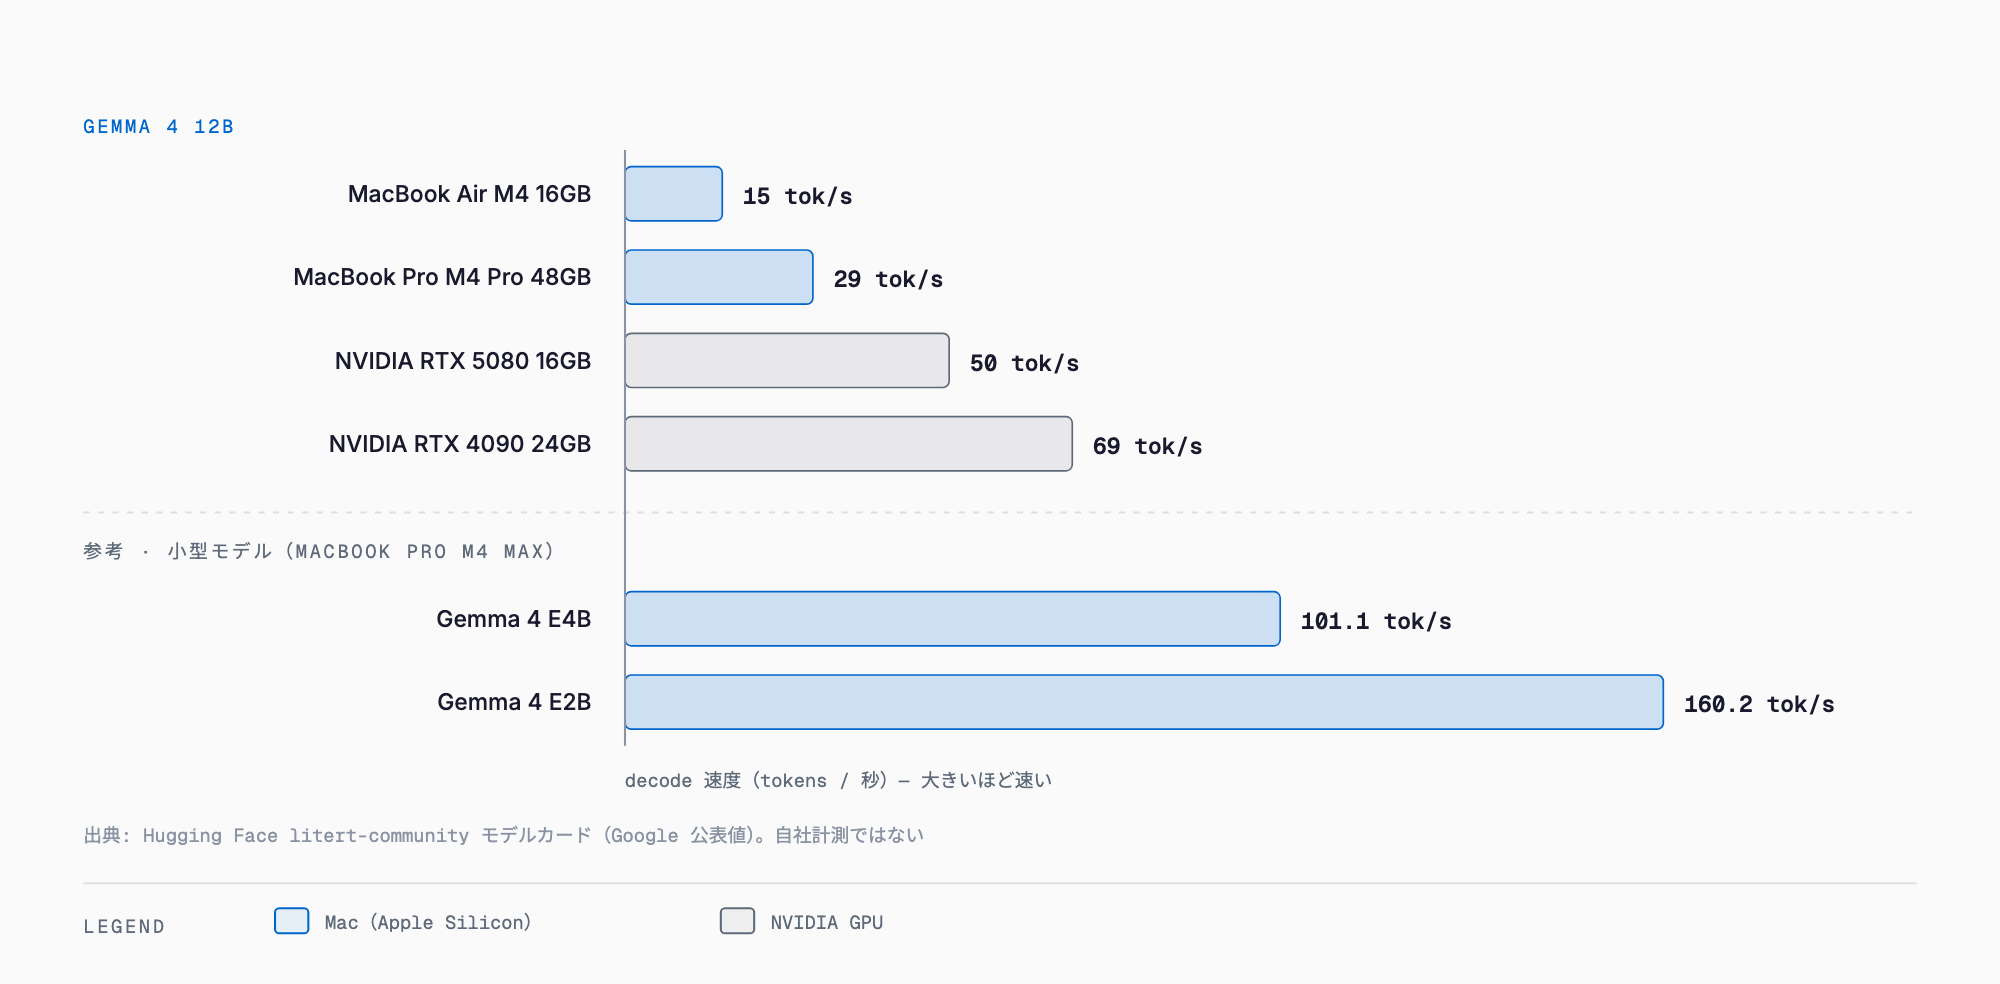
以下はHugging FaceのGemma 4 12Bモデルカードに掲載されている公式ベンチマークで、GPUバックエンドでの計測値だ。decode速度(1秒あたりの生成トークン数)を見ると、MacBook Air M4 16GBは15 tok/s、MacBook Pro M4 Pro 48GBは29 tok/sと、メモリ・チップ帯が上がるほぼ倍近い差が出ている。
| デバイス | Prefill (tok/s) | Decode (tok/s) | TTFT (秒) | ピークGPUメモリ |
|---|---|---|---|---|
| MacBook Air M4 16GB | 114 | 15 | 9.13 | 約7,900MB |
| MacBook Pro M4 Pro 48GB | 297 | 29 | 3.48 | 約7,870MB |
| NVIDIA RTX 5080 16GB | 391 | 50 | 2.5 | 約7,300MB |
| NVIDIA RTX 4090 24GB | 3,548 | 69 | 0.3 | 約7,790MB |
16GBのMacBook Airでも12Bは動くが、decodeは15 tok/s、初回応答まで約9秒とやや待たされる上、ピークGPUメモリは約7.9GBに達するため16GB機では他アプリとの同時利用に注意したい。参考までにMacBook Pro M4 Max(GPU)でのE4Bはprefill 2,560/decode 101.1 tok/s/TTFT 0.4秒/ピーク3,217MB、E2Bはprefill 7,835/decode 160.2 tok/s/TTFT 0.1秒/ピーク1,623MBと大幅に高速だ。速度を優先するなら小型モデルを選ぶとよく、E4Bの詳細はGemma 4 E4B完全ガイドにまとめている。なお、これらの数値はすべてGoogle公表のベンチマークであり、当方による実機計測ではない。
Mac 版でできること — Python 実行・画像・音声・Agent Skills
Googleの公式ブログでは、自然言語で分析したい内容を伝えるだけで、モデルがPythonコードを生成しローカルで実行する例が紹介されている。たとえば「2024年と2025年で人気だった名前トップ10を比較するグラフを作って」と伝えると、必要な依存関係の指定からコード生成、グラフPNGの出力、さらにエラーが出た場合の自己修正までを1ターンでこなす、としている。
| 機能 | 内容 |
|---|---|
| AI Chat | Thinking Modeで推論過程を表示しながら対話できる |
| Ask Image | 画像について質問できる |
| Audio Scribe | 音声の文字起こし・翻訳 |
| Prompt Lab | プロンプトの実験・比較 |
| Agent Skills | Wikipedia検索や地図表示などの拡張機能。コミュニティ共有も可能 |
| モデル管理・ベンチマーク | モデルのダウンロード管理と性能計測 |
なお、Mobile ActionsやTiny Garden(FunctionGemma 270m使用)はモバイル向け機能であり、上記の各機能がMac版ですべて同等に使えるかどうかは公式に明記なしのため、実際に試して確認するのが確実だ。
開発者向け — litert-lm serve で OpenAI 互換 API を立てる
Gallery macOS版と同時にGoogleが公開したLiteRT-LM CLIを使うと、コマンドラインからGemma 4 12Bを実行したり、OpenAI互換のローカルAPIサーバーを立てたりできる。
```bash
pip install -U litert-lm

# 単発実行
litert-lm run --from-huggingface-repo=litert-community/gemma-4-12B-it-litert-lm --prompt="Write me a poem"
```
```bash
# モデルを取り込んでサーバー名を付ける
litert-lm import --from-huggingface-repo=litert-community/gemma-4-12B-it-litert-lm gemma-4-12B-it.litertlm gemma4-12b
# OpenAI互換サーバーを起動
litert-lm serve
```serveコマンドはポート9379、パス/v1/chat/completionsでOpenAI互換のエンドポイントを立てる。公式ブログでは互換ツールとしてOpen WebUI、Continue、Aider、OpenClaw、Hermes、OpenCode、Piが挙げられている。
```bash
# 一般的なOpenAI互換の呼び出し形式の例
curl http://localhost:9379/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"gemma4-12b","messages":[{"role":"user","content":"Hello"}]}'
```
AI Edge Eloquent — 声で書く・声で直す
AI Edge Eloquentは、端末内で動く音声入力・編集アプリだ。カスタマイズ可能なホットキーでどのアプリにも口述入力でき、口述したテキストの推敲、音声・動画ファイルのローカル文字起こし、カスタム単語の登録に対応する。新機能のVoice EditはGemma 4 12Bを使って声でテキストを編集する機能で、Googleによれば全体的な品質が60%以上向上したという。発表時点では英語のみの対応とされている。
Ollama・LM Studio との違い
ローカルLLMツールとしてはOllamaやLM Studioも広く使われている。それぞれの詳しい比較はOllama vs LM Studio 徹底比較に譲るとして、ここではAI Edge Galleryとの位置づけの違いを簡単に整理する。
| 項目 | AI Edge Gallery | Ollama | LM Studio |
|---|---|---|---|
| 選べるモデル | Google製モデルのみ(Gemma 4/3n系) | 多数のオープンモデル | 多数のオープンモデル |
| 形式 | .litertlm | GGUF等 | GGUF等 |
| GUI | あり(モバイル/Mac共通デザイン) | 基本CLI(別GUIツールと併用) | あり |
| APIサーバー | litert-lm serve(OpenAI互換) | あり(OpenAI互換) | あり(OpenAI互換) |
| マルチモーダル | テキスト・画像・音声(モデル依存) | モデルによる | モデルによる |
| 向く人 | Google製モデルをMac/モバイルで手軽に試したい人 | 多様なモデルをCLI中心で管理したい人 | GUIで多様なモデルを試したい人 |
よくある質問
8GBのMacでも動く?
12Bモデルの実行は現実的ではない。AppleInsiderは8GB構成のMacBookは対象外と指摘しており、16GB未満の場合はE2B・E4Bなど小型モデルの利用を検討したい。
Intel Macでも使える?
公式ページ・ブログともにIntel Mac対応の可否は明記されていない。公式ベンチマークはすべてApple Silicon機で計測されている。
完全にオフラインで使える?
モデルの初回ダウンロードにはネット接続が必要だが、ダウンロード後は完全にオフラインで推論できる(公式: すべての推論は端末上で実行)。
料金はかかる?
アプリ・モデルともに無料。Gemma 4はApache 2.0ライセンスで提供されている。
Windows版はある?
2026年9月時点でGalleryアプリの公式配布はAndroid・iOS・macOSのみ。ただしLiteRT-LMのベンチマークにはNVIDIA GPU(RTX 5080/4090)が含まれており、CLI自体はWindows等でも動く可能性がある。
日本語には対応している?
Gemma 4自体は多言語モデルだが、GalleryアプリのUIやAI Edge Eloquentの日本語対応は公式に明記なし。Eloquentは発表時点で英語のみとされている。
まとめ
Google AI Edge GalleryのMac版は、DMGを公式ページから直接ダウンロードするだけで、16GBメモリのApple Silicon MacにGemma 4 12Bを完全オフラインで導入できる。公式ベンチマークではMacBook Air M4で15 tok/s、MacBook Pro M4 Proで29 tok/sというdecode速度が示されており、速度を重視するならE4B・E2Bといった小型モデルも選択肢になる。
開発者にはlitert-lm serveによるOpenAI互換APIサーバーという入り口も用意されており、Open WebUIやContinueなど既存ツールとの連携もしやすい。Mac App Store配布ではない点だけ注意し、必ず公式ページ経由で入手すること。
参考リンク(一次ソース)
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ