Atria Dawn Preview 必要スペック早見表
744B MoEをローカルで動かすVRAM目安(約400GB〜1.5TB)
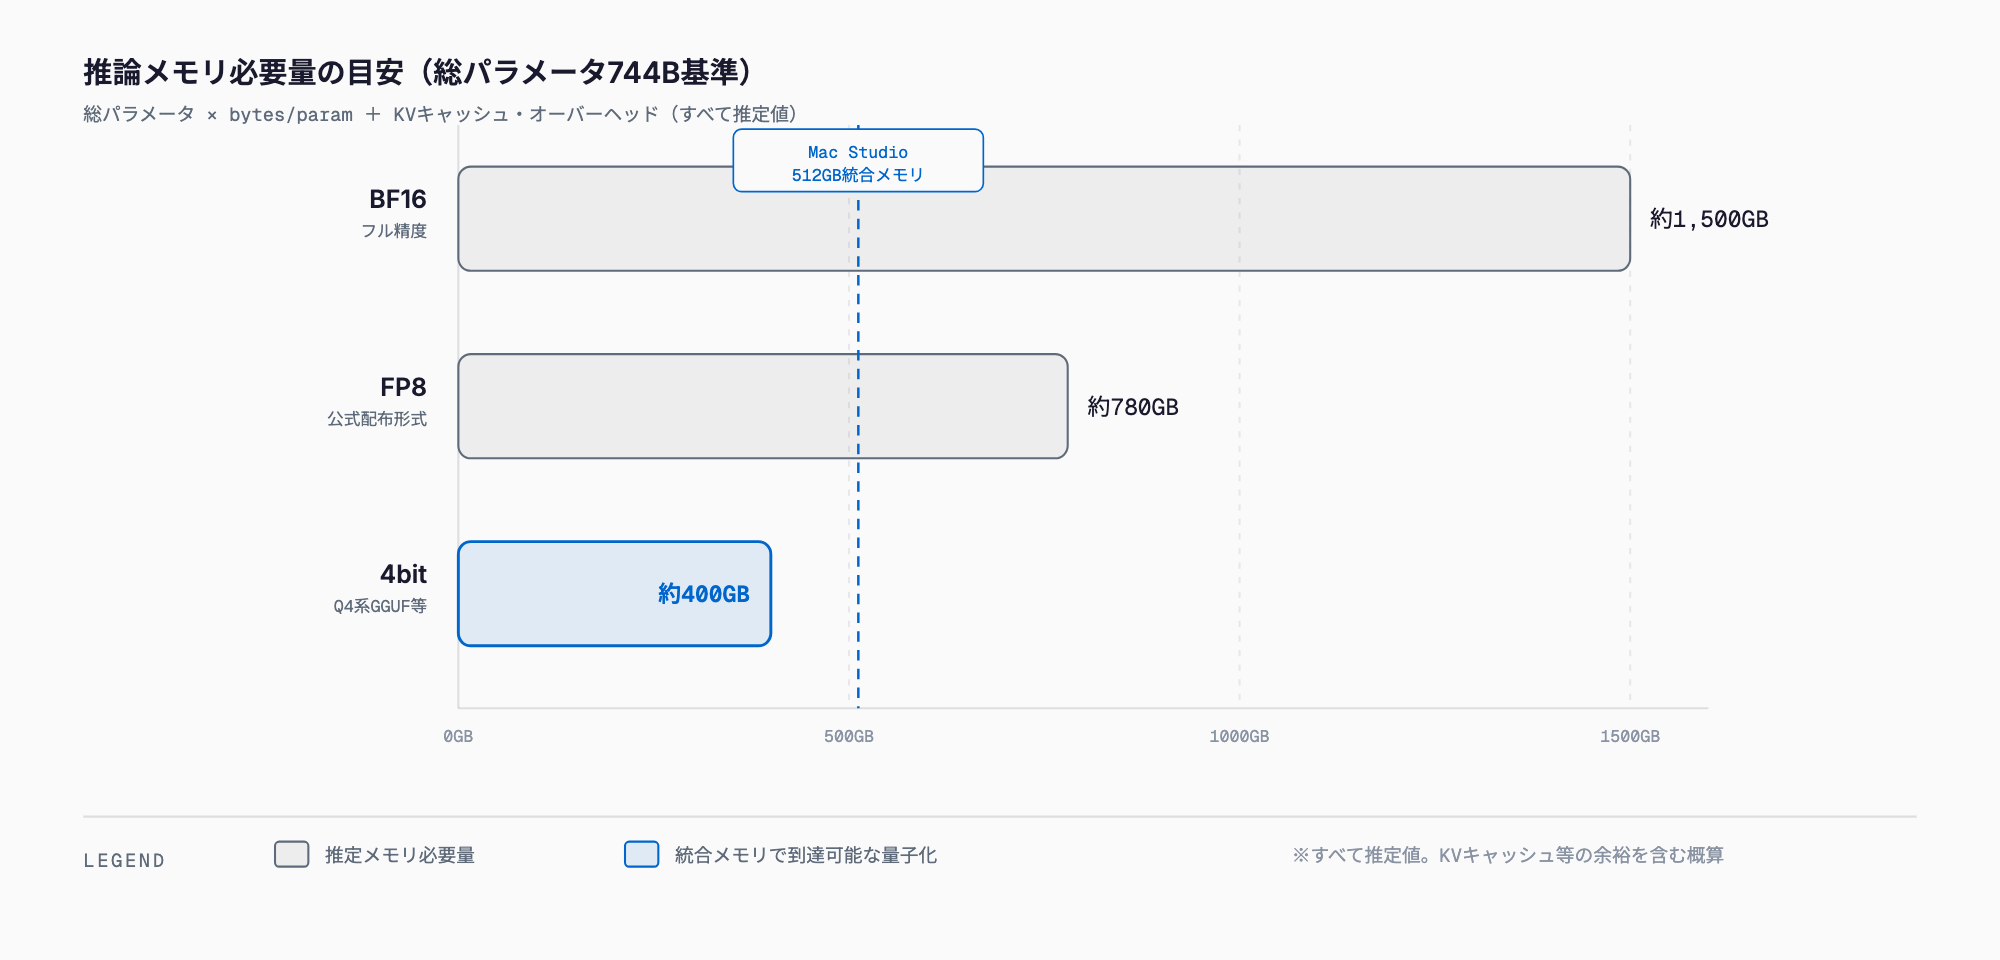
Atria Dawn Previewは4bit量子化で約400GB、FP8で約780GB、BF16で約1,500GBのメモリが目安(推定値)。744B MoEの基本情報・自己申告ベンチマーク・API有無・他モデル比較を整理した。
Atria Dawn Previewをローカルで動かすには、量子化次第でおよそ400GB(4bit)〜1,500GB(BF16フル精度)のメモリが必要になる、というのが結論だ。総パラメータ744BのMoE(Mixture of Experts)モデルであり、公式配布はBF16のフル精度チェックポイントとFP8量子化チェックポイントの2種類。いずれも個人のゲーミングPC1台では収まらず、マルチGPUサーバーか大容量統合メモリのワークステーション級の環境が前提になる。
以下の数値はすべて推定値である。計算式は「総パラメータ数 × bytes/param + KVキャッシュ・オーバーヘッド」。bytes/paramはBF16=2、FP8=1、4bit(INT4/GGUF Q4系)=0.5として、そこにコンテキストキャッシュや推論時のアクティベーション分の余裕(オーバーヘッド)を上乗せして概算している。MoEモデルなので1トークンの計算に使われるアクティブパラメータは総パラメータより大幅に少ないが、次にどの専門家(エキスパート)が選ばれるかは入力次第で変わるため、実務上はほぼ全ての専門家の重みをメモリに常駐させる必要がある。したがってVRAM/RAMのサイジングは、アクティブパラメータではなく総パラメータ数を基準に見積もるのが正しい。
必要スペック早見表(推定)
| 量子化 | 推定メモリ(総計) | GPU構成の例 | Mac Studio 512GB(統合メモリ)で動くか |
|---|---|---|---|
| BF16(フル精度・公式配布) | 約1,500GB | H100 80GB×19〜20枚 / H200 141GB×11枚 / B200×9枚クラス | 不可(容量を大きく超過) |
| FP8(公式配布) | 約780GB | H100 80GB×10枚 / H200 141GB×6枚 / B200×5枚クラス | 不可(容量を超過) |
| 4bit(INT4/GGUF Q4系・コミュニティ変換想定) | 約400GB | H100 80GB×5〜6枚 / H200 141GB×3枚 / B200×3枚クラス | 条件次第で可能性あり(KVキャッシュ次第で余裕は小さい) |
公式が配布しているのはBF16とFP8の2種類のみで、4bit級の軽量チェックポイントは本稿執筆時点(2026年9月22日)で公式には見当たらない。コミュニティによるGGUF等への変換が今後登場する可能性はあるが、現時点では推定値として参考にとどめてほしい。
Atria Dawn Previewとは何か
Atria Dawn Previewは、中国・上海人工智能実験室(Shanghai AI Laboratory)が2026年9月11日に公開した、エージェント用途(研究・エンジニアリングワークフロー)に特化したプレビューモデルである。総パラメータ744BのMoE基盤モデルで、Zhipu AI(Z.ai)が2026年6月に公開したGLM-5.2をベースに、Shanghai AI Laboratoryが独自のポストトレーニング(エージェント向け強化学習)を重ねて作られたとされる。単発の質疑応答ではなく、課題の分析→ツール利用→コード実装→実験実行→結果分析→失敗からの立て直し、という一連のタスク遂行ループを想定して設計されている点が特徴だ。
GitHub・Hugging Face上のモデル公開は2026年9月11日(FP8チェックポイントは9月12日)で、技術レポート(arXiv:2609.15818)の投稿は9月14日。つまりウェイトとAPIが技術レポートの公開より数日先行して公開された形になる。論文のタイトルは「Atria Dawn: The Dawn of Agentic Superintelligence」で、143名以上の著者が名を連ねる。
基本情報
| 項目 | 値 |
|---|---|
| 開発元 | 上海人工智能実験室(Shanghai AI Laboratory) |
| ベースモデル | GLM-5.2(Zhipu AI / Z.ai、744B MoE)にエージェント向けポストトレーニング |
| 総パラメータ | 744B |
| アクティブパラメータ | 公式は未公表(非公式情報は数値が不一致のため本稿では確定値扱いしない) |
| コンテキスト長 | 256K トークン |
| ライセンス | MIT(GitHub・Hugging Face双方で確認) |
| 公開配布形式 | BF16(フル精度)/FP8量子化の2種類 |
| 推論エンジン対応 | SGLang(v0.5.13.post1以降)、vLLM(v0.23.0以降)を公式にサポート |
| API | 国際向け api.atria-asi.ai/中国向け discovery.intern-ai.org.cn(OpenAI互換API) |
| 重み公開日 | 2026年9月11日(FP8は9月12日) |
| 技術レポート | arXiv:2609.15818(2026年9月14日投稿、v2は9月17日) |
ベンチマーク(すべて自己申告値)
以下はShanghai AI Laboratoryの技術レポートに掲載された数値で、すべて開発元による自己申告(ベンダー報告)のベンチマークであり、第三者機関の独立検証を経たものではない。技術レポートによれば16種類のベンチマークのうち5種類で最高スコアを記録したとされる。
| ベンチマーク | スコア | 備考 |
|---|---|---|
| SWE-bench Pro | 59.6% | ソフトウェアエンジニアリング能力の評価 |
| AutomationBench | 53.8 | 最高スコアとされる項目の一つ |
| BrowseComp | 92.5 | 最高スコアとされる項目の一つ |
| DeepSearchQA | 96.0 | 最高スコアとされる項目の一つ |
| BFCL v4 | 77.0 | 最高スコアとされる項目の一つ(ツール呼び出し評価) |
| CyberGym | 86.5 | 最高スコアとされる項目の一つ(サイバーセキュリティ) |
| MLE-bench Lite | 86.2 | 機械学習エンジニアリング関連 |
技術レポートでは、769件のタスク記録を対象にしたケーススタディで、人間の評価者が「AIの支援なしでは実行不可能だった」と判定したタスクが約3分の1に達したと報告している。エージェントが単発のタスク実行を超えて、プロジェクト単位での人間とAIの協業に寄与しうるという主張の根拠として位置づけられている。これも開発元の自己評価である点には留意したい。
想定用途 — Discovery / Creation / Delivery / Cybersecurity
- Discovery(発見): 論文調査・エビデンス収集など研究寄りのタスク
- Creation(創出): ソフトウェア・アプリ・機械学習システムの実装
- Delivery(成果物化): ドキュメントやプレゼンテーション資料の作成
- Cybersecurity(サイバーセキュリティ): 脆弱性の分析と修正対応
APIか自前ホストか
Shanghai AI Laboratoryは国際向け(api.atria-asi.ai)と中国向け(discovery.intern-ai.org.cn)の2つのホスト型APIを、OpenAI互換の形式で提供している。ただしAPI料金は本稿執筆時点で公式に未公表であり、無料枠の有無や従量課金の単価も確認できていない。まず性能を評価したい段階ではAPI利用が現実的な選択肢になる。
自前ホストを選ぶ場合は、SGLang(v0.5.13.post1以降)またはvLLM(v0.23.0以降)が公式にサポートされている。ただし前述の通りBF16で約1,500GB、FP8でも約780GBのメモリが必要になるため、H100/H200クラスのGPUを複数枚束ねたマルチノード構成が前提になる。データ主権やレイテンシ要件が厳しく、かつ継続的に高負荷で使う見込みがある場合に限り、自前ホストの投資対効果が見合ってくる。
主要なオープンウェイトMoEモデルとの比較
同時期に公開・話題になっている大型オープンウェイトMoEモデルと並べると、Atria Dawn Previewの位置づけが分かりやすい。数値は各モデルの公式発表・当サイトの既存記事で確認済みのものに限定し、未確認の項目は「未公表」と明記する。
| モデル | 総パラメータ | アクティブパラメータ | コンテキスト長 | ライセンス | 4bit時の推定メモリ目安 |
|---|---|---|---|---|---|
| Atria Dawn Preview | 744B | 公式は未公表 | 256K | MIT | 約400GB |
| GLM-5.2 | 753B | 未公表(当サイト既存記事準拠) | 記事準拠 | MIT | 約430GB |
| Kimi K3 | 2.8T | 約50B相当(報告値に幅あり) | 1,048,576(1M) | 修正MIT系(配布物のLICENSE要確認) | 4bit相当の重みで約1.4TB(MXFP4配布のため8bit級) |
| DeepSeek V4-Pro | 1.6T | 49B | 1M | MIT | 約920GB |
| DeepSeek V4-Flash | 284B | 13B | 1M | MIT | 約160GB |
Atria DawnはGLM-5.2の派生であるため、総パラメータ規模も推定メモリもGLM-5.2に近い。DeepSeek V4やKimi K3と比べると総パラメータは小さいが、これらのモデルはアクティブパラメータやコンテキスト長の設計思想が異なり、単純な優劣比較にはならない点に注意したい。なお、Kimi K3は公式配布がMXFP4形式のため、他モデルの「4bit」とは量子化方式が異なる。
注意点 — 「Preview」であることを踏まえて読む
- プレビュー版である: モデル名に明示されている通り先行公開版で、正式版でアーキテクチャやベンチマーク数値が変わる可能性がある
- ベンチマークは自己申告: 本稿で紹介した数値はすべて開発元の技術レポートによる自己評価で、第三者機関の独立検証を経ていない
- アクティブパラメータ非公表: MoEの設計上重要な情報だが公式資料に明記がなく、外部情報も数値が割れている
- 量子化版が限定的: 公式配布はBF16とFP8のみで、コミュニティによる4bit変換が本稿執筆時点で見当たらない
- API料金非公表: 継続利用時のコスト試算ができない状態のため、大規模な自前ホスト投資の判断は時期尚早な面がある
FAQ
Atria Dawn Previewはどこの誰が作ったモデルか。
中国・上海人工智能実験室(Shanghai AI Laboratory、InternLMシリーズの開発元)が2026年9月11日に公開したエージェント特化のプレビューモデルである。総パラメータ744BのMoE基盤モデルで、Zhipu AI(Z.ai)のGLM-5.2をベースにポストトレーニングを重ねて作られている。
なぜ「総パラメータ数」でVRAMを見積もるのか。アクティブパラメータは関係ないのか。
MoE(Mixture of Experts)モデルは、1トークンの計算には一部の専門家(エキスパート)しか使わないため計算量(アクティブパラメータ)は小さいが、次にどの専門家が選ばれるか分からない以上、原則として全専門家の重みをメモリ上に載せておく必要がある。したがって計算速度はアクティブパラメータに左右されるが、必要なVRAM/RAM容量は総パラメータ数で見積もるのが基本になる。
Atria Dawn Previewのアクティブパラメータ数は公表されているか。
本稿執筆時点(2026年9月22日)で、Hugging FaceのモデルカードおよびGitHubリポジトリのREADMEにはアクティブパラメータ数の明記が見当たらず、公式は未公表である。海外の非公式まとめサイトでは「約18B」「約37〜40B」など数値に幅があり、出典間で一致していないため本稿では確定値として扱わない。
SWE-bench Proの59.6%という数値はどこまで信用できるか。
Shanghai AI Laboratory自身が公開した技術レポート(arXiv:2609.15818)に掲載された自己申告(ベンダー報告)のベンチマーク値であり、第三者機関による独立検証ではない。「Preview」と明示された先行公開版でもあるため、正式版で数値が変わる可能性を踏まえて参考値として扱うべきである。
Mac StudioのようなApple Silicon機で動かせるか。
4bit量子化(約400GB程度と推定)であれば、統合メモリ512GB構成のMac Studioに収まる可能性がある。ただしFP8(約780GB推定)やBF16(約1,500GB推定)は512GBでは収まらない。いずれも推定値であり、実際にはOS・他プロセスの消費やコンテキスト長に応じたKVキャッシュ増加分を差し引いて考える必要がある。
API利用と自前ホスト、どちらを選ぶべきか。
Atria Dawn PreviewのAPI料金は本稿執筆時点で公式に未公表である。数百GB〜1.5TB級のメモリを要する自前ホストは初期投資と運用の負荷が大きいため、まずは国際向け・中国向けのホスト型APIや、SGLang/vLLM対応をうたうサードパーティのホスティングサービスで性能を評価し、継続利用の見込みが立ってから自前ホストを検討する順番が現実的である。
まとめ
Atria Dawn Previewは、総パラメータ744BのMoE基盤モデルで、GLM-5.2をベースにエージェント用途向けのポストトレーニングを重ねた、Shanghai AI Laboratoryによるプレビューモデルだ。ローカルで動かす場合の目安は4bit量子化で約400GB、公式配布のFP8で約780GB、BF16フル精度で約1,500GBと、いずれも推定値ながら大規模な計算資源が必要になる。ベンチマーク数値はすべて自己申告であり、プレビュー版という位置づけも踏まえて評価する必要がある。同時期の大型オープンMoEモデルの比較はGLM-5.2、Kimi K3、DeepSeek V4、GLM-5.3の各記事も参照してほしい。大規模モデルの検証環境構築やAI導入の相談はAIコンサルティングでも受け付けている。相談はお問い合わせから。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ