DwarfStar(ds4)とは — Redis作者antirezのローカルLLM推論エンジン
DwarfStar(ds4)はRedis作者antirezのMITライセンスのローカルLLM推論エンジン。DeepSeek V4/V4.1・GLM 5.3・Qwen3.8を96〜128GBのMacやDGX Sparkで動かす。2026年10月時点のメモリ要件、導入手順、Claude Code連携、実測値を解説。
DwarfStar(ds4、GitHub: antirez/ds4)は、Redisの作者Salvatore Sanfilippo(antirez)が公開しているMIT Licenseのローカル推論エンジンです。DeepSeek V4/V4.1 Flash・GLM 5.2/5.3・Qwen3.8 Flash Nextなど「ごく少数の優れたオープンウェイトモデル」に絞り込んだ設計で、96〜128GBのMac(Metal)、NVIDIA DGX Spark、Strix Halo、複数枚のCUDAカードで動かすことを主眼にしています。汎用のGGUFランナーではなく、プロジェクトが配布する専用GGUFだけを動かす点が最大の特徴です。2026年5月6日のリポジトリ作成からスターは約2万3,000に達し、10月3日にはプロジェクトサイトdwarfstar.shが「From the creator of Redis; run LLM locally with ds4」というタイトルでHacker Newsのフロントページに載りました。
本稿では、2026年10月時点の公式ドキュメント(README、MODELS、PERFORMANCE、CLIENTS、SSD_STREAMING)に基づき、できること、対応ハードウェアとメモリ要件、導入手順、Claude Code・Codex CLI・OpenCodeとの接続、実測値、既存ツールとの違い、注意点を整理します。なお、公式がこのソフトウェアを「ベータ品質」と明記している点は最初にお伝えしておきます。
DwarfStar(ds4)とは — 「狭く作る」推論エンジン
公式の目標は「消費者が実際に所有できるハードウェアで、少数の優れた大規模言語モデルを動かす最良の方法になること」です。そのために、特定モデルに最適化した小さなネイティブ推論エンジンを自前で書いています。最優先の対象はDeepSeek V4 Flash(実験的なビジョンモデルを含む)で、そこにDeepSeek V4.1 Flash(Metalと、CUDAでのテキスト推論)、GLM 5.2・5.3、GLM 5.3 Flash、DeepSeek V4 PRO、Qwen3.8 Flash Next(MetalとCUDA)が加わります。
コードは自己完結しており、モデルのロード、プロンプトの組み立て、ツール呼び出し、KV状態、HTTPサーバ、コーディングエージェントを一体でテストしています。GGML自体にはリンクしていませんが、llama.cppとGGMLが切り開いたカーネル、量子化フォーマット、GGUFエコシステムを参照して成立しており、READMEにはGeorgi Gerganov氏らへの謝辞が明記されています。モデル対応も意図的に「機会主義的」で、より良い重みが出れば古いモデルは外される場合があります。ターゲットは128GBのノートPCや256/512GBのワークステーションといった、現実的に手の届く上限のマシンです。
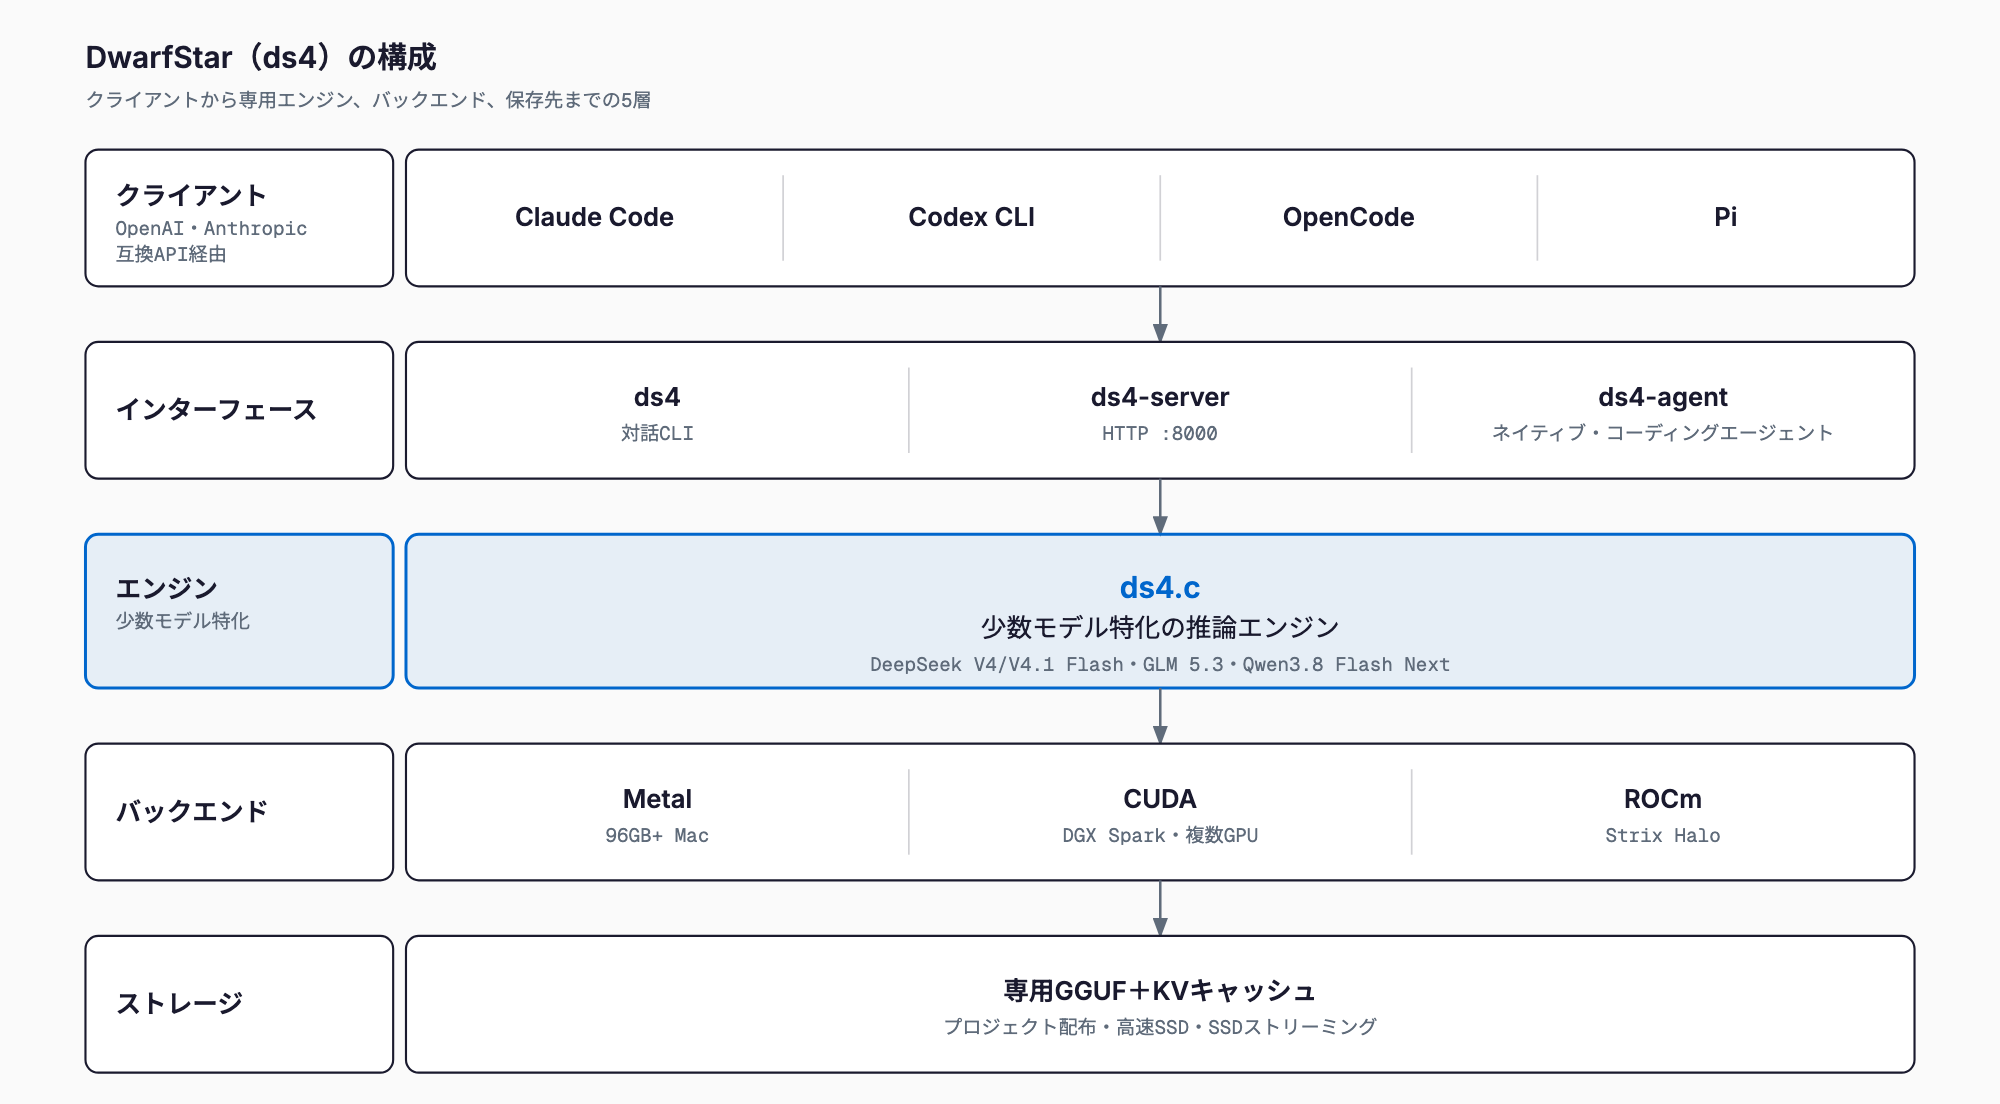
DwarfStarでできること
- 専用エンジンによる大型モデルのローカル実行: MacBook、DGX Spark、Strix Haloなどで、非常に高性能なモデルを動かせる
- 非対称の2bit量子化: 推論の大半を占めるルーテッドエキスパートに強く圧縮をかけ(IQ2_XXSのgate/up、Q2_Kのdown)、他の部分はQ8やF16/F32など高い精度で残す
- SSDストリーミング: メモリに載り切らないモデルを、使用頻度の高いエキスパートだけをキャッシュしつつSSDから読んで動かす
- ディスクKVキャッシュ: 互換性のあるKVスナップショットを保存し、長いプロンプトの再計算を避ける
- 3つの実行形態: 対話CLIのds4、OpenAI/Anthropic互換APIのds4-server、推論エンジンに直結するネイティブds4-agent
- ビジョン: PNG/JPEG入力に対応(モデルに合うエンコーダを--visionで指定)
- MTP投機的デコード: --mtpでGLMとQwenの内蔵ドラフトブロックを利用できる
- 複数Macの結合: RDMAで接続した2台の128GB Macでのテンソル並列、パイプライン並列でRAMを合算
- マルチGPUのCUDA: Ada Lovelace世代(L40S含む)に対応し、L40Sを8枚使う構成で16セッション時に集計約126 t/sの生成速度を記録
READMEの動機として挙げられているのは、高性能なオープンウェイトモデルが個人の高性能マシンに収まるようになったこと、DeepSeek V4 Flash/PROとGLM 5.2がルーテッドエキスパートへの強い量子化に耐えること、圧縮KVキャッシュと高速なローカルSSDで長いコンテキストが現実的になったことです。
対応ハードウェアとモデルごとのメモリ要件
対応環境は3系統です。Metalはプライマリターゲットで、96GB以上のMacを想定し、それより小さいマシンではSSDストリーミングを使います。NVIDIA CUDAではDGX Sparkが主目標で、他のバックエンドが対応しないマルチGPU構成(例: Ada LovelaceカードでのDeepSeek V4 Flash)も動かせます。ROCmはFramework DesktopなどのStrix Haloが対象です。ビルドはMetalがmake、DGX Sparkがmake cuda-spark、Strix Haloがmake strix-halo、汎用CUDAがmake cuda-genericです。
主なダウンロードターゲットと目安は次の表のとおりです(公式MODELS.mdの記載に基づく。実行時はコンテキストやバッファ分のメモリも別途必要)。
| ターゲット | ファイルサイズ | 常駐メモリ・備考 | 想定マシン |
|---|---|---|---|
ds4f-q2(DeepSeek V4 Flash 0731) | 約81 GiB | 最初の一歩に推奨 | 96/128GB Mac、DGX Spark |
ds41f-q2(V4.1 Flash) | 341 GiB(主重み152 GiB+Engram 189 GiB) | Engramは常にディスクから直接読む。TPなら各ランクで主重み約81 GiB | 128GB MacまたはSparkでSSDストリーミング、または2台でTP |
ds41f-q4(V4.1 Flash) | 483 GiB(主重み294 GiB) | 小型Macはストリーミング、常駐は512GB Mac | 512GB Mac |
qwen38-q2(Qwen3.8 Flash Next) | 137.10 GiB(主重み/MTP 41.73 GiB+n-gram 95.37 GiB) | n-gramはメモリに載せずディスクから読む。8Kコンテキストから開始 | 64GB Mac〜 |
qwen38-q4k | 165.11 GiB | 常駐重み69.74 GiB(ランタイムバッファ別) | 大きめのMac、単一GPU CUDA |
glm53-q2(GLM 5.3 Flash) | 約90 GiB | 128GBマシンのメモリ予算にほぼ収まる | 128GB Mac、DGX Spark、ROCm |
glm53-q4 | 約178 GiB | 大きなMac、2台の128GB Mac、またはSSDストリーミング | 大容量Mac |
glm53-full-q2(フルGLM 5.3) | 約197 GiB | 十分に大きなマシンまたはストリーミング | 大容量Mac、ストリーミング |
pro-q2-imatrix(V4 PRO) | — | 512GB常駐、またはSSDストリーミング | 512GB Mac |
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。
元になっているモデルの仕様や料金は、DeepSeek V4の必要スペック・VRAM・料金の解説、GLM 5.3 Flashの必要スペック解説、Qwen3.8 Flash Nextの必要スペック解説で詳しく扱っています。ds4はそれらを「どのマシンでどう動かすか」の実行環境側から支えるツールと位置づけられます。
インストールとクイックスタート
ビルドから初回起動までは数コマンドで済みます。まずリポジトリをクローンし、自分の環境に合ったターゲットでビルドします(以下はApple Siliconの例)。96/128GBのマシンでの初回は、DeepSeek V4 Flash Q2を取得するのが公式の案内です。ダウンロードはgguf/に保存され、中断した場合は同じコマンドを再実行すると再開されます。
git clone https://github.com/antirez/ds4.git
cd ds4

# Apple Silicon (Metal)
make

# 96/128GBマシン向けの最初のモデル
./download_model.sh ds4f-q2モデルを取得したら、普段使いのコマンドは次のとおりです。デフォルトのモデルはds4flash.ggufというリンクで、メインモデルをダウンロードするたびに更新されます。どのモデルを使うか明示したい場合は-m FILEを指定します。サーバはデフォルトでhttp://127.0.0.1:8000で待ち受けます。
./ds4
./ds4 -p "Explain Redis streams in one paragraph."
./ds4-agent
./ds4-server --ctx 32768対話CLIでは/help、/read FILE、/ctx N、/quitが使え、Ctrl+Cで生成を中断してプロンプトに戻れます。思考(thinking)はデフォルトで有効で、--nothinkで直接回答に切り替えられます。V4.1では--think-level 25のように1〜100で推論の強さを指定でき、0で無効化です。サンプリングの既定値はtemperature 1、top-p 1、min-p 0.05で、--temp 0で貪欲デコードになります。
メモリに載らないモデルを動かす — SSDストリーミング
モデルが常駐できる場合はそちらが速く、SSDストリーミングは速度を容量と引き換えにする仕組みです。ルーテッドエキスパートの有限キャッシュをメモリに保ち、足りないエキスパートをGGUFから読み込みます。ただし、それ以外の重み、活性化、スクラッチ、コンテキストに必要なメモリが不要になるわけではありません。まずは自動予算で試すのが公式の推奨で、起動時のレポートに実効キャッシュと必要メモリが表示されます。
# 小さめのMacでFlash Q2
./download_model.sh ds4f-q2
./ds4 --ssd-streaming --ctx 32768 --nothink

# 128GB MacでGLM 5.3 Flash Q4
./download_model.sh glm53-q4
./ds4 --ssd-streaming --ctx 4096

# キャッシュ予算を明示する場合
./ds4 --ssd-streaming --ssd-streaming-cache-experts 32GB
128GBのM5 Maxで自動キャッシュ・投機的デコードなしで測った参考値(2026年9月6日)は、GLM 5.3 Flash Q4_K(177.77 GiB)が初回prefill 121 t/s・継続prefill 104 t/s・生成11.9/14.9 t/s(3回の中央値)、DeepSeek Flash Vision Exp MXFP4(145.26 GiB)が初回prefill 300 t/s・継続prefill 263 t/s・生成11.9/19.3 t/s(1回の計測)でした。生成はキャッシュミスの影響を受けやすく、起動に成功しても対話には遅すぎる場合があるため、長い作業の前に短い生成で確認するよう公式も勧めています。128GB MacでのPRO Q2も「確認用には使えるが遅い」という位置づけです。これらはプロンプトに依存する参考値で、あらゆる「RAM超え」モデルの速度保証ではありません。
なお、キャッシュを大きくしすぎると、毎トークン必要な非ルーテッド重みがメモリから追い出されてデコードが遅くなる場合があります。キャッシュを増やして効くのは、残りの作業セットがメモリに収まっている間だけです。
Claude Code・Codex CLI・OpenCodeから使う
ds4はds4-serverを通じて、Pi、OpenCode、Codex CLI、Claude Codeといったコーディングエージェントのバックエンドになれます。先にサーバを起動し、クライアント側のコンテキスト上限はサーバ以下に設定します(出力トークンもコンテキストを消費し、クライアント設定でサーバの確保量が増えるわけではありません)。以下のdsv4-localは認証ではなくプレースホルダです。
./ds4-server --ctx 100000 --kv-disk-dir /tmp/ds4-kv --kv-disk-space-mb 8192Claude CodeはAnthropic互換エンドポイントを使います。公式が示すシェルラッパーでは、メインエージェントと各モデルロール、サブエージェントのモデルをローカルのDeepSeek V4 Flashに向けます。ラッパーにはclaudeとは別の名前を付けてください。
#!/bin/sh
unset ANTHROPIC_API_KEY
export ANTHROPIC_BASE_URL="http://127.0.0.1:8000"
export ANTHROPIC_AUTH_TOKEN="dsv4-local"
export ANTHROPIC_MODEL="deepseek-v4-flash"
export ANTHROPIC_DEFAULT_SONNET_MODEL="deepseek-v4-flash"
export ANTHROPIC_DEFAULT_HAIKU_MODEL="deepseek-v4-flash"
export ANTHROPIC_DEFAULT_OPUS_MODEL="deepseek-v4-flash"
export CLAUDE_CODE_SUBAGENT_MODEL="deepseek-v4-flash"
export CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1
export CLAUDE_STREAM_IDLE_TIMEOUT_MS=600000
exec claude "$@"
Codex CLIはResponses APIを使い、設定にプロバイダを追加して起動します。OpenCodeは~/.config/opencode/opencode.jsonに@ai-sdk/openai-compatibleプロバイダ(baseURLはhttp://127.0.0.1:8000/v1)を追記し、モデルにds4/deepseek-v4-flashを選びます。Piも~/.pi/agent/models.jsonにプロバイダを足す方式です。
[model_providers.ds4]
name = "DwarfStar"
base_url = "http://127.0.0.1:8000/v1"
wire_api = "responses"
stream_idle_timeout_ms = 1000000

# 起動
codex --model deepseek-v4-flash -c model_provider=ds4エージェント系クライアントは大きな初期プロンプトを送るため、最初のprefillには時間がかかります。--kv-disk-dirによるディスクキャッシュを有効にしておくと、2回目以降は互換性のあるプレフィックスを再利用できます。
性能の実測値 — M5 MaxとDGX Spark
公式PERFORMANCE.mdに記録されている、DeepSeek V4 Flash Q2のベースライン(2048トークン刻みの継続prefill、各地点で128トークンを貪欲生成)は次のとおりです。これは記録済みのベースラインであり、すべてのコミットを測り直した結果ではありません。
| マシン | コンテキスト | Prefill | 生成 |
|---|---|---|---|
| M5 Max 128GB | 2,048 | 790.18 t/s | 39.35 t/s |
| M5 Max 128GB | 16,384 | 572.53 t/s | 36.14 t/s |
| M5 Max 128GB | 32,768 | 557.04 t/s | 34.36 t/s |
| M5 Max 128GB | 65,536 | 398.50 t/s | 27.64 t/s |
| DGX Spark 128GB | 2,048 | 825.76 t/s | 18.05 t/s |
| DGX Spark 128GB | 16,384 | 872.44 t/s | 15.10 t/s |
| DGX Spark 128GB | 32,768 | 855.94 t/s | 14.43 t/s |
| DGX Spark 128GB | 65,536 | 822.98 t/s | 13.84 t/s |
傾向としては、M5 Maxは生成が速い一方でコンテキストが伸びるとprefillが落ち、DGX Sparkはprefillが長いコンテキストでもほぼ800 t/s台を維持するものの生成はM5 Maxの半分以下です。長い入力を読ませる用途とチャット的な応答速度では、得意なマシンが分かれます。DGX Sparkでのローカル活用はDGX Sparkで機密コードを解析する運用の解説も参考になります。自分の環境で測る場合は、同梱のds4-benchでコンテキストごとのprefillと生成を計測できます。
MTPによる投機的デコードと複数マシン構成
投機的デコードはオプトインです。GLMとQwenは--mtpで内蔵のドラフトブロックを使え、追加のモデルファイルは要りません。V4 Flash DSpark用には対応するサポートGGUFが必要です。生成が速くなる場合がありますが、全ワークロードで効くわけではなく、予測しにくいプロンプトでは通常のデコードより遅くなり得ると公式も注意しています。デフォルトの機会的サンプリングと--mtp-exact-samplingの違いは専用ドキュメントを確認してください。
複数マシンでは、RDMAで接続した2台の128GB MacでDeepSeek Flashの4bit版やGLM 5.3 Flashをテンソル並列で動かせます。V4.1 Flash Q2の場合、各ランクの主重みは約81 GiBで、両マシンに完全なGGUFが必要です。V4.1 Q4は2台の128GB Macには常駐TPで収まらないため、ストリーミングか512GB Macを使います。パイプライン並列でシステムのRAMを足し合わせる使い方もできます。
既存ツール(llama.cpp・Ollama・LM Studio・oMLX)との違い
最大の違いは「どのモデルでも動かす汎用ランナー」か「少数モデルに特化した専用エンジン」かです。ds4はllama.cppの成果に依拠しており、競合というより特定の用途に絞った別の選択肢です。公式ドキュメントに基づく範囲で比較します。
| 項目 | ds4(DwarfStar) | llama.cpp | Ollama / LM Studio | oMLX |
|---|---|---|---|---|
| 設計思想 | 少数モデル専用の狭いエンジン | 汎用GGUFランナー | 汎用ランナーを使いやすく包んだツール | Apple Silicon向け推論サーバ |
| 対応モデル | DeepSeek V4系、GLM 5.x、Qwen3.8 Flash Nextなど | 幅広いGGUFモデル | 幅広いモデル | mlx-lm系のモデル |
| モデルファイル | プロジェクト配布の専用GGUFのみ | 一般的なGGUF | 各ツールのモデル管理 | MLX形式 |
| 対応環境 | Metal、CUDA、ROCm | 幅広い | 幅広い | Apple Siliconのみ |
| 成熟度 | ベータ(変化が速い) | 成熟 | 成熟 | — |
| 大型MoE特化機能 | 非対称2bit量子化、SSDストリーミング、ディスクKV | 汎用 | 汎用 | 階層KVキャッシュ |
日常の汎用用途でモデルを頻繁に入れ替えるなら、OllamaとLM Studioの比較で扱ったような汎用ツールのほうが扱いやすいでしょう。Apple Silicon上で連続バッチングやメニューバー管理を重視するならoMLXの解説も選択肢です。ds4は「DeepSeek V4やGLM 5.xクラスの大型MoEを、手持ちの128GBクラスのマシンで現実的に動かす」ことに価値を置く人向けです。
注意点と制約
- ベータ品質: 変化が非常に速く、各リリース前にQAは実施されるものの、不安定さや退行は起こり得る
- 専用GGUFのみ: 他のGGUFは、テンソルレイアウトやメタデータ、量子化の組み合わせが未対応の場合がある。download_model.shのターゲットを使う
- AIの強い支援で開発: 作者は、このソフトウェアがAIコーディングエージェントの強い支援のもと、人間が発想・テスト・デバッグを主導して作られていると明記している。AI生成コードに抵抗がある場合は合わないと述べられている
- 高速なローカルSSDが前提: V4.1のEngramテーブルやQwen3.8のn-gramは常にディスクから読む。SSDストリーミングも含め、SSD性能が体感速度を左右する
- 機能の対応差: V4.1のビジョンはMetalのみ。ビジョン付きエージェントセッションは/saveで保存できない。GLMは--power 100が必要で、--prefill-chunkや外部--mtp-modelは使えない
- プライバシー: 保存した会話やトレースには個人情報が含まれ得る。リモートサーバに向ける場合は信頼できる環境に限る
- 数値の完全一致は保証されない: スカラー、バッチ、テンソル並列の実行は数値的に同一ではない
また、作者は「AI時代のソフトの届け方」として、ユーザーがコーディングエージェントを使って自分の環境向けに改造すること自体を想定しています。ドキュメントにない要望も、エージェントに相談して実現できる可能性があるというのが公式のスタンスです。
よくある質問
ds4はどんなマシンで動きますか?
主な対象は96GB以上のメモリを持つApple Silicon Mac(Metal)、DGX Spark、Strix Halo、複数枚のCUDAカードです。メモリが足りない場合はSSDストリーミングで容量を補えますが、速度は落ちます。Qwen3.8 Flash Nextの小さなQ2版は64GB Macが出発点です。
OllamaやLM Studioのように好きなGGUFを読み込めますか?
読み込めません。DwarfStarは汎用GGUFランナーではなく、プロジェクトが作成・配布するGGUFのみを対象にしています。他のGGUFはテンソルレイアウトやメタデータ、量子化の混成が未対応の可能性があります。
Claude Codeのモデルとして使えますか?
使えます。ds4-serverがAnthropic互換エンドポイントを提供するため、ANTHROPIC_BASE_URLなどを設定したシェルラッパー経由でClaude Codeを接続できます。Codex CLI(Responses API)、OpenCode、Piにも対応した設定例が公式ドキュメントにあります。ただし最初のprefillには時間がかかります。
ライセンスと商用利用は?
リポジトリはMIT Licenseで公開されており、llama.cpp/GGMLの一部コードを流用している関係でGGML作者の著作権表示がLICENSEに残されています。ただし、動かすモデルの重みには各モデル自体のライセンスが別途適用されるため、利用前に確認してください。
どのくらいの速度が出ますか?
公式の記録では、DeepSeek V4 Flash Q2が128GBのM5 Maxで2,048トークン時にprefill 790 t/s・生成39 t/s、DGX Sparkで同条件のprefill 826 t/s・生成18 t/sでした。SSDストリーミングやモデルの大きさで大きく変わり、公式も「速度保証ではない」としています。
まとめ
DwarfStar(ds4)は、Redisの作者が「少数の優れたモデルを、手の届く高性能マシンで」という方針で作ったMITライセンスの専用推論エンジンです。非対称2bit量子化、SSDストリーミング、ディスクKV、MTP、複数マシン結合を組み合わせ、128GBクラスのMacやDGX SparkでDeepSeek V4やGLM 5.xといった大型モデルを現実的に動かすことを狙っています。ds4-serverを通じてClaude CodeやCodex CLIのバックエンドにもできます。一方でベータ品質で、専用GGUFしか動かず、SSD性能にも左右されます。汎用性と安定性を求めるなら既存ツール、特定の大型モデルをローカルで動かしたいなら有力な選択肢、という使い分けが現実的です。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ