FLUX 3 Image Klein 必要スペック・使い方
5.6Bで生成と編集、RTX 8GBから【2026年10月】
FLUX 3 Image Kleinの必要スペックは、INT8版とComfyUIでVRAM 8GBのRTX、公式実測はBF16で31GBである。2026年10月15日公開、5.6Bで生成と編集に対応。最大10枚参照、pupは約28GB追加で、商用利用は年商500万ドル未満が条件となる。Macは公式未記載。
FLUX 3 Image Klein は、Black Forest Labs(BFL)が2026年10月15日にオープンウェイトで公開した5.6Bパラメータの画像生成・編集モデルである。結論から言うと、INT8版とComfyUIを使えばVRAM 8GBのGeForce RTXでも動作する一方、公式のリファレンスコードで実測された値はBF16で31GB・FP8で26GB・NVFP4で25GBと大きく、プロンプトアップサンプラー(pup)を併用するとさらに約28GBが加わる。この差は量子化とオフロード、テキストエンコーダの扱いから生じるもので、本記事ではその内訳を整理する。テキストからの画像生成、画像編集、最大10枚の参照画像を使うマルチリファレンス生成、ネイティブ4K出力に対応し、ライセンスは年間総収益500万ドル未満の事業者なら商用出力が認められるFLUX Kommunity License v1.0である。以下、必要スペック、使い方、ライセンス、既存モデルとの違い、トラブル対処をまとめる。
必要スペック早見表
| 構成 | 必要VRAM目安 | 推奨GPU(目安) | 備考 |
|---|---|---|---|
| INT8版+ComfyUI(メモリ管理・オフロードあり) | 8GB〜 | RTX 4060 8GB、RTX 4070クラス | BFLとNVIDIAの公式発表ベース。速度は1MPで4070が9秒未満 |
| FP8版(リファレンスコード) | 26GB(B200・1024x1024・アップサンプラーなし) | RTX 5090(32GB)クラス | 重みは5.6GBだが、テキストエンコーダ等を含めて26GB |
| BF16版(リファレンスコード) | 31GB(同条件) | RTX 5090(32GB)は余裕が小さい。RTX PRO 6000など48GB以上が安心 | 重みは11.2GB。Klein Baseの微調整もこのクラスが目安 |
| NVFP4版(リファレンスコード) | 25GB(同条件) | Blackwell世代GPU | 公式発表ではGB300で1MPあたり0.6秒未満 |
| 上記+プロンプトアップサンプラー(pup) | 追加で約28GB(80GBのGPUでの実測) | 80GB級GPU、またはpupを別処理・API側に逃がす | pupは別の9Bモデル。モデルカードは「アップサンプラーなしで使うな」と案内 |
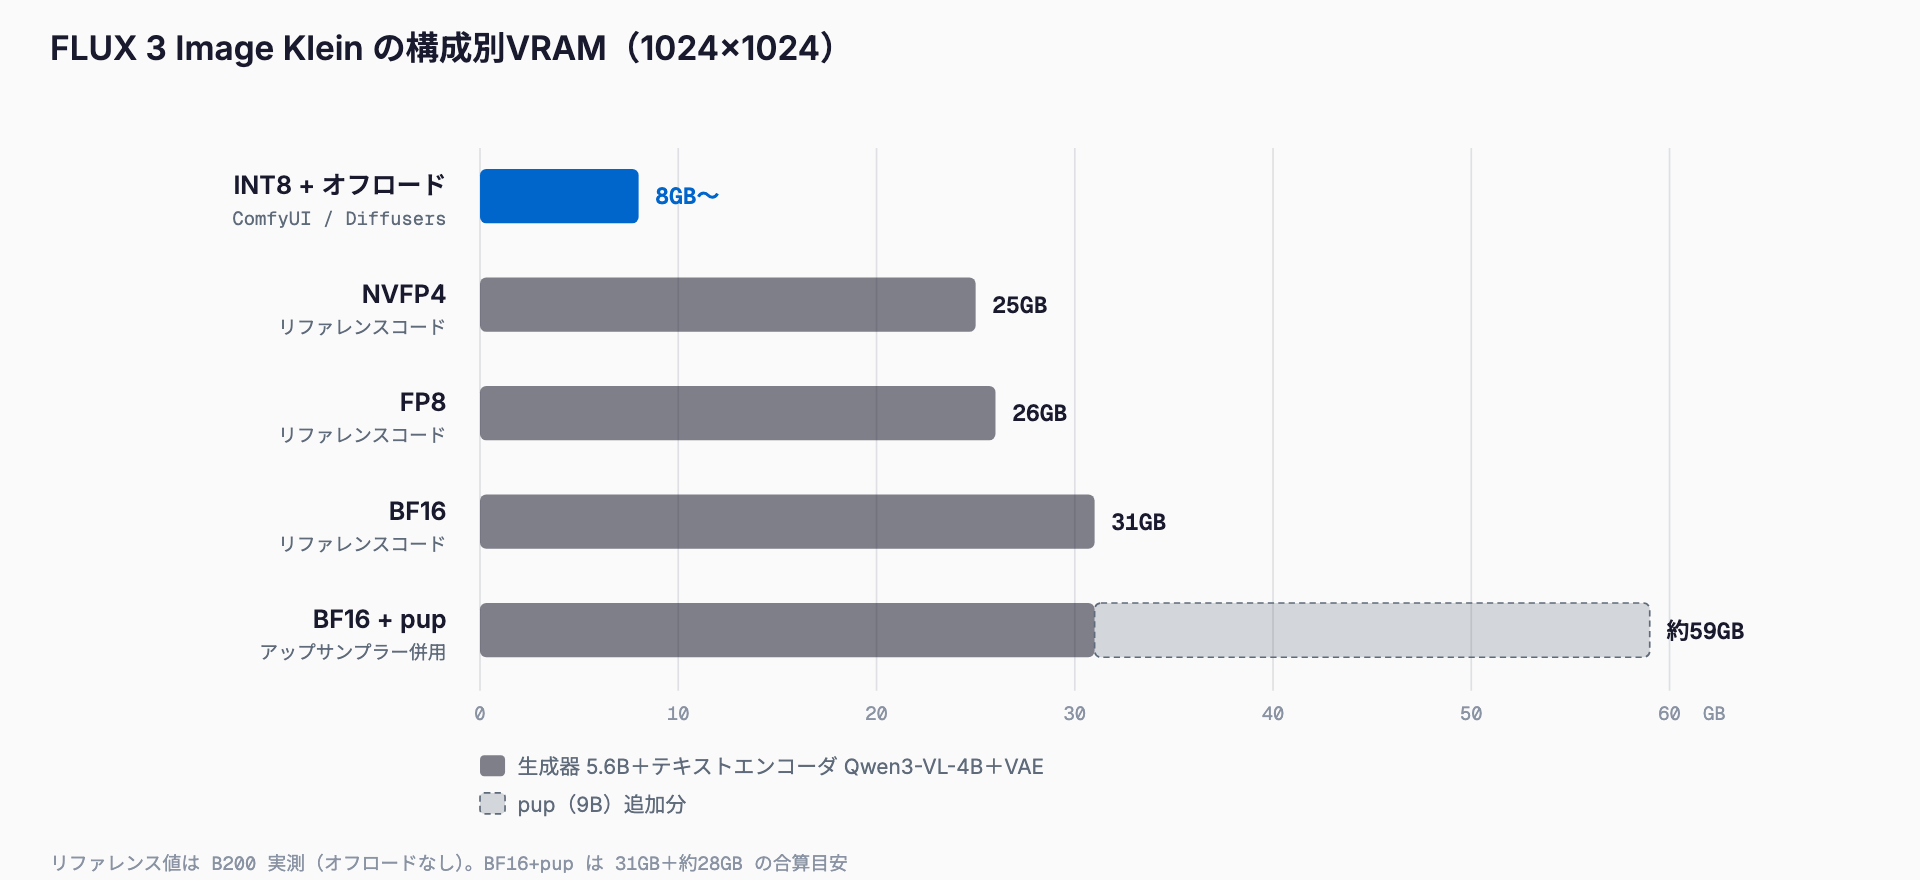
GPUの推奨欄は、公式の実測値から筆者が当てはめた目安であり、公式が推奨GPUを列挙しているわけではない。また上のVRAM値はB200で測られたものなので、他のGPUでは実装やドライバの違いで多少ずれる。公式モデルカードも、量子化後のファイルサイズがそのままGPUメモリ使用量にはならないと注意している。
なお、Apple Siliconを含むMacでの動作は公式には記載がなく、MPS(Metal)での動作や速度も未検証である。本記事ではMacの数値は示さない。
なぜ「31GB」と「8GB」が両立するのか
公式情報には一見矛盾する2つの数字がある。リファレンスコードの実測31GB(BF16)と、コンシューマGPUのVRAM 8GBで動くというブログの記述だ。これは前提条件が違うために生じる。
- リファレンスコードの値: 生成器(Transformer)、Qwen3-VL-4B-Instructのテキストエンコーダ、VAEをすべてGPUに載せたまま、オフロードなしで測った値である。BF16の生成器だけで11.2GB、テキストエンコーダが約8GB(4BをBF16で保持した場合の概算)あり、そこへアクティベーションが乗るため、合計で31GBに達する
- 8GB構成: 生成器をINT8に量子化して重みを半分以下に圧縮し、さらにComfyUIやDiffusersのメモリ管理(使わないコンポーネントをCPUメモリへ退避するオフロード)を併用することで、GPUに同時に載せる量を抑える。引き換えにCPU側のメモリ(RAM)と転送時間が必要になる
- テキストエンコーダは別部品: 5.6Bという数字にはテキストエンコーダが含まれない。safetensorsのメタデータ上は約6Bと表示される。VRAMを見積もるときは「生成器+テキストエンコーダ+VAE」の合算で考える必要がある
つまり8GBで動くのは「INT8+オフロード」という条件つきであり、常にすべてをGPUに置いておく使い方ではない。システムRAMの必要量は公式未公開なので、目安として16GB以上、余裕を持たせるなら32GBを用意しておくと安心だが、これは筆者の推測であることを断っておく。
FLUX 3 Image Klein とは
FLUX 3 Image Kleinは、FLUX 3ファミリーとして2つ目のオープンウェイト公開モデルにあたる。1つ目はロボティクス向けのFLUX 3 Actionである。Kleinは5.6Bパラメータの画像Transformerで、テキストから画像を作る機能と、既存画像を編集する機能を1つのモデルで扱う。
Klein と Klein Base の違い
| 項目 | Klein(蒸留版) | Klein Base(非蒸留版) |
|---|---|---|
| 精度 | BF16(FP8・NVFP4の量子化版も同梱) | BF16 |
| ステップ数 | 16 | 50 |
| ガイダンス | なし | 3.5 |
| 主な用途 | 推論・日常的な生成。BFLのAPIで使われているのもこちら | 微調整、LoRA学習、研究 |
| Hugging Faceリポジトリ | black-forest-labs/flux-3-image-klein | black-forest-labs/flux-3-image-klein-base |
ふだん画像を生成するだけならKlein(蒸留版)を選ぶ。ステップが16と少なく、ガイダンスも不要なので速い。LoRAなどで自社の画風や商品を学習させたい場合は、非蒸留のKlein Baseを土台にする。蒸留版にはFP8(variants/fp8r)とNVFP4(variants/nvfp4)の量子化バリアントが同梱されており、ブログではNVIDIAと開発したINT8版にも言及されている。
構成要素: テキストエンコーダ・VAE・pup
- テキストエンコーダ: Qwen3-VL-4B-Instruct(Apache-2.0)。生成器とは別コンポーネントとして読み込まれる
- VAE: ae.safetensors
- プロンプトアップサンプラー(pup): black-forest-labs/flux-3-image-klein-pup。別個の9Bモデルでダウンロードは18.8GB。短い指示文をシーン全体の詳細な説明文へ書き換える役割を持つ。モデルカードは、pupなしでの利用を推奨しないとしている
- ComfyUI向けパッケージ: black-forest-labs/flux-3-image-klein-comfy。ComfyUIでそのまま読み込める形に整えられている
pupは生成器とは独立して動き、80GBのGPUでの測定では約28GBのGPUメモリを追加で使う。コンシューマGPUでは同時常駐が難しいため、pupを別処理にする、CPUオフロードにする、あるいはAPI側(アップサンプリング付き)を使うといった分担が現実的になる。
できること
- テキストから画像生成: ネイティブ4Kまで直接生成できる
- 画像編集: 公式が「ピクセルパーフェクト」と表現する編集で、指定した部分以外を保ったまま変更を加える
- マルチリファレンス生成: 最大10枚の参照画像を入力し、人物・商品・スタイルを組み合わせた画像を作る
- バウンディングボックス指定: [top, left, bottom, right] の形式で、0〜1000のグリッド上に要素の配置位置や編集範囲を指定できる
- LoRA学習: Ostris AI ToolkitとNVIDIA NeMo AutoModelが公式に案内されている
プロンプトの書き方にはコツがある。公式は、短い指示ではありふれた出力になりやすいので、シーン全体を説明するキャプション形式で書くよう勧めている。pupはこの書き換えを自動で行う部品である。
生成速度
公式発表の速度は、GPUと精度、ステップ数で大きく変わる。蒸留版(16ステップ)、INT8、1MP(約1メガピクセル)の条件では、RTX 5090で約4秒、RTX 4070で9秒未満(ComfyUI)とされている。
| 条件 | GPU | 時間 |
|---|---|---|
| 蒸留・INT8・1MP | RTX 5090 | 約4秒 |
| 蒸留・INT8・1MP | RTX 4070 | 9秒未満(ComfyUI) |
| 蒸留・1024x1024・16ステップ | GB300 | 0.55秒 |
| 蒸留・1024x1024・16ステップ | RTX 4070 | 8.9秒 |
| 蒸留・NVFP4・1MP | GB300 | 0.6秒未満 |
| Base・1024x1024・50ステップ | GB300 / DGX Station | 1.7秒 |
| Base・1024x1024・50ステップ | DGX Spark | 43.8秒 |
| BFL API(中央値・1MP) | クラウド | テキスト生成4.54秒、編集7.18秒 |
LoRAを適用した場合の追加時間は、GB300で約5%とされている。DGX Sparkのようなメモリ帯域が小さい環境では、Baseの50ステップは40秒を超える点に注意したい。日常用途にはステップ数の少ない蒸留版が向いている。
ベンチマークとFLUX.2 klein との違い
BFL社内の評価では、FLUX 3 Image Kleinはオープンウェイトモデルの中で、テキストから画像、マルチリファレンス、編集の3つすべてで1位とされている。クローズドモデルのIdeogram V4.5やFLUX.2 [pro]を上回る項目もあると発表されている。これは社内評価であり第三者による検証ではないため、自分の用途で比較してから採用を判断するのがよい。
- FLUX.2 [klein] 9Bとの比較: パラメータは38%少ないにもかかわらず、テキストから画像でElo +91、編集でElo +70の改善とされている
- Qwen-Image 2.1(7B)、Krea 2(12.9B)との比較: これらと並べても最小のモデルであり、サイズあたりの性能が売りになっている
インストールと使い方
対応環境は、ComfyUI、Hugging Face Diffusers、TensorRT-LLM、SGLang Diffusion、vLLM-Omniが初日から用意されている。個人で試すなら、導入が最も手軽なのはComfyUIである。
ComfyUIで使う
- ComfyUIを最新版に更新する
- Hugging Faceのgatedリポジトリ(black-forest-labs/flux-3-image-klein-comfy)でライセンスに同意し、ログインしてからモデルをダウンロードする
- 8GB級GPUならINT8版を選ぶ。VRAMに余裕があればFP8またはBF16を選ぶ
- 公式のテンプレートワークフローを読み込み、シーン全体を説明するプロンプトを入れて実行する
INT8版の具体的な配布ファイル名や配置ディレクトリは、公式のモデルカードとComfyUIのテンプレートで確認してほしい。バージョンによって変わる可能性があるため、本記事ではファイル名を断定しない。
Diffusersで使う
Diffusersは、PyPIのリリース版ではなくGitHubのmainブランチから導入する必要がある。以下は公式の案内に沿った最小の例である。
pip install git+https://github.com/huggingface/diffusers
huggingface-cli login
import torch
from diffusers import ModularPipeline
pipe = ModularPipeline.from_pretrained("black-forest-labs/flux-3-image-klein")
pipe.load_components(dtype=torch.bfloat16)
pipe.to("cuda")生成を呼び出す際の引数名など、上記以降の細部はモデルカードのサンプルコードを参照してほしい。ここでは公式案内で確認できた部分に限って示している。
リファレンスCLIで使う
公式リポジトリには、リファレンス用のCLIが用意されている。蒸留版でプロンプトから1枚生成する例は次のとおりである。
python scripts/cli.py '<prompt>' --model distilled --out out.png参照画像を使うときは --image オプションを指定する。リファレンスCLIにはNSFW分類器が含まれている。
ライセンスと商用利用の注意
ライセンスはFLUX Kommunity License v1.0である。非商用利用は認められている。商用の出力生成については、関連会社を含めた年間総収益が500万米ドル未満の事業者(Qualifying Users)であれば、規約の条件に従って認められる。それを超える事業者は、bfl.aiを通じて商用ライセンス(セルフホスト用ライセンスまたはAPI)を取得する必要がある。
- 年商の判定は関連会社を含む点に注意する
- Hugging Faceのリポジトリはgated(連絡先情報の共有への同意とログインが必要)
- 条件の細部は規約本文が正であり、社内利用か顧客への納品かといった個別の判断は、導入前に原文を読んで確認してほしい
- 安全面では、データセットのフィルタリング、ポストトレーニングでの微調整、外部パートナーCinderによるレッドチーミングが実施されたと説明されている
APIで使う場合
自前のGPUを用意しなくても、BFLのAPIでflux-3-image-kleinを使える。APIではプロンプトのアップサンプリングとピクセル復元が組み込まれており、ローカルでpupを動かす負担を避けられる。公式発表の開始価格は$0.009〜である(課金単位や解像度別の料金は、公式料金ページで要確認)。ほかに、PlaygroundとHugging Face Spacesでも試せる。
ローカル実行とAPIの使い分けは、利用頻度とデータの扱いで決めるとよい。社外に出せない画像を扱うならローカル、試作や低頻度の利用ならAPI、という整理が基本になる。
既存モデルとの違い
| モデル | パラメータ | 主な特徴 | ライセンス | ローカル最小VRAM目安 |
|---|---|---|---|---|
| FLUX 3 Image Klein | 5.6B(テキストエンコーダ除く) | 生成と編集、最大10枚参照、ネイティブ4K、バウンディングボックス | FLUX Kommunity License v1.0(年商500万ドル未満は商用出力可) | 8GB〜(INT8+ComfyUI) |
| FLUX.2 [klein] 9B | 9B | Kleinの前世代。FLUX 3 Image Kleinは38%少ないパラメータでElo +91(生成)、+70(編集) | — | — |
| Qwen-Image 2.1 | 約7B | 生成と編集の統合、透過PNG、10枚参照 | 非商用研究限定 | 公式未公開 |
| Krea 2 | 12.9B | — | — | — |
Qwen-Image 2.1の必要スペックについては、Qwen-Image-2.1 の必要スペックで整理している。ライセンス面では、Qwen-Image 2.1が非商用研究に限られるのに対し、FLUX 3 Image Kleinは年商500万ドル未満なら商用出力が認められる点が実務上の大きな違いになる。表で「—」としている欄は、公式情報で確認できなかった項目である。
トラブルシューティング
CUDA out of memoryが出る
- INT8版またはFP8版に切り替える
- ComfyUIやDiffusersのオフロード設定を有効にして、使わないコンポーネントをCPUメモリへ退避させる
- 生成解像度を下げる(まず1MP前後で試す)
- プロンプトアップサンプラー(pup)を同じGPUに載せない。pupは約28GBを追加で使うため、別処理にするかAPI側のアップサンプリングを使う
- 他のアプリがVRAMを占有していないか確認する
401エラーでモデルをダウンロードできない
Hugging Faceのリポジトリはgatedなので、ブラウザでモデルページを開いてライセンスと連絡先情報の共有に同意し、さらにコマンドラインでhuggingface-cli loginを実行してトークンを設定する必要がある。同意しただけではダウンロードできない。
Diffusersでクラスが見つからない
リリース版のDiffusersにはまだ対応コードが含まれていない。GitHubのmainブランチから導入し直すこと。ComfyUIも古い版では読み込めない場合があるため、最新版に更新する。
出力が単調になる
短い指示だと汎用的な絵になりやすい。被写体、構図、光、背景、質感を含むシーン全体の説明に書き直す。pupを使うと、この書き換えを自動化できる。
よくある質問
FLUX 3 Image Klein の必要VRAMはどれくらいですか。
構成によって大きく異なる。INT8版とComfyUIを使うとVRAM 8GBのGeForce RTXでも動作すると公式に発表されている。一方、リファレンスコードをオフロードなしで動かした場合の実測は、B200・1024x1024・アップサンプラーなしの条件でBF16が31GB、FP8が26GB、NVFP4が25GBである。pupを併用するとさらに約28GB加わる。
RTX 4060 8GBでも動きますか。
INT8版とComfyUIのメモリ管理を使えば、VRAM 8GBのRTX GPUで動作すると公式に発表されている。RTX 4060 8GBの個別の速度は公式未公開だが、RTX 4070で1MPあたり9秒未満という数字が示されている。8GB構成ではCPUメモリとの転送が発生するため、より遅くなることは見込んでおきたい。
Macで動かせますか。
Apple Siliconでの動作は公式に記載されておらず、MPSでの動作や速度も未検証である。公式が初日から対応を明示しているのは、ComfyUI、Diffusers、TensorRT-LLM、SGLang Diffusion、vLLM-Omniである。Macで使いたい場合は、APIの利用を検討するのが確実である。
商用利用はできますか。
FLUX Kommunity License v1.0のもとで、関連会社を含めた年間総収益が500万米ドル未満の事業者は、規約に従って商用の出力を生成できる。それを超える場合は、bfl.aiで商用ライセンス(セルフホストまたはAPI)を取得する必要がある。細部は規約本文で確認してほしい。
KleinとKlein Baseはどちらを使えばよいですか。
通常の画像生成と編集には、16ステップで速い蒸留版のKleinを使う。LoRA学習や微調整、研究には、非蒸留で50ステップのKlein Baseが向いている。ガイダンスは蒸留版が不要、Baseは3.5である。
プロンプトアップサンプラー(pup)は必須ですか。
モデルカードは、アップサンプラーなしでモデルを使わないよう案内している。ただしpupは別の9Bモデルで、ダウンロードが18.8GB、GPUメモリを約28GB追加で使う。ローカルで同居させにくい場合は、アップサンプリング付きで提供されているBFLのAPIを使う方法がある。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ