Index-Translate 必要スペック — VRAM2〜72GB・150言語翻訳
Index-Translateの必要VRAMは2Bで約2GB、9Bで約6GB、35B-A3Bで約21GBから(4bit時)。bilibili公開のApache 2.0・150言語対応の翻訳モデルを、NVIDIA GPU・Mac・CPU別のスペック目安と量子化、vLLMでの使い方まで解説。2026年10月更新。
Index-Translate(bilibili / IndexTeam)は、Qwen3.5をベースにした150言語対応のオープンウェイト翻訳モデル群で、必要メモリの目安は2Bで約2〜5GB、9Bで約6〜19GB、35B-A3Bで約21〜72GB(量子化次第)。2Bは8GBのGPUやMac、CPUでも動き、9Bは16GB GPUで実用的、35B-A3Bは4bit量子化なら24〜32GBのGPUやメモリ32GB以上のMacで動かせる。ライセンスはApache 2.0で商用利用も可能である(2026年10月時点)。
本記事は、必要スペックの早見表、量子化(GGUF/FP8/NVFP4)別のメモリ目安、NVIDIA GPU・Apple Silicon・CPUのそれぞれでの動かし方、ベンチマーク、vLLMでの使い方、他の翻訳手段との比較をまとめたものである。ローカルでの動かし方の基本は Qwen3.5 9Bのローカル導入ガイド も参考になる。メモリ量は公式の実測値ではなく、重みサイズから計算した目安である点に注意してほしい。
必要スペック早見表
| 項目 | 2B | 9B | 35B-A3B(preview) |
|---|---|---|---|
| 構造 | Dense | Dense | MoE(総35B/アクティブ3B) |
| BF16 | 約4〜5GB | 約18〜19GB | 約70〜72GB |
| FP8 | 約2.5GB | 約10GB | 約36〜38GB |
| 4bit(GGUF Q4_K_M) | 約1.5〜2GB | 約6GB | 約21〜23GB |
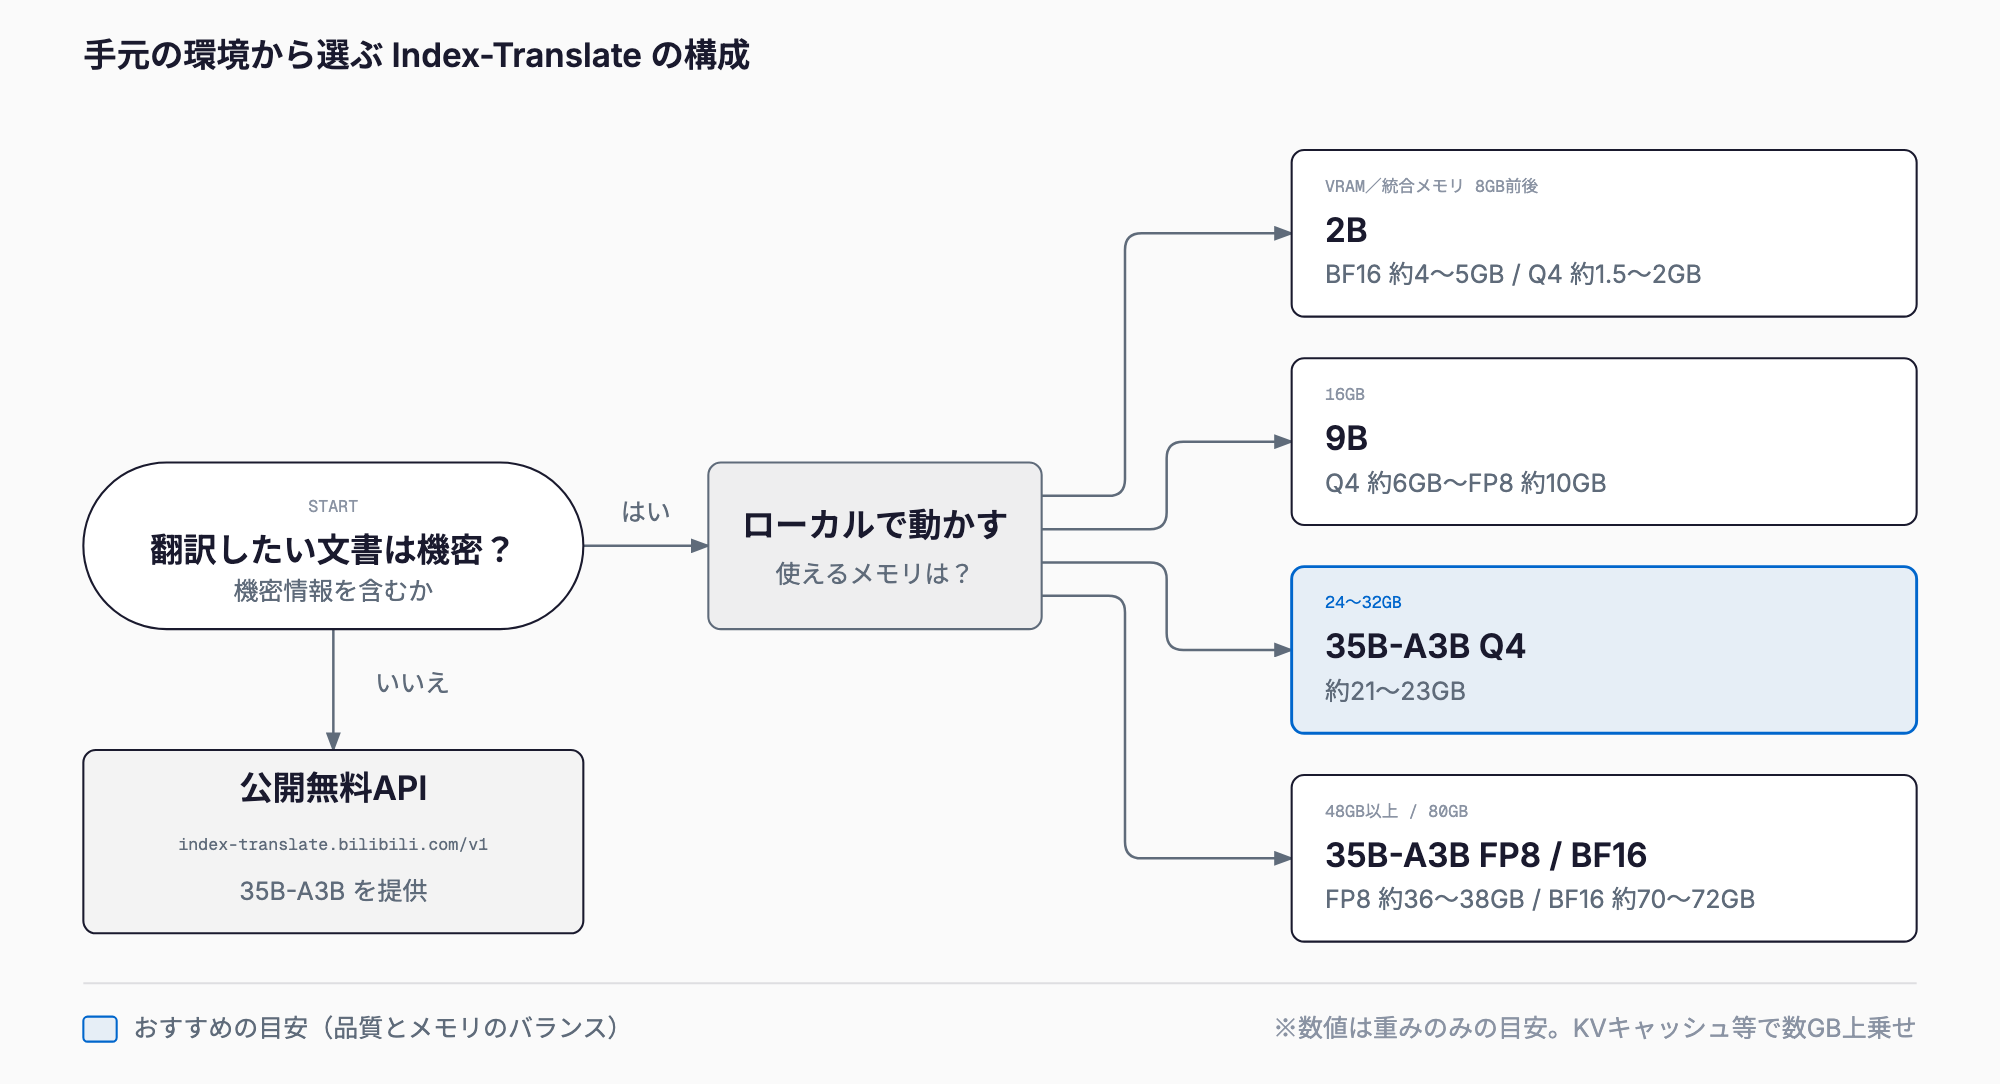
| 動かせる環境の目安 | 8GB GPU/Mac 8GB/CPU | 16GB GPU(Q4〜Q8)/Mac 16GB(Q4) | 24〜32GB GPU(Q4)/48GB級(FP8)/80GB(BF16) |
| コンテキスト長 | 32,768 | 32,768 | 最大262,144(推奨serve設定は32,768) |
| ライセンス | Apache 2.0 | Apache 2.0 | Apache 2.0 |
上の表は重みだけのメモリ目安(estimates)である。実際にはKVキャッシュと実行時のオーバーヘッドで数GB上乗せされ、コンテキストを長くするほど増える。余裕を見て、表の数値に2〜4GBほど足して考えるとよい。
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。Index-Translateの2B・9B・35B-A3Bもモデル一覧から選択できる。
Index-Translateとは — bilibiliの150言語翻訳モデル
Index-Translateは、動画プラットフォームbilibiliのIndex LLMチーム(IndexTeam)が公開した翻訳特化のオープンウェイトモデルである。Qwen3.5を土台に、2B・9B・35B-A3Bの3サイズが用意されている。GitHubは bilibili/Index-Translate、重みはHugging Face(IndexTeam/Index-Translate-35B-A3B-preview、IndexTeam/Index-Translate-9B、IndexTeam/Index-Translate-2B)とModelScopeで配布されている。
公開の流れは次のとおりである。2026年9月30日にテキスト翻訳の重み(2B/9B/35B-A3B preview)が公開され、10月3日に公式の量子化版(llama.cpp向けGGUF、vLLM向けFP8 W8A8とNVFP4 W4A4)が追加された。NVFP4はBlackwell世代のGPUを想定している。10月4日にはOpenAI互換の無料公開API(https://index-translate.bilibili.com/v1、35B-A3Bを提供)とベンチマークデータセットも公開された。
対応言語は日本語を含む150言語のテキスト翻訳。もう一つの特徴が「指示追従型の翻訳」で、用語集の強制や書式の維持といったハード制約と、文体・専門分野の曖昧さ解消・長さといったソフト制約をプロンプトで指定できる。同じファミリーには、音声翻訳(S2TT/S2ST、中国語と英語・日本語・スペイン語間)のIndex-Echo、Index-Homura、全文書翻訳向けのIndex-NativeLongもあるが、本記事ではテキスト翻訳の3モデルを扱う。
モデル別の詳細と選び方
Index-Translate-2B — どこでも動く軽量版
BF16でも4〜5GB程度、4bitなら2GB前後に収まるため、8GBのGPU、メモリ8GBのMac、さらにはCPUだけでも動かせる。一方でベンチマークは9B以上と差が大きく、WMT26のジャッジスコアは60.26と、9Bの75.35に15ポイント近く届かない。手元の端末や組み込み用途、下訳の速度重視で使うモデルと考えるのが妥当である。
Index-Translate-9B — 16GB GPUで実用的な中核サイズ
9Bは重みがBF16で約18〜19GB、FP8で約10GB、Q4_K_Mで約6GB。RTX 4060 Ti 16GBやRTX 5060 Ti 16GBならQ4〜Q8で余裕を持って動く。RTX 4090/5090(24/32GB)ならBF16も載るが、長いコンテキストではKVキャッシュで余裕がなくなるためFP8のほうが安心である。Macならメモリ16GBでQ4が現実的な下限になる。後述のとおり、FLORESの指標では35B-A3Bとほぼ並ぶ水準であり、コストパフォーマンスが高い。
Index-Translate-35B-A3B(preview) — MoEで大型の品質を軽く動かす
総パラメータ数は約35B(Hugging Faceのカードには約36Bと記載)、推論時に動くのは約3B分のみのMoE構成である。BF16の重みは約70〜72GBで、80GBのH100/A100、またはメモリ96〜128GBのMacが必要になる。FP8なら約36〜38GBで、RTX 6000 Ada(48GB)や24GB×2枚構成で動かせる。4bit GGUFなら約21〜23GBとなり、RTX 4090/5090や32GB以上のMacに載る。
MoEの利点は、メモリ容量は大きく要るが1トークンあたりの計算量は3B相当で済む点にある。そのため、VRAMに載り切らない分をCPU側のメモリに逃がすオフロード構成でも、同サイズのDenseモデルよりトークン速度を保ちやすい。なお、モデル名のとおり現時点はpreview版で、正式版で重みや性能が変わる可能性がある。最大位置埋め込みは262,144だが、推奨のserve設定は--max-model-len 32768、評価時の設定は16,384である。
量子化 — GGUF / FP8 / NVFP4
| 形式 | 主な用途 | 特徴 |
|---|---|---|
| BF16(元の重み) | 80GB級GPU、vLLM | 最高精度。35B-A3Bで約70GB超 |
| GGUF(Q4_K_Mなど) | llama.cpp、Mac、CPU/GPU混在 | 容量最小。オフロードしやすい |
| FP8 W8A8 | vLLM、Ada/Hopper以降のGPU | BF16の約半分で、品質の低下が小さい |
| NVFP4 W4A4 | vLLM、Blackwell世代GPU | 4bitで最小級。Blackwellを前提とする |
公式量子化版は10月3日に追加されたもので、自前でGGUFを作る必要はない。選び方の目安は、GPUが1枚でVRAMが限られるならGGUF、サーバーでvLLMを使うならFP8、Blackwell(RTX 50系やB200など)ならNVFP4である。翻訳は一語の誤りが目立つ用途なので、4bitで足りるかは自分の対象言語・文体で一度確かめたい。llama.cpp、vLLM、Ollamaの違いは ローカルLLM推論エンジン比較 にまとめられている。
Apple Siliconでの動かし方
Macはユニファイドメモリなので、GPU用に使えるメモリ量がそのままモデルの上限になる。実際はOSなどに使われるため、搭載メモリの7〜8割程度が目安である。メモリ16GBのMacなら9BのQ4(約6GB)が快適で、2BはどのMacでも動く。32GB以上なら35B-A3BのQ4(約21〜23GB)、96〜128GBならBF16(約70〜72GB)も視野に入る。MoEは3B分しか計算しないので、Mac上でも速度の落ち込みが比較的小さい。ツールはllama.cppのほか、GGUFに対応するLM StudioやOllamaが使える(Ollama vs LM Studio)。
NVIDIA GPUの目安
| GPU(VRAM) | 2B | 9B | 35B-A3B |
|---|---|---|---|
| 8GBクラス(RTX 4060等) | BF16可 | Q4が限界 | 不可(要オフロード) |
| 16GBクラス(RTX 4060 Ti 16GB/5060 Ti 16GB) | 余裕 | Q4〜Q8 | Q4+CPUオフロード |
| 24GB(RTX 4090) | 余裕 | BF16が窮屈/FP8可 | Q4(約21〜23GB、長文は厳しい) |
| 32GB(RTX 5090) | 余裕 | BF16可 | Q4(余裕あり) |
| 48GB級(RTX 6000 Ada、24GB×2) | 余裕 | 余裕 | FP8 |
| 80GB(H100/A100) | 余裕 | 余裕 | BF16 |
表はいずれも重みとKVキャッシュを合わせた目安であり、32,768トークンのコンテキストを使う前提では余裕を見ておく必要がある。翻訳は入力を段落ごとに区切って処理することが多く、実運用では長いコンテキストを使わない場面も多い。
CPUのみで動かす場合
2Bの4bit版であれば、GPUなしの一般的なノートPCでもllama.cppで動く。9Bも6GB程度なのでメモリ16GBのCPU環境で動かせるが、速度は遅くなる。35B-A3Bは重みが約21〜23GB(4bit)あるため、メモリ32GB以上のマシンが必要だが、アクティブが3BのMoEなので、同じメモリ量のDenseモデルよりはCPUでも現実的な速度が出やすい。VRAMに載せられない場合は、一部のレイヤーだけをGPUに置いて残りをCPUに置くオフロードも有効である。
予算別の構成例
- 数万円〜(既存PC・Mac): 2Bを4bitで。メモリ8GBあれば動く。下訳や簡易翻訳向け
- 10万円台(16GB GPU搭載PC、またはMac 16GB): 9Bを Q4〜Q8 で。最もバランスが良い
- 20〜40万円台(RTX 4090/5090、またはMac 32GB以上): 35B-A3Bを4bit GGUFで。品質重視のローカル運用
- 業務サーバー(48GB級GPU): 35B-A3BをFP8でvLLM配信。複数人で共有
- 80GB GPU(H100/A100): 35B-A3BをBF16で。精度優先の検証用途
ベンチマーク — 公式の数値と比較
以下はHugging Faceのモデルカードおよびリポジトリに掲載された数値で、ベンダー(bilibili)自身による報告値である。第三者の再現検証は本記事の時点では確認していない。
| 指標 | 35B-A3B(preview) | 9B | 2B |
|---|---|---|---|
| FLORES(COMET-22) | 0.8794 | 0.8789 | 0.8655 |
| WMT26(ジャッジ、100点満点) | 76.76 | 75.35 | 60.26 |
| instTrans Quality | 0.6901 | 0.6771 | 0.5391 |
| instTrans IFscore | 0.8336 | 0.8209 | 0.7569 |
| MEME | 0.7405 | 0.7387 | 0.6443 |
| 低リソース言語FLORES(COMET-22) | 0.8168 | — | — |
| off-target率(低リソース) | 2.4% | — | — |
リポジトリが示す比較対象では、GPT-5.6-SolのWMT26は89.10で、35B-A3Bの76.76を大きく上回る。つまり総合的な翻訳品質では、最上位のクローズドモデルにまだ明確な差がある。一方でMEME(ネットスラングや文化的表現)は35B-A3Bが0.7405、GPT-5.6-Solが0.7194と、特定の指標では上回っている。その他、Hy-MT2-7BのFLORESは0.8747、DeepSeek-V4.1-FlashのinstTrans Qualityは0.6068、Gemini 3.5 FlashのIFscoreは0.6374と報告されており、制約を守る能力は比較対象より高い。
読み取れる点は2つある。第一に、9BはFLORESとMEMEで35B-A3Bとほぼ並び、WMT26でも約1.4ポイント差にとどまる。コスト面では9Bが優位である。第二に、2Bは大きく劣るため、品質が必要な用途では選びにくい。
使い方 — vLLMでサーバーを立てる
推奨の推論設定は、貪欲デコーディング(temperature 0)、max_tokensは既定1,024、思考モードは無効化する。vLLMでの起動例は次のとおり。
pip install -U vllm

vllm serve IndexTeam/Index-Translate-35B-A3B-preview \
  --served-model-name IndexTeam/Index-Translate-35B-A3B-preview \
  --host 127.0.0.1 --port 8000 \
  --max-model-len 32768
起動後はOpenAI互換のクライアントから呼べる。思考モードのオフは、extra_bodyでchat_template_kwargsにenable_thinking=Falseを渡す。
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")

prompt = (
    "请将以下日语文本翻译为英语,直接输出翻译结果,不要进行任何解释。\n"
    "本製品は防水仕様ですが、水没には対応していません。"
)

resp = client.chat.completions.create(
    model="IndexTeam/Index-Translate-35B-A3B-preview",
    messages=[{"role": "user", "content": prompt}],
    temperature=0,
    max_tokens=1024,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}},
)
print(resp.choices[0].message.content)
リポジトリ付属のCLIを使う方法もある。
python inference/llm/translate.py "本製品は防水仕様です。" --target en \
  --model IndexTeam/Index-Translate-35B-A3B-preview
プロンプトの書式(中国語テンプレート)
公式のプロンプトテンプレートは中国語で書かれている。通常の翻訳は次の形式で、{source}と{target}に言語名、{text}に原文を入れる。
请将以下{source}文本翻译为{target},直接输出翻译结果,不要进行任何解释。
{text}
用語集や書式などの制約を付ける場合は、【源文】と【约束要求】の形式を使い、ハード制約は番号付きの【硬性要求】として列挙する。以下は書式の骨格を示した例で、制約の文言は用途に合わせて書き換える。
【源文】
{text}

【约束要求】
【硬性要求】
1. {constraint_1}
2. {constraint_2}
请将以上源文翻译为{target}。
無料公開APIを使う場合の注意
10月4日から、OpenAI互換の無料APIが https://index-translate.bilibili.com/v1 で提供されている(35B-A3Bを提供)。クライアントのbase_urlをこのURLに変えるだけで試せる。ただしレート制限や利用規約の詳細は、現時点で十分に公開されていない。外部の公開エンドポイントに送った文章がどう扱われるかは保証されないため、機密文書や個人情報を含む原稿は送らず、そうした用途ではローカルで動かすのが安全である。
他の翻訳手段との比較
| 手段 | 重み公開 | ローカル/オフライン | 用語集による制約 | コスト |
|---|---|---|---|---|
| Index-Translate | あり(Apache 2.0) | 可能 | プロンプトで指定(ハード/ソフト制約) | 自前のGPU・電気代。公開APIは無料 |
| DeepL API | なし(クローズドSaaS) | 不可 | 用語集機能あり | 従量課金(プランによる) |
| Google Cloud Translation | なし | 不可 | 用語集機能あり | 文字数あたりの従量課金 |
| GPT-5.6-Sol等の汎用LLM API | なし | 不可 | プロンプトで指定 | トークン従量課金 |
| Tencent Hy-MT2-7B | あり | 可能 | モデル依存 | 自前のGPU・電気代 |
使い分けの考え方は次のとおり。最高品質が必要で機密性が問題にならないなら、GPT-5.6-Solのような最上位APIが有利である(WMT26で89.10)。原稿を外に出せない、大量処理でAPI費用が膨らむ、用語を厳密に守らせたい、といった場合にIndex-Translateのローカル運用が合う。DeepLやGoogleは安定した運用品質と、用語集などの管理機能が手軽な点が強みである。
トラブルシューティング
- OOM(メモリ不足): --max-model-lenを下げる(32768→16384)、FP8やGGUFの量子化版に切り替える、9B以下のモデルにする。vLLMではgpu-memory-utilizationの調整も有効
- 中国語が混ざって出力される: テンプレートが中国語のため、{target}を必ず明示し、プロンプトで目標言語を英語や日本語など具体名で指定する。低リソース言語ではoff-target(目的外の言語での出力)が2.4%報告されているため、後処理で言語判定を入れると安心
- 長い思考文が出力される・遅い: enable_thinking=Falseを必ず渡す。temperature 0(貪欲デコーディング)にする
- 制約が複数あると守られない: カード自身が、制約の組み合わせと低リソース言語は難しいと述べている。制約を減らすか、翻訳後に用語を検証するスクリプトを挟む
- 品質が想定より低い: previewである点、2Bは品質が大きく下がる点を踏まえ、9B以上を試す
まとめ
Index-Translateは、Apache 2.0の150言語対応翻訳モデルで、2Bから35B-A3Bまで手元の環境に合わせて選べる。9Bは16GB GPUで動き品質も高く、35B-A3Bは4bitなら24〜32GB GPUで動かせる。品質の天井ではGPT-5.6-Solに及ばないが、用語や書式の制約を指定でき、機密文書をローカルで処理できる点に価値がある。まずは9Bの量子化版で自分の原稿との相性を確かめるのがよい。
よくある質問
Index-Translateを動かすのに最低限必要なメモリはどれくらいですか。
2Bの4bit GGUFなら重みは約1.5〜2GBで、メモリ8GBのPCやMac、CPUのみの環境でも動きます。ただし数値は重みだけの目安で、KVキャッシュなどで数GB上乗せされます。
RTX 4090(24GB)で35B-A3Bは動きますか。
4bit GGUF(約21〜23GB)なら載りますが、余裕は小さく、長いコンテキストでは厳しくなります。MoEで3B分しか計算しないため速度は出やすく、VRAMが足りない分をCPUにオフロードする構成も使えます。
日本語の翻訳に使えますか。
150言語の対象に日本語が含まれています。ただしプロンプトテンプレートは中国語なので、{target}に目的言語を明示し、別の言語が混ざらないか確認してください。
商用利用できますか。
ライセンスはApache 2.0で、商用利用が可能です。ただしベースのQwen3.5を含め、利用前に各リポジトリのライセンス表記を確認してください。
公開APIに機密文書を送ってよいですか。
推奨しません。レート制限や利用規約、データの取り扱いが詳しく公開されていないため、機密文書や個人情報はローカルで動かしたモデルで処理するのが安全です。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ