MiMo-V2.6 必要スペック早見表
Flash 309Bは4bitで約180GB / Pro 1TはVRAM約580GB【全モデル・2026年版】
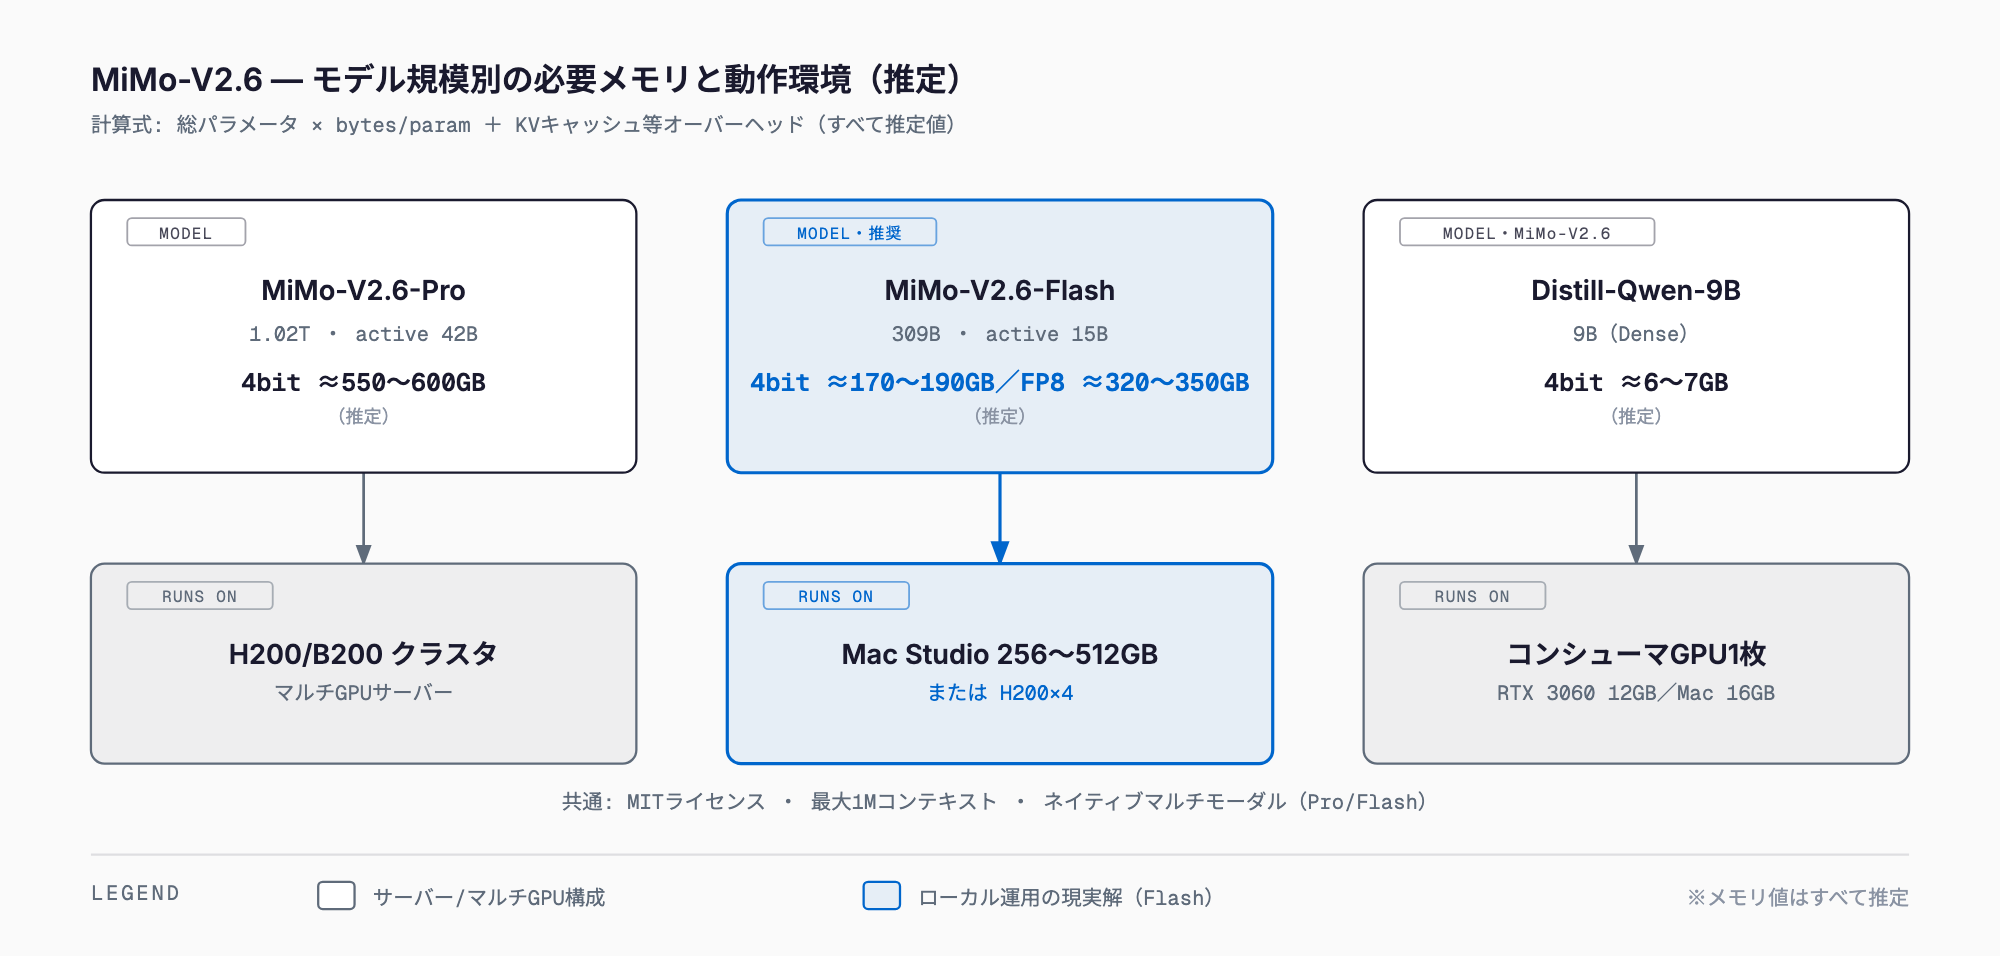
MiMo-V2.6はFlashが4bitで約170〜190GB・FP8で約320〜350GB、Proは4bitでも約550〜600GB、9B蒸留版は4bitで約6〜7GBが目安(推定)。2026年9月22日にXiaomiが公開したMITライセンス全3モデルの構成・ベンチマーク・料金・他モデル比較を整理した。
Xiaomi(小米)のMiMoチームが2026年9月22日に公開したMiMo-V2.6シリーズをローカルで動かす場合、モデルによって必要なメモリは大きく異なる。結論から言うと、総パラメータ309B・アクティブ15BのMiMo-V2.6-Flashは4bit量子化で約170〜190GB、FP8で約320〜350GBが目安(推定)。総パラメータ1.02T・アクティブ42BのMiMo-V2.6-Proは4bit量子化でも約550〜600GBが必要になる(推定)。一方、9BのMiMo-V2.6-Distill-Qwen-9Bなら4bit量子化で約6〜7GBに収まり、コンシューマ向けGPU1枚でも動作が視野に入る。
以下の数値はすべて推定値である。計算式は「総パラメータ数×bytes/param+KVキャッシュ等のオーバーヘッド(目安5〜15%)」。bytes/paramはBF16=2、FP8=1、4bit(INT4/GGUF Q4系)=0.5として概算している。MiMo-V2.6-ProとFlashはいずれもMoE(Mixture of Experts)構成で、1トークンの計算に使うアクティブパラメータ(Proは42B、Flashは15B)は総パラメータよりはるかに少ないが、次にどの専門家(エキスパート)が選ばれるかは入力次第で変わるため、メモリ容量の見積もりは総パラメータ数を基準にするのが実務上は妥当である。1Mトークンという長いコンテキスト長を使う場合はKVキャッシュの消費が別途上乗せされる点にも注意したい。
必要スペック早見表(推定)
| モデル | 量子化 | 推定メモリ | GPU構成の例 | Macで動くか |
|---|---|---|---|---|
| MiMo-V2.6-Pro(1.02T/アクティブ42B) | BF16 | 約2,100〜2,200GB | H200 141GB×16枚クラス / B200 192GB×12枚クラス | 不可(大幅に超過) |
| MiMo-V2.6-Pro(1.02T/アクティブ42B) | FP8 | 約1,050〜1,100GB | H200 141GB×8枚クラス(公式SGLang例はtp16・dp2の大規模構成) | 不可(512GBを大幅超過) |
| MiMo-V2.6-Pro(1.02T/アクティブ42B) | 4bit | 約550〜600GB | H100 80GB×8枚 / H200 141GB×5枚クラス | 条件次第(複数Mac Studioの分散推論なら可能性あり、推定) |
| MiMo-V2.6-Flash(309B/アクティブ15B) | BF16 | 約640〜680GB | H100 80GB×9枚 / H200 141GB×5枚クラス | 不可(512GBを超過) |
| MiMo-V2.6-Flash(309B/アクティブ15B) | FP8 | 約320〜350GB | H100 80GB×5枚 / H200 141GB×4枚(公式vLLM例はtp4・gpu-memory-utilization 0.95) | 条件次第(512GBぎりぎり、余裕は小さい) |
| MiMo-V2.6-Flash(309B/アクティブ15B) | 4bit〜2-3bit(GGUF等コミュニティ変換) | 約110〜190GB | GPU1〜2枚、または統合メモリ機 | Mac Studio 192GB/256GBクラスで動作の可能性あり(推定・品質は要検証) |
| MiMo-V2.6-Distill-Qwen-9B | BF16 | 約18〜20GB | RTX 4090 24GB×1枚など | Mac 32GBクラスで可 |
| MiMo-V2.6-Distill-Qwen-9B | 4bit | 約6〜7GB | RTX 4060 Ti 16GB / RTX 3060 12GB | Mac 16GBクラスで可 |
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。MiMo-V2.6のFlash・Pro・9B蒸留版もモデル一覧から選択できる。
MiMo-V2.6とは
MiMo-V2.6は、Xiaomi(小米)のMiMoチームが2026年9月22日に公開した大規模言語モデルシリーズである。同時に3つのモデルが公開された。MoE(Mixture of Experts)構成の大型モデルであるMiMo-V2.6-Pro(総パラメータ1.02T、アクティブ42B)、同じくMoE構成でより軽量なMiMo-V2.6-Flash(総パラメータ309B、アクティブ15B)、そしてQwen3.5-9Bをベースにした9Bの蒸留モデルMiMo-V2.6-Distill-Qwen-9Bの3種類である。いずれもライセンスはMITで、重み本体に加えて技術レポート、7,000件を超えるRLタスク環境、エンドツーエンドのRLフレームワーク、ミニハーネス群も合わせてオープンソース化されている点が特徴だ。Hugging Faceのリポジトリはそれぞれ XiaomiMiMo/MiMo-V2.6-Pro-RL、XiaomiMiMo/MiMo-V2.6-Flash-RL、XiaomiMiMo/MiMo-V2.6-Distill-Qwen-9B として公開されている。
Pro・Flashはいずれもテキスト・画像・動画・音声を扱うネイティブなマルチモーダル構成で、681MパラメータのMiMo ViT視覚エンコーダ、308MパラメータのAudioTokenizerと127Mパラメータの音声パッチエンコーダを共有している。コンテキスト長は両モデルとも最大1Mトークン、出力トークンは最大128Kまで対応する。重みはBF16とFP8(F8_E4M3形式)の両方が配布されており、公式のデプロイ例としてSGLangは--tp 16 --dp 2 --ep 16というマルチノード構成、vLLMは--tensor-parallel-size 8が示されている。
基本情報
| 項目 | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Distill-Qwen-9B |
|---|---|---|---|
| 総パラメータ | 1.02T | 309B(VentureBeat報道では約310B) | 9B |
| アクティブパラメータ | 42B | 15B | 9B(フル稠密) |
| MoE構成 | ルーティングエキスパート384、8個をアクティブ化 | ルーティングエキスパート256、8個をアクティブ化 | 該当なし(Denseモデル) |
| レイヤー構成 | 70層(スライディングウィンドウ60+グローバル10) | 48層(スライディングウィンドウ39+グローバル9、hidden 4096) | Qwen3.5-9Bベース |
| コンテキスト長 | 最大1M | 最大1M | 未確認(ベースのQwen3.5-9B準拠) |
| 出力トークン上限 | 最大128K | 最大128K | 未確認 |
| 特徴的な仕組み | ネイティブマルチモーダル(681M ViT+308M AudioTokenizer+127M音声パッチエンコーダ) | Proと同じマルチモーダルエンコーダ+5層構成のMulti-Token Prediction(7トークン先まで予測、投機的デコーディング用) | MiMo生成トラジェクトリ(77.4Bトークン)でSFT |
| 重み形式 | BF16 / FP8(F8_E4M3) | BF16 / FP8(F8_E4M3)+コミュニティGGUF等約19種確認 | 未確認 |
| ライセンス | MIT | MIT | MIT |
| 公式推論エンジン例 | SGLang --tp 16 --dp 2 --ep 16(マルチノード) | SGLang tp=8 dp=2 / vLLM --tensor-parallel-size 4 --gpu-memory-utilization 0.95 | 未確認 |
ベンチマーク
以下はXiaomi MiMoチームによる自己申告(ベンダー報告)のベンチマークで、第三者機関の独立検証を経たものではない。
| ベンチマーク | Pro | Flash | 備考 |
|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | Claude Opus 5がなお上回るとの報道あり |
| Terminal Bench 2.1 | 89.9 | 87.6 | Claude Opus 5はTerminal Bench 4.0で上回るとの報道あり |
| Toolathlon-Verified | 76.9 | 73.6 | — |
| AutomationBench | 53.1 | 52.3 | — |
| CyberGym | 94.0 | 95.1 | Flashが上回る珍しいケース |
| OSWorld-Verified | 82.0 | 未確認 | Proのみ報告 |
9B蒸留版のDistill-Qwen-9Bについてはエージェント系タスクの数値が公開されている。
| ベンチマーク | スコア |
|---|---|
| SWE-bench Verified | 61.1 |
| SWE-bench Pro | 44.6 |
| Terminal Bench 2.1 | 37.1 |
| AutomationBench | 30.3 |
第三者評価機関Artificial Analysisの「Intelligence Index」では、MiMo-V2.6-Proが46点でオープンウェイトモデルの最高水準となり、Grok 4.7と並んだと報告されている。比較として、DeepSeek V4.1 Flashは39点、DeepSeek V4.1 Proは36点(いずれも同機関による第三者評価)である。
API料金
| モデル | 入力(1Mトークンあたり・キャッシュミス想定) | 出力(1Mトークンあたり) |
|---|---|---|
| MiMo-V2.6-Pro | $0.435 | $0.87 |
| MiMo-V2.6-Flash | $0.14 | $0.28 |
キャッシュヒット時はさらに単価が下がる。自前ホストとAPI利用の損益分岐は、①GPU調達・電力・運用人件費などの固定費、②月間トークン処理量、③データ主権やレイテンシ要件、の3点で決まる。ProはFP8だけで1TB超のメモリを要するため、よほど継続的な大量利用が見込めない限りAPI利用の方が総コストで有利になりやすい。一方Flashは4bitならH100クラス数枚〜1台の大容量ワークステーションでも扱える規模のため、月間処理量が大きく継続利用が確実な場合には自前ホストのコスト優位が出やすい。9B蒸留版はコンシューマGPU1枚で完結するため、開発・検証段階ではローカル実行、本番運用ではAPIとの併用を検討する、といった使い分けが現実的だろう。
Flashをローカルで動かす現実的な構成
MiMo-V2.6-Flashは総パラメータ309Bながらアクティブパラメータは15Bと小さいため、量子化次第では現実的な個人〜小規模チーム向け構成でも動かせる可能性がある。FP8(約320〜350GB推定)であれば、公式のvLLM例に近いH100 80GB×4〜5枚、またはH200 141GB×4枚(--tensor-parallel-size 4 --gpu-memory-utilization 0.95)で動作させられる計算になる。SGLangの公式例ではtp=8・dp=2という設定も示されており、スループット重視かレイテンシ重視かで構成を変える余地がある。
4bit量子化(約170〜190GB推定)まで下げれば、統合メモリ256GBまたは512GBのMac Studio級のワークステーションが候補に入る(推定・実測未確認)。すでにHugging Face上にはllama.cpp・Ollama・LM Studioなどで扱えるGGUF形式を中心に、コミュニティによる量子化バリエーションが19種類ほど確認できる状態であり、2〜3bit級までさらに圧縮すれば約110〜130GB(推定)となり、統合メモリ128GBクラスのMacやDGX Spark、Ryzen AI Max搭載機でも動作の可能性が出てくる。ただし2〜3bit級の量子化は応答品質の劣化が避けられないため、実運用ではまずFP8か4bitでの品質を基準に、圧縮度合いとのトレードオフを見極める必要がある。アクティブパラメータが15Bと小さい設計のため、統合メモリ機でもトークン生成速度は比較的確保しやすいと考えられるが、具体的な数値は未確認である。
1Mトークンという長いコンテキストを使う場合は、上記の重み容量に加えてKVキャッシュの消費が別途発生する。MiMo-V2.6は70層(Pro)・48層(Flash)のうち大半をスライディングウィンドウアテンション(SWA)が占める設計のため、全層がフルアテンションのモデルに比べればKVキャッシュの増加は抑えられる設計だが、1M級のコンテキストを本当に使い切る場合はそれでも無視できない容量になる点は覚えておきたい。
Distill-Qwen-9Bの使いどころ
MiMo-V2.6-Distill-Qwen-9Bは、ベースモデルQwen3.5-9Bに対して、MiMo-V2.6が生成した77.4Bトークン分のトラジェクトリでSFT(教師ありファインチューニング)を施したモデルである。エージェント型RLの出発点として研究向けに公開されたもので、SWE-bench Verified 61.1、SWE-bench Pro 44.6、Terminal Bench 2.1 37.1、AutomationBench 30.3という、9Bクラスとしては高めのエージェントベンチマークスコアを持つ。BF16で約18〜20GB(推定)とRTX 4090 24GB1枚に収まる規模で、4bit量子化なら約6〜7GB(推定)までさらに小さくなり、RTX 4060 Ti 16GBやRTX 3060 12GB、あるいはメモリ16GBクラスのMacでも動作が見込める。ProやFlashをフルスペックで動かす環境がなくても、エージェント型タスクの挙動やRLパイプラインの検証を手元で始めたい場合の入り口として位置づけられるモデルだ。
他の大型オープンウェイトMoEとの比較
同時期に話題になっている大型オープンウェイトMoEモデルと並べると、MiMo-V2.6の位置づけが分かりやすい。数値は各モデルの公式発表・当サイトの既存記事で確認済みのものに限定し、未確認の項目は「未確認」と明記する。
| モデル | 総パラメータ | アクティブパラメータ | コンテキスト長 | ライセンス | 4bit時の推定メモリ目安 |
|---|---|---|---|---|---|
| MiMo-V2.6-Pro | 1.02T | 42B | 1M | MIT | 約550〜600GB |
| MiMo-V2.6-Flash | 309B | 15B | 1M | MIT | 約170〜190GB |
| DeepSeek V4.1-Flash | 552B | prefill 8B / decode 16B | 1M | 未確認(記事準拠) | 約320GB(記事準拠、必要VRAM+15%込み) |
| Kimi K3 | 2.8T | 約50B相当(報告値に幅あり) | 1,048,576(1M) | 修正MIT系(配布物のLICENSE要確認) | 約1.4TB(MXFP4配布のため8bit級、単純な4bit換算ではない) |
| Atria Dawn Preview | 744B | 公式は未公表 | 256K | MIT | 約400GB |
総パラメータで見るとMiMo-V2.6-Proの1.02Tはこの中で最大級だが、アクティブパラメータ42Bという設計はDeepSeek V4.1-Flashのdecode時16BやAtria Dawn Previewの規模感と比べても大きい部類に入る。一方MiMo-V2.6-Flashはアクティブ15Bと軽量寄りで、総パラメータの近いAtria Dawn Preview(744B)よりも推定メモリは小さく収まる。Kimi K3は総パラメータ2.8Tと突出しているが公式配布がMXFP4のため、他モデルの「4bit」とは前提が異なる点に注意したい。ベンチマーク面では、Artificial Analysis Intelligence IndexでMiMo-V2.6-Pro(46点)がDeepSeek V4.1 Flash(39点)・DeepSeek V4.1 Pro(36点)を上回ったと報告されている。
トラブルシューティング — メモリ不足・1Mコンテキスト時のKV
- OOM(メモリ不足)が出る場合: まずコンテキスト長を短く設定し直し、KVキャッシュの消費を抑えてから重み本体が載るかを切り分ける
- FP8でギリギリ載らない場合: --gpu-memory-utilizationを公式vLLM例の0.95より下げると起動はしやすくなるが、実効コンテキスト長やバッチサイズは犠牲になる
- マルチノード構成(SGLang tp16/dp2等)でエラーになる場合: ノード間通信(NVLink/InfiniBand等)の帯域がボトルネックになりやすいため、まず単一ノードでの動作確認を先に済ませる
- 1Mトークン級の長文コンテキストで急にメモリが増える場合: SWA主体の設計でも上限は有限であるため、実際に使うコンテキスト長を見積もった上でKVキャッシュ分の余裕を重み容量とは別に確保する
- コミュニティ量子化(GGUF等)の動作が不安定な場合: マルチモーダル対応が本家より遅れている、または未対応のことがあるため、テキスト専用での動作確認を先に行う
注意点
- ベンダー報告ベンチマーク: 本稿で紹介したPro・Flashの性能比較数値はXiaomi MiMoチームによる自己申告であり、第三者機関の独立検証を経ていない
- メモリ見積もりはすべて推定: 「総パラメータ×bytes/param+オーバーヘッド」という簡易計算式によるものであり、実際の消費量は推論エンジンやバッチサイズ、コンテキスト長次第で変動する
- コミュニティ量子化の品質: GGUF等の低ビット量子化は応答品質が公式チェックポイントより劣化する可能性があり、特に2〜3bit級では実用性を事前に検証すべき
- マルチモーダル対応の遅れ: llama.cpp等のコミュニティランタイムでは、公式のビジョン・音声エンコーダへの対応が遅れる、またはテキストのみのサポートにとどまる場合がある
- Distill-Qwen-9Bの位置づけ: 研究・実験用の出発点として公開されたモデルであり、Pro・Flashと同水準の総合性能を期待するものではない
FAQ
MiMo-V2.6はどこの誰が作ったモデルか。
Xiaomi(小米)のMiMoチームが2026年9月22日に公開した大規模言語モデルシリーズである。MoE構成の大型モデルMiMo-V2.6-Pro(1.02T/アクティブ42B)、軽量版のMiMo-V2.6-Flash(309B/アクティブ15B)、Qwen3.5-9Bベースの蒸留モデルMiMo-V2.6-Distill-Qwen-9Bの3種類が同時公開され、いずれもMITライセンスである。
Proをローカルで動かすにはどれくらいのメモリが必要か。
推定値だが、BF16フル精度で約2,100〜2,200GB、FP8で約1,050〜1,100GB、4bit量子化でも約550〜600GBが目安になる。いずれも複数枚のH100/H200/B200級GPUを束ねたマルチノード構成が前提で、個人のワークステーション1台では現実的ではない。
FlashはMac Studioで動くか。
4bit量子化(約170〜190GB推定)であれば、統合メモリ256GBまたは512GBクラスのMac Studioで動作する可能性がある。さらに2〜3bit級まで圧縮すれば約110〜130GB(推定)となり128GBクラスの機体でも候補に入るが、いずれも応答品質とのトレードオフがあり、実測での検証はできていない。
MiMo-V2.6-Proの性能は他のオープンウェイトモデルと比べてどうか。
第三者評価機関Artificial AnalysisのIntelligence IndexでMiMo-V2.6-Proが46点を記録し、Grok 4.7と並んでオープンウェイトモデルの最高水準になったと報告されている。同機関の評価ではDeepSeek V4.1 Flashが39点、DeepSeek V4.1 Proが36点で、これらを上回る結果となっている。ただしベンダー独自のベンチマーク(DeepSWE v1.1やTerminal Bench 2.1など)は自己申告値である点には注意したい。
API利用と自前ホスト、どちらを選ぶべきか。
MiMo-V2.6-Proは入力$0.435・出力$0.87(100万トークンあたり)、Flashは入力$0.14・出力$0.28と公表されている。Proは自前ホストにFP8だけで1TB超のメモリが必要になるため、継続的な大量利用が確実でない限りAPI利用の方が総コストで有利になりやすい。Flashは4bit量子化ならGPUサーバー数枚や大容量ワークステーションでも扱える規模のため、月間処理量と運用体制次第では自前ホストの優位が出てくる。
まとめ
MiMo-V2.6は、Xiaomi MiMoチームが2026年9月22日に公開した、1.02TのMoEモデルMiMo-V2.6-Pro、309BのMiMo-V2.6-Flash、9BのDistill-Qwen-9Bという3段構成のオープンウェイトシリーズだ。ローカルで動かす場合の目安は、Flashが4bitで約170〜190GB・FP8で約320〜350GB、Proが4bitでも約550〜600GB、9B蒸留版は4bitで約6〜7GBといずれも推定値ながら、モデルごとに必要な計算資源の桁が大きく異なる。ベンチマークはベンダー報告値が中心だが、第三者評価のArtificial Analysis Intelligence IndexでProがオープンウェイト最高水準の46点を記録した点は参考になる。同時期の大型オープンMoEモデルとの比較はDeepSeek V4.1-Flash、Kimi K3、Atria Dawn Previewの各記事も参照してほしい。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ