Mistral Large 4 必要スペック早見表
1T MoE(FP8実測約1.06TB・NVFP4約610GB・B200×4〜)
Mistral Large 4の重みは実測でFP8約1,060.6GB・NVFP4約610.0GB(総1T・アクティブ49B・コンテキスト1M)。B200×4やH200×8での可否、ライセンスの商用条件、Macでの目安、API料金(入力$0.70・出力$2.10)との費用比較まで整理。2026年10月31日更新。
Mistral AIのフラッグシップ「Mistral Large 4」(愛称Le Chonk)のオープンウェイトが、2026年10月29日にHugging Faceで公開された。公式チェックポイントの実サイズはFP8が約1,060.6GB、NVFP4が約610.0GBで、重みだけでこの容量が要る。総パラメータ約1兆(1T)・アクティブ49B(埋め込み層などを含めると52B)のMoEで、テキストと画像を入力できる。個人のPCで動かす規模ではなく、現実的な選択肢はAPI、B200×4(NVFP4)、またはH200×8(FP8、余裕は小さい)のサーバーになる。
公式リポジトリはFP8版(mistralai/Mistral-Large-4-1T-A52B)とNVFP4版(同-NVFP4)の2つ。NVFP4はBlackwell世代(B200・B300・GB200・GB300)向けで、モデルカードはFP8と同等の性能と説明している。ライセンスはMistral Ecosystem Open-Weight License(修正版MIT)で、商用・非商用とも利用できるが、Model as a Service事業を営む場合はMistralとの別途商用ライセンスが要る。コンテキスト長は1M(1,048,576)トークンだ。本稿は2026年10月7日の公開時には推定値で書いていたが、10月31日にモデルカード・設定ファイル・ファイルサイズの実測値へ更新した。いまも推定のままの項目は「推定」と明記している。
必要スペック早見表(公式チェックポイントの実サイズ)
FP8・NVFP4の容量は、Hugging Face上の各リポジトリのsafetensorsファイルのサイズ合計(10億バイト=1GB換算)だ。ビジョンエンコーダーと投機的デコード用のドラフトヘッドも含まれる。BF16と各種GGUFは公式ではなくggml-orgとUnslothが公開している変換版のファイル実測で、公式のBF16チェックポイントは見当たらない。右の列は、vLLM公式手順の--gpu-memory-utilization 0.85で使う場合に必要な合計VRAMの当サイト試算(重み÷0.85)で、KVキャッシュなどはこの余白に収める前提だ。
| 形式 | 配布元 | 重みのみ(実測) | 0.85運用時の必要合計VRAM(試算) | 備考 |
|---|---|---|---|---|
| BF16(GGUF) | ggml-org・Unsloth(変換版) | 約2,098.9GB | 約2,470GB | 公式BF16はなし。研究用途以外は非現実的 |
| Q8_0(GGUF) | ggml-org・Unsloth(変換版) | 約1,115.2GB | 約1,312GB | ほぼ無劣化とされる8bit |
| FP8 | Mistral公式 | 約1,060.6GB(987.7GiB) | 約1,248GB | 公式の基準精度(54ファイル) |
| Q4_K_M(GGUF) | ggml-org(変換版) | 約634.8GB | 約747GB | llama.cpp向けの4bit級 |
| NVFP4(GGUF) | ggml-org(変換版) | 約619.4GB | 約729GB | 公式NVFP4のGGUF版 |
| NVFP4 | Mistral公式 | 約610.0GB(568.1GiB) | 約718GB | Blackwell向け(32ファイル) |
| Q2_K(GGUF) | ggml-org(変換版) | 約380.7GB | 約448GB | 2bit級、品質低下は大きい |
| IQ2_XXS(GGUF) | ggml-org(変換版) | 約297.7GB | 約350GB | 2bit未満級、Mac 512GB向けの下限候補 |
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。Mistral Large 4もモデル一覧から選択できる。
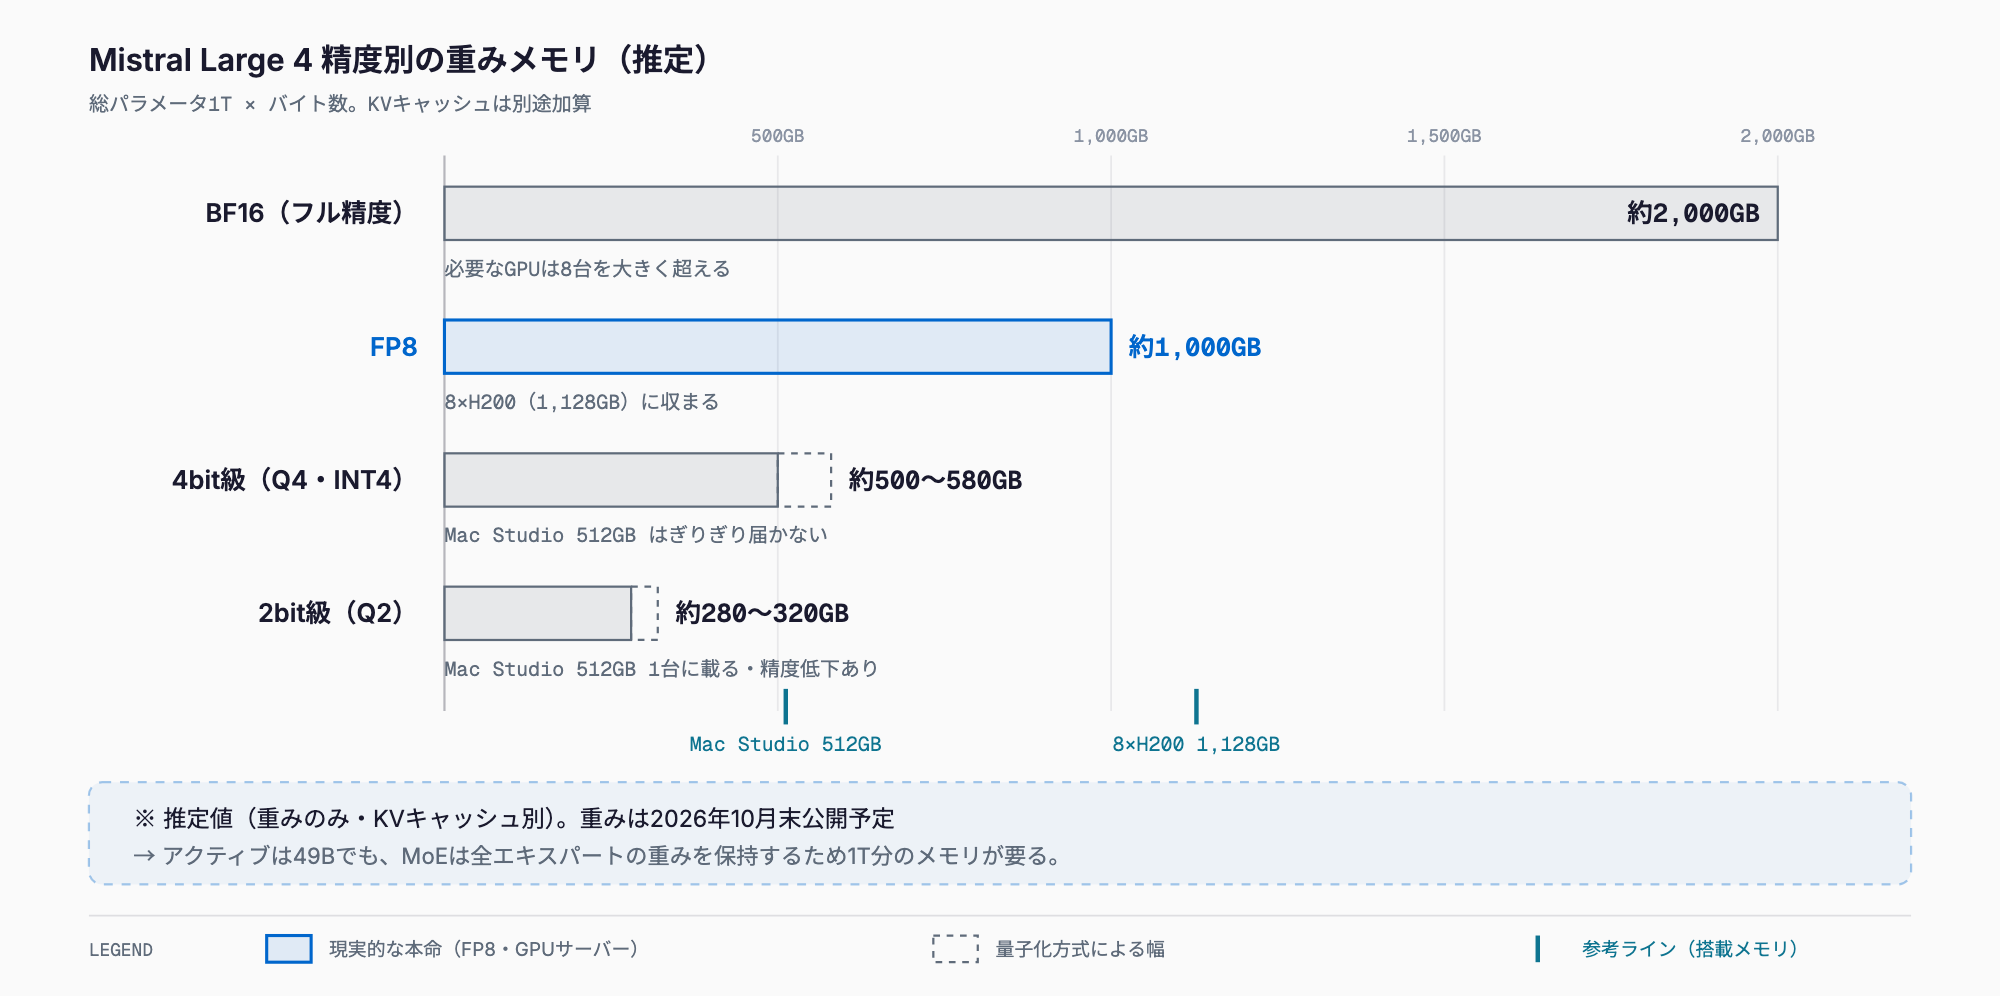
NVFP4が約610GBと、一律4bitの理論値(約500GB)より大きいのは、モデルカードによればエキスパートのみをNVFP4にし、線形層はFP8のままにしているためだ。コンテキストを長く使うほど、KVキャッシュがこの表に上乗せされる。config.jsonから計算すると、このモデルはMLA(KV圧縮)方式で、1トークン・1層あたりのキャッシュは(KV LoRAランク512+RoPE次元64)=576要素になる。KVを共有する層があり、独立してKVを持つのは72層中63層なので、FP8のKVキャッシュで1トークンあたり約36KB、128Kトークンで約4.8GB、1Mトークンで約38GB(1リクエスト分)になる(当サイトの計算値。インデックス用のキャッシュとドラフトヘッド分は含まない)。一般的なKV計算の考え方はKVキャッシュとコンテキスト長のVRAM解説で整理している。
Mistral Large 4とは — モデルカードで確認できる事実
Mistral Large 4は、フランスのMistral AIが2026年10月に発表した大規模言語モデルだ。総パラメータ約1兆、トークンあたりのアクティブパラメータ49B(埋め込み層・出力層を含めて52B)のMixture of Experts(MoE)で、ネイティブのマルチモーダル(テキスト+画像入力、出力はテキスト)に対応し、指示応答(instruct)と推論(reasoning)を1つのモデルに統合している。推論の強度はリクエストごとにlow・medium・highから選べる。EU公用語すべてを含む160以上の言語に対応し、学習には欧州内のNVIDIA Grace Blackwell GPU 3,800基が使われたとモデルカードに記載されている。
| 項目 | 内容 | 状態 |
|---|---|---|
| 総パラメータ | 約1T(1兆) | 確定(モデルカード) |
| アクティブパラメータ | 49B(埋め込み層・出力層を含めて52B) | 確定(モデルカード) |
| エキスパート構成 | ルーティング128個(トークンあたり4個)+共有1個。72層のうち先頭1層は密(config.json) | 確定 |
| アテンション | MLA(KV LoRAランク512)。隠れ次元6,144、語彙204,800 | 確定(config.json) |
| コンテキスト長 | 1M(1,048,576)トークン | 確定(config.json) |
| マルチモーダル | Pixtral系ビジョンエンコーダー(30層・隠れ次元2,048)。テキスト+画像入力、テキスト出力 | 確定 |
| 投機的デコード | DSparkドラフトヘッドを同梱(3トークン先読み、開発元計測で最大1.9倍の高速化) | 確定(開発元計測) |
| 対応言語 | 160以上(EU公用語すべてを含む) | 確定 |
| 学習環境 | 欧州内のNVIDIA Grace Blackwell GPU 3,800基 | 確定 |
| オープンウェイト | 2026年10月29日にHugging Faceで公開(FP8版・NVFP4版) | 公開済み |
| チェックポイント容量 | FP8 約1,060.6GB(54ファイル)、NVFP4 約610.0GB(32ファイル) | 実測(ファイルサイズ) |
| ライセンス | Mistral Ecosystem Open-Weight License(修正版MIT)。商用・非商用とも可。Model as a Service事業は別途商用ライセンスが必要 | 確定(LICENSE) |
| API | mistral-large-4として提供中(2026年10月6日〜、ドキュメント上はPublic Preview表記) | 提供中 |
| API料金 | 入力 $0.70 / 100万トークン、出力 $2.10 / 100万トークン(キャッシュ入力 $0.07) | 公式ドキュメント(10月31日確認) |
ベンチマーク(開発元の発表値)
以下は発表で示された数値で、開発元による発表であり、独立した第三者検証は確認できていない。モデルカードにはArtificial Analysisの指標(Coding Agent Index 48%、Intelligence Index v5 26)も載っているが、これも開発元が引用した数値だ。重みが公開されたため、今後は追試が出れば評価が変わりうる。
| ベンチマーク | スコア | 領域 |
|---|---|---|
| DeepSWE 1.1 | 61.7% | ソフトウェアエンジニアリング |
| Terminal Bench 4.0 | 28.3% | ターミナル操作・エージェント |
| AutomationBench | 59.9% | 業務自動化 |
| Cybench | 93% | セキュリティ(CTF課題) |
| 脆弱性の再現 | 82% | セキュリティ |
| Dense 200 | 42% | 視覚的グラウンディング(GPT-6-Astraは41%) |
このほか、AA Cyber Indexで世界トップ5に入ったこと、Harvey Legal Agent Benchmarkでオープンモデルとして最高だったことも発表されている。モデルカードは、Intelligence Index v5では西側のオープンウェイトで最高だが中国勢の上位モデルより低いこと、Coding Agent IndexではGLM-5.3と同水準で1タスクあたりのトークンが47%少ないことも述べている(いずれも開発元の記述)。法務や多言語の業務用途を意識した位置づけがうかがえるが、自社の用途で効くかどうかは実際のデータで試すしかない。
なぜ「総パラメータ1T」でメモリを見積もるのか
MoEは1トークンの計算に一部のエキスパートしか使わないが、次にどのエキスパートが選ばれるかは入力ごとに変わる。そのため原則として全エキスパートの重みをメモリ上に置く必要があり、必要容量は総パラメータ(約1T)で決まる。実際にFP8のチェックポイントが約1,060GBあることが、それを裏づけている。アクティブ49Bが効くのは速度の側だ。1トークンあたりに読み出す重みは、NVFP4の実サイズ比(610GB÷1T≒0.61byte/パラメータ)で計算するとおおむね30GB前後(49B × 約0.61byte、当サイトの計算値)に収まるため、メモリ帯域が足りる環境では、密な1Tモデルよりはるかに高速に動く。計算量としては約49B級のモデルに近いが、メモリの要求は1T級のままという点が、MoEの設計上の特徴だ。
量子化とは — 何bitを選ぶべきか
量子化は、重みを表すビット数を減らしてメモリを圧縮する技術だ。BF16(16bit)を8bitにすれば半分、4bitにすれば約4分の1になる。8bitはほぼ無損失、4bit級は多くの用途で実用範囲とされるが、2bit級まで落とすと出力品質が目に見えて下がる。Mistral Large 4は、開発元がFP8版とNVFP4版を公式に出している。NVFP4はMoEのエキスパートをNVFP4、線形層をFP8にした構成で、モデルカードはマルチモーダル推論・長文・コーディングエージェントなどの評価でFP8と同等としている(開発元の評価で、独立検証は未確認)。推論(reasoning)モードを使う場合は、長い思考過程で誤差が蓄積しやすいため、できるだけ高い精度を選ぶほうが無難だ。
方針としては、品質を優先してHopper世代(H100・H200)で動かすならFP8、Blackwell世代があればNVFP4、llama.cppで動かす4bit級ならGGUFのQ4_K_M(約634.8GB)、メモリが足りないときの最後の手段が2bit級GGUF(Q2_K 約380.7GB、IQ2_XXS 約297.7GB)、という順になる。BF16は公式チェックポイントがなく、変換版GGUFで約2,098.9GBあり、研究目的でない限り選ぶ理由は薄い。
GPU構成別の目安(実測サイズからの算出)
下表は「重みが載るか」を、上で示した実サイズから算出したものだ。余裕は合計VRAM×0.85(vLLM公式手順の設定)から重みを引いた概算で、KVキャッシュとアクティベーションがここに収まる必要がある。実際に動くかどうかは、フレームワークの並列化方式とコンテキスト長、同時リクエスト数で変わる。NVFP4はモデルカードがBlackwell向けと明記しているため、Hopper世代は対象外とした。
| GPU構成 | 合計VRAM | FP8(約1,060.6GB) | NVFP4(約610.0GB・Blackwell向け) | 2bit級GGUF(Q2_K 約380.7GB) |
|---|---|---|---|---|
| H100 80GB × 8 | 640GB | 不可 | 対象外(Hopper)。重みだけで95% | 載る(余裕あり) |
| H100 80GB × 16 | 1,280GB | 載るが余裕は約27GB(0.85時、2ノード構成) | 対象外(Hopper) | 過剰 |
| H200 141GB × 4 | 564GB | 不可 | 対象外。重み610GBは564GBに届かない | 載る |
| H200 141GB × 8 | 1,128GB | 載るが重みで94%を占め、0.85では不足。余裕は約67GB(使用率を0.95前後に上げる必要) | 対象外(Hopper) | 過剰 |
| B200 192GB × 4 | 768GB | 不可 | 載る(余裕は0.85時で約43GB、全量で約158GB) | 過剰 |
| B200 192GB × 8 | 1,536GB | 余裕あり(0.85時で約245GB) | 余裕大 | 過剰 |
推奨の目安は次のとおりだ。NVFP4ならB200×4が最小構成で、モデルカードのSGLang手順も--tp-size 4のBlackwellノードを例にしている。1Mトークン1リクエスト分のKVキャッシュ(約38GB、上記の計算値)は、全量の余裕約158GBに収まる計算だ。FP8を動かすならB200×8が安全で、H200×8は重みで合計VRAMの94%を占めるため、vLLM公式手順の使用率0.85では載らず、使用率を上げても残りは約67GBでKVキャッシュに余裕がない。公式手順のFP8例がテンソル並列8(--tensor-parallel-size 8)なのは、この規模を想定したものと読める。BF16相当(約2,100GB)はB200×8でも総量1,536GBに届かず、対象外だ。なお、GPU枚数は並列化方式の制約で2の累乗が前提になることがあり、H200×5のような構成が使えるかはフレームワーク次第だ。
Apple Siliconで動かす場合
Apple Siliconは統合メモリをGPUからも使えるため、大型モデルを手元で動かす選択肢になる。ただしMac Studioの最大構成は512GBで、OS分を引くと使える容量はさらに小さい。4bit級のGGUF(Q4_K_M 約634.8GB、UnslothのUD-Q4_K_XL 約604.8GB)は1台には載らない。1台で動かせるのは2bit級のQ2_K(約380.7GB)やIQ2_XXS(約297.7GB)、Unslothの3bit級UD-IQ3_XXS(約423.5GB、重みだけで512GBの8割強)までで、品質低下とのトレードオフになる。
4bit級を狙うなら、Mac Studio 512GBを2台つなぎ、分散推論で合計1,024GBを使う構成が考えられる。Q4_K_M(約634.8GB)は載る計算だが、台数間の通信速度が律速になり、安定運用のハードルも高い。FP8(約1,060.6GB)は合計1,024GBを超えるため、2台でも載らない。モデルカードはllama.cppについてGGUFと手順(ggml-org)へ案内しているが、MetalでのMac実行やMLXへの対応には言及がなく、Macでの動作は未確認だ。512GB機の考え方はReflection Beamの必要スペック記事でも触れている。
CPU+大容量RAMでのオフロード
アクティブ49Bという性質を活かし、エキスパートを大容量のシステムRAMに置いてGPUに共通部分だけを載せる方法もある。ただしMistral Large 4は4bit級でも約610〜635GBあるため、512GBのRAMでは足りず、実質1TB級のサーバーが必要になる(2bit級のQ2_K約380.7GBなら512GBに載るが、品質は下がる)。1トークンあたり約30GBを読む計算なので、帯域が約300GB/sのサーバーでも理論上の上限は十トークン/秒前後で、実際はその数分の一にとどまる見込みだ(推定)。
RTX 5090(32GB)のような消費者向けGPUは、VRAM単体では到底足りない。512GB超のRAMとの組み合わせで極端なCPUオフロードを行えば動く可能性はあるが、速度は実用に遠い。ローカルで試すだけなら、このモデルの選択は現実的ではなく、同じMistralの小型モデルを使うほうが向いている。小型版の考え方はMistral Small 4の記事を参照してほしい。
API利用とローカル運用の費用比較
Mistral Large 4のAPI料金は、公式ドキュメントによると入力が100万トークンあたり$0.70、出力が$2.10(キャッシュ入力は$0.07)だ。発表時の報道にあった入力$1.36・出力$4.18から、ドキュメント上の現行価格に改めた。たとえば1日に入力100万トークン・出力30万トークンを処理する場合、1日あたり入力$0.70+出力$0.63(0.3 × $2.10)で約$1.3になる。30日で約$40、1年でも約$490にとどまる。
| 利用量(1日) | 入力 | 出力 | 1日の費用 | 1か月(30日) |
|---|---|---|---|---|
| 小規模 | 100万トークン | 30万トークン | 約$1.3 | 約$40 |
| 中規模(10倍) | 1,000万トークン | 300万トークン | 約$13 | 約$400 |
| 大規模(100倍) | 1億トークン | 3,000万トークン | 約$133 | 約$4,000 |
B200×4やH200×8のようなサーバーは、購入すれば数千万円規模、クラウドで借りても継続的な時間課金が発生する。このため、多くの中小企業ではAPI利用のほうが圧倒的に安い。自前運用を検討するのは、機密データを社外に出せない、データの所在を欧州域内などに限定したい、毎日大量に処理して従量課金がかさむ、といった明確な理由がある場合に絞るのが現実的だ。重みが公開されたため自前運用は選べるようになったが、APIで自社データによる品質評価を先に行ってから投資を判断する順序は、変わらず誤りにくい。
他の大型オープンMoEとの比較
当サイトの既存記事で確認できる数値と並べる。アクティブパラメータに対する総パラメータの比が大きいほど、メモリは重いのに1トークンの計算は軽い、というMoEらしい性格になる。
| モデル | 総パラメータ | アクティブ | コンテキスト長 | ライセンス | 4bit時のメモリ目安 |
|---|---|---|---|---|---|
| Mistral Large 4 | 約1T | 49B | 1M | Mistral Ecosystem Open-Weight License(修正版MIT、MaaS事業は別途契約) | 約610GB(NVFP4公式・実測、重みのみ) |
| Reflection Beam | 501B | 23B | 1M | Apache 2.0 | 約250〜290GB(推定・重みのみ) |
| DeepSeek V4-Pro | 1.6T | 49B | 1M | MIT | 約920GB |
| GLM-5.2 | 753B | 約40B | 1M | MIT | 約430GB |
| Mistral Small 4 | 119B | 6.5B | 256K | Apache 2.0 | 約60GB(Q4) |
| Kolibri-1 | 78B | 約3.46B | 262K(ネイティブ) | Apache 2.0 | 約39〜45GB(推定) |
Mistral Large 4はアクティブ49BでDeepSeek V4-Proと同じだが、総パラメータは約3分の2で、4bit時のメモリも約610GBと約3分の2になる。一方でReflection Beamの約2倍強のメモリを要する。欧州発のモデルという点では、78BのMoEであるKolibri-1のほうが、はるかに少ないメモリで動く。ライセンスはMIT系だが、Model as a Service事業には別途契約が要る点が、Apache 2.0やMITの他モデルと異なる。ベンチマークの優劣は各社の発表値に基づくため、この表では比較していない。
重み公開後に確認すること
- ダウンロード前に保存先のディスク空き容量を確保する(FP8は約1,060.6GB、NVFP4は約610.0GB)
- GPUの世代で版を選ぶ(B200・B300・GB200・GB300ならNVFP4、H100・H200ならFP8)
- 推論基盤はモデルカードが案内するvLLM公式イメージ(vllm/vllm-openai:mistral-large-4、推奨)、SGLang(lmsysorg/sglang:mistral-large-4)、transformers(mainブランチ)、llama.cppのGGUFから選ぶ
- 最初は--max-model-lenと--max-num-seqsを下げて起動し、OOMを避けながら上げていく(1Mトークンのコンテキストは重みとは別にKVキャッシュが要る)
- ライセンス全文を確認する。自社内の利用は対象外条件に当たるが、第三者へAPIやホスティングで提供する事業をする場合はMistralとの別途契約が要る
- 速度を上げたい場合は同梱のDSpark投機的デコードを有効にする(開発元計測で最大1.9倍。効果は環境と用途で変わる)
- 機密データを扱わないなら、APIで自社データによる品質評価を先に行う
トラブルシューティング(メモリ不足・OOM)
- 起動時にOOMになる: 重みが載っていない。精度を一段下げる(FP8→NVFP4)か、GPU枚数を増やす
- 途中からOOMになる: KVキャッシュが原因の可能性が高い。コンテキスト長の上限を下げる、同時リクエスト数を減らす、KVキャッシュの量子化(NVFP4版の公式手順は--kv-cache-dtype fp8_ds_mla)を使う
- 画像入力で落ちる: マルチモーダルでは画像のトークン分と視覚部分の重みが加わる。画像の解像度や同時枚数を減らして確認する
- オフロード構成が遅い: メモリ帯域が律速。DDR5のチャネル数を確認し、エキスパート配置を見直す
- GPUは空いているのに載らない: 並列化方式の制約で、均等分割できない枚数だと使い切れないことがある。枚数と並列設定を確認する
- H200×8で起動しない: 公式手順の使用率0.85では、重みが1,060GBのFP8は載らない。使用率を上げるか、B200×8やNVFP4版を検討する
- 品質が極端に悪い: 2bit級は劣化が大きい。3bit以上を試す
まとめ
Mistral Large 4は総パラメータ約1T・アクティブ49Bのマルチモーダル対応MoEで、2026年10月29日に重みが公開された。公式チェックポイントの実サイズはFP8が約1,060.6GB、NVFP4が約610.0GBだ。NVFP4ならB200×4、FP8ならB200×8が現実的で、H200×8でもFP8は載るが余裕は約67GBしかない。Mac Studio 512GBは4bit級(約605〜635GB)が1台には載らず、消費者向けGPUは現実的ではない。ライセンスは修正版MIT(Mistral Ecosystem Open-Weight License)で、商用利用も可能だが、MaaS事業には別途契約が要る。コンテキスト長は1Mトークンだ。1日100万トークン規模ならAPIは1日約$1.3で済み、多くの中小企業にはAPIが合理的だ。BF16・GGUF・長文時のKVキャッシュの実測は、Mac・MLX対応を含め、検証が進み次第追記する。
FAQ
Mistral Large 4を動かすのに必要なVRAMはどれくらいですか。
公式チェックポイントの実サイズで、重みだけならFP8が約1,060.6GB、NVFP4が約610.0GBです。変換版GGUFではBF16が約2,098.9GB、Q4_K_Mが約634.8GB、Q2_Kが約380.7GBです。ここにKVキャッシュとオーバーヘッドが加わります。config.jsonから計算すると、FP8のKVキャッシュは1Mトークンで1リクエストあたり約38GBです(当サイトの計算値)。
重みはもう公開されていますか。ライセンスは何ですか。
2026年10月29日にHugging Faceで公開されました(FP8版とNVFP4版)。ライセンスはMistral Ecosystem Open-Weight Licenseで、修正版のMITです。商用・非商用とも利用できますが、Model as a Service事業(第三者がAPIなどで入力や設定を制御できる形でモデルを提供する事業)を営む場合は、Mistralとの別途商用ライセンスが必要です。自社内での利用や、Mistral公式サービス経由の利用は、この条件の対象外とライセンスに書かれています。
アクティブ49Bなら、49B相当のVRAMで動きますか。
動きません。MoEは次にどのエキスパートが選ばれるか分からないため、原則として全エキスパートの重みをメモリに置く必要があり、必要容量は総パラメータ約1Tで決まります。実際にFP8のチェックポイントは約1,060GBあります。アクティブ49Bは主に生成速度に効きます。
B200×4やH200×8で動きますか。
NVFP4(約610.0GB)はB200×4(合計768GB)に載る計算で、全量の余裕は約158GBです。FP8(約1,060.6GB)はH200×8(合計1,128GB)に載りますが、重みで94%を占めるため、vLLM公式手順の使用率0.85では足りず、余裕も約67GBです。FP8を余裕を持って動かすならB200×8が安全です。NVFP4はモデルカードがBlackwell向けと明記しています。
Mac Studio(512GB)やRTX 5090で動きますか。
Mac Studio 512GB 1台には4bit級のGGUF(約605〜635GB)が載らず、載るのは2bit級(Q2_K約380.7GB、IQ2_XXS約297.7GB)や3bit級(Unslothの約423.5GB)までで品質が下がります。2台での分散推論ならQ4_K_Mが載る計算ですが、MetalやMLXでの動作はモデルカードに記載がなく未確認です。RTX 5090(32GB)は、大容量RAMによる極端なCPUオフロードでない限り現実的ではなく、速度も実用に遠いです。
ローカルで動かすのとAPIを使うのはどちらが安いですか。
多くの中小企業ではAPIが圧倒的に安いです。公式ドキュメント上の料金は入力$0.70・出力$2.10(100万トークンあたり)で、1日に入力100万・出力30万トークンなら約$1.3です。自前運用はB200×4級のサーバーが必要で、機密データを社外に出せない場合や大量処理が続く場合に限って検討する価値があります。
株式会社オブライト
株式会社オブライトは、ソフトウェア開発、デジタルサイネージ、Web開発、ネットワークシステム、IoT/AR/VRなどの技術サービスを提供する東京のIT企業です。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ