Ollayaとは — Jev型判断モデルをローカルで動かす『判断モデル版Ollama』【使い方】
Ollayaは状態と選択式・数値の質問を入力すると確率をミリ秒で返す「判断モデル」をローカル実行できるOSSランタイムです。Ollama風にpull・run・serveでき、TypeSafe Jev互換APIやMCPにも対応。Rust製・Apache 2.0でHacker Newsでも話題になりました。
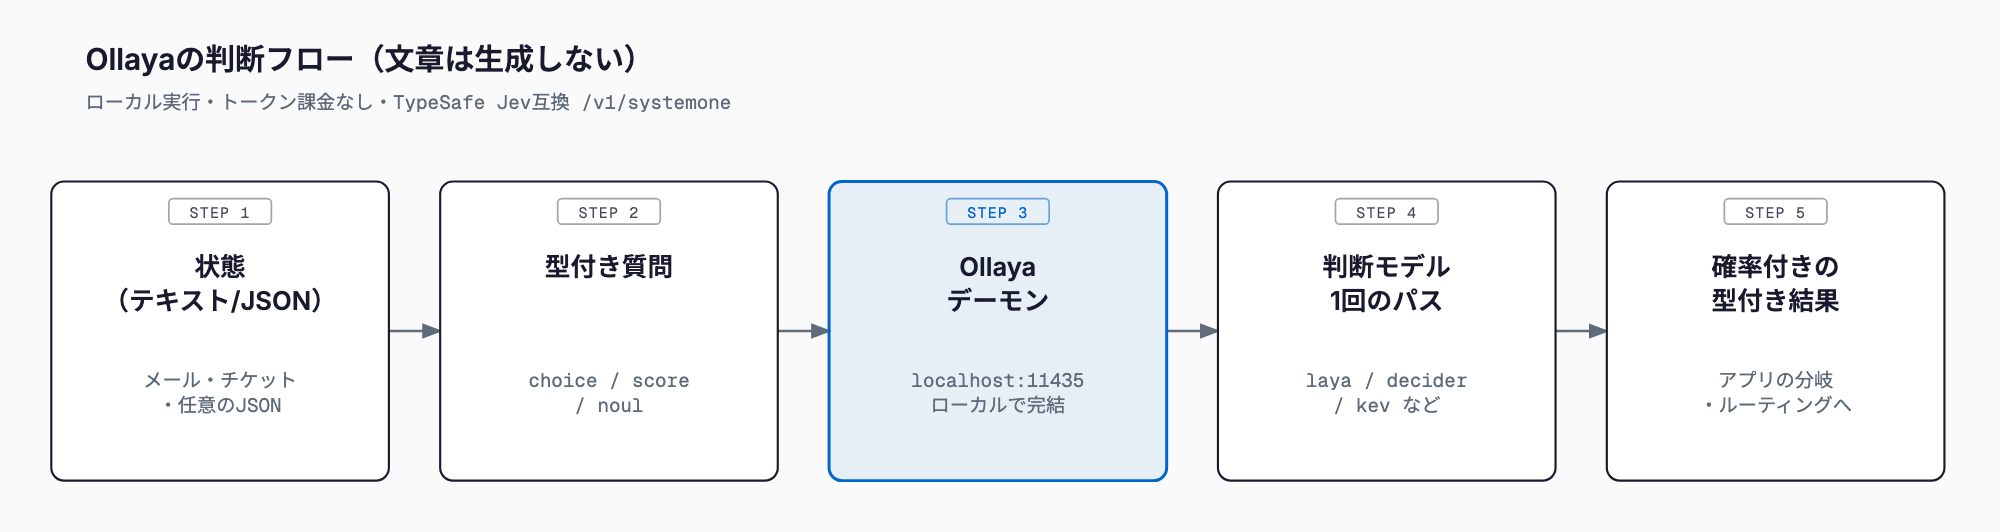
Ollayaは、LLM Chatではなく「判断モデル」をローカルで動かすためのOSSランタイムだ。テキストやメール、チケット本文、あるいは任意のJSONといった「状態」と、選択式(choice)・スコア(score)・真である確率を返すyes/no型(noul)で書かれた質問を渡すと、1回のフォワードパスでキャリブレーションされた確率をミリ秒単位で返す。CLIやAPIの体験はOllamaを踏襲しており、モデル名を指定してpullし、ローカルのデーモンでrun・serveする使い方はほぼそのままだ。2026年9月25〜26日ごろにHacker Newsのフロントページ入りし(462ポイント・117コメント)、TypeSafe AIが同月15日に発表したホスト型の判断モデルAPI「Jev System One」をローカルで動かす手段として注目された。
Ollayaで何ができるか
判断モデルは文章を生成しない。状態と型付きの質問を受け取り、各質問に対する確率(あるいはスコアの分布)だけを返す、いわば「賢いif文」だ。この性質から、Ollayaは次のような場面で使われている。
- サポートチケットのトリアージ — 返金意図か・緊急かどうか・チャーンリスクなどを1回の呼び出しでまとめて判定
- メールやチケットのルーティング — 部署・優先度・感情スコアを見てキューを振り分け
- LLMのガードレール — 生成前後の入力・出力をチェックし、危険な意図やポリシー違反を検知
- ワークフロー内の「賢いif文」 — 従来なら正規表現やルールベースで書いていた分岐条件を、確率付きの判断モデルに置き換える
インストール・料金・動作環境
OllayaはApache 2.0(個別モデルのライセンスは別)で公開されているオープンソースソフトウェアで、利用に料金はかからない。トークン課金もない。主な導入方法と動作環境は以下の通り。
| 項目 | 内容 | |
|---|---|---|
| ライセンス・料金 | Apache 2.0(モデル別ライセンスは個別)、OSS・無料。トークン課金なし | |
| Linux/macOSインストール | curl -fsSL https://ollaya.dev/install.sh をshにパイプ | |
| Windowsインストール | `irm https://ollaya.dev/install.ps1 \ | iex`(PowerShell) |
| Dockerインストール | docker run -d --gpus=all -p 11435:11435 ghcr.io/ollaya-dev/ollaya:cuda | |
| 対応OS | macOS Apple Silicon 14以降、Windows 10/11 x64、Linux x86-64/ARM64、WSL2 | |
| GPU | NVIDIA CUDA 13以降・ドライバR580以降(インストーラが自動検出しCUDAランタイムを追加)、Apple GPU(MLX経由)、CPUフォールバックあり | |
| デフォルトポート | 11435(Ollamaは11434) |
使い方 — 最短手順
セットアップの流れはOllamaとほぼ同じだ。上記のインストールコマンドを実行した後、ollaya serveでローカルデーモンを起動し、ollaya pull layaのようにモデルを取得する。動作確認はollaya runが手軽で、たとえばollaya run laya --preset triage "I was charged twice for my subscription this month and want a refund."を実行すると、intent refund 1.00 is_urgent no 0.88 frustration 1.76/3 0.36 refund_requested yes 0.90 churn_risk no 0.61のように、質問ごとの判定と確率が1回の呼び出しで返る。アプリケーションからはHTTP API(POST /api/decideや、Jev互換のPOST /v1/systemone)を叩くほか、TypeSafeの公式SDK(0.7.1で確認)の接続先をTYPESAFE_BASE_URL=http://localhost:11435に向けるだけでOllayaに切り替えられる。Claude CodeやCursorなどのMCPクライアントからはclaude mcp add ollaya -- ollaya mcpで追加でき、エージェントが判断モデルを直接呼び出せるようになる。モデルやサーバーの状態はollaya list(取得済み一覧)・ollaya ps(起動中モデル)・ollaya show(詳細)・ollaya stop/ollaya rmで管理する。挙動を環境変数で調整したい場合はOLLAYA_HOST・OLLAYA_MODELS・OLLAYA_KEEP_ALIVE・OLLAYA_DEVICE・OLLAYA_API_KEYが用意されている。
対応モデル一覧
| モデル | ベース | サイズ | 特徴 |
|---|---|---|---|
| laya | ルーター | - | 英語/多言語を自動判定して振り分け |
| laya:en | ModernBERT-large | 421M | RTX 4090で5問8〜10ms(公式サイト比較ではホストAPI比236〜276ms) |
| laya:multilingual | mmBERT-base | 322M | 100以上の言語に対応 |
| decider | Qwen3.5ベース | 0.75B/1.9B(デフォルト2B) | 自社の「typed-decisions」ベンチマークで0.591 |
| kev | Qwen3.5 LoRA | 0.76B/4.2B/7.9B | kev:9bが掲載モデル中最高の0.722 |
| nli | DeBERTa-v3-large | 約396M/435M | ゼロショットNLI |
| gliclass | DeBERTa-v3-large | 439M | ゼロショット分類 |
| qwen3guard | Qwen3.5系 | 0.6B | 安全性チェック用 |
| decision | - | 0.75B | コンテキスト長16k |
| von | - | 395M | コンテキスト長8k |
| winnow | Gemma 4(GGUF) | - | llama.cpp経由で実行 |
既存ツールとの違い
Ollayaは「ローカルLLMランタイム」と「ホスト型判断モデルAPI」のどちらとも違う、中間の立ち位置にある。
| ツール | 主な用途 | 実行場所 | Jev互換API | 料金 |
|---|---|---|---|---|
| Ollaya | 判断モデル(確率をミリ秒で返す) | ローカル | あり(/v1/systemone) | 無料・OSS |
| Ollama | LLMチャット・生成 | ローカル | なし | 無料・OSS |
| llama.cpp | LLM推論エンジン(GGUF実行) | ローカル | なし | 無料・OSS |
| LM Studio | LLMチャットのデスクトップGUI | ローカル | なし | 無料(一部有料プランあり) |
| TypeSafe Jev(ホスト型) | 判断モデル(本家) | クラウド | 本家 | 入力$0.042/M・出力無料 |
| LLMのstructured output/JSON mode | 汎用LLMでJSON整形出力を強制 | ローカル/クラウド両対応 | なし | 利用するLLM次第(トークン課金) |
OllayaはTypeSafe AI公式のプロダクトではなく、TypeSafe Jevが2026年9月15日に発表したホスト型System One APIと配線互換のサードパーティOSSである点には注意したい。LLMのstructured output/JSON modeも似た用途で使われることがあるが、あれは大きな生成モデルに出力形式を強制するアプローチで、専用の小型判断モデルが1フォワードパスで確率を返すOllayaとは推論コストもレイテンシも一桁以上違う。
向いている人・向いていない人
- 向いている: サポートチケットのトリアージやメール振り分けなど、大量の入力に対して型付きの判定を高速・低コストで繰り返し行いたいチーム
- 向いている: LLMエージェントの前後にガードレールとして挟み込み、危険な入力や逸脱した出力を確率付きで検知したい開発者
- 向いている: TypeSafe Jevで組んだアプリをオフラインやセルフホストで動かしたい、あるいはコストをゼロに近づけたいチーム
- 向いていない: 自然文の生成や要約、対話そのものが目的のユースケース(Ollayaは確率を返すだけで文章は生成しない)
- 向いていない: GPUどころかCPUリソースにも余裕がなく、外部APIに投げた方が運用が楽な小規模・低頻度の用途
- 向いていない: 2026年9月に広く知られ始めたばかりのプロジェクトで、成熟度・長期メンテナンス体制をまだ見極めたい保守的なチーム
よくある質問
OllamaとOllayaの違いは?
OllamaはLLMのチャット・生成をローカルで動かすためのランタイムで、応答は自然文の生成結果です。OllayaはCLIやデーモンのUXをOllamaから踏襲していますが、動かすのは『状態+型付き質問→確率』を返す判断モデルで、文章は生成しません。デフォルトポートもOllamaの11434に対しOllayaは11435と別に割り当てられています。
日本語は使えますか?
英語専用のlaya:enに加えて、100以上の言語に対応するlaya:multilingual(mmBERT-baseベース)が用意されており、ルーターモデルのlayaは入力言語を見て自動的にどちらかを選びます。日本語での精度が公式にベンチマーク公開されているかは2026年9月26日時点で確認できておらず、実運用前に自分のデータで検証することをおすすめします。
GPUは必須ですか?
必須ではありません。NVIDIA(CUDA 13以降・ドライバR580以降)やApple Silicon(MLX経由)のGPUがあれば高速に動きますが、CPUフォールバックも用意されています。ただし公式サイトが示す『5問8〜10ms』のような速度はGPU実行時の数値で、CPUではそれより遅くなる点は踏まえておきたい。
TypeSafe Jevとの関係は?TypeSafe公式のツールですか?
Ollayaはリポジトリ・ドメインとも『ollaya-dev』名義で公開されているサードパーティのオープンソースプロジェクトで、TypeSafe AI公式のツールではありません。TypeSafe Jevが2026年9月15日に発表したホスト型System One API(入力$0.042/M・出力無料)と配線互換のAPIを実装しているため、公式SDKの接続先を変えるだけでローカルに切り替えられる、という関係です。
商用利用や本番導入は可能ですか?
ライセンスはApache 2.0(個別モデルのライセンスは別途確認が必要)で、商用利用自体は妨げられません。ただしHacker Newsのフロントページ入りが2026年9月25〜26日ごろとまだ日が浅く、GitHubスター数も275前後(本記事執筆時点)というアーリーステージのプロジェクトです。本番投入前に自分たちのワークロードで精度・レイテンシ・運用面を検証することを推奨します。
まとめ
OllayaはOllamaのCLI体験をそのまま踏襲しながら、生成ではなく『状態+型付き質問→確率』を返す判断モデルをローカルで動かすためのOSSランタイムだ。TypeSafe Jevのホスト型APIと配線互換のエンドポイントを持つため、サポートチケットのトリアージやワークフロー内の分岐条件を、外部APIに依存せずセルフホストで動かしたいチームにとって選択肢になる。関連記事としてTypeSafe Jevとは — LLMの100倍速い「System One」判断モデル最速解説やTypeSafe Jev 実践ガイド — Choice/Score/Noulの書き方と活用アイデア12選も参考にしてほしい。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ