Strataとは — Qwen3.8 Flash Next(125B)をRTX 4090で動かすローカル推論ツール【必要
スペック・使い方】
StrataはQwen3.8-Flash-Next(125B MoE)をVRAM 12GBのゲーミングPCで動かすMIT Licenseの推論エンジン。RTX 5070で94トークン/秒(README実測)。2026年10月時点の必要スペック、導入手順、Claude Code連携を解説。
Strata(GitHub: Niko1221/Strata)は、1250億パラメータのMoEモデル「Qwen3.8-Flash-Next」を、VRAM 12GB以上のゲーミングPC(RTX 20/30/40/50シリーズ、Radeon RX 7000/9000シリーズ)でローカル実行するMIT Licenseのオープンソース推論エンジンです。公式READMEによる動作要件はRAM 32GB以上(全サイズを使うなら64GB推奨)・SSD空き約80GB・Windows 10/11またはLinuxで、RTX 5070(12GB)のQ2_0量子化で生成94トークン/秒という実測値が掲載されています。2026年10月にはHacker Newsのフロントページで600ポイント超(634ポイント・296コメント)を集め、リポジトリのスターも1万1,000を超えました(2026年10月5日時点)。
本稿では、公式README・リリースノート・HNスレッドに基づき、Strataの仕組み、必要スペック早見表、GPU別の速度目安、Windows/Linuxでの導入手順、ブラウザUI・API・Claude Codeなどコーディングエージェントとの接続、DwarfStar(ds4)・llama.cpp・Ollamaとの違い、注意点を整理します。モデル自体の仕様は別記事のQwen3.8-Flash-Next 必要スペック早見表にまとめています。
Strataとは — 125B MoEを「階層配置」で家庭用PCに載せる推論エンジン
Strataの狙いは、本来なら数百GB級のメモリを要する大型MoEモデルを、普通のゲーミングPCで実用速度まで引き上げることです。READMEは「無料でオープンソース」「データはPCの外に出ない」ことを前面に出しており、対象モデルはQwen3.8-Flash-Next(125B MoE)です。推論エンジンはllama.cpp/ggml系のコードを土台にしていると明記されています。
仕組みの要点は、モデルの部品をPCの各パーツに役割分担させることです。READMEの説明では、全24,576個のexpert(MoEの専門家ネットワーク)をすべてシステムRAMに置き、その中でよく使われるexpertをGPUのVRAMに常駐させ、GPUに載らない残りのexpertの計算をCPUが同時に受け持ち、ルックアップテーブルはSSDに置きます。MoEはトークンごとに一部のexpertしか使わないため、「全部をVRAMに載せる」のではなく「頻出分だけVRAM、全量はRAM」という階層で十分に速度が出るという考え方です。
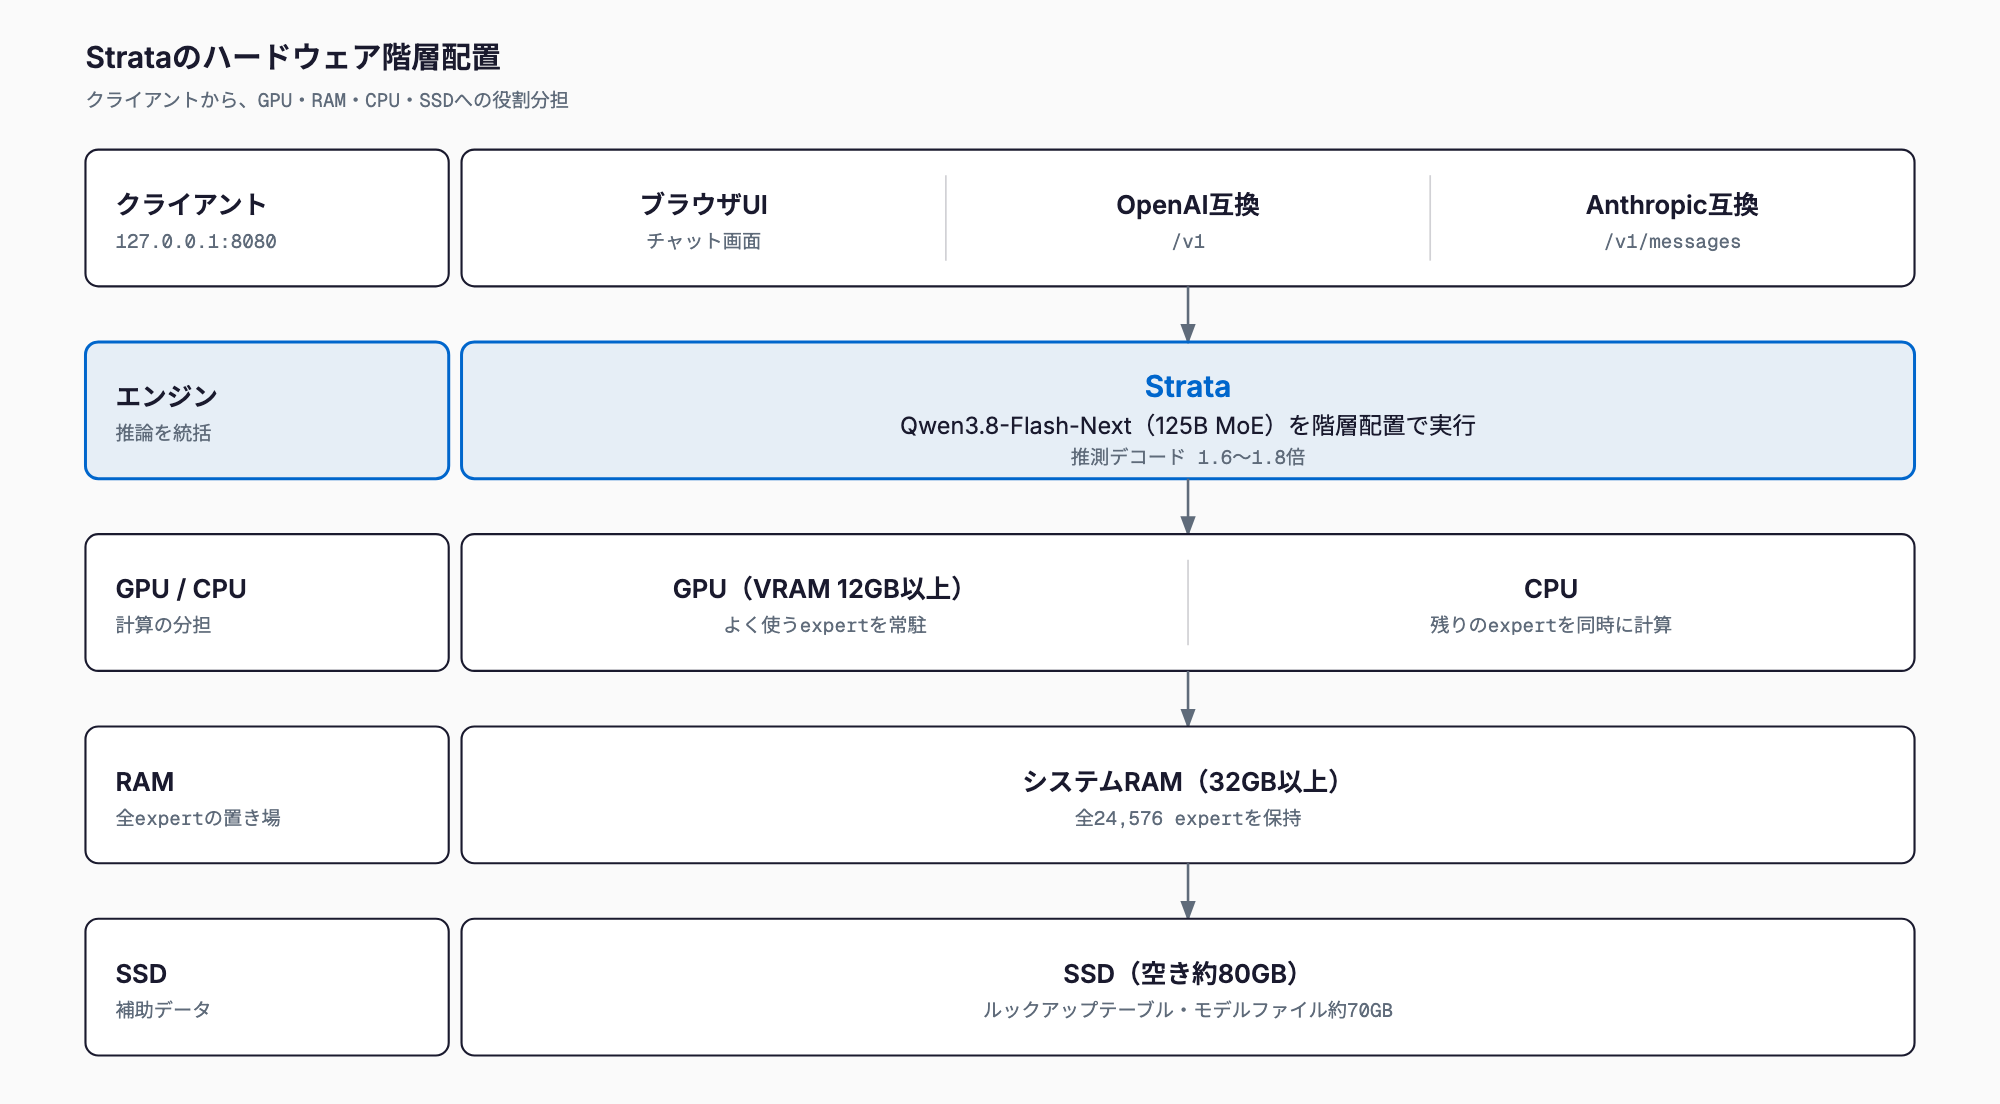
さらに推測デコード(speculative decoding)で1.6〜1.8倍の高速化を図っています。READMEの表現では、小さな予測役が次の数語を先読みし、大きなモデルがそれをまとめて検証する方式です。外れた予測は捨てられるため、出力の品質は大モデル単体と同じ(検証を通ったものだけが採用される)という性質があります。
必要スペック早見表 — RAM・VRAM別に選ぶモデル
公式READMEは、搭載RAM容量ごとの推奨モデルを次のように示しています。GPU側の最低ラインはVRAM 12GB以上で、RAMは最低32GBです。
| システムRAM | 推奨モデル | READMEの位置づけ |
|---|---|---|
| 32GB | Coder | コード特化・expertを半分に削減した版。32GBで動かす唯一の選択肢 |
| 48GB | IQ2_XS または Q2_0 | 最速クラスの2ビット系 |
| 64GB | IQ3_S | 品質が最も高い標準版(速度は最も遅い) |
| 96GB以上 | IQ3_S または Unsloth UD-IQ4_XS | 圧縮版の最大サイズまで対応。UD-IQ4_XSは約4ビットでダウンロード約94GB |
そのほかの条件は次のとおりです。
- GPU: NVIDIA GeForce RTX 20/30/40/50シリーズ、またはAMD Radeon RX 7000/9000シリーズ(いずれもVRAM 12GB以上)
- RAM: 最低32GB、全サイズを使うなら64GB推奨
- ストレージ: 空き約80GB(SSD推奨、起動が速くなる)
- OS: Windows 10/11、またはLinux(最新のGPUドライバ)
- モデルのダウンロード: 約70GB(選ぶモデルで変わる)
実験的サポートとして、Tesla P40/V100、GTX 10シリーズ、Radeon VII/MI50、Intel Arc(Linux)、AVX2非対応の古いCPUが挙げられています。v0.1.39(2026年10月4日)で対応が拡大された領域で、安定動作は保証されません。手元の構成で必要メモリを概算したい場合はVRAM計算ツールも使えます。
GPU別の速度目安 — RTX 5070で94トークン/秒、RX 9070 XTで60トークン/秒
READMEに掲載されている実測値は2機種です。生成(write)は出力の速さ、読み込み(read)はプロンプトを処理する速さを指します。
| 構成 | モデル | 生成 | プロンプト読み込み |
|---|---|---|---|
| RTX 5070(12GB)+ Ryzen 5 7600 | Q2_0 | 94 tokens/s | 2,650 tokens/s |
| 同上 | IQ2_XS | 79 tokens/s | 2,090 tokens/s |
| 同上 | IQ3_XXS | 62 tokens/s | 1,750 tokens/s |
| 同上 | IQ3_S | 53 tokens/s | 1,620 tokens/s |
| 同上 | Coder | 55 tokens/s | 2,180 tokens/s |
| RX 9070 XT(16GB)+ Ryzen 9 3900X | Q2_0 | 60 tokens/s | 1,160 tokens/s |
| 同上 | IQ2_XS | 52 tokens/s | 1,110 tokens/s |
| 同上 | Coder | 44 tokens/s | 1,420 tokens/s |
このほか、READMEはRTX 3090(24GB)で「約100〜140トークン/秒」が見込めるとしています。RTX 4090での「100トークン/秒」はHNスレッドのタイトルに掲げられた数字で、HNの書き込みでは、RTX 4090+DDR5 128GB+Ryzen 7950X3Dで124トークン/秒、RTX 3080+RAM 48GB+Ryzen 3600Xで30トークン/秒、GPUなしの64GB Mac(3ビット量子化)で25トークン/秒、RTX 2060(8GB)のQ2_0で33トークン/秒といった報告が出ています。いずれも利用者の自己申告で、第三者による検証ではない点に注意してください。
| GPU | 情報源 | 速度(生成) |
|---|---|---|
| RTX 5070(12GB) | README実測 | 53〜94 tokens/s(モデルで変動) |
| RX 9070 XT(16GB) | README実測 | 44〜60 tokens/s |
| RTX 3090(24GB) | READMEの見込み | 約100〜140 tokens/s |
| RTX 4090(24GB) | HNタイトル・HNの書き込み | 約100〜124 tokens/s(自己申告) |
| RTX 3080 | HNの書き込み | 約30 tokens/s(RAM 48GB、自己申告) |
インストール手順 — WindowsはSTART-HERE.bat、Linuxは setup.sh
導入は、リポジトリをダウンロードして展開し、セットアップスクリプトを実行するだけです。インストーラはGPUと搭載メモリを自動検出し、モデルサイズ、コンテキスト長、画像入力の有無を対話で尋ねたうえで、モデル(約70GB)をダウンロードして推論エンジンを起動します。ダウンロードは中断しても再開でき、2回目以降は再ダウンロードなしですぐ起動します。
- Windows: リポジトリのZIPを展開し、START-HERE.bat をダブルクリック
- Linux: Strataのディレクトリで ./setup.sh を実行
git clone https://github.com/Niko1221/Strata.git
cd Strata
./setup.sh   # Windowsは START-HERE.bat をダブルクリック
画像入力は、セットアップ中の「Images?」に肯定すると有効になります。AMD+Windowsでは画像処理が未対応(READMEの表現で「can't yet」)で、AMD+LinuxではCPUで処理されます。
使い方 — ブラウザUI・API・コーディングエージェント接続
起動すると http://127.0.0.1:8080 でブラウザのチャット画面が開きます。思考レベル(off/low/medium/high)の切り替え、画像入力、長文コンテキストに対応しており、READMEによると3万トークン前後の入力は約1分で読み込みます。--host 0.0.0.0 を付けてAPIキーを設定すれば、LAN内の別端末からも使えます。
| 接続先 | エンドポイント | 用途 |
|---|---|---|
| ブラウザUI | http://127.0.0.1:8080 | チャット |
| OpenAI互換API | http://127.0.0.1:8080/v1 | 各種アプリ・OpenAI互換のコーディングツール |
| Anthropic互換API | http://127.0.0.1:8080/v1/messages | Claude Code など |
| Responses API | /v1/responses | Codex CLI |
Claude Codeにつなぐ場合は、環境変数 ANTHROPIC_BASE_URL に http://127.0.0.1:8080 を指定します。OpenAI互換のツールにはベースURLとして http://127.0.0.1:8080/v1 を設定し、Codex CLIはOpenAI Responses API(/v1/responses)を使います。いずれもAPIキーとモデル名は形式上必要ですが、任意の値で構いません(READMEの記述)。
export ANTHROPIC_BASE_URL=http://127.0.0.1:8080
export ANTHROPIC_API_KEY=dummy   # 任意の値
claude
v0.1.39では、設定に "parallel": N を指定して複数の会話を同時に処理できるようになりました。エージェントを複数走らせる用途で効果があります。
既存ツールとの違い — DwarfStar(ds4)・llama.cpp・Ollama・ktransformers
Strataは、特定のモデルに絞って専用に最適化するタイプの推論エンジンです。同じ思想のDwarfStarは別記事で詳しく扱っています。下表のStrata以外の列は、公式ドキュメントと一般的な特性に基づく整理で、各ツールの最新対応は変わり得ます。
| ツール | 対象モデル | 主な想定環境 | 特徴 | ライセンス |
|---|---|---|---|---|
| Strata | Qwen3.8-Flash-Next(125B MoE)中心 | VRAM 12GB以上のゲーミングPC+RAM 32GB以上 | GPU/RAM/CPU/SSD階層配置+推測デコード。ワンクリック導入 | MIT |
| DwarfStar(ds4) | DeepSeek V4系・GLM 5.x・Qwen3.8 Flash Nextなど少数 | 96〜128GBのMac、DGX Spark、複数CUDA | 専用GGUFのみ。コーディングエージェント内蔵 | MIT |
| llama.cpp | 多数のGGUFモデル | CPUからGPU、Macまで幅広い | 汎用・安定。MoEのexpertをCPUに逃がすオフロードに対応 | MIT |
| Ollama | 多数のモデル | 個人PC・Mac | 導入が簡単でモデル管理が楽。裏側はllama.cpp系 | MIT |
| ktransformers | 大型MoE | GPU+大容量RAM | MoEのCPU/GPUハイブリッド実行に特化 | Apache-2.0 |
HNでは、llama.cppが多様な環境での安定性を優先するのに対し、Strataのようなモデル特化エンジンは同じハードで大幅に速いという声が複数ありました。一方、汎用ツールのOllamaのように多くのモデルを切り替えて使いたい場合は、Strataは向きません。Strataはあくまで「このモデルを速く動かす」ための道具です。
注意点 — 量子化の品質・初回起動・ライセンス
- 量子化の品質: 2ビット系(Q2_0、IQ2_XS)は速い反面、品質低下が起きやすい領域です。HNでも「2ビットは広範囲で劣化し得る」「4ビットが下限」という指摘と、IQ3_XXSで実用的なコーディング結果が出たという報告の両方がありました。Strata側が公表している精度ベンチマークは確認できませんでした。
- 初回起動の負荷: READMEによると、モデルのロード中はPCが1〜3分固まることがあります。RAMが足りない場合はディスクのスワップで極端に遅くなるため、他のアプリを閉じるか小さいモデルを選んでください。
- セットアップの安全性: HNでは、AI生成の手順に従う形式やスクリプト実行を「piping to bash」になぞらえる懸念が出ていました。実行前にスクリプトの中身を確認するのが安全です。
- ライセンスは二重構造: StrataはMITですが、モデル本体や構成要素は別ライセンスです。Qwen3.8-Flash-NextはApache-2.0ではなくQwen Community License 1.0で、商用利用の条件はモデル解説記事を確認してください。
- 開発が速い: v0.1.39は2026年10月4日付で、版番号はまだ0.1系です。仕様や推奨設定は頻繁に変わります。
よくある質問
StrataはRTX 4090で本当に動きますか?
動きます。READMEの対応GPUはRTX 20/30/40/50シリーズ(VRAM 12GB以上)で、RTX 4090は範囲内です。「100トークン/秒」はHNスレッドのタイトルの数字で、HNの書き込みではRTX 4090+DDR5 128GBで124トークン/秒という自己申告があります。ただしREADME自身の実測表はRTX 5070とRX 9070 XTです。
必要なRAMとVRAMはどれくらいですか?
READMEの要件はVRAM 12GB以上、RAM 32GB以上(全サイズなら64GB推奨)、空きストレージ約80GBです。RAM 32GBならCoder、48GBならIQ2_XSまたはQ2_0、64GBならIQ3_S、96GB以上ならUD-IQ4_XSまで選べます。
Claude Codeで使えますか?
使えます。Anthropic互換API(http://127.0.0.1:8080/v1/messages)を備えており、環境変数ANTHROPIC_BASE_URLにhttp://127.0.0.1:8080を指定します。APIキーとモデル名は任意の値で構いません。ただし、ローカルの量子化モデルはクラウドの最新モデルと同等の精度とは限りません。
無料で商用利用できますか?
Strata本体はMIT Licenseで、商用利用を含めて自由に使えます。モデル(Qwen3.8-Flash-Next)はQwen Community License 1.0という別ライセンスで、条件は別途確認が必要です。
OllamaやLM Studioの代わりになりますか?
代わりではなく使い分けです。Strataは主にQwen3.8-Flash-Nextを速く動かす専用エンジンで、多数のモデルを切り替えて試すならOllamaやLM Studioのほうが向いています。
AMDのGPUでも使えますか?
RX 7000/9000シリーズ(VRAM 12GB以上)が対象です。v0.1.34でWindowsにも対応しました。ただしAMD+Windowsでは画像入力が未対応で、AMD+LinuxではCPUで画像を処理します。
まとめ
Strataは、125B MoEのQwen3.8-Flash-Nextを「頻出expertはGPU、全expertはRAM、残りの計算はCPU、ルックアップテーブルはSSD」と役割分担し、推測デコードで1.6〜1.8倍に高速化することで、VRAM 12GB・RAM 32GBのゲーミングPCでも実用速度を狙えるMITライセンスのツールです。READMEの実測ではRTX 5070で最大94トークン/秒、RX 9070 XTで最大60トークン/秒、導入はSTART-HERE.batまたはsetup.shを実行するだけで、ブラウザUI、OpenAI/Anthropic互換API、Claude Codeなどのコーディングエージェントにそのままつながります。一方で、2ビット系量子化の品質、初回起動時の負荷、0.1系という成熟度には注意が必要です。まずは手元のRAM容量に合ったモデル(32GBならCoder、64GBならIQ3_S)から試すのが無難です。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ