Kolibri-1 必要スペック早見表
Aleph Alphaの78B MoE(VRAM 約78GB〜/H100×2〜)【ドイツ語特化・2026年版】
Kolibri-1の必要メモリはFP8で約78GB、H200×1枚またはH100×2枚から動作する。Aleph Alphaが公開した総78B・アクティブ3.46BのApache 2.0 MoE。精度別VRAM早見表・vLLM起動例・日本語非対応の注意点を整理【2026年10月】。
Kolibri-1の必要スペックはFP8で約78GB、データセンターGPU(H200×1枚/H100×2枚〜)が前提
Kolibri-1は、ドイツのAleph Alphaが2026年10月3日に公開した、総パラメータ約78B・アクティブ約3.46B/トークンのオープンウェイトMoE(Apache 2.0)で、ドイツ語・英語に特化している。モデルカードによれば公式配布のFP8重みは約78GBで、最小構成はA100 80GB×2枚、H100×2枚、H200×1枚、B200×1枚、B300×1枚、推奨構成はH100×2枚、H200×2枚、B200、B300とされる。4bitなど量子化時の必要メモリは、パラメータ数×ビット幅からの推定で約39〜45GBが目安(モデルカード記載の値ではない)。アクティブが3.46Bと小さいため推論は軽いが、全エキスパートの重みを置く必要があるため、メモリは総パラメータ分が要る点がMoEの要所だ【2026年10月時点】。
Kolibri-1とは — Aleph Alphaの欧州主権AIとドイツ語特化
Aleph Alphaはドイツ拠点のAI企業で、公共機関や産業など規制の厳しい分野での「主権的な(自国・自社管理下での)デプロイ」を訴求してきた。報道によれば、Kolibri-1もこの文脈で、公共行政・製造・航空宇宙などでの自社運用を想定したオープンウェイトモデルとして位置づけられている。最大の特徴は、ドイツ語の形態素(複合語など)に最適化した独自トークナイザ(UniBPE、語彙数128,000)を採用した、ドイツ語・英語のバイリンガルモデルである点だ。知識カットオフは2026年6月18日。推論モード(reasoning effort)とHermes形式のツール呼び出しにも対応する。
つまり汎用の多言語モデルではなく「ドイツ語圏の企業・行政が、データを外に出さず自前で動かす」ことに寄せた設計で、日本語は主対象外である。この前提を踏まえて読むと、必要スペックの数字も判断しやすい。
スペック一覧
| 項目 | 内容 |
|---|---|
| 提供元 | Aleph Alpha(ドイツ) |
| 公開日 | 2026年10月3日 |
| 総パラメータ | 約78B(78,103,074,560) |
| アクティブ | 約3.46B/トークン |
| 構成 | MoE、50層、SWA:GQA=4:1のアテンション |
| エキスパート | 各層384(共有1+ルーティング6が活性化) |
| 語彙 | 128,000(ドイツ語形態素向け独自トークナイザ) |
| コンテキスト | ネイティブ262,144/最大1,048,576(262K以下を推奨) |
| 対応言語 | ドイツ語・英語 |
| 推論機能 | 推論モード(low/medium/high/none)、ツール呼び出し |
| 重みの精度 | FP8(128×128ブロック)。埋め込み・LM head・norm・MoEルーターはBF16 |
| ライセンス | Apache 2.0(重みに対して) |
必要スペック早見表 — 精度別のメモリとGPU構成
下表のFP8行のみがモデルカード記載の値で、BF16・4bit・3bitはパラメータ数×ビット幅からの推定である。BF16は78.1B×2バイト≒156GB、4bitは78.1B×0.5バイト≒39GBにBF16で保持される埋め込み等やスケール分を加えた約39〜45GB、3bitは78.1B×0.375バイト≒29GBに同様の上乗せをした約30〜34GBと見積もった。いずれもKVキャッシュ・アクティベーションは別途必要で、コンテキストが長いほど増える。
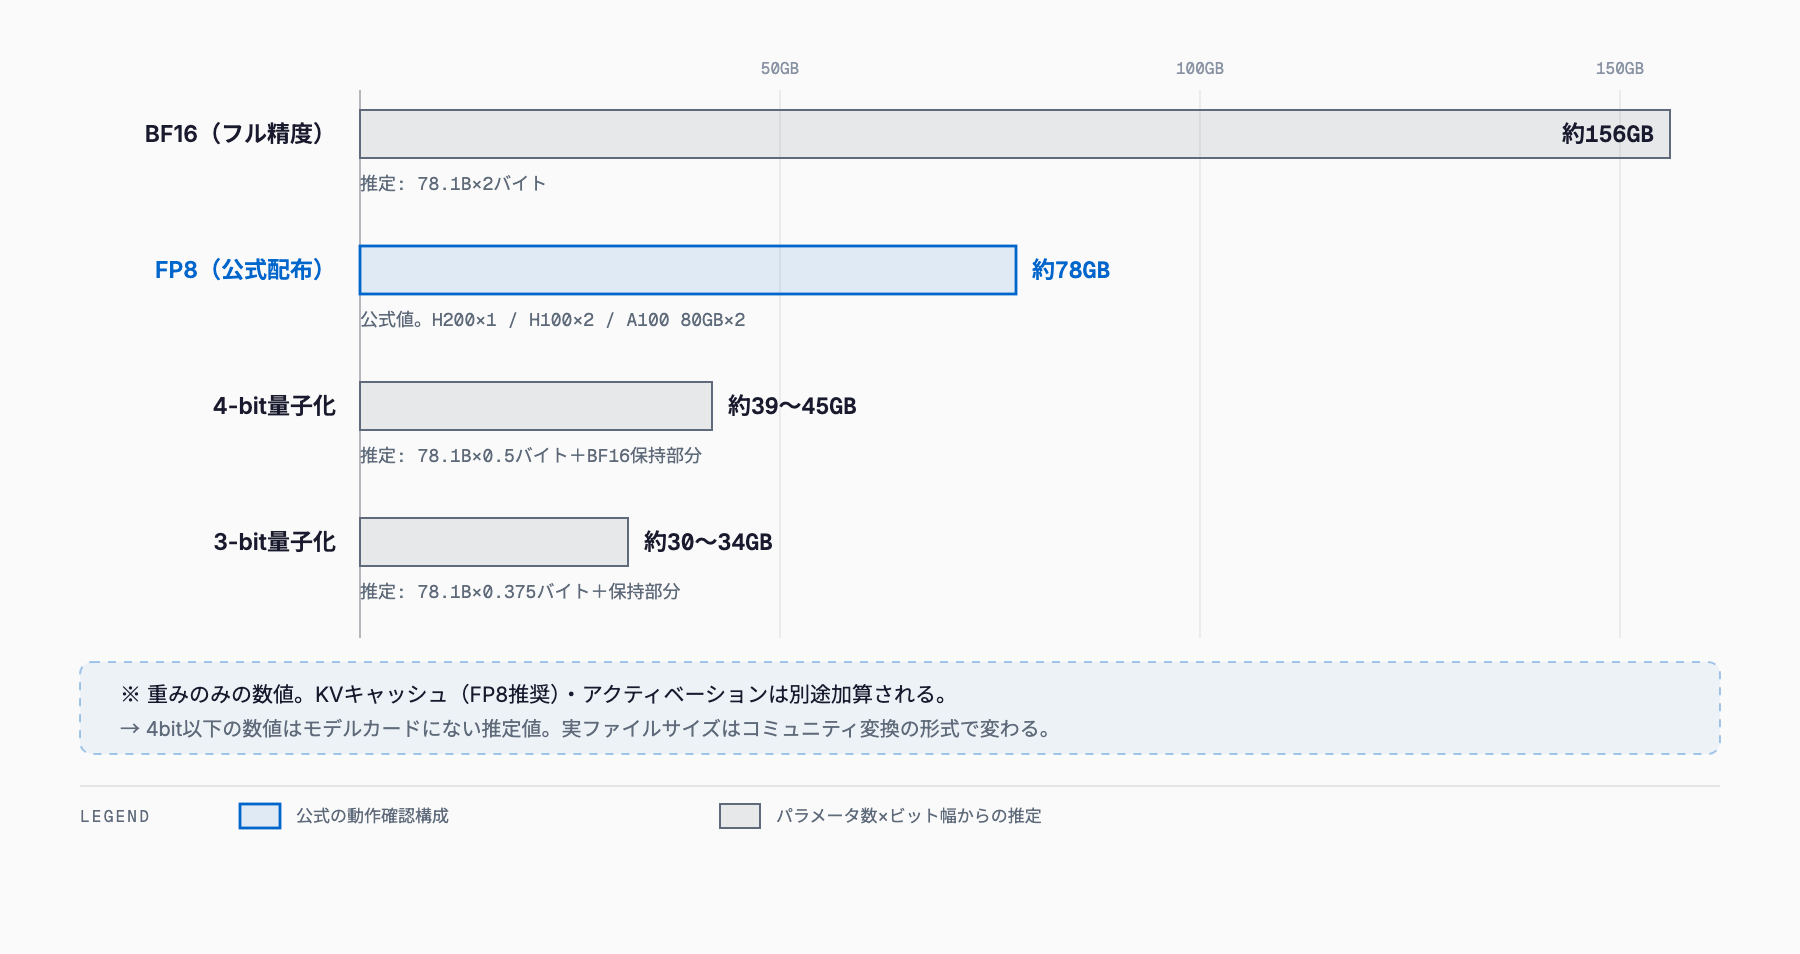
| 精度 | 重みメモリ | 区分 | GPU構成の目安 |
|---|---|---|---|
| BF16 | 約156GB | 推定 | H200×2枚(282GB)、またはH100×3〜4枚 |
| FP8(公式配布) | 約78GB | 公式 | H200×1枚、B200×1枚、H100×2枚、A100 80GB×2枚 |
| 4bit量子化 | 約39〜45GB | 推定 | RTX 6000 Blackwell(96GB)×1枚、A100/H100 80GB×1枚(KVは余裕小) |
| 3bit量子化 | 約30〜34GB | 推定 | 48GBクラスGPU×1枚、RTX 5090(32GB)は余裕なし |
手元の機材で動くかをモデル・量子化・コンテキスト長から試算したい場合は、VRAM計算ツール(無料・登録不要)も使える。Kolibri-1もモデル一覧から選べる。
公式推奨構成と実測報告
モデルカードの最小構成は、A100 80GB×2、H100 SXM5×2、H200×1、B200×1、B300×1。推奨は、H100 SXM5×2、H200×2、B200×1、B300×1だ。FP8重みの約78GBに対し、80GB級GPU 1枚では収まらないため、80GB級なら2枚(合計160GB)が必要になる。H200(141GB)・B200・B300なら1枚で重みが載り、残りがKVキャッシュに回る。
コミュニティの実測として、NVIDIAの開発者フォーラムに、128GBメモリのDGX Spark(GB10)でFP8のKolibri-1を動かした報告がある。重みだけで73.5GiBを占め、vLLM 0.29.0での2,048トークンのプロンプトでは、コンテキスト0でプレフィル約1,402 tok/s・デコード約20.4 tok/s、32kコンテキストでデコード約19.6 tok/sだった。起動(重みのロード)には18〜25分かかったという。また、SM121向け最適化を入れたvLLM 0.30.1rc1では約48 tok/sのデコードも報告されている。単独のユーザー報告であり、公式値ではない点に注意したい。
Macやコンシューマ向けRTXで動くか(推定)
以下は公式の動作確認ではなく、メモリ容量からの推定である。Apple Siliconは、128GBや192GBのUnified Memoryを持つMac Studio等であれば、FP8の約78GBや4bitの約39〜45GBは容量的に収まる。ただしmacOSでGPUに割り当て可能な量には上限があり、またモデルカードが案内するvLLMのFP8構成はNVIDIA GPU向けのため、Macで動かすにはMLXやGGUFなどコミュニティ変換版の登場と対応状況の確認が必要になる(本記事執筆時点では未確認)。
RTXなどのコンシューマGPUでは、4bit(約39〜45GB)なら24GB級を2枚(合計48GB)で重みがほぼ限界、32GBのRTX 5090を2枚(合計64GB)なら余裕が出る計算だ。アクティブが約3.46Bと小さいため、エキスパートをシステムRAM側に置くオフロード運用でも実用速度が出る可能性はあるが、これも推定の域を出ない。なお、最大で約78GB規模の重みに加えてKVキャッシュも必要なので、メモリ設計は余裕を持たせたい。
vLLMでの起動例(モデルカード記載)
モデルカードのvLLM起動コマンドは次のとおり。FP8のKVキャッシュと、Kolibri用の推論パーサ・ツール呼び出しパーサを指定する。
vllm serve Aleph-Alpha/Kolibri-1 --kv-cache-dtype fp8 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
262,144トークンを超えるコンテキストを使う場合は、上記に次の引数を追加する。ただし公式は、効率と複雑なタスクの品質のため262,144以下での運用を推奨している。
--max-model-len 1048576 --hf-overrides '{"max_position_embeddings": 1048576}'推奨サンプリング設定はtemperature=1.0、top_p=0.97、top_k=128。推論の深さは、チャットテンプレートでlow・medium・high・noneから選べる。前述のDGX Sparkの報告では、思考モードが既定で有効になり、推論内容は別フィールドに出力されたという。
日本企業にとっての意味 — 日本語は主対象外
Kolibri-1の対応言語はドイツ語と英語で、日本語は主対象ではない。日本語の業務文書や顧客対応にそのまま使えるとは言えず、日本語性能は公式にも示されていないため、採用前に自社データでの検証が必須になる。日本語中心の用途なら、日本語に強い他のオープンウェイトモデルを先に検討するのが現実的だろう。
一方で、検討に値する場面もある。ドイツ語圏の取引先や拠点とのやりとりを自社環境で処理したい企業、ドイツ語・英語の文書を機密のままローカルで扱いたい場合、あるいは「主権AI」「データを外に出さない運用」の設計参考として、Apache 2.0で重みが公開されている点は評価できる。商用利用のハードルは低いが、重みのみがApache 2.0で、モデルカードによれば基盤コード・アーキテクチャ・学習手法は対象外とされる点は確認しておきたい。
同規模のオープンウェイトMoEとの比較
同じく2026年に公開された大規模MoEと並べると、Kolibri-1は「総パラメータが小さく、必要メモリも小さい」側に位置する。他モデルの数値は、当サイトの各requirements記事に基づく。
| モデル | 総/アクティブ | 目安メモリ | ライセンス | 主な言語・特徴 |
|---|---|---|---|---|
| Kolibri-1(本記事) | 約78B / 約3.46B | FP8 約78GB、4bit 約39〜45GB(推定) | Apache 2.0 | ドイツ語・英語特化 |
| Qwen3.8-Flash-Next | 125B / 約6B | 4bit 約111GB、BF16 約354GB | Qwen Community License 1.0 | 多言語・マルチモーダル |
| GLM-5.3-Flash | 320B / 18B | 4bit 約190GB、BF16 約740GB(推定) | MIT | マルチモーダル、1Mコンテキスト |
| MiMo-V2.6-Flash | 309B / 15B | FP8 約320〜350GB、4bit 約110〜190GB(推定) | 各記事参照 | 1Mコンテキスト |
同じ「重み数百GB」の世界でも、Kolibri-1は80GB級GPUを2枚、あるいはH200 1枚で収まる規模で、4bitなら1枚の大容量ワークステーションGPUも射程に入る。反面、日本語を含む多言語運用が必要なら、表のQwen系などのほうが選択肢として合う場面が多い。
導入前の注意点
- 言語の対象範囲: ドイツ語・英語が主で、日本語性能は公式に示されていない
- 4bit以下の数値は推定: モデルカードにあるのはFP8の約78GBまで。量子化版の実サイズは変換形式で変わる
- KVキャッシュは別枠: FP8 KVを推奨。262Kや1Mまで伸ばすと重み以外のメモリが大きく増える
- 起動に時間がかかる: DGX Sparkの報告では重みのロードに18〜25分
- ライセンスの範囲: Apache 2.0は重みが対象で、基盤コード・学習手法は含まない(モデルカード記載)
- ベンチマークはベンダー公表値: モデルカードの総合スコアは英語75.5%、ドイツ語70.8%で、実業務での性能は自社検証で確認する
よくある質問
Kolibri-1を動かすのに必要なVRAMはどれくらいですか?
公式のFP8重みで約78GBです。最小構成はA100 80GB×2枚、H100×2枚、H200×1枚、B200×1枚、B300×1枚で、KVキャッシュ分の余裕も必要です。4bit量子化は推定で約39〜45GBです。
RTX 4090やMacで動きますか?
公式の動作確認はデータセンターGPUです。メモリ容量だけで見れば、4bit量子化なら24GB級の2枚や128GB以上のMacに収まる計算ですが、これは推定で、対応する量子化版の有無も別途確認が必要です。
日本語は使えますか?
公式の対象言語はドイツ語と英語で、日本語性能は示されていません。日本語用途では自社データでの検証が必須です。
コンテキスト長はどれくらいですか?
ネイティブ262,144トークンで、検証済みの最大は1,048,576トークンです。公式は効率と品質のため262,144以下を推奨しています。
商用利用できますか?
重みはApache 2.0で、商用利用のハードルは低いです。ただしモデルカードによれば、基盤コード・アーキテクチャ・学習手法はライセンス対象外です。
MoEなのにアクティブが3.46Bでもメモリが大きいのはなぜですか?
トークンごとに使うエキスパートは変わるため、全エキスパートの重みを高速メモリに置く必要があります。計算量は軽くても、必要メモリは総パラメータ約78B分です。
まとめ
Kolibri-1は、約78B・アクティブ約3.46BのApache 2.0オープンウェイトMoEで、FP8重み約78GB、H200×1枚またはH100×2枚から動かせる、ドイツ語・英語特化のモデルだ。4bit量子化は推定で約39〜45GBだが、公式の動作確認はデータセンターGPUに限られる。日本語は主対象外のため、日本企業が使う場合は、ドイツ語圏とのやりとりや主権AIの参考といった用途で、自社データでの検証を前提に判断したい。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ