Ternary Bonsai 2 27B 必要スペック — 5.9GB・RAM16GBで動く1.76bit版
PrismMLが2026年9月17日に公開したTernary Bonsai 2 27Bを解説。Qwen3.8-27Bを三値重み量子化し1.76bit・5.9GBに圧縮、RAM16GBや24GB GPU一枚で動作する。精度はFP16比98.2%を維持し、Apache 2.0で商用利用も可能。2026年9月更新。
Ternary Bonsai 2 27Bは、PrismMLが2026年9月17日に公開したQwen3.8-27B派生の三値量子化モデルで、必要メモリはわずか5.9GB(1.76 effective bits/weight)。RAM16GBのノートPCか、単体24GB GPU(RTX 4090など)1枚で動作する。FP16換算54GBに対し9倍以上の圧縮でありながら、公式ベンチマークではQwen3.8-27B(FP16)比98.2%の精度を維持している。
本記事は必要スペックの早見表と、前世代モデル(PrismML Bonsai 27B)・ベースモデル(Qwen3.8-27B)との違いをまとめたものである。
必要スペック早見表
| 項目 | 内容 |
|---|---|
| 公開日 | 2026年9月17日(PrismML公式発表、HF公開は9月17〜18日) |
| ライセンス | Apache 2.0 |
| ベースモデル | Qwen3.8-27B(ハイブリッド注意:線形75%/フルアテンション25%) |
| 総パラメータ数 | 27.36B(バックボーン24.35B+埋め込み/LMヘッド2.54B+Vision Tower 0.46B) |
| 対応入力 | テキスト+画像(マルチモーダル) |
| コンテキスト長 | 262,144トークン |
| 最大出力 | 32,768トークン |
| ツール呼び出し | 対応(Function Calling/JSON Schema構造化出力) |
| 量子化方式 | 三値重み{-1, 0, +1}+FP16グループ単位スケール(グループサイズ128) |
| 実効ビット数 | 1.76 bit/weight(公式値) |
| 総フットプリント | 5.9GB(公式値、FP16比9倍以上の圧縮) |
| 最小動作環境の目安 | RAM 16GB、または単体24GB GPU |
Ternary Bonsai 2 27Bとは — Qwen3.8-27Bの後継圧縮版
PrismMLは2026年7月に、Qwen3.6-27Bをポストホック量子化した「Bonsai 27B」(Ternary版1.71bit・5.9GB、FP16比94.6%維持)を発表していた。Ternary Bonsai 2 27Bはそのバージョン2にあたり、ベースモデルをQwen3.8-27B(線形注意とフルアテンションを混在させたハイブリッド構成、262Kコンテキスト、マルチモーダル対応)に切り替えて再構築したものである。
ベースモデルの世代が上がったことに加え、PrismML自身の量子化手法も改良されており、公式発表では「インテリジェンス密度」(GBあたりの性能指標)が前バージョンの0.416から0.457へ、約9.9%向上したとされている。モデルの容量はほぼ同じ5.9GB帯を維持しつつ、中身の性能が底上げされた格好である。
量子化方式 — 三値重み+FP16グループスケール
重みは{-1, 0, +1}の3値に量子化され、128個の重みごとにFP16のスケール係数を1つ持つグループ単位量子化が採用されている。この方式により、単純な2bit量子化よりも情報保持効率が高くなり、公式発表の実効ビット数は1.76 bit/weightとなる。モデルカードにはVision Tower(画像入力用エンコーダ)部分の量子化情報も含まれる。
なぜグループ単位のスケールが効くのか。三値だけでは表現力が乏しいが、128個ごとにFP16のスケール係数を挟むことで、局所的な重みの大小関係を保ったまま量子化誤差を抑えられる。グループサイズを小さくするほど精度は上がるがスケール係数のオーバーヘッドが増え、逆に大きくすると容量は下がるが精度が落ちる。128という値は、その両者のバランスを取った実用上の落としどころといえる。
配布パッケージ(GGUF / MLX)のサイズ比較
| パッケージ | 方式 | bit/weight | サイズ |
|---|---|---|---|
| PTQ1_0(GGUF) | 密な三値格納 | 1.75 bpw | 5.95GB |
| PQ2_0(GGUF) | 2bitスロット格納 | 2.13 bpw | 7.21GB |
| Vision Tower(任意・Q8_0) | 画像入力用エンコーダ | — | 0.63GB追加 |
| MLX 2bit版 | Apple Silicon向け(prism-ml/Ternary-Bonsai-2-27B-mlx-2bit) | 2bit相当 | GGUF PQ2_0に準ずる |
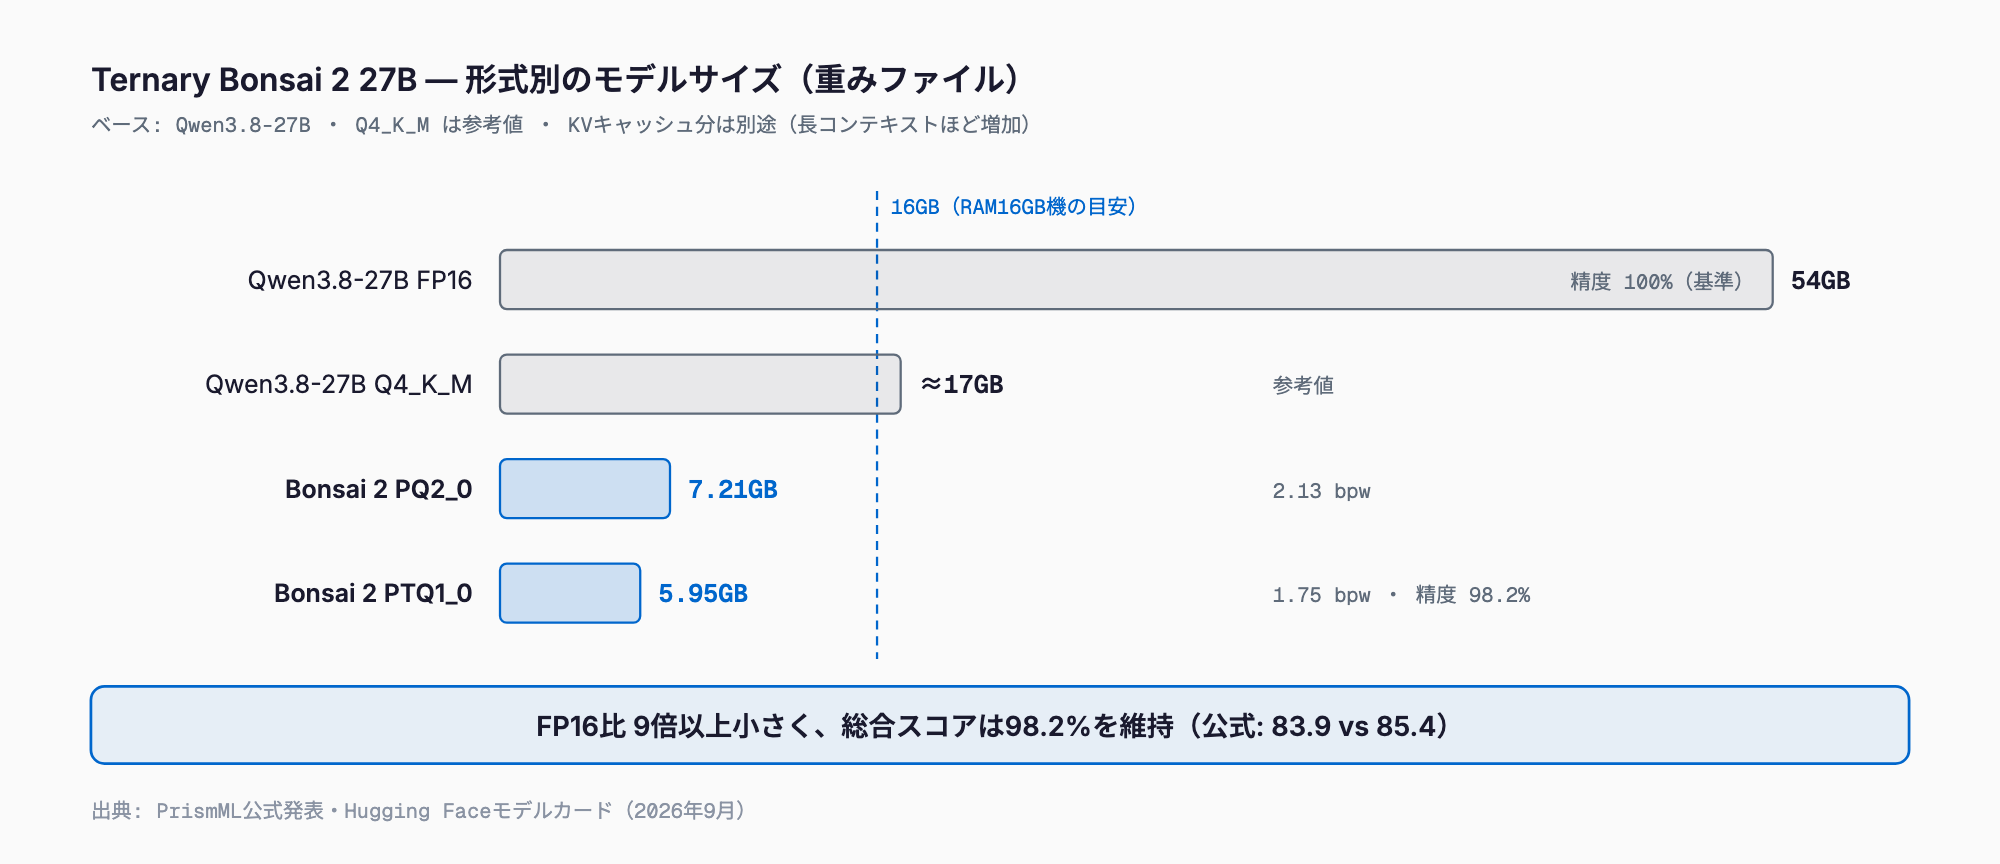
PTQ1_0は理論値に近い1.75 bpwで最小サイズだが、実行速度やハードウェア対応の都合でPQ2_0(2bitスロットに詰める方式)を使う場面もある。画像入力を使う場合はVision Tower分(Q8_0で約0.63GB)が別途加算される点に注意したい。
数値の出どころにも触れておく。「総合スコア」は公式発表とモデルカードで83.9/84.78という近いが異なる値が示されている。前者はPrismMLのプレスリリース、後者はモデルカードに載る14種のthinkingモードベンチマーク平均であり、評価セットが完全一致しているとは限らない。どちらの数値でもFP16比の維持率は98.2%とほぼ一致しており、本記事では両方を併記した上でこの98.2%という維持率を代表値として扱う。
ベンチマーク — 精度はどれだけ残るか
| 指標 | Ternary Bonsai 2 27B | Qwen3.8-27B(FP16) | 維持率 |
|---|---|---|---|
| 総合スコア(公式発表) | 83.9 | 85.4 | 98.2% |
| 総合スコア(モデルカード・14種thinkingモード平均) | 84.78 | 86.32 | 98.2% |
| Math | 96.57 | 97.06 | 99.5% |
| Coding | 89.42 | 89.07 | 100.4%(上回る) |
| Knowledge & Reasoning | 79.86 | 85.55 | 93.3% |
分野別では、MathとCodingはFP16とほぼ同等かむしろ上回る結果になっている一方、Knowledge & Reasoningの落ち込みがやや大きい。三値量子化は「計算・推論の手続き」よりも「広範な知識の保持」で精度が落ちやすい傾向がうかがえる。なお、同程度に低bitなIQ2_XXS(72.59)と比較すると、Ternary Bonsai 2 27Bはそのサイズの約82%でありながら12ポイント以上上回っており、単純な低bit量子化との差は大きい。
速度 — RTX 5090で最大143 tok/s、Apple Siliconでも実用域
| ハードウェア | 指標 | 数値 |
|---|---|---|
| RTX 5090 | 生成速度(公式最大値) | 143 tok/s |
| RTX 5090 | TG128(モデルカード・PQ2_0) | 129.9 tok/s |
| Apple M5 Max | TG128 | 47 tok/s |
| Apple M5 Pro | TG128 | 28.1 tok/s |
| L4(72W) | TG128 | 29.8 tok/s |
| RTX PRO 6000 Blackwell | PP512(プロンプト処理) | 4,020 tok/s |
| Apple M5 Max | PP512(プロンプト処理) | 765 tok/s |
| RTX 4090 | 消費電力 | 0.714 mWh/token |
生成速度(TG128)とプロンプト処理速度(PP512)は別指標であり、長文の入力を扱う用途ではPP512の数値も確認したい。Apple Silicon(M5系)でも実用的な速度が出ており、Mac一台でのオフライン運用が現実的な選択肢になる。
動作環境 — RAM16GB/24GB GPUで動くが、長コンテキストはメモリ増を見込む
公式発表・各種レポートでは「RAM 16GBのマシン、または単体24GB GPU 1枚で動作する」とされている。ただし、この目安はモデル重み(5.9GB前後)+実行時のオーバーヘッドを想定した数値であり、262Kという最大コンテキスト長をフルに使う場合はKVキャッシュの分だけ追加のメモリが必要になる点は踏まえておきたい。公式に具体的なコンテキスト長別のメモリ増加量は公表されていないため、短い入出力であれば16GB帯、長文・長会話を扱うなら余裕を持ったメモリ構成を選ぶのが無難である。
前世代Bonsai 27B・Qwen3.8-27Bとの比較
| モデル | ベース | 量子化 | サイズ | FP16比精度維持率 |
|---|---|---|---|---|
| Qwen3.8-27B(BF16) | — | なし | 約56GB | 100%(基準) |
| Qwen3.8-27B(Q4_K_M・GGUF参考値) | — | 4bit | 約17GB(詳細) | — |
| PrismML Bonsai 27B(前世代・Ternary) | Qwen3.6-27B | 1.71bit(5.9GB) | 5.9GB | 94.6% |
| Ternary Bonsai 2 27B(本記事) | Qwen3.8-27B | 1.76bit(5.9GB) | 5.9GB | 98.2% |
サイズはほぼ同じ5.9GB帯を維持しながら、ベースモデルの世代交代と量子化手法の改善により精度維持率が94.6%→98.2%へ改善している。「27Bクラスを5.9GBで動かす」という価値提案は変わらず、その中身の実用性が上がったと捉えるのが適切である。
どの選択肢を使うかは、手元の環境とワークロードで決まる。Linux/WindowsでNVIDIA GPUを使う場合はllama.cppのPrismMLフォーク一択になる。Mac・iPhone・iPadで完結させたい場合はMLX版が扱いやすく、GUIツールに組み込んで使いたい場合はOllamaのコミュニティ版を試す選択肢もある。まずクラウドAPIで挙動や精度を確認してから、自社環境への導入コストと見合うかを判断する進め方も現実的である。
実行方法 — llama.cpp fork/MLX/Ollama/API
- llama.cpp: 三値カーネルに対応したPrismML独自フォーク(CUDA/Metal/CPU対応)が必要。通常のllama.cpp本家ビルドでは三値重みを正しく展開できない
- MLX(Apple Silicon): Mac・iPhone・iPad向けにprism-ml/Ternary-Bonsai-2-27B-mlx-2bitが用意されている
- Ollama: 公式配布ではなくコミュニティによるアップロードが存在する。導入時のツール選びはOllama vs LM Studio比較記事を参照してほしい
- API(OpenRouter): セルフホストなしで試す場合、入力$0.075/Mトークン・出力$0.50/Mトークンで利用可能
FAQ
Ternary Bonsai 2 27BはVRAM計算ツールで試算できますか?
現時点ではできない。当サイトの無料VRAM計算ツールは「総パラメータ数×bit/weight」という通常の量子化式を前提としており、三値量子化+FP16グループスケールという特殊な圧縮方式には未対応である。本記事の実容量(5.9GB前後)を目安にしてほしい。
通常のllama.cppで動きますか?
動かない。三値重みを正しく展開するには、PrismMLが公開している三値カーネル対応フォーク(CUDA/Metal/CPU)が必要。本家llama.cppのリリースに三値量子化の対応が取り込まれるかは未定である。
Qwen3.8-27B(FP16やQ4_K_M)と比べてどちらを選ぶべきですか?
メモリが潤沢(32GB以上のVRAM)でGGUF/MLXの三値カーネル導入が手間になる場合はQwen3.8-27BのQ4_K_M(約17GB)などが無難。メモリが16GB前後しかない、あるいはノートPC・Mac・小型GPUで27Bクラスを動かしたい場合はTernary Bonsai 2 27Bが有力な選択肢になる。
前世代のBonsai 27Bから乗り換える価値はありますか?
サイズはほぼ同じ5.9GB帯のまま、ベースモデルがQwen3.6-27BからQwen3.8-27Bへ、精度維持率が94.6%から98.2%へ改善している。同じメモリ予算でより高い精度を得られるため、乗り換えの価値は高い。
画像入力(マルチモーダル)を使う場合、追加で何が必要ですか?
Vision Tower部分(Q8_0量子化で約0.63GB)が本体の量子化ファイルとは別に必要になる。テキストのみの用途であれば省略できる。
クラウドAPIとして試す方法はありますか?
OpenRouter経由で、入力$0.075/Mトークン・出力$0.50/Mトークンで利用できる。セルフホスト環境を用意する前に、まずAPIで挙動を確認する使い方もできる。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ