VoiceStudioとは何か 完全ローカルで動くElevenLabs代替の音声AIツール
2026年9月にGitHub Trendingで急上昇したdebpalash/VoiceStudio(旧OmniVoice-Studio)を解説。音声クローン・ボイスデザイン・動画吹き替え・ディクテーション・文字起こし・オーディオブック作成を完全ローカルで実行できる仕組み、TTS16/ASR11エンジン構成、インストール手順、ローカルAPI/MCP対応、ElevenLabsなど既存ツールとの違いを整理する。
VoiceStudioとは何か — ローカル完結のElevenLabs代替
VoiceStudio(debpalash/VoiceStudio、旧名OmniVoice-Studio)は、音声クローン・ボイスデザイン・動画吹き替え・ディクテーション・文字起こし・オーディオブック作成をすべて自分のPC上で実行できる、オープンソースのデスクトップアプリである。クラウドAPIの従量課金やアカウント登録を必要とせず、646言語のカタログとTTS16種・ASR11種のエンジンを内蔵し、ローカルAPIとMCP(Model Context Protocol)経由で他のアプリやAIエージェントからも呼び出せる。2026年9月時点でGitHub Trendingで急上昇しており、スター数・フォーク数が短期間で伸びている。
何ができるか
- 音声クローン: 短い音声サンプルからゼロショットで声を複製
- ボイスデザイン: 年齢・アクセント・ピッチを指定して声そのものを新規に作る
- 動画吹き替え: 翻訳・話者の声の保持・音声合成・書き出しまでを一括処理
- ディクテーション: OS全体で使えるショートカットで音声入力
- 文字起こし: ASRエンジンによる音声からテキストへの変換
- オーディオブック作成: 複数の声を使い分け、EPUB/PDFを取り込んでm4b形式で出力
音声クローンは既定エンジンのOmniVoiceが拡散モデル(diffusionベースのTTS)を参照音声に条件付けするゼロショット方式で、事前の追加学習は不要。公式の推奨は「5〜15秒、単一話者、マイクに近い、BGM・ノイズ・リバーブなし」の音声で、最短では3秒のクリップからでもクローンできるとされている。
ボイスデザインは既存の話者を複製するのではなく、年齢・アクセント・ピッチといったパラメータから新しい声を合成する機能で、実在の人物の声を使わずにナレーションやキャラクターボイスを作りたい場合に向く。
動画吹き替えは、元動画のセリフを翻訳し、話者ごとの声の特徴を保ったまま別言語の音声を合成、映像に合わせて書き出すところまでを一連の処理として提供する。646言語カタログを使えば、対応言語の組み合わせ次第で多言語展開の下地に使える。
ディクテーションはOSレベルのショートカットからどのアプリにでも音声入力できる機能で、ASRエンジン(既定はWhisperX)を使ってリアルタイムに近い速度でテキスト化する。文字起こしは録音済み音声ファイルからの書き起こし用途で、同じASRエンジン群を利用する。
技術スタックとエンジン構成
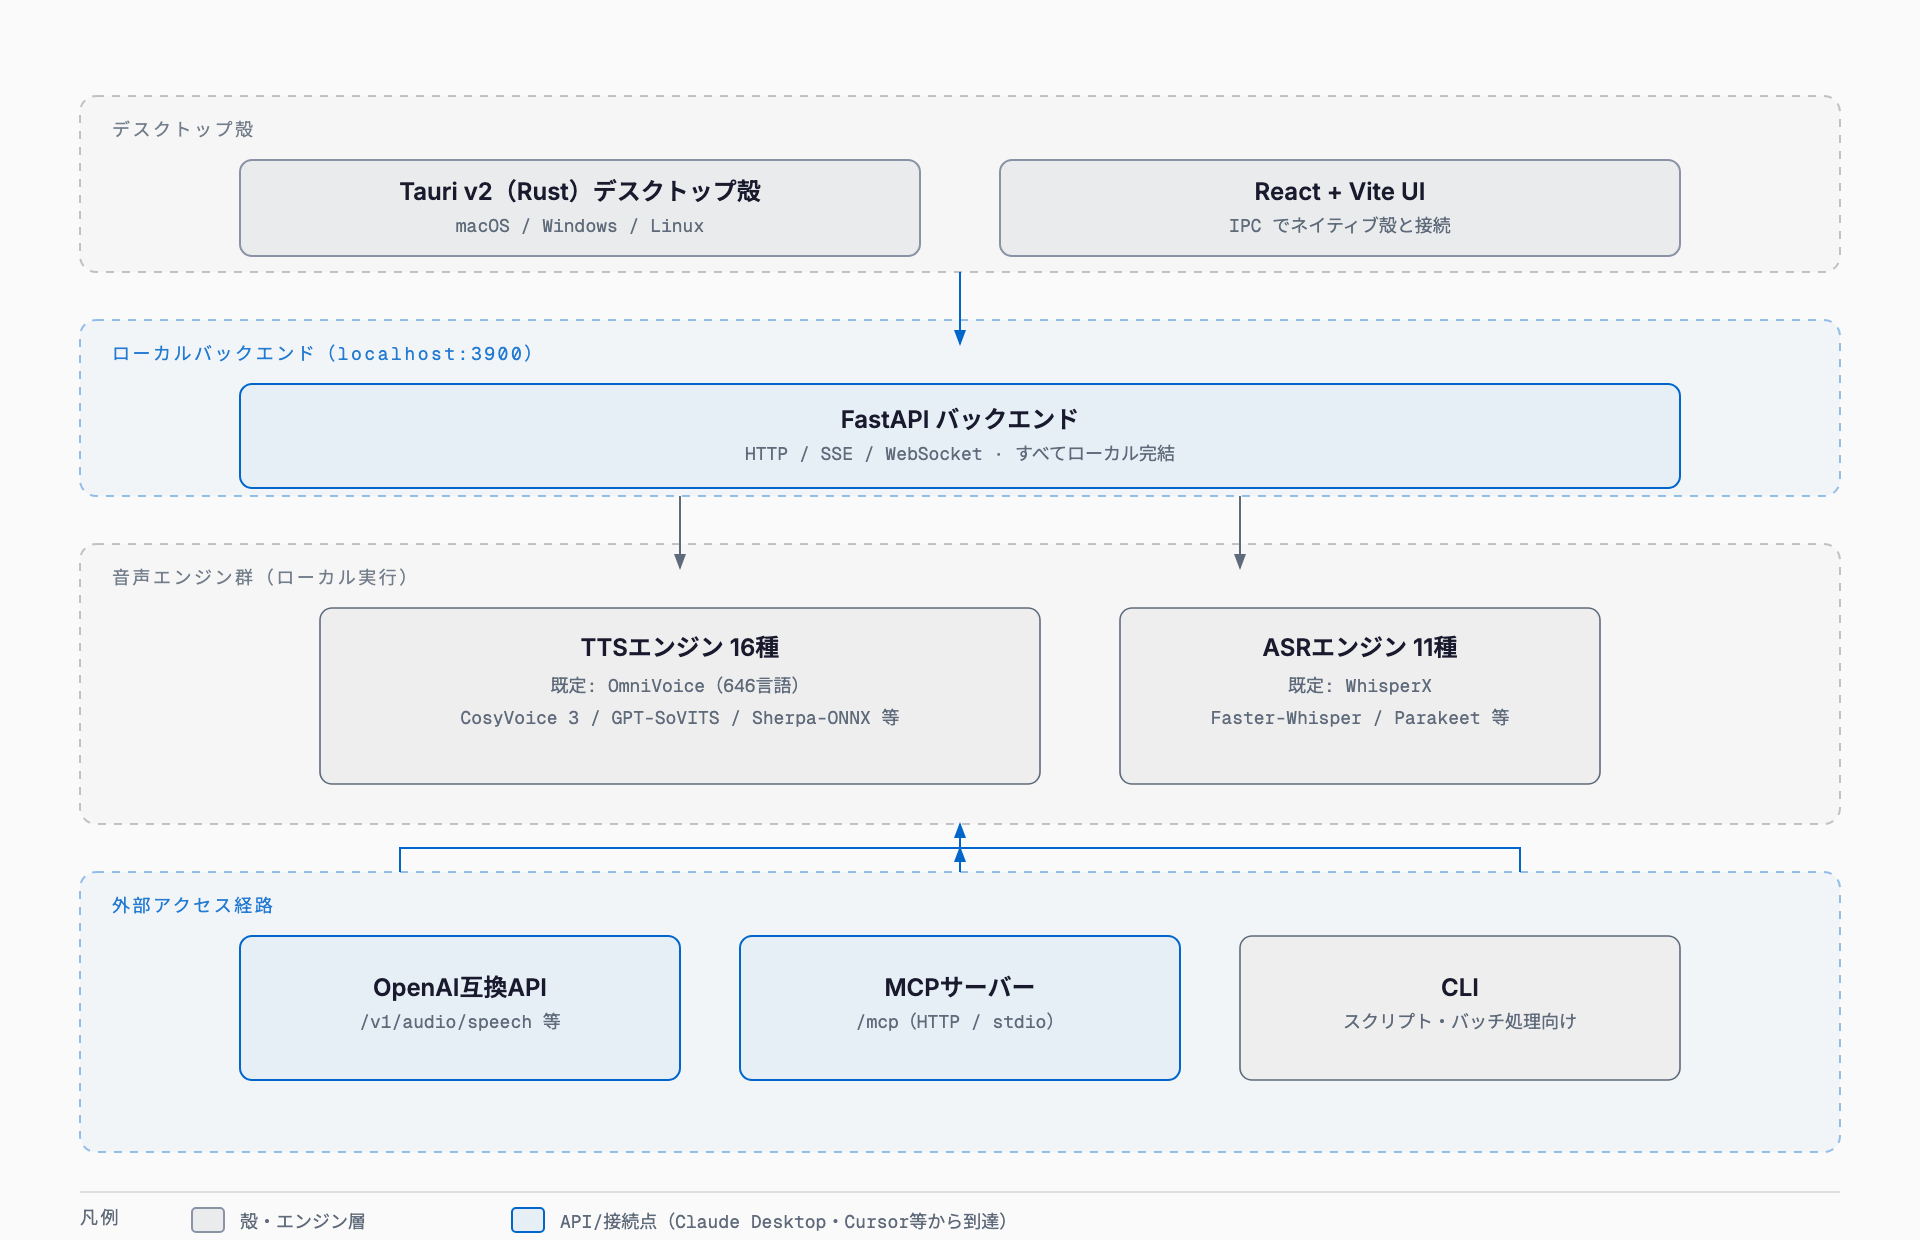
VoiceStudioはTauri v2(Rust製のデスクトップアプリフレームワーク)のシェルにReact + Viteで作られたUIを組み込み、IPCで通信する構成を取る。実際の音声処理はlocalhost:3900で動くFastAPI製のバックエンドが担当し、HTTP・SSE(Server-Sent Events)・WebSocketの3系統でUIやAPI利用者と通信する。バックエンドの下にTTSエンジン16種・ASRエンジン11種が搭載されており、用途や実行環境(NVIDIA GPU、Apple Silicon、CPUのみ等)に応じて切り替えられる。
| TTSエンジン(16種) | 特徴 |
|---|---|
| OmniVoice(既定) | 646言語対応、拡散ベースのゼロショットクローン |
| CosyVoice 3 | 多言語対応の高品質TTSモデル |
| GPT-SoVITS | 少量サンプルでの声質再現に強い |
| IndexTTS 2.5 | 高精度なゼロショットTTS |
| VoxCPM2 / MOSS-TTS Nano・v1.5 | 軽量〜中量級のTTSモデル群 |
| KittenTTS / PocketTTS | 低リソース環境向けの軽量エンジン |
| MLX-Audio | Apple Silicon(MLX)最適化 |
| Sherpa-ONNX | ONNX Runtime ベースの軽量推論 |
| OmniVoice GGUF / OmniVoice subprocess | OmniVoiceの派生実行形態 |
| Supertonic 3 / dots.tts / Confucius4-TTS | その他対応エンジン |
| ASRエンジン(11種) | 特徴 |
|---|---|
| WhisperX(既定) | Whisperベース、タイムスタンプ精度が高い |
| Faster-Whisper / Faster-Whisper isolated | Whisperの高速推論実装 |
| PyTorch Whisper | OpenAI Whisperの標準実装 |
| MLX Whisper | Apple Silicon(MLX)最適化 |
| Parakeet TDT / Parakeet TDT v3 MLX | NVIDIA系の高速ASRモデル |
| Moonshine | 軽量なストリーミング向けASR |
| FunASR | 中国語を含む多言語対応ASR |
| sherpa-onnx | ONNX Runtime ベースの軽量推論 |
| OpenAI互換対応 | 外部Whisper互換APIへの接続 |
インストールと必要スペック
| 項目 | 最小構成 | 推奨構成 |
|---|---|---|
| RAM | 8GB | 16GB以上 |
| ディスク空き容量 | 10GB | 20GB以上(SSD推奨) |
| GPU | 不要(CPUのみ可) | NVIDIA CUDA または Apple Silicon |
| VRAM(GPU使用時) | 4GB | 8GB以上 |
| OS | Windows 10/11 x64、macOS 13.3+(Apple Silicon)、Linux x86_64(glibc 2.39+) | 各OSの現行リリース |
- パッケージ版: 最新リリースからmacOS用DMG・Windows用MSI・Linux用AppImageをダウンロードしてインストール(初回起動時にmanaged Python環境の作成と既定モデルの自動ダウンロードが走る)
- ソースからのビルド: 前提として Node.js 20+ または Bun、Python 3.11+、ffmpeg、uv(Pythonパッケージマネージャ)が必要
- Dockerイメージも提供されており、サーバー用途での導入もできる
git clone https://github.com/debpalash/VoiceStudio.git
cd VoiceStudio
bun install
bun run desktop
モデルは初回起動時にダウンロードされ、以降はネットワーク接続なしでも動作するとされている。GPUがない環境でもCPUのみで動作するが、モデルサイズによっては生成速度が実用的でない場合がある点には注意したい。
使い方の流れ
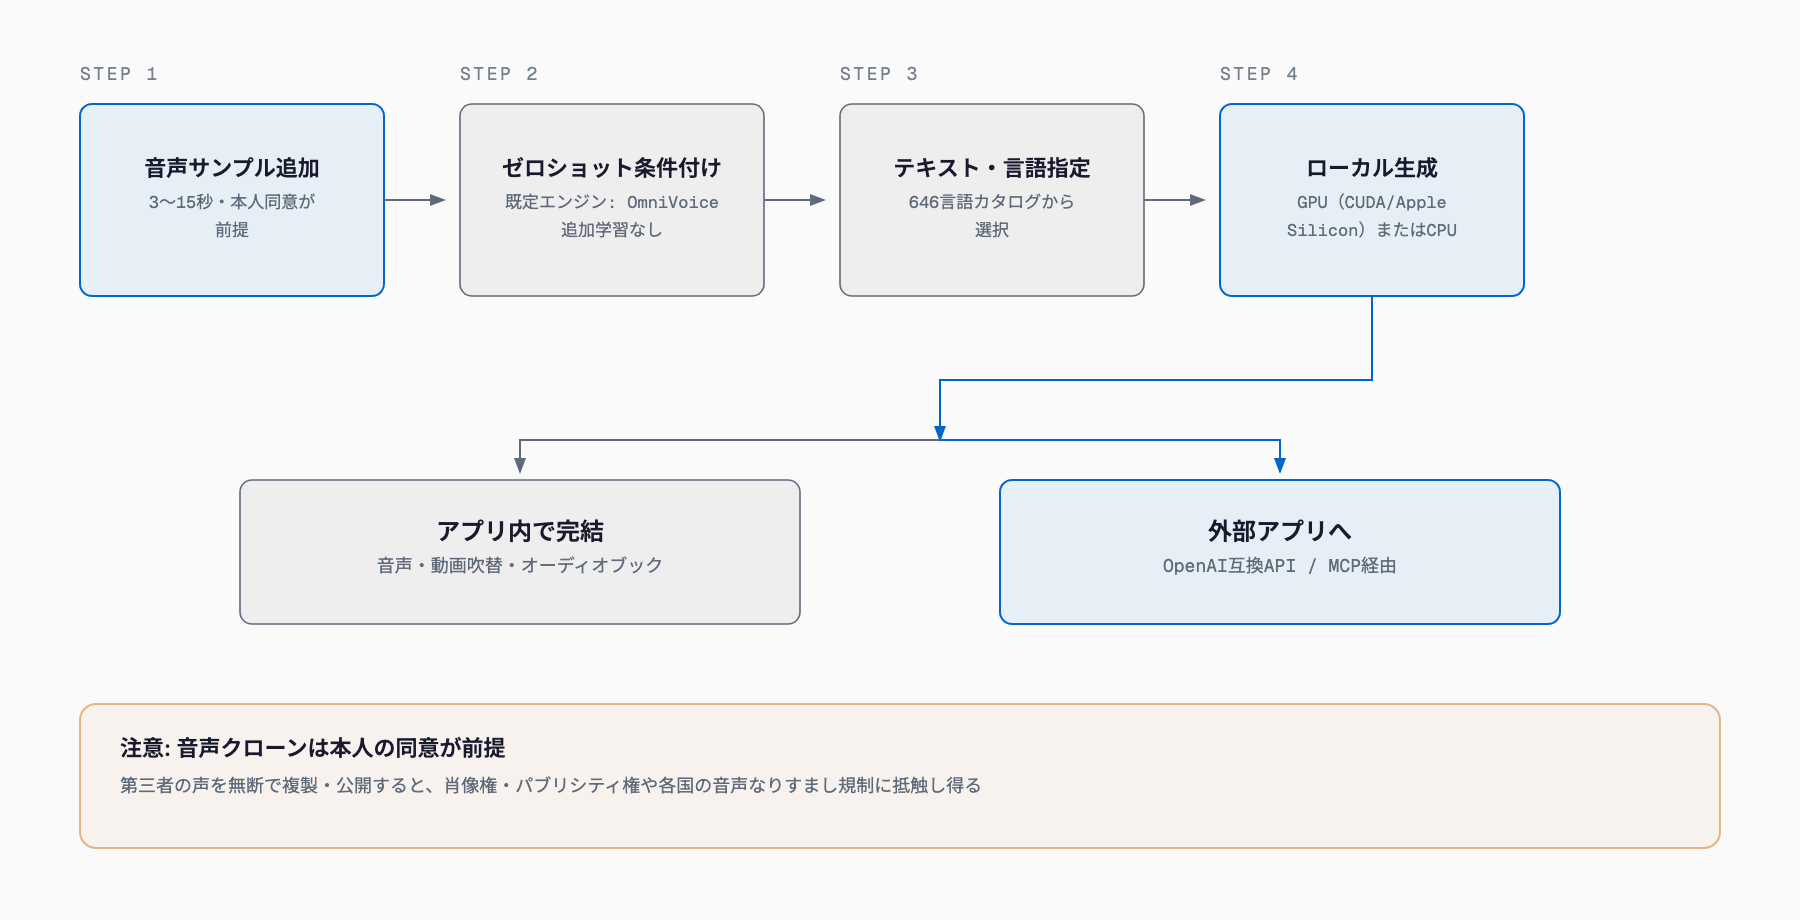
- ステップ1: 本人同意のある音声サンプルを追加(3〜15秒推奨)
- ステップ2: 既定エンジンOmniVoiceがゼロショットで声を条件付け
- ステップ3: 生成したいテキストと言語(646言語カタログから)を指定
- ステップ4: ローカルのGPU(CUDA/Apple Silicon)またはCPUで音声を生成
- ステップ5: アプリ内(音声・動画吹替・オーディオブック)で完結させるか、OpenAI互換API/MCP経由で外部アプリに渡す
ローカルAPIとMCP対応
VoiceStudioはアプリ単体としてだけでなく、ローカルの音声プラットフォームとしても機能する。OpenAI互換のREST API(ベースURL http://localhost:3900/v1)を備え、/v1/audio/speech(テキスト音声変換)・/v1/audio/transcriptions(音声テキスト変換)・/v1/audio/voices(ボイスプロファイル一覧)といったエンドポイントを提供する。既存のOpenAI Audio API向けコードをエンドポイントの向き先だけ変えて流用できる設計だ。
加えてMCP(Model Context Protocol)サーバーをhttp://localhost:3900/mcpまたはstdioトランスポートで公開しており、Claude DesktopやCursorなどMCP対応クライアントから generate_speech(音声生成)・clone_voice(声のクローン)・transcribe(文字起こし)といった機能を直接呼び出せる。AIエージェントに音声入出力の手足を持たせたい場合の選択肢になる。
音声クローンの倫理と同意の注意
音声クローン機能は技術的には第三者の声も含めどんな音声サンプルからでも複製できてしまう。しかし本人の同意なく他人の声を複製・公開する行為は、肖像権やパブリシティ権の侵害、各国・各州で強化されつつある音声なりすまし規制(ディープフェイク関連法)に抵触するおそれがある。VoiceStudioはAGPL-3.0ライセンスのアプリケーション本体を無償で提供するが、利用者が生成した音声の用途・同意取得については利用者自身の責任範囲となる点に注意したい。また、ダウンロードされる各TTS/ASRモデルはVoiceStudio本体とは別にモデルごとの利用規約・ライセンスを保持しており、商用利用時はモデル単位での確認が必要になる。
既存ツールとの違い
| 項目 | VoiceStudio | ElevenLabs | Aqua Voice |
|---|---|---|---|
| 実行場所 | 完全ローカル(自分のPC) | クラウド(ElevenLabs社サーバー) | クラウド |
| 料金体系 | 無料(AGPL-3.0、モデルは個別ライセンス) | 月額サブスクリプション+従量課金 | サブスクリプション |
| 主な用途 | 音声クローン・ボイスデザイン・動画吹き替え・ディクテーション・文字起こし・オーディオブック | 音声クローン・TTS・動画吹き替え・音声エージェント向けAPI | AI音声入力(ディクテーション)に特化 |
| 対応言語目安 | 646言語カタログ(エンジン依存) | 数十言語規模 | 主に英語圏中心 |
| API/連携 | OpenAI互換API+MCPサーバー(ローカル) | 独自クラウドAPI | 専用アプリ・拡張機能中心 |
| データの扱い | 音声・生成物とも端末外に送信されない | 音声データがクラウド事業者を経由 | 音声データがクラウド事業者を経由 |
ElevenLabsは音声品質やAPIの成熟度、音声エージェント向けの周辺機能で先行しているが、クラウド前提のため通信環境や従量課金、音声データの外部送信が制約になる場面がある。VoiceStudioはその対極として「オフラインでも動く」「データが外に出ない」「無料で試せる」点を軸に据えており、動画吹き替えやオーディオブック作成までを1つのアプリでまとめて扱える点が特徴的だ。一方でモデルの生成品質や安定性はエンジン・モデルの組み合わせに左右され、クラウドサービスのように単一の高品質モデルに一本化されているわけではない。
導入時の注意点
VoiceStudioは2026年9月時点でGitHub Trendingに急浮上したばかりのプロジェクトであり、コマンド体系・API仕様・エンジン構成が今後変わる可能性がある。プロジェクト名がOmniVoice-Studioから改名された経緯もあり、ドキュメントやリポジトリのURLも変更されうる。導入前には最新のREADMEとリリースノートを確認し、業務利用する場合はモデルごとのライセンス条件も個別に確認することをすすめる。
関連記事
VoiceStudioは無料で使えますか。
アプリケーション本体はAGPL-3.0ライセンスのオープンソースソフトウェアで無料です。ただし内蔵する各TTS/ASRモデルは個別のライセンスを持つため、商用利用時はモデルごとの利用規約を確認する必要があります。
インターネット接続がなくても使えますか。
初回起動時のモデルダウンロード後は、完全にオフラインで動作するとされています。音声クローン・生成・文字起こしはすべて端末上で処理され、音声データが外部に送信されません。
GPUがなくても使えますか。
CPUのみでも動作しますが、公式にはNVIDIA CUDAまたはApple SiliconのGPU利用が推奨されています。GPUなしの場合、モデルによっては生成に時間がかかります。
OmniVoice-Studioとの違いは何ですか。
VoiceStudioはOmniVoice-Studioの改名後のプロジェクト名です。機能や技術スタックは基本的に同一の後継で、リポジトリはdebpalash/VoiceStudioに移動しています。
Claude DesktopやCursorから音声生成を呼び出せますか。
可能です。VoiceStudioはhttp://localhost:3900/mcpでMCPサーバーを公開しており、generate_speech・clone_voice・transcribeなどの機能をMCP対応クライアントから直接呼び出せます。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ