Nex-N2.5 必要スペック早見表
VRAM 約22GB〜1.6TB級/RTX 4090〜H200マルチノード【2026年9月版】
2026年9月8日にNex-AGIが公開したエージェント特化モデル群Nex-N2.5(Mini 35B/Pro 397B/Max 1.6T)の必要VRAMは、量子化と機種によって約22GBから1.6TB級まで幅がある。モデル別・量子化別の早見表とGPU/Apple Silicon構成の目安をまとめた。
Nex-N2.5の必要VRAMはMiniで約22GB(Q4)、Maxは1.6TB級
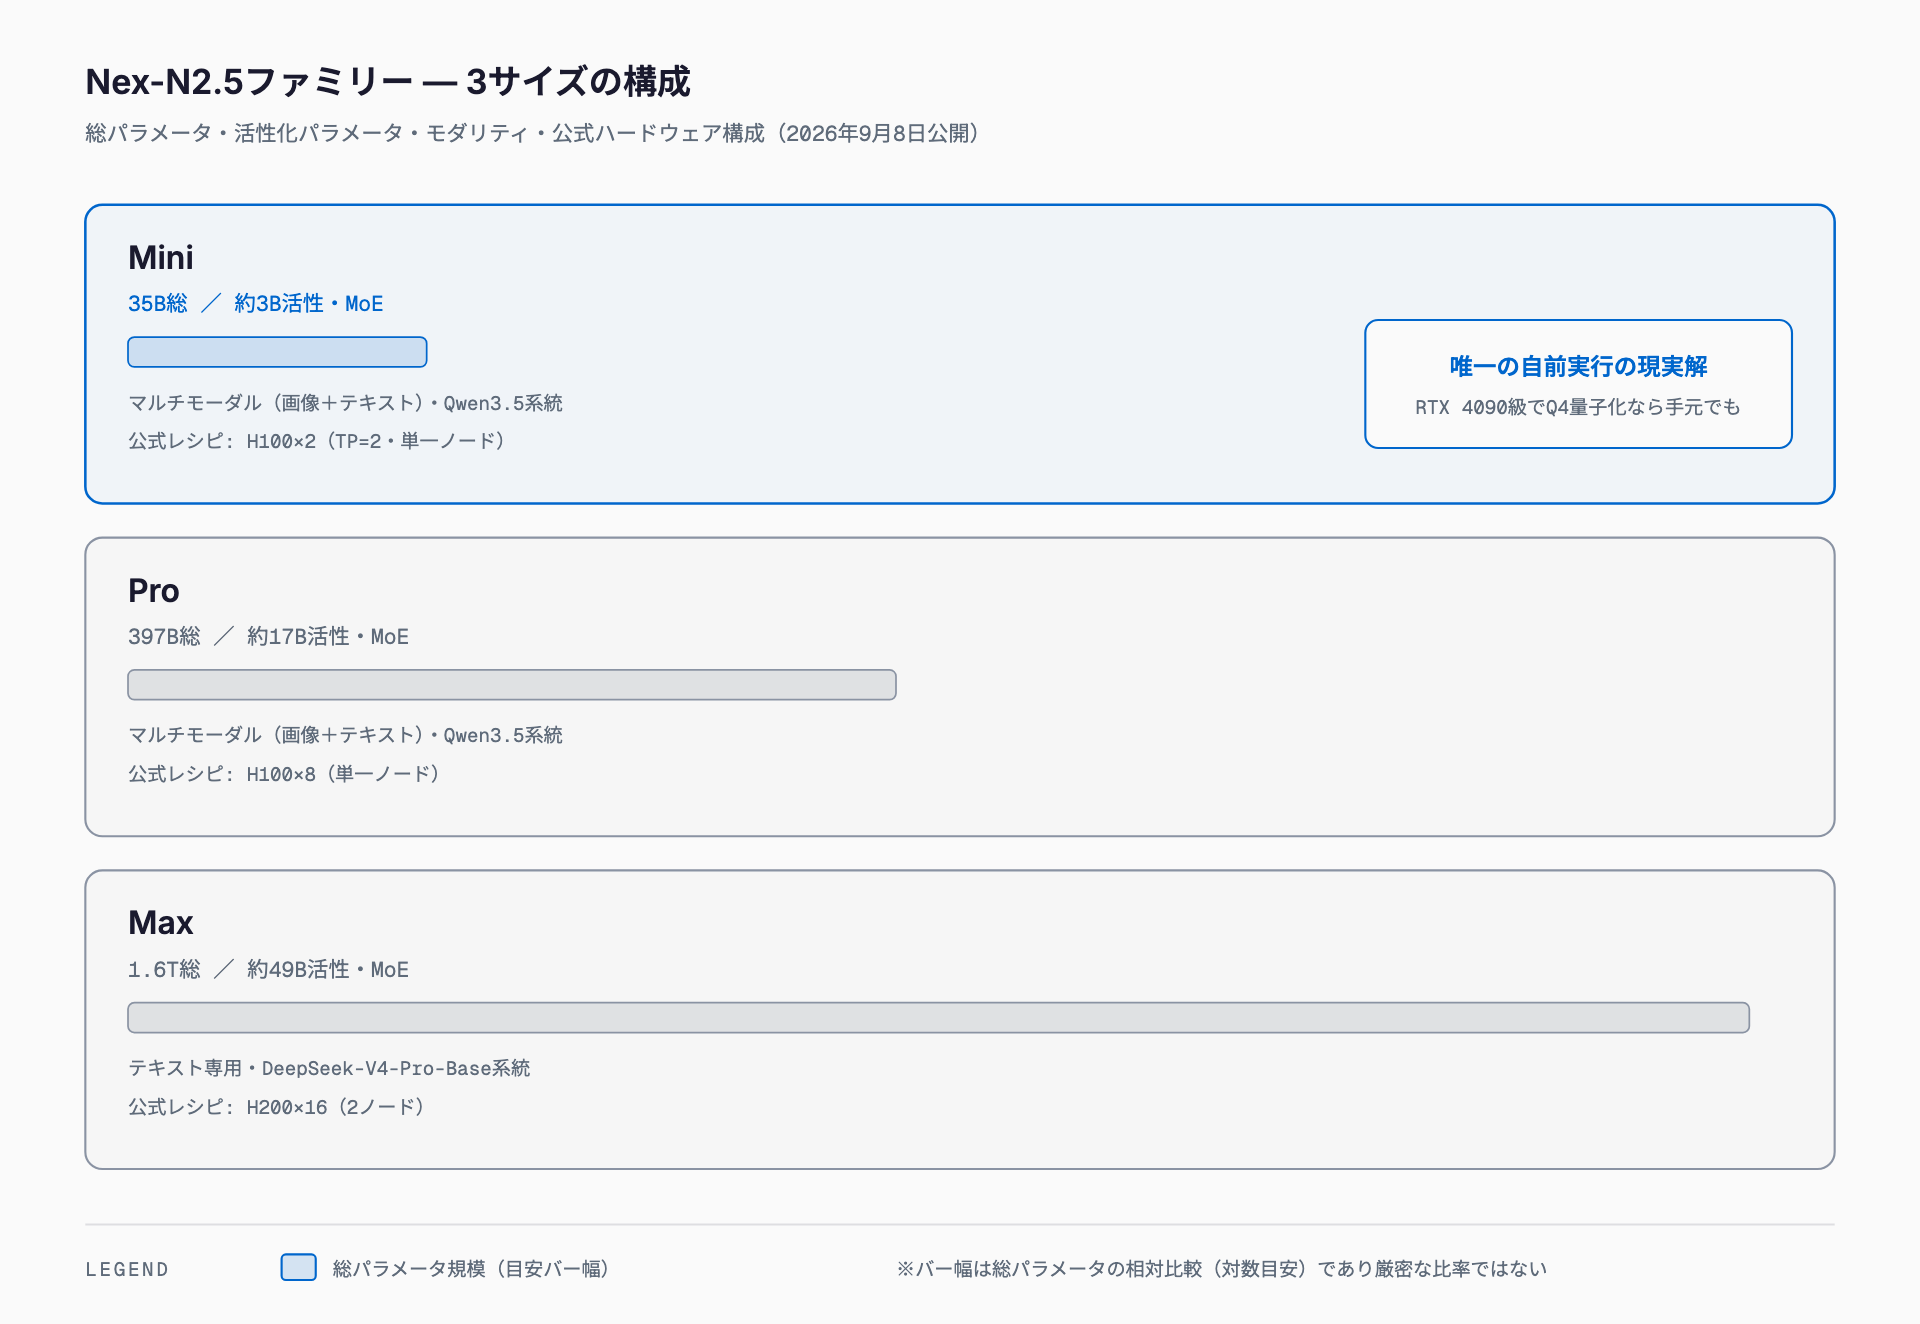
Nex-N2.5は2026年9月8日にNex-AGIが公開した、Mini(35B)・Pro(397B)・Max(1.6T)の3サイズからなるオープンウェイトのエージェント特化モデル群である。必要VRAMは機種と量子化で大きく異なり、最小のMiniはQ4_K_M量子化で約22GBに収まる一方、最大のMaxはBF16精度だと1.6TB級のメモリが必要になる。以下、モデル別・量子化別の目安をまとめる。
Nex-N2.5とは何か
Nex-N2.5はNex-AGIが開発した、コンピュータ操作・ブラウザ操作・コーディングなど長時間にわたるエージェントタスクを主眼に置いたモデル群である。前世代Nex-N2のマルチモーダル基盤を引き継ぐMiniとProは、視覚フィードバックをもとに継続的に行動と自己修正を行う「長期水平タスク」向けの強化が加えられている。一方Maxはテキスト専用の1.6兆パラメータMoE基盤モデルで、DeepSeek-V4-Pro-Baseをベースに構築された、複雑な推論・コーディング・エージェントワークフロー向けのモデルである。3モデルとも重みはApache 2.0ライセンスで公開されており、Hugging Face(nex-agi組織)とModelScopeから入手できるほか、OpenRouter経由のホスティングも用意されている。
| モデル | 総パラメータ | 活性化パラメータ | モダリティ | 系統 | コンテキスト長 |
|---|---|---|---|---|---|
| Nex-N2.5-Mini | 35B | 約3B | マルチモーダル(画像+テキスト) | Qwen3.5系統 | 約262K |
| Nex-N2.5-Pro | 397B | 約17B | マルチモーダル(画像+テキスト) | Qwen3.5系統 | 約262K |
| Nex-N2.5-Max | 1.6T | 約49B | テキスト専用 | DeepSeek-V4-Pro-Base系統 | 262,144 |
必要スペック早見表(モデル×量子化)
| モデル | Q4_K_M(約4.5bit) | Q8_0(8bit) | BF16(16bit) |
|---|---|---|---|
| Nex-N2.5-Mini(35B) | 約22.3GB(GGUF実測) | 約36.9GB(GGUF実測) | 約69.4GB(GGUF実測) |
| Nex-N2.5-Pro(397B) | 約241GB(概算) | 約422GB(概算) | 約794GB(概算) |
| Nex-N2.5-Max(1.6T) | 約970GB(概算) | 約1,700GB(概算) | 約3,200GB(概算) |
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。Nex-N2.5の3モデルもモデル一覧から選択できる。
VRAM計算の考え方 — MoEでも「総パラメータ」基準
上の早見表は「総パラメータ数(B) × 1weightあたりのbit数 ÷ 8」で概算している。Nex-N2.5の全モデルはMoE構成だが、活性化パラメータ数ではなく総パラメータ数を基準にしている。理由は単純で、MoEは推論時にどのエキスパートが呼ばれるかがトークンごとに変わるため、使われないエキスパートも含めて全重みをメモリに常駐させておく必要があるからだ。したがって「Miniは約3B活性」というスペックは計算量(=推論速度)が3B相当で済むという意味であり、VRAM消費量は35B総パラメータを前提に見積もる必要がある。Pro(397B総/17B活性)・Max(1.6T総/49B活性)も同じ非対称性を持ち、規模が大きくなるほど「速度は軽いがメモリは重い」という差が拡大する。
Mini(35B)の量子化別実測サイズ
| 量子化 | 実測サイズ(GGUF) |
|---|---|
| IQ3_M | 約19.0GB |
| IQ4_XS | 約19.9GB |
| Q4_K_M | 約22.3GB |
| Q5_K_M | 約27.0GB |
| Q6_K | 約29.4GB |
| Q8_0 | 約36.9GB |
| BF16 | 約69.4GB |
MiniについてはコミュニティによるGGUF量子化版(bartowski等)が公開されており、この表の数値は計算式による概算ではなく実測値である。一方Pro・Maxは2026年9月14日時点で広く使われているGGUF量子化ビルドが確認できておらず、上の早見表の数値は計算式に基づく概算である点に注意したい。
Apple SiliconとNVIDIA GPUでの動作の目安(Mini)
- Apple Silicon(統合メモリ): Q4_K_M(約22.3GB)はM3 Max 36GB〜、M3/M4 Max 64GB〜なら長めのコンテキストでも余裕を持って動作。BF16(約69.4GB)を狙うならM3/M4 Max 96GB以上、あるいはM2/M3 Ultra 128GB〜が目安
- RTX 4060 / 4070(8〜12GB): Miniでも収まらない。IQ2〜IQ3級の強い量子化を使っても品質劣化が大きく、実用的な下限は12GB台後半以上
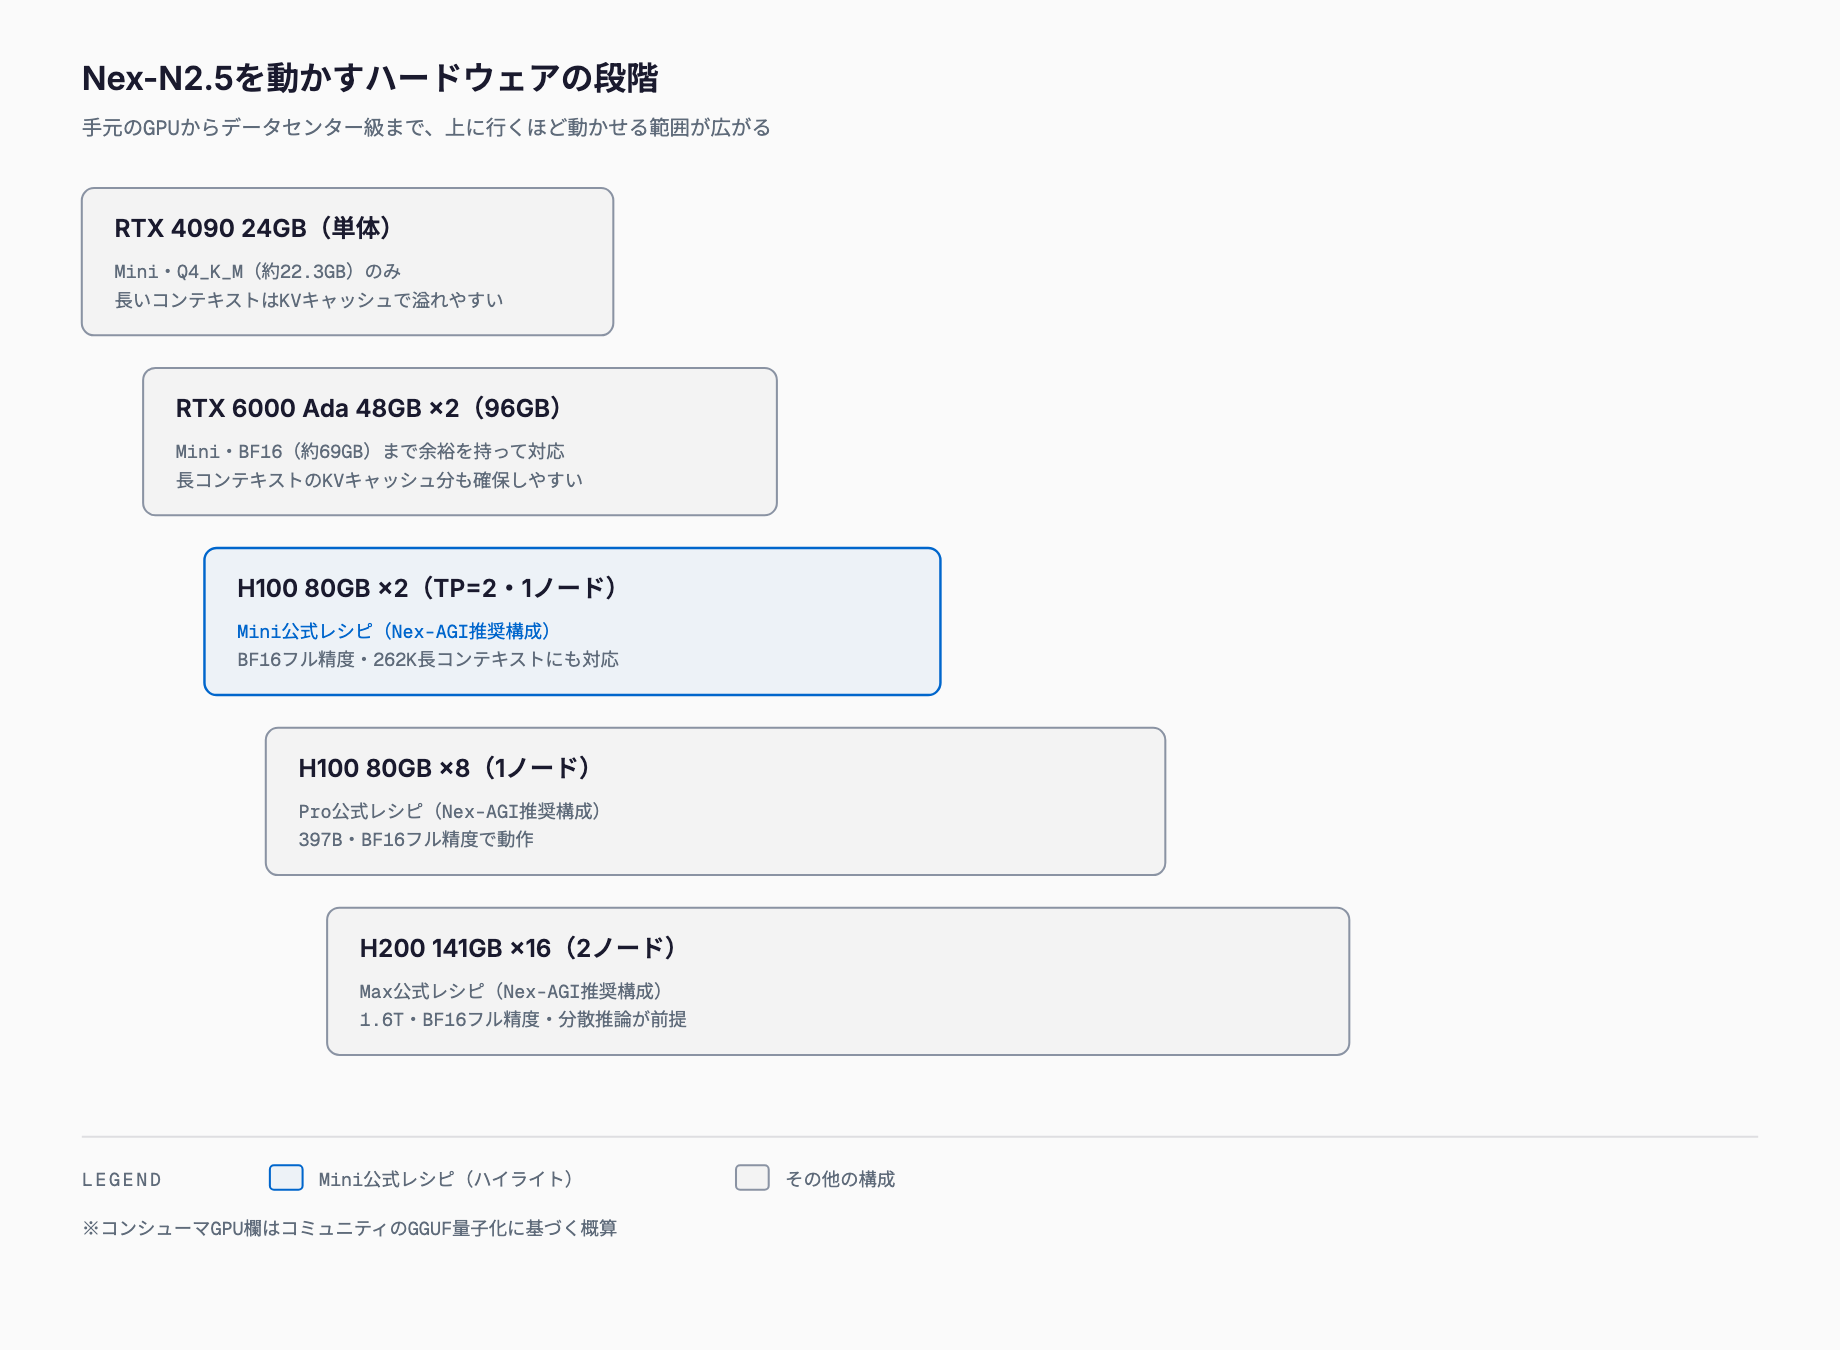
- RTX 4090(24GB): Q4_K_M(約22.3GB)がぎりぎり収まる構成。ただしコンテキストを長く取るとKVキャッシュ分で溢れやすく、262Kフルコンテキストの利用には向かない
- RTX 6000 Ada / A100(48〜80GB): Q8_0(約36.9GB)やBF16(約69.4GB)まで余裕を持って動作し、長めのコンテキストにも対応しやすい
- H100 80GB×2(Nex-AGI公式レシピ): BF16フル精度・TP=2構成で262Kの長コンテキストにも対応できる、公式に検証済みの構成
Pro・Maxのハードウェア要件 — 事実上データセンター専用
ProとMaxはコンシューマGPUでの自前実行がほぼ現実的でない規模である。Nex-AGIが公表している公式レシピでは、Pro(397B)はH100 80GB×8の単一ノード、Max(1.6T)はH200 141GB×16の2ノード構成が前提となっている。BF16フル精度ではProで約794GB、Maxで約3,200GB相当のメモリが必要になる計算で、量子化を強めても複数GPU・複数ノードの分散推論が避けられない。手元での検証や日常利用はMiniに絞り、Pro・Maxを試す場合はOpenRouter等のホスティングサービスやクラウドAPI経由の利用が現実的な選択肢になる。
予算別の推奨構成
- 〜40万円程度: RTX 4090 24GB構成でMiniをQ4_K_M量子化・短めのコンテキストで運用。コーディング支援やエージェントタスクの検証用途に向く
- 〜120万円程度: RTX 6000 Ada 48GB等でMiniをQ8_0〜BF16の高精度量子化・長コンテキストで快適に運用可能
- 300万円以上(H100複数枚): Nex-AGI公式レシピのH100×2構成でMiniをBF16フル精度・262Kフルコンテキストで運用。Proを試すにはさらにH100×8規模が必要
- クラウドAPI併用: Pro・Maxをフル精度で試すだけであれば自前ハードウェアより、OpenRouter等の対応クラウド経由でのAPI利用の方が初期投資を抑えられる
既存のオープンウェイトモデルとの違い
| モデル | 総パラメータ/活性化 | モダリティ | 自前実行の現実解 | 詳細記事 |
|---|---|---|---|---|
| Nex-N2.5-Mini | 35B/3B | マルチモーダル | RTX 4090級(Q4) | 本記事 |
| Nex-N2.5-Pro | 397B/17B | マルチモーダル | H100×8相当(公式レシピ) | 本記事 |
| Nex-N2.5-Max | 1.6T/49B | テキスト専用 | H200×16・2ノード(公式レシピ) | 本記事 |
| K2-Horizon-375B-A23B | 375B/23B | テキスト専用 | 複数GPU前提 | 必要スペック記事あり |
| GLM-5.3-Flash | 320B/18B | テキスト系 | 複数GPU前提 | 必要スペック記事あり |
| Solar Open2 250B-A15B | 250B/15B | テキスト系 | 複数GPU前提 | 必要スペック記事あり |
Nex-N2.5の特徴は、MiniとProがQwen3.5系統をベースにしたマルチモーダル・エージェント特化モデルである点、そしてMaxだけが別系統(DeepSeek-V4-Pro-Base)のテキスト専用モデルとして切り離されている点にある。つまり同じ「Nex-N2.5」という名前でも、3サイズが単純に大きさだけ違うわけではなく、Mini/Proのレシピ1つとMaxのレシピ1つという、実質2系統のモデル群である。ベンチマークではMaxのTerminal-Bench 2.1が86.1でClaude Opus 5(89.1)に近い水準、AutomationBench v1.0.6でも0.1点差という報告があり、オープンウェイトのエージェントモデルとしては上位クラスの性能を主張している。
ライセンスと公開状況
Nex-N2.5はMini・Pro・Maxとも重みがApache 2.0ライセンスで公開されており、商用利用を含めて制限は緩い。Hugging Faceの nex-agi 組織から3モデルとも入手できるほか、ModelScopeでも配布されている。2026年9月14日時点でコミュニティによる量子化GGUFビルドが広く出回っているのはMiniのみで、Pro・Maxについては規模の大きさもあり、標準的な量子化ビルドの流通はまだ限定的である。ローカル実行環境の選び方についてはローカル推論エンジン比較やローカルLLM全体地図も参考になる。
関連記事
- Edge0-35B-A3Bとは何か — SSDストリーミングで35BのMoEを3GB未満のRAMで動かす仕組みと必要スペック
- colibriとは何か — 744BのMoEモデルを25GB RAMで動かすpure C推論エンジン
- MiniCPM5-2B 必要スペック早見表 — スマホ・ラズパイ・ラップトップで動かす目安【2026年9月版】
よくある質問
Nex-N2.5-MiniはRTX 4090(24GB)で動くか。
Q4_K_M量子化(GGUF実測で約22.3GB)であればRTX 4090 24GBに収まる。ただしコンテキストを長く取るとKVキャッシュ分で24GBを超えやすいため、262Kのフルコンテキストを使う場合は複数GPUやより大容量のGPUが必要になる。
Nex-N2.5-Miniは「3B活性」なのに、なぜ35B相当のVRAMが必要なのか。
MoEモデルは推論時にどのエキスパートが呼ばれるかがトークンごとに変わるため、使われないエキスパートも含めて全パラメータをメモリ上に置いておく必要がある。計算量(速度)は3B相当で済むが、メモリ容量は総パラメータの35B基準で見積もる必要がある。Pro(397B/17B活性)・Max(1.6T/49B活性)も同じ考え方が当てはまる。
Nex-N2.5-Pro・Maxを個人のPCで動かすことはできるか。
事実上できない。Nex-AGIの公式レシピはPro(397B)がH100 80GB×8の単一ノード、Max(1.6T)がH200 141GB×16の2ノードを前提としており、BF16換算でそれぞれ約794GB・約3,200GB相当のメモリが必要になる。個人でMoEを試したい場合はMiniに絞るか、OpenRouter等のホスティング経由でPro・Maxを利用するのが現実的である。
MiniとPro、Maxはどう違うのか。
MiniとProはQwen3.5系統をベースにしたマルチモーダル(画像+テキスト)モデルで、コンピュータ操作・ブラウザ操作などの視覚を伴うエージェントタスクに強みを持つ。一方MaxはDeepSeek-V4-Pro-Baseをベースにしたテキスト専用モデルで、複雑な推論・コーディング・エージェントワークフロー向けに特化している。同じファミリー名でも設計思想が異なる2系統のモデル群と捉えるのが実態に近い。
コンテキスト長262Kをフルに使うと必要VRAMはどれだけ増えるか。
早見表の数値は重みの読み込み分のみで、KVキャッシュの分は含んでいない。262Kトークンのコンテキストをフルに使うとモデルサイズによっては数十GB単位でVRAMが追加で必要になるため、実際の運用ではVRAM計算ツールでコンテキスト長を指定して試算することを推奨する。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ