colibriとは何か 744BのMoEモデルを25GB RAMで動かすpure C推論エンジン
GitHub Trendingで注目を集めたJustVugg/colibriを解説。GLM-5.2(744B)をディスクからのエキスパートストリーミングで一般PCで動かす仕組み、対応モデル、ビルド・使い方、必要スペック、llama.cpp・Ollama・Edge0・turbo-fieldfareとの違いを整理する。
colibriとは何か — ディスクをメモリ階層の一部にして超大型MoEを動かすエンジン
colibri(JustVugg/colibri)は、GPUやPythonランタイムに依存しないpure C製のローカル推論エンジンで、VRAM・RAM・ストレージを1つの統合メモリ階層として扱うことで、744Bパラメータ級のMoE(Mixture of Experts)モデルを一般的なPCで動かせるようにする。ライセンスはApache 2.0。2026年7月10〜11日にリリースされ、Hacker Newsで「Show HN: Getting GLM 5.2 running on my slow computer」として投稿され900pt超を獲得、GitHub Trendingにも浮上した。2026年9月14日時点でGitHubスター数は約3万。
結論を先に言うと、colibriは「速さ」ではなく「メモリに載らないはずの巨大モデルを、正確さを保ったまま一応動かす」ことを目的にしたエンジンである。GLM-5.2(744Bパラメータ、活性化は約40〜55B)を25GBのRAMで動かせるが、速度はコールドキャッシュ時で0.05〜0.1トークン/秒と、実用速度とは言えない。ウォームキャッシュや潤沢なハードウェアがあれば数トークン/秒まで上がる。
仕組み — エキスパートのオンデマンドロード
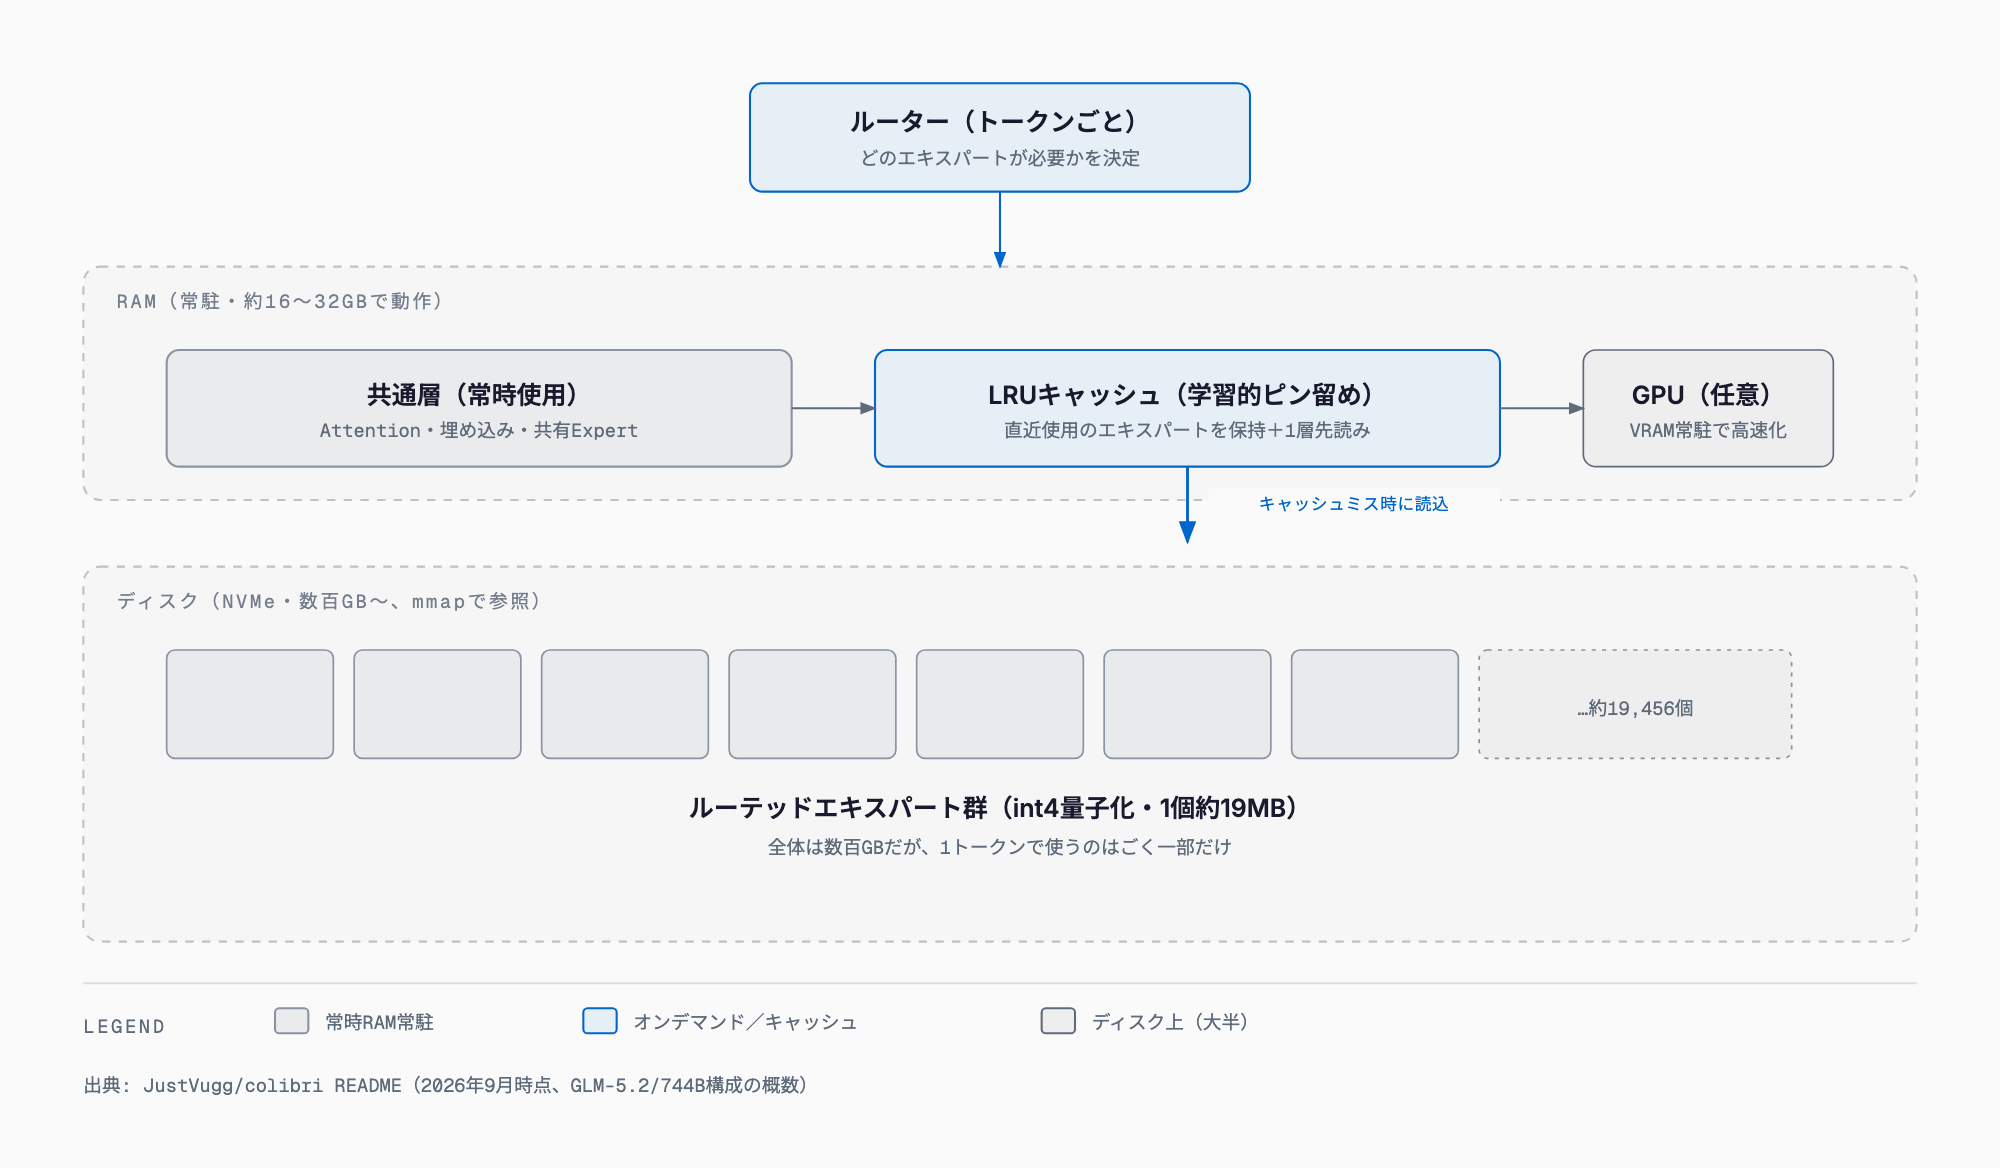
MoEモデルは全パラメータのうち、1トークンあたり実際に計算に使うのはごく一部(アクティブパラメータ)だけという特性を持つ。GLM-5.2の場合、744Bパラメータのうち実際に使うのは約40B、しかもトークンが変わっても更新される部分は約11GB相当にとどまる。colibriはこの特性を利用し、モデルを2つに分けて扱う。
- 常時RAM常駐: Attention・埋め込み・共有Expertなど、どのトークンでも使う「共通層」(GLM-5.2で約17B、int4量子化で約9.9GB)
- ディスク常駐+オンデマンド読込: ルーティングされるエキスパート群(GLM-5.2で約19,456個、1個あたりint4で約19MB、合計約370GB)はディスク上にmmapで置き、ルーターが選んだ分だけ読み込む
読み込みには層単位のLRUキャッシュを使い、学習的なピン留め(よく使われるエキスパートを優先的に保持)と1層先読みでディスクI/Oを減らす。開発元はこの挙動を「重み版のJITコンパイラ」と表現しており、実行パターンを見ながら「ホットな」エキスパートを高速なティアへ動的に配置していく。GPUがあればVRAM常駐という追加の高速ティアとして使えるが、CPUのみの経路も完結しており必須ではない。
開発元はこの設計思想を「速度より正確さ」と表現しており、量子化やティア配置によってモデルの出力が変わらないよう、Hugging Face transformers との完全一致(トークン単位のオラクル検証)を品質担保の基準にしている。速いメモリが足りなければ遅くなるだけで、モデルの意味的な挙動自体は変えない、という設計原則である。
対応モデル
colibriはモデルファミリーごとに専用のCファイル(例: c/glm.c は約2,400行)を持ち、共通のCLIで操作する。2026年9月時点で以下のモデル系列に対応している(数値は概算・README記載値)。
| モデル | 総/活性化パラメータ | ディスク容量目安 | RAM最小 | 備考 |
|---|---|---|---|---|
| GLM-5.2 / 5.3 | 744B / 約40B | 約372GB | 16GB | リファレンスモデル。MTP速度改善にはint8ヘッドが必要 |
| GLM-5.3-Flash | 321B / 40B | 約195GB | 25GB | ビジョン対応 |
| Inkling | 975B / 41B | 約469GB | 25GB | 思考(Thinking)機能あり |
| Kimi K3 | 2.8T / 104B | 約1.6TB | 32GB | ネイティブMXFP4のまま配信 |
| DeepSeek V4 Flash | 284B / 13B | 約137GB | 16GB | CUDAは任意。REAP枝刈り版150Bもあり |
| DeepSeek V4.1 Flash | 552B / 16B | 約203GB | 32GB | ビジョン・ツール呼び出し対応 |
| Qwen3.8-Flash-Next | 125B+51Bのn-gram / 6B | 約185.5GB | 16GB | CPU専用・GPU非対応 |
| Qwen3.6 | 35B / 3B | 約20GB | 24GB | CUDA利用時1.44→10.05トークン/秒(GPU2枚構成) |
| OLMoE | 7B / 1B | 約7GB | 8GB | ラインナップ中最小 |
対応モデルはREADMEの更新頻度が高く、今後も追加が見込まれる。最新の対応状況はGitHubリポジトリで随時確認するのが確実である。
ビルドと使い方
colibriはLinux・macOS・Windows向けのビルド済みバイナリを配布しており、コンパイラなしですぐ試せる。
# ビルド済みリリースを使う場合
tar xzf colibri-v1.11.0-linux-x86_64.tar.gz
python3 coli info

# ソースからビルドする場合(gcc/clang + OpenMP が必要)
git clone https://github.com/JustVugg/colibri && cd colibri/c
./setup.sh
make glm        # モデルファミリーごとに make ターゲットが分かれる
# 他の例: make inkling / make kimi_k3 など
ビルドまたは展開後は、共通のCLI coli で操作する。
./coli chat --model /path/to/model    # 対話型ターミナル
./coli serve --model /path/to/model   # APIサーバー(ヘッドレス)
./coli web --model /path/to/model     # API+ダッシュボード(ブラウザで開く)
./coli plan --model /path/to/model    # VRAM/RAM/ディスクの配置計画を確認
./coli doctor --model /path/to/model  # 動作可否チェック
./coli tune --model /path/to/model    # 性能を計測してプロファイル保存
主な環境変数には、モデルパスを指定する COLI_MODEL、VRAMティアのサイズを自動調整する CUDA_EXPERT_GB=auto、全エキスパートをRAMにピン留めする PIN_GB=all、2枚のSSDへ分散配置して読み込み帯域を約33%向上させる COLI_MODEL_MIRROR、投機的デコードを無効化する DRAFT=0、マルチソケット環境向けの COLI_NUMA=1 などがある。
必要スペックの目安
colibriの最小要件は動かすモデルによって大きく異なる。目安は次の通り(2026年9月時点、README記載の実測・概算値)。
| 構成 | 実測スループット |
|---|---|
| 25GB端末・コールドディスク(GLM-5.2) | 0.05〜0.1トークン/秒 |
| NVMe1本・ウォームキャッシュ | 1〜2トークン/秒 |
| CPU専用・RAM128GBデスクトップ | 約1.8トークン/秒(ウォーム) |
| RTX 5070 Ti(GPU常駐パイプライン) | 1.07トークン/秒 |
| RTX 5090×6(全エキスパートを常駐) | 5.8〜6.8トークン/秒・TTFT約13秒 |
開発元自身が明言している通り、速度を決めるのはモデルサイズそのものよりディスクI/Oである。GPU・VRAMティアは高速化に寄与するが必須ではなく、CPUのみの経路が完結した動作パスとして用意されている。ゲーミングPC程度のNVMe+RAM32GB前後でも動かせるが、実用的な対話速度を求めるなら中小規模モデル(Qwen3.6やOLMoEなど)を選ぶか、GPUを複数枚用意する必要がある。
投機的デコードと圧縮KVキャッシュ
colibriはGLM-5.2のネイティブなMTP(Multi-Token Prediction)ヘッドを使った投機的デコードに対応する。ドラフトしたトークンを1回のバッチ処理でまとめて検証し、キャッシュがウォームな状態では1回のフォワードパスあたり2.2〜2.8トークンを生成できる。ただしMTPヘッドはint8精度が必須で、int4量子化すると採択率が0〜4%まで落ち込むとされる。コールドワークロードでは検証コストがドラフトの節約分を上回るため、デフォルトでは無効化される。
またMLA(Multi-head Latent Attention)方式によりKVキャッシュを1トークンあたり576floatまで圧縮(通常の32,768floatに対し約57分の1)し、.coli_kv ファイルとして永続化する。これにより会話を再開する際、プリフィル(プロンプトの再計算)なしで続きから再開できる。
既存ツールとの違い
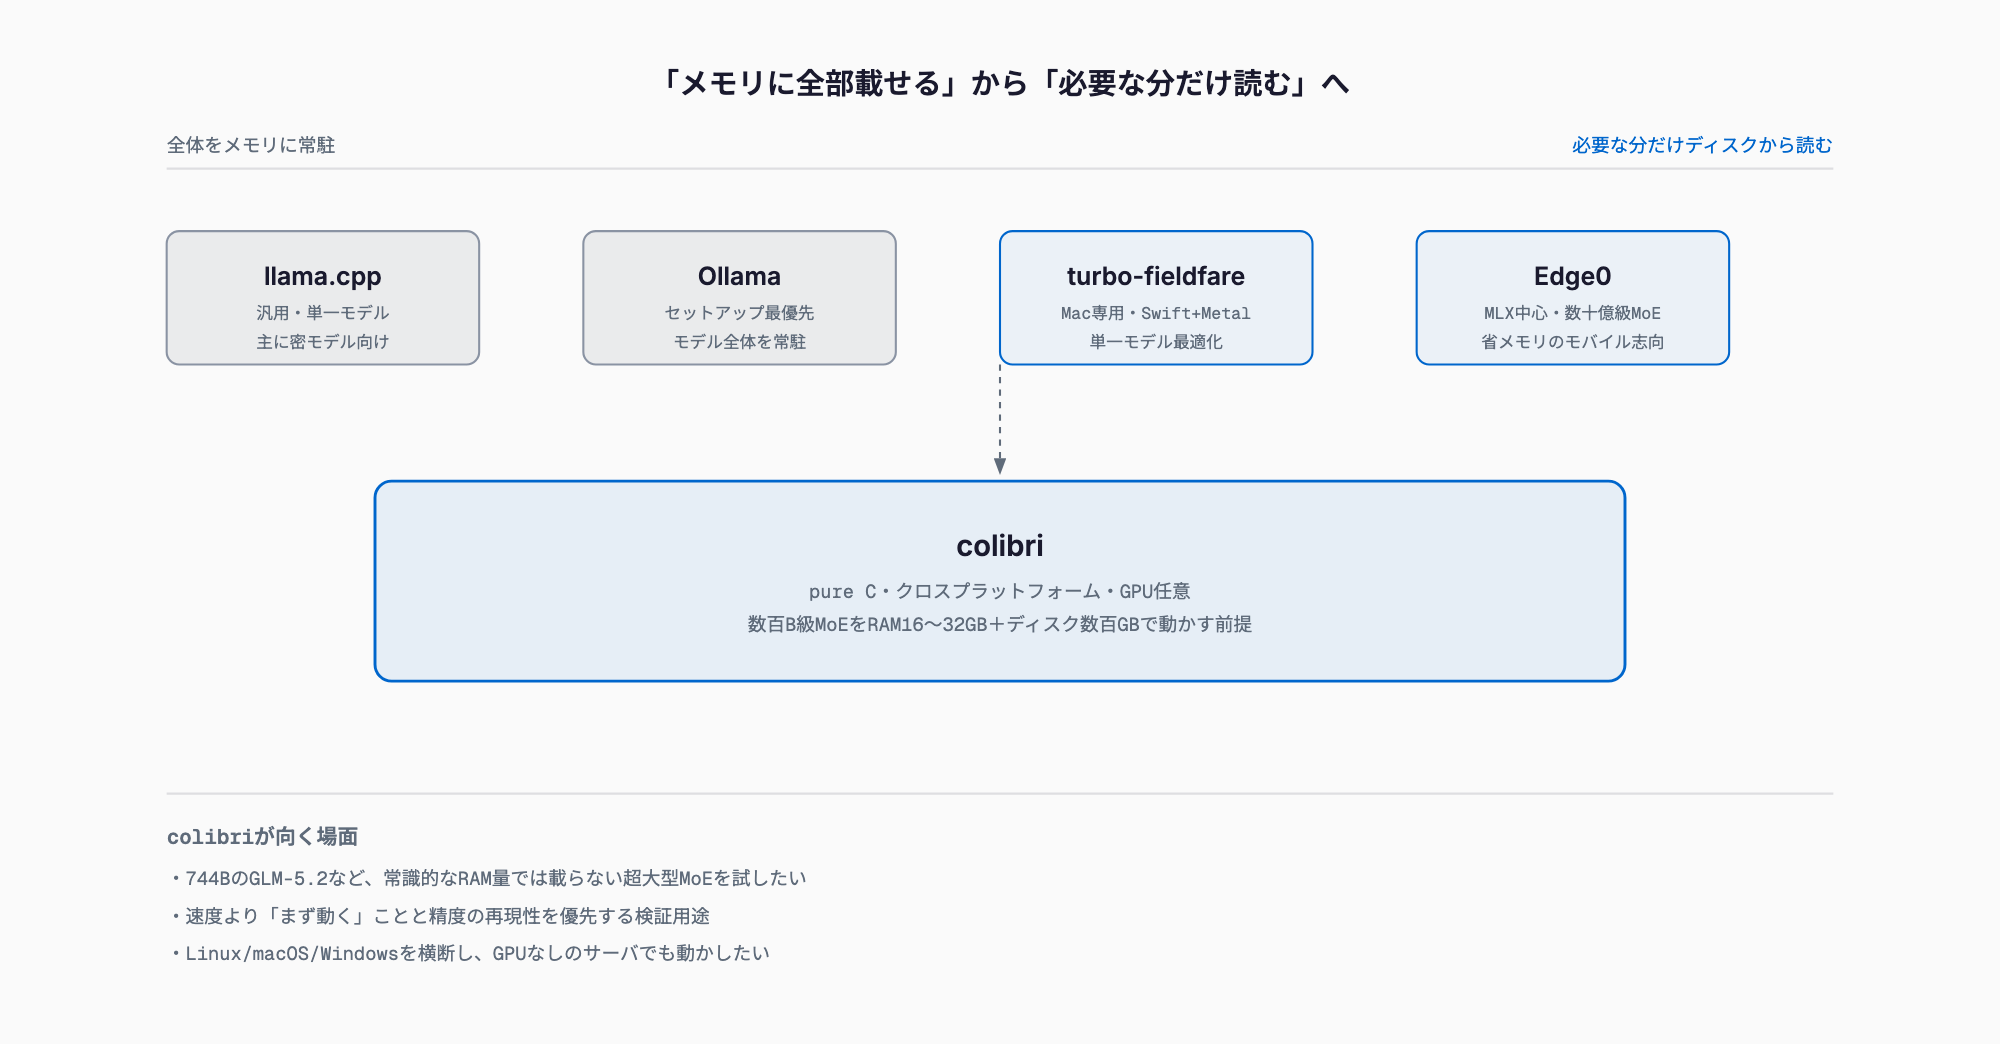
ローカルLLM実行エンジンはすでにllama.cpp・Ollamaという定番があるほか、2026年に入ってからも小型MoEを省メモリで動かす専用エンジン(turbo-fieldfare、Edge0)が登場している。狙いはそれぞれ異なる。
| ツール | 主な狙い | 想定モデル規模 | プラットフォーム | メモリ戦略 |
|---|---|---|---|---|
| colibri | 巨大MoEをメモリに載らないまま動かす | 数百B〜2.8T(MoE) | Linux/macOS/Windows・pure C | RAM+ディスクの階層メモリ、GPU任意 |
| llama.cpp | 汎用の単一モデル実行基盤 | 主に〜数十B(密モデル中心) | クロスプラットフォーム | モデルをメモリ/VRAMに読み込む前提 |
| Ollama | セットアップの簡単さ優先 | 主に〜数十B | クロスプラットフォーム(llama.cppベース) | モデル全体を常駐させる運用が基本 |
| turbo-fieldfare | Mac単体でMoEを省メモリ実行 | 数十B級MoE(例: Gemma 4 26B-A4B) | macOS(Apple Silicon)専用・Swift+Metal | 独自フォーマットに変換し常駐部を約1.35GBに圧縮 |
| Edge0 | モバイル/エッジ向け省メモリMoE | 数B〜数十B級MoE | 主にMLX(Apple Silicon) | SSDオフロード+ルーティング予測で数GB未満に収める |
llama.cppとOllamaは「モデル全体をメモリまたはVRAMに載せる」ことを前提にした汎用エンジンで、密モデルを含む幅広いモデルを安定して動かせる反面、モデルサイズがハードウェアのメモリ容量を超えると動作しない。turbo-fieldfareとEdge0はcolibriと同じ「ディスクからエキスパートをストリーミング」する発想を採るが、対象はGemma 4 26B-A4BやEdge0の35B/8B級といった比較的小さいMoEモデルで、Apple SiliconのMLX/Metal環境に最適化されている。colibriはこれらより一桁以上大きい、数百B〜Kimi K3の2.8Tパラメータ級までを対象にしており、GPUを持たないLinux/Windowsサーバーでも動かせる点が異なる。速度面では、turbo-fieldfareやEdge0が実用的な対話速度(十数〜千トークン/秒級、条件次第)を狙うのに対し、colibriは巨大モデルを「動かせること」自体を優先し、速度は二の次という位置づけである。
使う際の注意点
colibriはまだ2026年7月にリリースされたばかりの新しいプロジェクトであり、対応モデルやパフォーマンス数値は今後のアップデートで変わる可能性が高い。実運用のチャットボットやAPIサービスとして常時利用するより、手元のハードウェアで「フロンティア級の巨大MoEモデルが動くかどうか」を検証する用途、あるいは研究・実験目的での利用に向いている。速度が遅い場合はモデルサイズを下げるか、COLI_MODEL_MIRROR によるデュアルSSDストライピングやGPUティアの追加で改善できる余地がある。
関連記事
- Edge0-35B-A3Bとは何か — SSDストリーミングで35BのMoEを3GB未満のRAMで動かす仕組みと必要スペック
- Nex-N2.5 必要スペック早見表 — VRAM 約22GB〜1.6TB級/RTX 4090〜H200マルチノード【2026年9月版】
- ローカルLLMのコンテキスト長とVRAM — KVキャッシュ計算式と早見表
colibriを動かすのに最低限必要なスペックは?
モデルによって大きく異なるが、最小構成のOLMoE(7B/1B)ならRAM8GB程度、GLM-5.2(744B)はRAM16〜25GB+ディスク約370GBが目安。ディスク容量とNVMeの読み込み速度が体感速度に直結する。
GPUは必須ですか?
必須ではない。CPUのみの経路が完結した動作パスとして用意されており、GPUがあればVRAM常駐という追加の高速ティアとして使える程度の位置づけ。
llama.cppやOllamaの代わりになりますか?
用途が異なる。llama.cpp・Ollamaはメモリに収まるモデルを安定して動かす汎用基盤で、日常利用向き。colibriはメモリに収まらない超大型MoEモデルを、速度を犠牲にしてでも動かすための特化型エンジンで、両者は置き換えというより住み分けの関係にある。
turbo-fieldfareやEdge0との違いは何ですか?
どちらもディスクからエキスパートをストリーミングする発想は共通だが、対象モデル規模が異なる。turbo-fieldfare・Edge0はApple Silicon上で数十B級までの小型MoEを省メモリ・実用速度で動かすのに対し、colibriは数百B〜2.8T級の超大型MoEを、速度は二の次にしてでも動かすことを目指す。
実際の応答速度はどれくらいですか?
条件次第で0.05トークン/秒〜数トークン/秒まで幅がある。25GB端末でのコールドディスク実行は0.05〜0.1トークン/秒と非常に遅く、GPUを複数枚使った構成でようやく5〜7トークン/秒程度になる。実用的なチャット速度を求める用途には向かない。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ