Edge0-35B-A3Bとは何か SSDストリーミングで35BのMoEを3GB未満のRAMで動かす仕組みと必要スペック
2026年9月公開のEdge0-35B-A3B-previewは、Qwen3.5-MoE 35B-A3Bを4bit量子化し、SSDからエキスパートを都度ストリーミングすることでアクティブメモリ3GiB未満・約15〜18tok/sで動かすMLX向けモデル。仕組み・必要ハード・使い方・llama.cppやColibriとの違いを整理する。
Edge0-35B-A3Bは35Bモデルを3GiB未満のRAMで動かすSSDストリーミング方式のMoEモデル
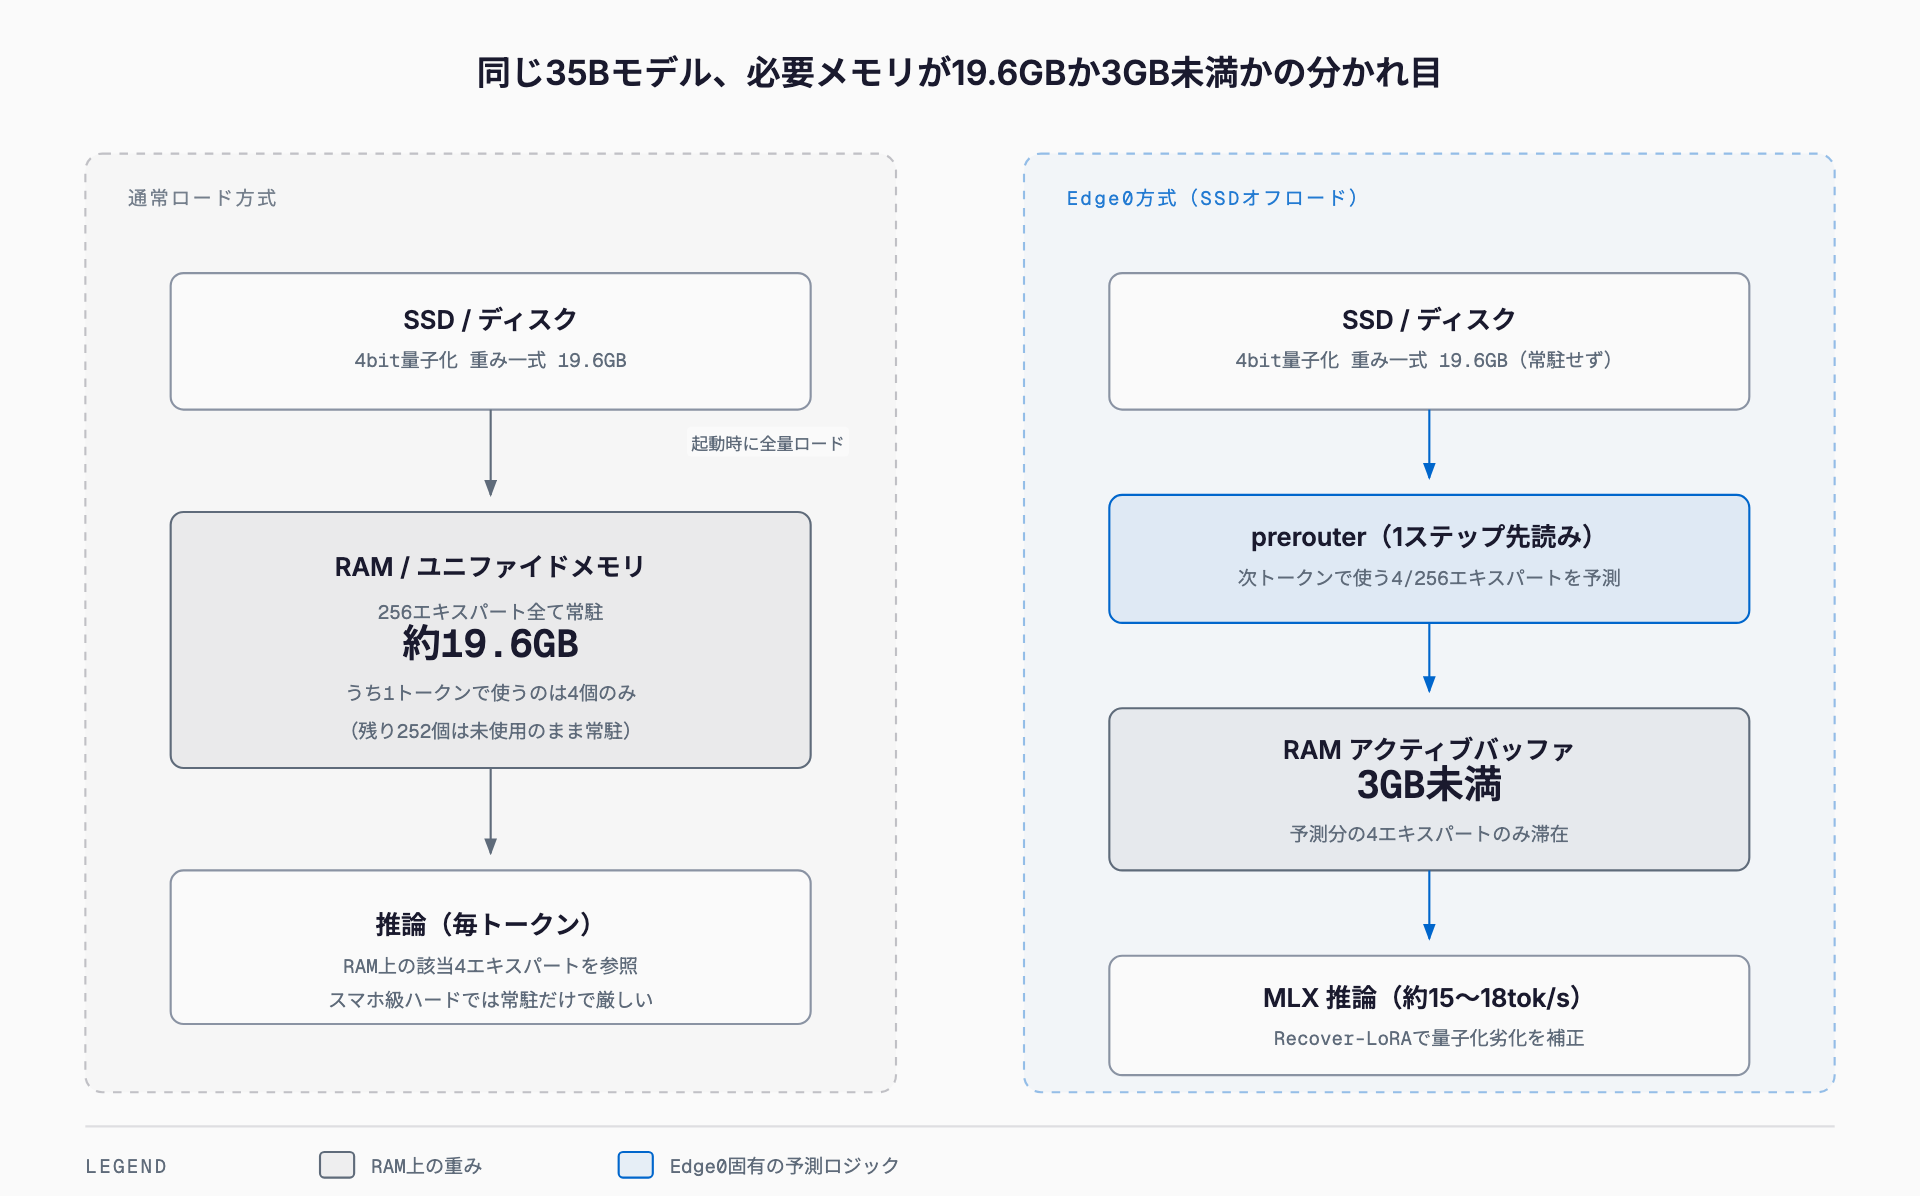
Edge0-35B-A3B-previewは、Edge0-AIが2026年9月上旬に公開したオープンウェイトモデルである。ベースはQwen3.5-MoE 35B-A3B(総パラメータ35B・トークンあたり活性化パラメータ約3B)を4bit量子化したもので、通常なら全重み約19.6GBをメモリに常駐させる必要があるところを、全重みをSSDに置いたまま推論のたびに必要なエキスパートだけをストリーミング読み込みすることで、アクティブメモリを3GiB未満に抑える。Mac mini M4 Pro(統合メモリ24GB)での実測は復号(デコード)速度が約14.9〜17.7tok/s、プレフィル速度がコールドで約113tok/s・ウォームで約140tok/sとされている。MLX(Apple Silicon向け)実装のみで、2026年9月時点でCUDA対応はロードマップ項目にとどまる。
基本スペック早見表
| 項目 | 値 |
|---|---|
| ベースモデル | Qwen3.5-MoE 35B-A3B |
| 総パラメータ | 35B |
| アクティブパラメータ(1トークンあたり) | 約3B(K=4/256エキスパート) |
| レイヤー数 | 40 |
| 隠れ層サイズ | 2048 |
| 量子化 | 4bit(int4 base + LoRA + prerouter safetensors) |
| モデル一式のディスクサイズ | 約19.6GB |
| ピークアクティブメモリ(短コンテキスト) | 約2.9GiB |
| デコード速度(M4 Pro実測) | 約14.9〜17.7tok/s |
| プレフィル速度(M4 Pro実測) | コールド約113tok/s/ウォーム約140tok/s |
| 対応バックエンド | MLX(Apple Silicon)。CUDAはロードマップ |
| ライセンス | Apache 2.0 |
手元のGPU・Macで他モデルとの必要メモリを比較したい場合は、VRAM計算ツール(無料・登録不要)でモデル・量子化・コンテキスト長を選んで試算できる。なお同ツールは「重みを全量ロードした場合」の一般的な計算式に基づくため、Edge0特有のSSDストリーミングによる圧縮効果は含まない点に注意してほしい(詳細は後述)。
なぜ35Bのモデルが3GB未満のRAMで動くのか
MoE(Mixture of Experts)モデルは通常、どのエキスパートが呼ばれるかがトークンごとに変わるため、使われないエキスパートも含めて全重みをメモリに常駐させる必要がある。実際、K2 Horizonの必要スペック記事で解説した「速度は軽いがメモリは重い」という非対称性は、Qwen3.5-MoE 35B-A3Bをベースにした通常のロード方式でも変わらない。Edge0-35B-A3Bが異なるのは、この前提そのものを崩している点にある。全256エキスパートの重みをRAMではなくSSDに置いたまま、prerouterと呼ぶ予測ヘッドが次のトークンで必要になる4エキスパートをあらかじめ予測し、その分だけをRAM上のアクティブバッファへストリーミングする。使われない252個のエキスパートはRAMに載らないため、常駐メモリは活性化分の3B相当・3GiB未満で済む計算になる。
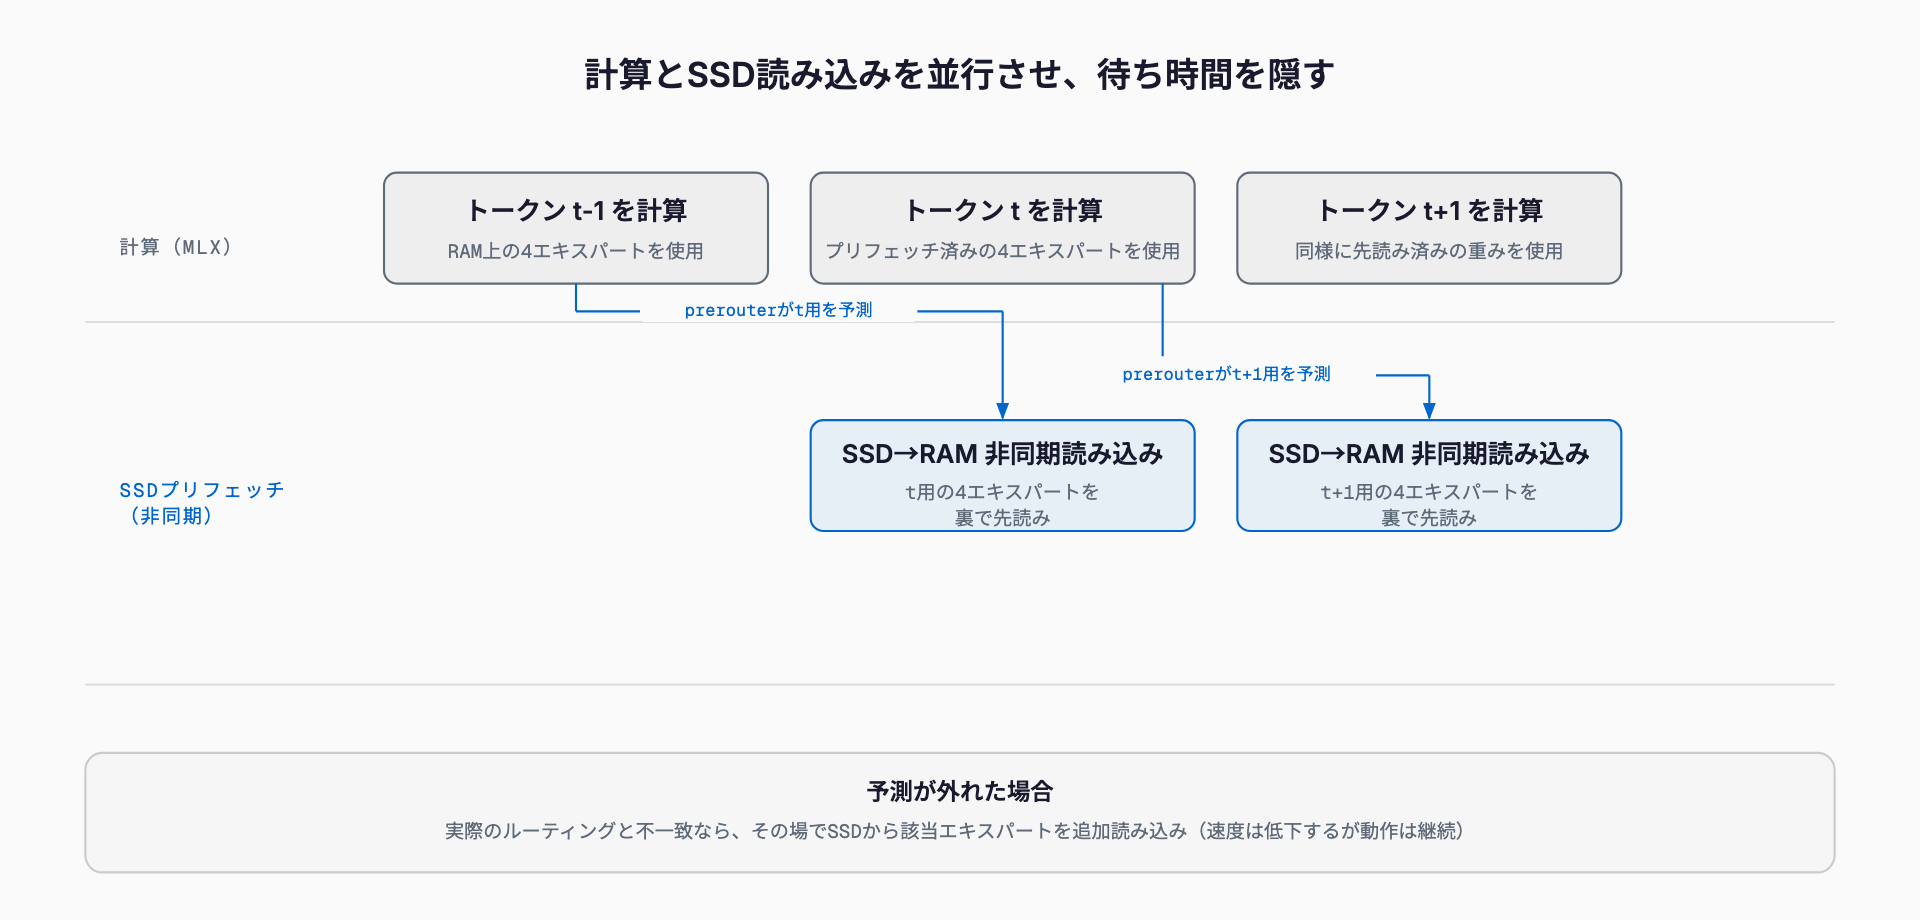
prerouter — 1ステップ先読みで読み込み待ちを隠す
SSDから毎トークンごとにエキスパートを読みに行くだけでは、読み込み待ちがそのまま推論の遅延になってしまう。Edge0はこれを避けるため、prerouterという軽量な予測ヘッドを使い、トークンtのルーティング結果をトークンt-1の時点で予測する。予測が完了した時点でSSDからの非同期読み込みを裏で開始しておき、トークンt-1の計算が終わる頃には必要な重みがすでにRAM上に揃っている、という段取りになる。この仕組みにより、prerouterなし(都度同期読み込み)と比べてデコードスループットが最大59%向上するとされる。予測が外れた場合は、その場でSSDへ追加読み込みに行くため速度は落ちるが動作自体は継続する。
Recover-LoRA — 4bit量子化の劣化を取り戻す仕組み
SSDストリーミングと並ぶもう一つの要素がRecover-LoRAである。int4量子化したベースモデルを凍結したうえで、FP精度の教師モデルからの蒸留によりLoRAアダプタを学習させ、4bit化で失われた精度の大部分を取り戻す設計になっている。Edge0側の報告では、int4量子化後の評価スコアはfp16ベースと比べて平均約3.9ポイントの低下にとどまるとされる(参考値としてAIME 2026が86.6、HumanEvalが90.9、GPQA-Diamondが79.8、MMLU-Proが81.0)。これらの数値はEdge0側が公開したベンチマーク結果であり、当サイトで独自に再現検証したものではない点は留意してほしい。
必要なSSD速度・RAM・対応ハードウェア
- ストレージ: 公式ドキュメントは「NVMeまたは同等の内蔵フラッシュを前提とする」としており、具体的な必要読み込み速度(GB/s)の数値は2026年9月時点で公表されていない。コミュニティ側の試算では、毎トークンでコールドにSSDから読みに行く前提だと理論上20GB/s超が必要になるが、実際にはOSのファイルキャッシュ(ページキャッシュ)が読み込みの大半を肩代わりするため、実効的に必要な持続読み込み速度はそれより低いとみられる。外付けSSDや低速なUSBストレージでの検証結果は確認できていない
- RAM(ユニファイドメモリ): ピークアクティブメモリは短いコンテキストで約2.9GiB。ただしKVキャッシュは別途RAMを消費し、コンテキストが伸びるほど増える(姉妹モデルEdge0-8Bでは3.3kトークンのコンテキストでKVキャッシュ込み約3.3GiBという実測値が公開されている)。長文プロンプトを扱う場合は2.9GiBはあくまで下限と考えたほうがよい
- 対応ハードウェア: 2026年9月時点でApple SiliconのMLXバックエンドのみが対応。CUDA(NVIDIA GPU)や汎用のWindows/Linux対応はロードマップ上の項目であり、現時点では動作しない
- テスト機種: 公開情報で実測が確認できるのはMac mini M4 Pro(統合メモリ24GB)のみ。M1〜M4世代のApple Silicon全般をサポート対象と謳っているが、機種ごとの詳細なベンチマークは限定的
使い方 — インストールから起動まで
Edge0はEdge0-AIが公開しているPythonパッケージで、モデル一式(ベースチェックポイント+LoRAアダプタ+prerouterの重み)をHugging Faceからまとめて取得し、CLIでチャットを起動する構成になっている。
# パッケージのインストール
pip install edge0[fetch]

# モデル一式(ベース + LoRA + prerouter)を取得
huggingface-cli download Edge0/Edge0-35b-a3b-preview

# チャットを起動
edge0 chat --name edge0-35b
リポジトリを直接チェックアウトして開発版を試す場合は、以下のようにeditableインストールする方法も案内されている。
pip install -e 'git+https://github.com/Edge0-AI/edge0.git#egg=edge0[fetch]'Edge0フレームワーク自体は「SSDエキスパートオフロード+Recover-LoRA+prerouterルーティング予測」という手法を汎用化した拡張可能なフレームワークとして設計されており、標準では2モデルに対応する。35B(Qwen3.5-MoE、K=4)に加え、より軽量なEdge0-8B(Ling 3.0ハイブリッド、K=8、ピークアクティブメモリ約1.0GiB)も同じ仕組みで提供されている。バックエンドはedge0/backends/mlx/配下に切り出されており、将来のCUDAバックエンド追加を見据えた構造になっている。
既存の手法との違い — llama.cppのmmapオフロード・Colibriとの比較
SSD越しにMoEモデルを動かす発想自体はEdge0が最初ではない。llama.cppはGGUF形式のモデルをmmapで扱えるため、物理メモリに収まらない大型モデルでもOS側のページングに任せて動かすことができる。ただしOSレベルのページフォールトは「次に何が必要か」を知らないため、ページ単位で盲目的にブロッキング読み込みが発生する。一方Colibriは370GB級のGLM 5.2を25GBのRAMで動かすことを狙ったC言語製の推論エンジンで、ルーター選択を先読みして必要なエキスパート群を非同期で要求し、次レイヤーで使われそうなエキスパートを投機的にプリロードする仕組みを持つ(予測的中率は約72%と報告されている)。Edge0のprerouterと考え方は近いが、Colibriは汎用のMoEモデル(21,500以上の細粒度エキスパート)を対象にしており、実測速度は0.1〜1tok/s程度とEdge0よりかなり遅い。
| 方式 | 対象モデルの例 | 予測読み込み | 精度回復 | 実測速度の目安 | 対応バックエンド |
|---|---|---|---|---|---|
| Edge0(本記事) | Qwen3.5-MoE 35B-A3B(4bit) | prerouterによる1ステップ先読み(最大+59%) | Recover-LoRA(蒸留LoRA) | 約14.9〜17.7tok/s(M4 Pro) | MLX(Apple Siliconのみ) |
| llama.cpp mmapオフロード | GGUF形式の各種MoE/Denseモデル | なし(OSページフォールト任せ、盲目的) | なし(量子化方式に依存) | モデル・ストレージ次第で大きく変動 | CPU/GPU(CUDA/Metal等)幅広く対応 |
| Colibri | GLM 5.2(370B級) | ルーター先読み+投機的プリロード(的中率約72%) | なし(量子化方式に依存) | 約0.1〜1tok/s | CPU中心のC実装 |
| 通常のQwen3.5-35B-A3Bフルロード | Qwen3.5-MoE 35B-A3B(量子化なし〜4bit) | 不要(全重みが常時RAM上) | 量子化方式に依存(Recover-LoRAなし) | ハードウェア次第(VRAM/RAMに収まれば高速) | 実装依存(llama.cpp/vLLM/MLX等) |
比較から分かるのは、Edge0が「特定の1モデル(Qwen3.5-MoE 35B-A3B、後にEdge0-8Bも追加)向けにprerouterとRecover-LoRAをセットで作り込んだ専用実装」である点だ。汎用性ではllama.cppのmmapオフロードやColibriに劣るが、対象モデルに絞って予測ヘッドと精度回復用LoRAを個別に学習しているぶん、実測速度は本記事執筆時点で確認できる同種のSSDストリーミング手法の中でも高い部類に入る。
注意点・制約
- プレビュー版であること: モデル名に "preview" が付く通り、正式版ではない。README上でもツール利用・複数ステップのエージェント的な計画立案・長時間の自律タスクは「弱い」と明記されている
- Apple Silicon専用: 2026年9月時点でMLXバックエンドのみが動作対象。CUDA対応やWindows/Linuxでの動作はロードマップ項目であり、現時点では利用できない
- KVキャッシュの増加: ピークアクティブメモリ2.9GiBは短いコンテキストでの数値。長いプロンプトや長い会話履歴を扱うとKVキャッシュ分がRAMを追加で消費する
- ストレージ速度の公式基準が未公表: 具体的な必要読み込み速度(GB/s)がドキュメント化されておらず、外付けSSDや低速ストレージでの動作検証も確認できていない。内蔵NVMe以外での利用は自己責任での検証が必要になる
関連記事
- colibriとは何か — 744BのMoEモデルを25GB RAMで動かすpure C推論エンジン
- MiniCPM5-2B 必要スペック早見表 — スマホ・ラズパイ・ラップトップで動かす目安【2026年9月版】
- ローカルLLMのコンテキスト長とVRAM — KVキャッシュ計算式と早見表
よくある質問
Edge0-35B-A3Bは何ビット量子化で、ディスクにどのくらいの容量が必要か。
ベースモデルは4bit量子化されており、ベースチェックポイント・LoRAアダプタ・prerouterの重みを合わせたモデル一式のディスクサイズは約19.6GBである。RAMには全量ロードされず、SSD上に置いたまま必要な分だけストリーミングされる。
なぜ35Bモデルなのに3GiB未満のRAMで動くのか。
MoEモデルは通常、使われないエキスパートも含めて全重みをRAMに常駐させる必要があるが、Edge0は全256エキスパートの重みをSSDに置いたまま、prerouterが次のトークンで必要な4エキスパートを1ステップ先読みして予測し、その分だけをRAMのアクティブバッファへストリーミングする。常駐するのは活性化分の約3B相当のみのため、3GiB未満に収まる。
どんなハードウェアで動くか。WindowsやNVIDIA GPUでも動くか。
2026年9月時点ではApple SiliconのMLXバックエンドのみに対応しており、公開情報で実測が確認できるのはMac mini M4 Proのみである。CUDA対応やWindows/Linuxでの動作はロードマップ項目であり、現時点では利用できない。
llama.cppのmmapオフロードやColibriと何が違うか。
llama.cppのmmapオフロードはOSのページフォールトに任せる盲目的な読み込みで、次に何が必要かを予測しない。Colibriはルーター先読みと投機的プリロードを持つが汎用MoEモデル向けで実測は0.1〜1tok/s程度にとどまる。Edge0はQwen3.5-MoE 35B-A3B専用にprerouterとRecover-LoRAを学習させた専用実装で、M4 Proで約14.9〜17.7tok/sと、同種の手法の中では速い部類に入る。
通常のQwen3.5-35B-A3Bと比べて何が変わるか。
通常ロードでは35B全重みをRAM/VRAMに常駐させる必要があり、4bit量子化でも約19.6GB程度のメモリが必要になる。Edge0はこれをSSDストリーミングで3GiB未満まで下げる代わりに、Edge0独自のRecover-LoRAを適用してもfp16ベース比で平均約3.9ポイントの精度低下が生じるとされ、対応ハードウェアもApple Siliconに限られる。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ