MiniCPM5-2B 必要スペック早見表 — スマホ・ラズパイ・ラップトップで動かす目安【2026年9月版】
2026年9月7日にOpenBMBが公開したMiniCPM5-2B(2.52B・Dense・131Kコンテキスト・Apache-2.0)の必要RAM/VRAMは量子化次第で1.5GB台〜5GB台。GGUFのサイズ表とOllama/llama.cppでの動かし方、Qwen3.5-4Bとの比較をまとめた。
MiniCPM5-2Bの必要メモリはQ4_K_Mで約1.56GB、F16でも約5.04GB
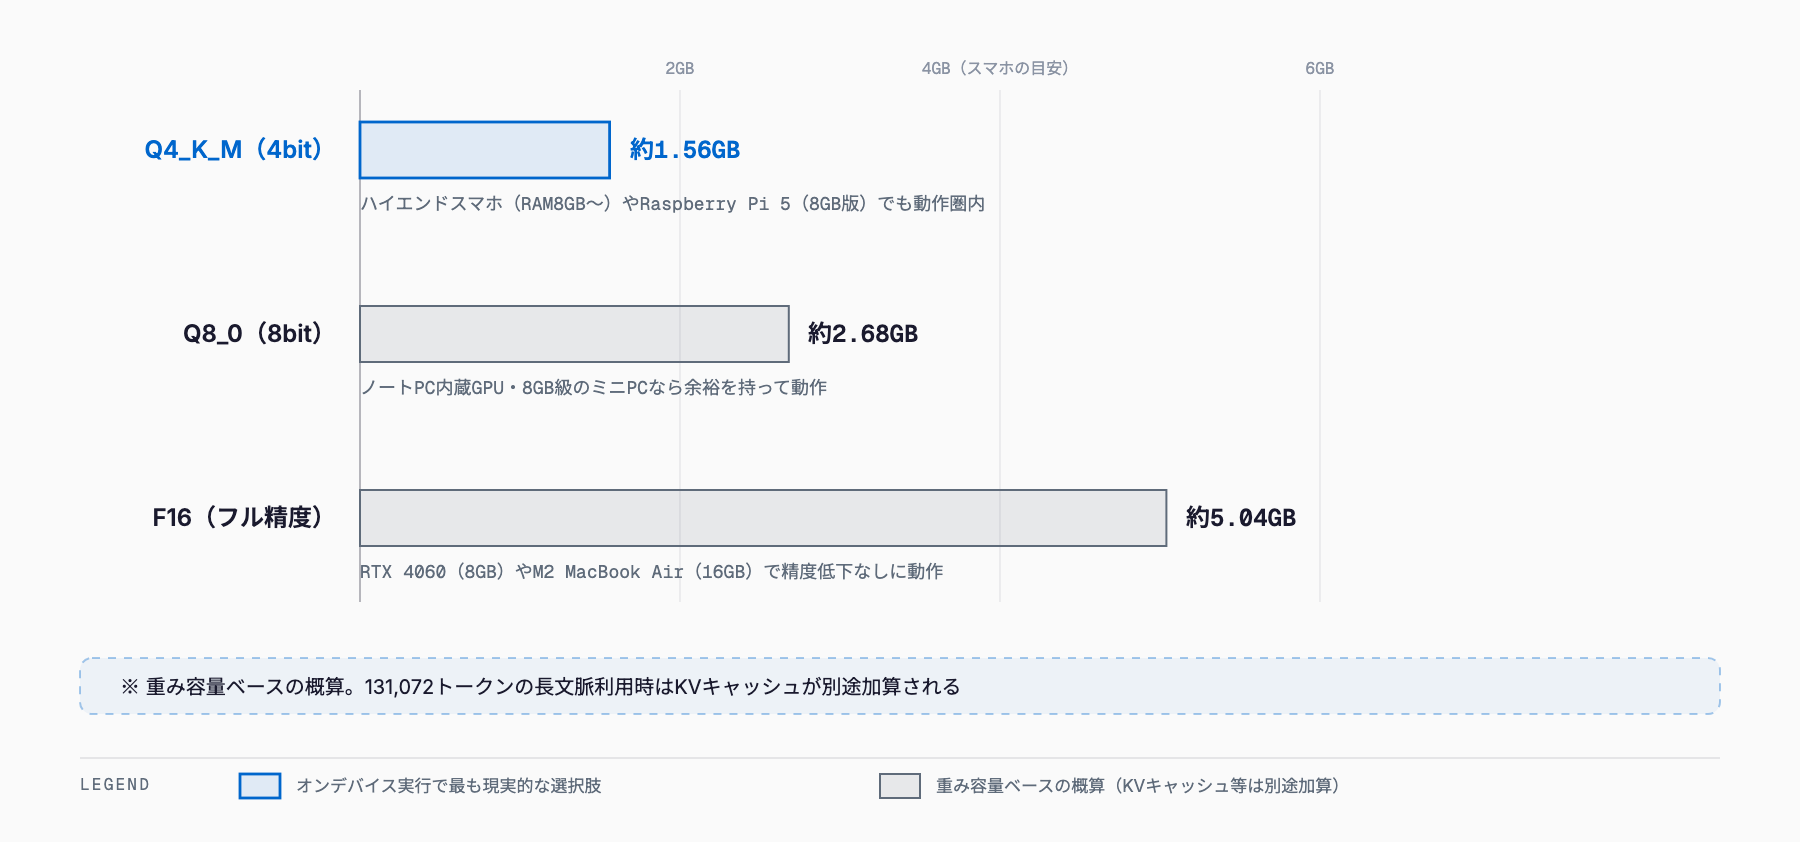
MiniCPM5-2Bは2026年9月7日にOpenBMBが公開した2.52BパラメータのDenseモデルで、オンデバイス実行を前提に設計されている。公式GGUFの必要メモリは量子化により、Q4_K_Mで約1.56GB、Q8_0で約2.68GB、フル精度のF16でも約5.04GBと、いずれもハイエンドスマホやRaspberry Pi 5クラスの機器でも収まる水準にある。結論としては、Q4_K_Mであればハイエンドスマホ(RAM8GB以上)やRaspberry Pi 5(8GB版)でも動作圏内、ノートPCやミニPCならQ8_0以上でも余裕がある。以下、モデル概要・量子化別サイズ・実行手順・比較の順にまとめる。
MiniCPM5-2Bとは何か
MiniCPM5-2BはOpenBMBが開発するMiniCPM5シリーズの一員で、ローカルアシスタント・コーディングエージェント・ツール利用・推論タスクなど、コンパクトなモデルが好まれる用途向けに設計されている。アーキテクチャは標準的なLlamaForCausalLM(Dense Transformer、MoEではない)で、総パラメータ数は2,516,756,480(約2.52B)、埋め込み層を除くと1,981,982,720(約1.98B)。42層のTransformer層に、16クエリヘッド・2キーバリューヘッドのGrouped-Query Attention(GQA)を採用している。コンテキスト長は131,072トークンで、2B級のモデルとしては長い部類に入る。ライセンスはApache-2.0で、商用利用を含め制限は緩い。
| 項目 | 値 |
|---|---|
| 総パラメータ数 | 約2.52B(2,516,756,480) |
| 非埋め込みパラメータ | 約1.98B(1,981,982,720) |
| 方式 | Dense(LlamaForCausalLM) |
| 層数 | 42層 |
| アテンション | GQA(クエリ16ヘッド/KV2ヘッド) |
| コンテキスト長 | 131,072トークン |
| ライセンス | Apache-2.0 |
| 公開日 | 2026年9月7日 |
| 開発元 | OpenBMB |
必要スペック早見表(量子化別)
| 量子化 | ファイルサイズ(公式GGUF) | 想定用途 |
|---|---|---|
| Q2_K(コミュニティ量子化・参考値) | 約1.04GB | 極小メモリ環境の限界値目安 |
| Q3_K_M(コミュニティ量子化・参考値) | 約1.29GB | 低メモリ環境向け |
| Q4_K_M | 約1.56GB | スマホ・Raspberry Pi 5・省メモリ運用の主力 |
| Q5_K_M(コミュニティ量子化・参考値) | 約1.81GB | 精度と軽さのバランス |
| Q6_K(コミュニティ量子化・参考値) | 約2.07GB | 精度重視の中間点 |
| Q8_0 | 約2.68GB | ノートPC・ミニPCでの高精度運用 |
| F16(フル精度) | 約5.04GB | 精度低下なしのローカル検証・開発用途 |
Q4_K_MとQ8_0、F16は開発元OpenBMBの公式GGUF(openbmb/MiniCPM5-2B-GGUF)に掲載されている数値である。Q2_K・Q3_K_M・Q5_K_M・Q6_Kはコミュニティ配布のGGUF(DevQuasar版)で確認できる参考値で、公式が保証する数値ではない点に注意したい。いずれの量子化も重み容量ベースの概算であり、131,072トークンのフルコンテキストを使う場合はKVキャッシュ分のメモリが別途必要になる。手元のスマホ・PC・GPUで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要メモリを試算できるVRAM計算ツール(無料・登録不要)も用意している。
デバイス別の動作目安
- スマートフォン(ハイエンド機・RAM8GB以上): Q4_K_M(約1.56GB)であればOS・他アプリの占有分を差し引いても十分な余裕がある。MLC-LLMやllama.cppベースのモバイルアプリ経由での実行が現実的な選択肢(実測トークン/秒は機種依存のため未検証・推定)
- Raspberry Pi 5(8GBモデル): Q4_K_Mであればメモリ容量上は動作可能。CPU推論となるため速度は控えめになる見込み(実測値は非公表のため推定)
- ノートPC内蔵GPU/統合メモリ機(16GB以上): Q8_0(約2.68GB)やF16(約5.04GB)でも余裕を持って動作
- エントリー〜ミドルクラスGPU(RTX 4060など8GB級): F16でもVRAMの半分程度に収まり、量子化を気にせず運用しやすい
- 131,072トークンのフルコンテキストを使う場合: 上記はいずれも重み容量ベースの概算であり、長文脈を使うほどKVキャッシュ分のメモリが追加で必要になる点に注意
Ollamaでの動かし方
OllamaはHugging FaceのGGUFリポジトリを直接指定して実行できる。MiniCPM5-2BもOllama経由で以下のように起動できる(量子化を指定しない場合はデフォルトのタグが使われるため、軽量に動かしたい場合はQ4_K_Mを明示するのが無難)。
```sh
# Hugging FaceのGGUFを直接指定して実行
ollama run hf.co/openbmb/MiniCPM5-2B-GGUF:Q4_K_M

# OpenBMB公式配布のタグを使う場合
ollama run openbmb/minicpm5-2b
```
llama.cppでの動かし方
llama.cppでは公式GGUFをダウンロードしてllama-serverで起動する。OpenBMBのモデルカードでは以下のコマンド例が示されている。
```sh
llama-server -m MiniCPM5-2B-F16.gguf -a MiniCPM5-2B --port 8080 -ngl 99 -c 8192 --jinja
```
サンプリングパラメータはtemperature=1.0、top_p=0.95、min_p=0.0が推奨されている。llama.cpp環境ではデフォルトのmin_p=0.05のままだと出力が繰り返しになりやすいため、min_p=0.0に変更することが公式ドキュメントで案内されている。また高速化を狙う場合、投機的デコード向けの補助モデル「MiniCPM5-2B-DSpark」もOpenBMBから公開されており、llama.cppでMiniCPM5-2B本体と組み合わせて使う想定になっている。
既存モデルとの違い — Qwen3.5-4B・Gemma 4 E2Bとの比較
| モデル | 総パラメータ | コンテキスト長 | ライセンス | 34ベンチマーク平均(OpenBMB公表) |
|---|---|---|---|---|
| MiniCPM5-2B | 約2.52B(Dense) | 131,072 | Apache-2.0 | 53.9 |
| Qwen3.5-4B | 約4B(Dense) | 262,144(拡張時最大約1,010,000) | Apache-2.0 | 51.1 |
| Gemma 4 E2B | 2B(Dense、Matryoshka Transformer) | 記事執筆時点で個別未確認 | Gemma利用規約 | 非公表(本比較表には含めず) |
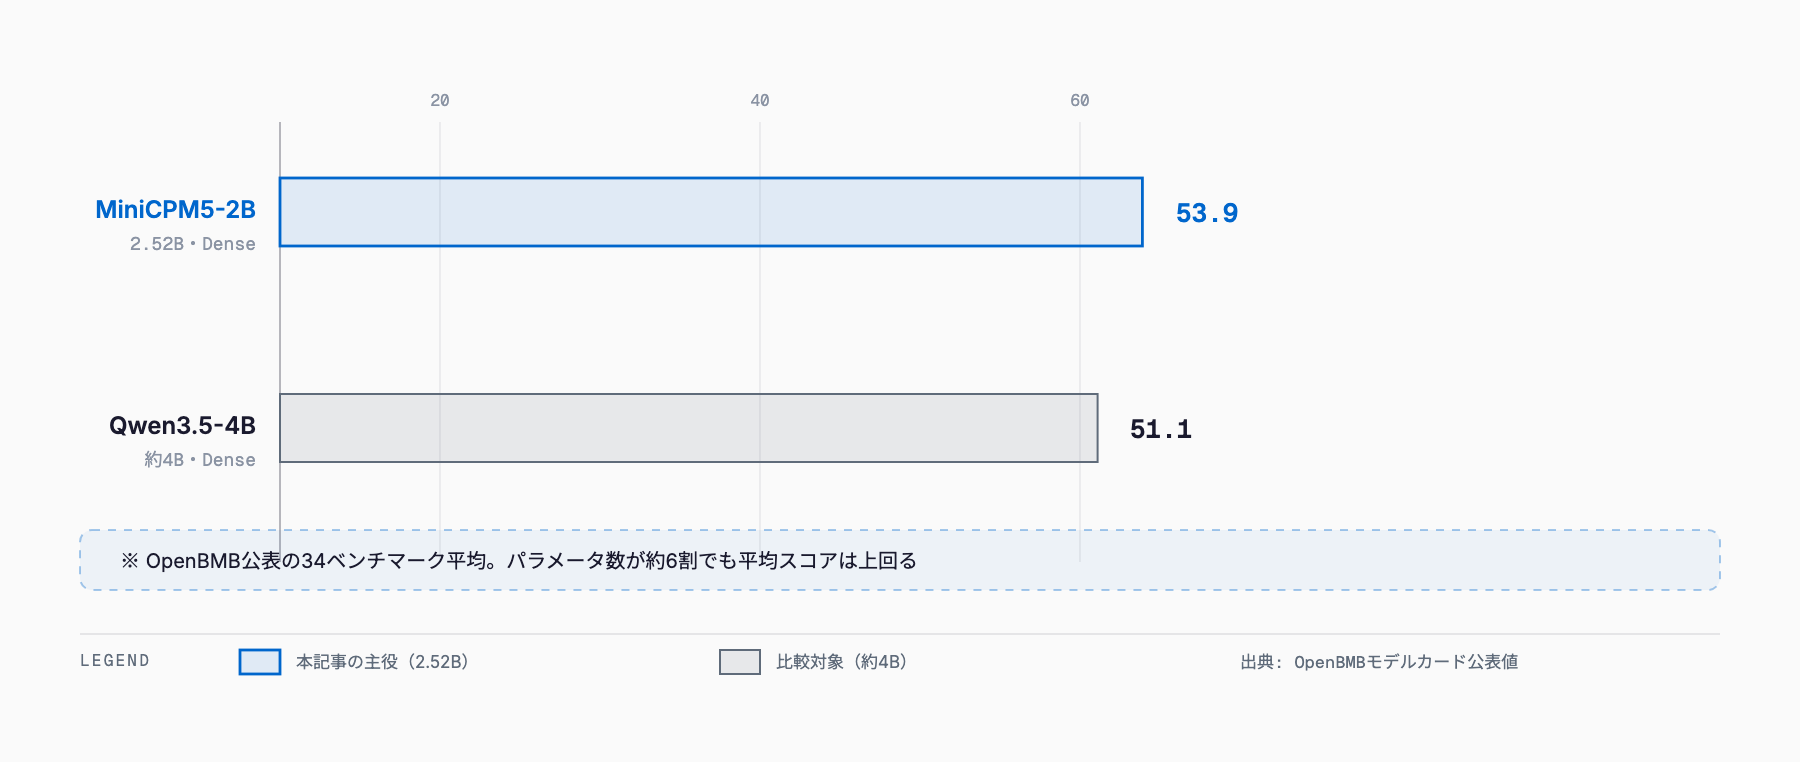
OpenBMBが公表した34ベンチマークの平均スコアでは、MiniCPM5-2B(2.52B)が53.9、Qwen3.5-4B(約4B)が51.1となっており、パラメータ数が約6割にとどまるMiniCPM5-2Bの方が平均スコアで上回っている。個別のベンチマークでは長文脈検索のAA-LCRでMiniCPM5-2Bが59.0%を記録し、同クラスの2Bモデルと比べても差が大きい(OpenBMB公表値としてQwen3.5-2Bが5.3%、Gemma-4-E2B-itが28.7%)。ただしGemma 4 E2Bの34ベンチマーク平均スコアはOpenBMBの比較表に個別掲載されておらず、本記事では未確認の値として比較表には含めていない。Gemma 4シリーズの必要VRAMやMatryoshka Transformer方式の詳細は別記事を参照してほしい。
ベンチマークで見る強み
- コード: LiveCodeBench v6で69.1
- 数学: AIME 2026で86.5、MATH-500で94.6
- ツール利用: BFCL v4で66.6、tau2-Bench Telecomで97.1
- 長文脈検索: AA-LCRで59.0%(同クラスのQwen3.5-2Bは5.3%、Gemma-4-E2B-itは28.7%)
- これらはいずれもOpenBMBが公表した数値であり、当サイトによる独自ベンチマークではない
ライセンスと配布形態
MiniCPM5-2Bはモデル・GGUF量子化版ともApache-2.0ライセンスで公開されており、商用利用を含めて制限は緩い。公式配布はopenbmb/MiniCPM5-2B(元モデル)とopenbmb/MiniCPM5-2B-GGUF(量子化版、Q4_K_M・Q8_0・F16の3種)で、Hugging Face上ではDevQuasarなどのコミュニティによる追加量子化(Q2_K〜Q6_K)も流通している。2026年9月14日時点で、より小型のMiniCPM5-1Bも同シリーズとして公開されているが、本記事はMiniCPM5-2Bに絞って扱う。
関連記事
- Edge0-35B-A3Bとは何か — SSDストリーミングで35BのMoEを3GB未満のRAMで動かす仕組みと必要スペック
- Nex-N2.5 必要スペック早見表 — VRAM 約22GB〜1.6TB級/RTX 4090〜H200マルチノード【2026年9月版】
MiniCPM5-2Bはスマホだけで動かせるか
Q4_K_M量子化(約1.56GB)であればメモリ容量上はハイエンドスマホ(RAM8GB以上)でも収まる。ただし実際の推論速度は機種やアプリ実装(MLC-LLM、llama.cppベースのモバイルアプリなど)に依存し、公式による実機ベンチマークは2026年9月時点で確認できていないため推定にとどまる。
MiniCPM5-2BはMoE(Mixture of Experts)か
いいえ。標準的なLlamaForCausalLM構成のDense Transformerで、42層・GQA(16クエリヘッド/2KVヘッド)という構成。総パラメータ約2.52Bがそのまま推論時に使われる。
Qwen3.5-4Bと比べて何が優れているか
OpenBMB公表の34ベンチマーク平均では、MiniCPM5-2B(2.52B)が53.9、Qwen3.5-4B(約4B)が51.1で、パラメータ数が約6割にとどまるMiniCPM5-2Bの方が平均スコアで上回る。特に長文脈検索(AA-LCR)や一部のツール利用ベンチマークで差が大きい。
131,072トークンのフルコンテキストを使うと必要メモリはどう変わるか
本記事の数値はモデル重みのみの概算で、コンテキストを長く使うほどKVキャッシュ分のメモリが別途加算される。フルコンテキスト利用時の具体的なKVキャッシュ量はOpenBMBから個別に公表されていないため、実運用では余裕を持ったメモリ設計が必要になる。
llama.cppで出力が同じ文の繰り返しになる場合はどうすればよいか
OpenBMBの公式案内では、llama.cppのデフォルトサンプリング設定(min_p=0.05)が繰り返しの原因になりやすいとされている。min_p=0.0に変更し、temperature=1.0・top_p=0.95と合わせて使うことが推奨されている。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ