DeepInferとは — DeepSeek公式の推論フレームワーク、動作要件・使い方・vLLMとの違い
DeepInferは、DeepSeekが公開したApache 2.0の推論フレームワーク【2026年10月】。対応はDeepSeek-V4.1-FlashとSM100 GPU・Ascend 950。動作要件、最短の使い方、EP/DP/CPの意味、vLLMやSGLangとの違い、未公開の部分を整理する。
DeepInfer(ディープインファー)は、DeepSeekが公開したオープンソース(Apache License 2.0)の大規模推論フレームワークで、同社が自社の大規模な本番サービスで使っている推論基盤の一部です。対象は個人のPCではなく、NVIDIAのBlackwell世代データセンターGPU(SM100)やHuawei Ascend 950を何枚も束ねてDeepSeek-V4.1-Flashを動かす、サーバー運用の技術者です。2026年10月にGitHubで公開され、Hacker NewsでTop(2,251ポイント)になりました。
今回公開されたのはオフライン推論(バッチ処理)の部分で、対応モデルはDeepSeek-V4.1-Flashのみです。モデル側の必要メモリや構成はDeepSeek V4.1 Flash 必要スペック早見表にまとめています。本稿は、GitHubのREADMEで確認できた範囲だけをもとに、できること、動作要件、最短の使い方、vLLMなどとの違い、公開されていない部分を整理します。
結論 — 個人向けの「vLLM代替」ではなく、DeepSeek流の最適化の参照実装
先に結論を書くと、DeepInferはOllamaやllama.cppのように手元のGPUやMacで気軽に使うツールではありません。READMEが示す環境はSM100 GPUまたはAscend 950 NPUのマルチGPU構成で、ベンチマークも「prefillに4基、decodeに64基のSM100 GPU(単一のスケールアップドメイン内)」で測られています。一方で、DeepSeekが本番で磨いてきた最適化(専用カーネル、MoEの並列化、投機的デコードなど)がコードとして読めること自体に価値があります。
- 向いている人: 大規模GPUクラスタでDeepSeek-V4.1-Flashを自前運用する、または推論基盤の設計を研究するエンジニア
- 向いていない人: RTX 5090やMacで手軽にローカルLLMを動かしたい個人。この場合はvLLM、SGLang、llama.cppなど既存の選択肢のままでよい
- 今後の見どころ: 今回は「オフライン推論」のみ。サーバー化やKVキャッシュ系は未公開(後述)
DeepInferとは — 公式の位置づけと経緯
READMEでは、DeepInferは「DeepSeekの大規模な本番サービスを支える高性能な推論フレームワーク」と説明されています。今回のリリースで公開されているのはオフライン推論の部分です。ライセンスはApache License 2.0で、確認時点のmainブランチのコミットは4件、READMEにリリース日の記載はありません。まだ公開直後の段階だと考えてください。
成り立ちについては、もともとvLLMを土台に構築し、SGLangとTensorRT-LLMからも着想を得たと説明されています。つまり、まったく新しい別物ではなく、既存の推論エンジンの考え方をDeepSeekのモデル構造に合わせて掘り下げたものです。対応モデルは現時点でDeepSeek-V4.1-Flashだけで、モデル自体の発表内容はV4.1-Flash最速解説、前世代を含む全体像はDeepSeek V4 必要スペック・料金ガイドを参照してください。
何ができるか — 主な機能
READMEに書かれている機能を、役割ごとに整理します。専門用語が多いので、一言説明を添えます。
- 専用カーネル: FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect、およびTileLangによる独自カーネルを利用する
- Attention DP / balanced CP: アテンション部分をデータ並列(DP)や、長い文脈を分担するコンテキスト並列(CP)で処理する
- MoE の EP と EPLB: MoEのエキスパートを複数GPUに分散(EP)し、負荷の偏りをならす(EPLB)。冗長エキスパートの既定数は32で、環境変数 DEEPINFER_OVERRIDE_NUM_EXTRA_EXPERTS で変えられる
- 投機的デコード: DSpark と、確信度に応じて検証を切り替える方式。DEEPINFER_ENABLE_MTP_VARLEN=1 で有効化し、ドラフト長の上限は DEEPINFER_USE_NEXTN_DECODE(既定5)で指定する
- SWA bounded replay: スライディングウィンドウ注意の再計算を抑える仕組み。DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact と DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140 で設定する
- 非同期スケジューリング: 既定でオン
- バッチ不変推論: DEEPINFER_BATCH_INVARIANT=1。同じ入力が、同時に処理される他のリクエストの数に左右されず同じ結果になる(NVIDIAのみ)
- 決定論的サンプリング: バッチ不変を1、MTP_VARLENを0にし、SamplingParamsで seq_seed を固定する(NVIDIAのみ)
- 構造化出力: 正規表現、JSON Schema、EBNFでの出力制約。SamplingParamsの so_args で指定する
報道によれば、DSpark系の投機的デコードで推論が最大およそ85%速くなるとされています。ただしこれはREADME本文ではなく二次情報に基づく数字で、READMEには具体的な速度比較(vLLMやSGLangとの数値比較)は載っていません。Pareto曲線のグラフのみです。
動作要件
| 項目 | 要件 |
|---|---|
| OS | Linux |
| コンパイラ | GCC 13.0以上 |
| Python | 3.12 |
| NVIDIAの場合 | SM100 GPU(Blackwellのデータセンター向け。B200・GB200など)、CUDA 13 |
| Ascendの場合 | Huawei Ascend 950 NPU、CANN 9.2 |
| 対応モデル | DeepSeek-V4.1-Flashのみ |
| 既定のチェックポイント | deepseek-ai/DeepSeek-V4.1-Flash-1017(初回実行時にHugging Faceのキャッシュへ取得) |
| ライセンス | Apache License 2.0 |
見落としやすいのは、RTX 4090/5090のような消費者向けGPUや、Apple Siliconは要件に含まれていない点です。READMEが挙げるのはSM100(Blackwellのデータセンター級)とAscend 950だけです。モデルの重みも、公式配布で約510GBある巨大なものなので、単体GPUでは扱えません。メモリ面の詳細は必要スペック早見表を見てください。
インストール手順
手順は短く、空のPython 3.12環境を作って、アクセラレータの種類を環境変数で指定し、ビルドスクリプトを実行するだけです。
# 空の Python 3.12 環境を用意して有効化したうえで
export DEEPINFER_ACCELERATOR=nvidia   # Ascendなら ascend
./build.sh
モデルの重みは、既定では初回実行時に deepseek-ai/DeepSeek-V4.1-Flash-1017 がHugging Faceのキャッシュへ取得されます。すでに手元にある場合は、環境変数 DEEPINFER_HF_MODEL_DIR=/path でローカルのコピーを指せます。別のチェックポイントを使うときは --model_name で上書きします。510GB級のダウンロードになるため、ディスクと回線の余裕は先に確認してください。
使い方 — 最短手順
オフライン推論のサンプルは examples/offline_inference.py です。並列化の指定でGPUの使い方が変わります。
# EP(エキスパート並列)を8に
python examples/offline_inference.py --ep 8

# EP 2 × データ並列 8
python examples/offline_inference.py --ep 2 --dp 8

# EP 2 × コンテキスト並列 8
python examples/offline_inference.py --ep 2 --cp 8

# 構造化出力の動作確認
python examples/offline_inference.py --check_structured_output
性能を測るには examples/benchmark.py を使います。既定値は decode_num_requests=64、context_length=32768、prefill_batch_size=32768、nextn=5 です。パラメータを振って測りたいときは、スイープ用のスクリプトも用意されています。
python examples/benchmark.py

# decode のスイープ例
bash examples/sweep/run_sweep.sh decode ce-128k 131072 3 0.75
ここまでの内容は、READMEとexamplesに書かれたコマンドをそのまま整理したものです。筆者側で実機実行して確認したものではありません。実際に動かす際は、リポジトリの最新のREADMEを優先してください。
並列化オプション(EP・DP・CP)をやさしく
DeepInferのコマンドには --ep、--dp、--cp という似た名前のオプションが並びます。大まかな意味は次のとおりです。
| オプション | 正式名 | 何を分けるか | たとえ |
|---|---|---|---|
| --ep | Expert Parallel | MoEのエキスパート(専門家)を複数GPUに分散して置く | 専門家チームを複数の部屋に分ける |
| --dp | Data Parallel | リクエスト(入力)を複数GPUで分担して処理する | 窓口を増やして並行して受け付ける |
| --cp | Context Parallel | 長い文脈(コンテキスト)を複数GPUで分担する | 長い資料を何人かで手分けして読む |
MoEモデルは、全体のパラメータは非常に大きいのに、1トークンごとに使うエキスパートは一部だけという構造です。そのため、エキスパートを多数のGPUに分散させるEPが中心になります。READMEの注意として、--cpの値はep_sizeを割り切れる値にする必要があり、ep_sizeは「WORLD_SIZE × 見えているGPU数」で決まります。たとえば8基のGPUで --ep 2 --cp 8 のような指定ができるのは、この関係を満たしているためです(READMEの例の読み方であり、筆者が構成を検証したものではありません)。
エキスパートへのアクセスには偏りが出るため、よく使われるエキスパートの複製を持つ冗長エキスパート(既定32)と負荷分散(EPLB)で偏りを抑えます。こうした細かな調整が、本番サービスの採算を左右する部分です。
vLLM・SGLang・TensorRT-LLM・llama.cpp/Ollamaとの違い
既存の推論エンジンと並べると、位置づけの違いがはっきりします。以下はREADMEと各ツールの一般的な位置づけにもとづく整理で、速度の優劣を示すものではありません。DeepInferには数値での比較が載っていないためです。
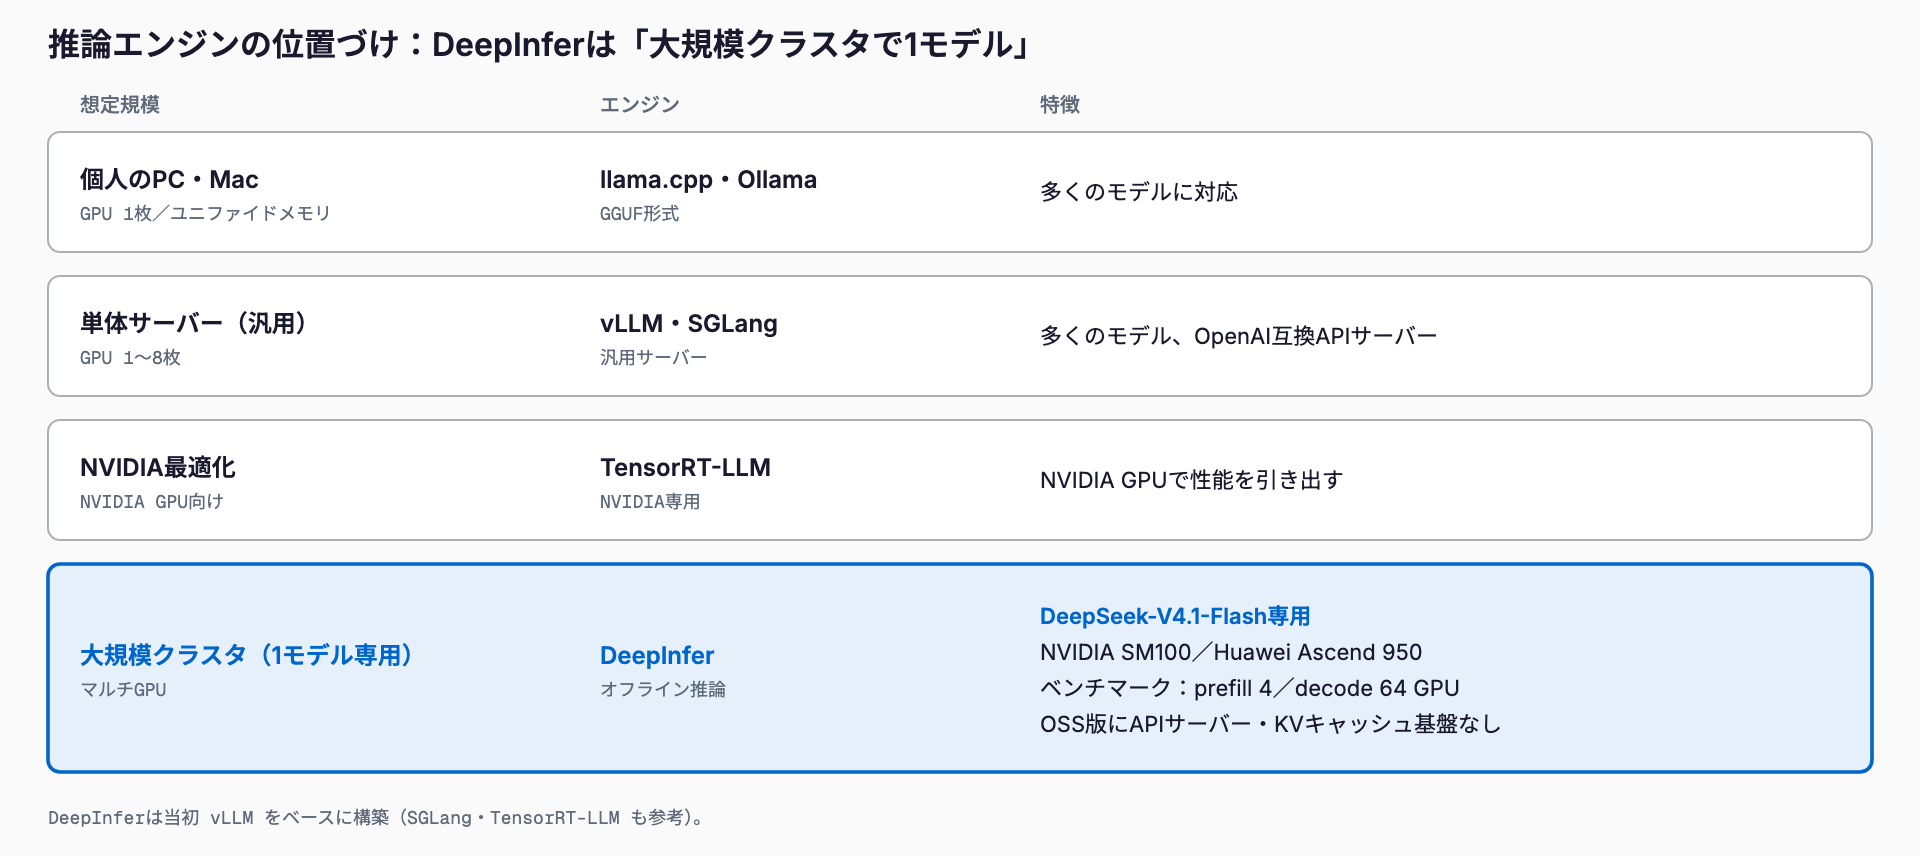
| ツール | 主な対象 | 対応モデル | 対応ハード | 向く場面 |
|---|---|---|---|---|
| DeepInfer | DeepSeek-V4.1-Flashの大規模運用・研究 | V4.1-Flashのみ | SM100 GPU、Ascend 950 | マルチGPUでの大規模オフライン推論、DeepSeek流最適化の学習 |
| vLLM | 汎用の高スループット推論サーバー | 多数のモデル | 幅広いGPU | 自前でLLM APIを立てる標準的な選択肢 |
| SGLang | 汎用の高性能サービング | 多数のモデル | 幅広いGPU | 構造化出力や高速サービングを重視する運用 |
| TensorRT-LLM | NVIDIA GPU向けの最適化推論 | 主要モデル | NVIDIA GPU | NVIDIA環境で性能を詰めたい場合 |
| llama.cpp / Ollama | ローカル実行 | 多数のGGUFモデル | CPU、一般的なGPU、Apple Silicon | 個人PC・Macで手軽に動かす |
DeepInferはvLLMを土台に生まれているため、思想は近いものの、守備範囲を「DeepSeek-V4.1-Flashを、特定の最新ハードで限界まで速く」に絞っています。逆に言えば、複数のモデルを切り替えて使う、OpenAI互換APIでアプリから呼ぶ、といった汎用性はvLLMやSGLangのほうが前提として備えています。
公開されていないもの・制約
READMEには、今回のオープンソース版に含まれないものが明記されています。導入を検討する前に把握しておきたい部分です。
- KVキャッシュシステム: 含まれていない
- Prefill/Decode分離(VEを含む): 含まれていない
- DPレプリカ間のロードバランシング: 含まれていない
- サーバー機能: READMEにOpenAI互換のサーバー/APIの記載はない(今回はオフライン推論の公開)
- 対応モデル: DeepSeek-V4.1-Flashのみ
- 対応ハード: SM100 GPUとAscend 950のみ。バッチ不変推論と決定論的サンプリングはNVIDIAのみ
- 成熟度: コミット数が少なく、リリース日の記載もない初期段階
つまり、本番サービスの全体がそのまま公開されたわけではなく、「推論の中核部分」が先に出た形です。DeepSeekが続報で何を足すかは、現時点では分かりません。
誰が使うべきか — 個人のGPU・Macではどうする?
まずターゲットを整理します。DeepInferを今すぐ試す意味があるのは、B200などのSM100 GPUやAscend 950を実際に使える環境のあるチーム、またはDeepSeekのMoE最適化を学びたい研究・開発者です。
手元のRTX 5090やMacでDeepSeek-V4.1-Flashを動かせるか知りたい場合は、まず必要メモリを確認してください。公式配布の重みで約510GB、4bit級でも約430GBが目安で、H200×8や512GB級のユニファイドメモリが前提です。詳細はDeepSeek V4.1 Flash 必要スペック早見表にあります。この規模に届かない環境では、より小さいモデルをvLLM、SGLang、llama.cpp、Ollamaで動かすほうが現実的です。
エンジニアにとっての意味は、実用面と学習面に分けられます。
- 学習教材として: DeepSeekがどんなカーネルや並列化でMoEを速くしているかをコードで読める
- 再現性の観点で: バッチ不変推論と決定論的サンプリングが実装として公開されている。評価や回帰テストで「同じ入力は同じ出力」を保ちたい場面の参考になる
- 将来への期待: サーバー機能やKVキャッシュ系が加われば、自前運用の選択肢が広がる可能性がある(現時点では未公開)
FAQ
DeepInferとは何ですか?
DeepSeekが公開したApache License 2.0のオープンソース推論フレームワークです。同社の大規模な本番サービスを支える基盤とされ、今回はオフライン推論の部分が公開されました。対応モデルはDeepSeek-V4.1-Flashのみです。
RTX 5090やMacで動きますか?
READMEの対象はNVIDIA SM100 GPU(B200・GB200など)とHuawei Ascend 950 NPUで、RTX 5090やApple Siliconは含まれていません。モデルの重みも公式配布で約510GBあり、手元の単体GPUでは扱えません。個人環境ではvLLM、SGLang、llama.cpp、Ollamaを使うのが現実的です。
vLLMの代わりになりますか?
汎用の置き換えにはなりません。DeepInferはDeepSeek-V4.1-Flash専用で、対応ハードも限られます。複数のモデルを扱う、APIサーバーを立てるといった用途では、vLLMやSGLangのほうが適しています。READMEにvLLMとの数値比較はありません。
商用利用できますか?
DeepInferのコードはApache License 2.0で公開されており、同ライセンスの条件の範囲で商用利用が可能です。ただしモデルの重みのライセンスは別なので、使うモデル側の条件も確認してください。
OpenAI互換のAPIサーバーとして使えますか?
READMEには、OpenAI互換のサーバーやAPIの記載はありません。今回の公開はオフライン推論で、KVキャッシュシステム、Prefill/Decode分離、DPレプリカ間のロードバランシングも含まれていません。
DeepSeek-V4.1-Flash以外のモデルは動かせますか?
READMEが対応モデルとして挙げているのはDeepSeek-V4.1-Flashのみです。既定のチェックポイントはdeepseek-ai/DeepSeek-V4.1-Flash-1017で、--model_nameで上書きできますが、他モデルでの動作は記載されていません。
お気軽にご相談ください
お問い合わせ