Nemotron 3.5 Bolt 必要スペック早見表
74Bを約22GBに、RTX 5090・Mac 32GBから【2026年版】
Nemotron 3.5 Bolt 74B-A9B(24GB版)はGGUF約22GB、必要メモリは24〜32GBでRTX 5090やMac 32GBが下限の目安。128K/256Kの食い違い、実測速度、Gemma 4・Qwen3.6との比較、使い方、OOM対処までまとめて解説。2026年10月更新。
NVIDIA Nemotron 3.5 Bolt 74B-A9B(24GB版)は、テキスト・画像・動画を入力できる総74B・活性9BのオープンウェイトMoEモデルで、GGUFのファイルは約22GB、実際に動かすのに必要なメモリは24〜32GB前後。 RTX 5090(32GB)や32GBのユニファイドメモリを積んだMacが現実的な下限で、24GBのGPU(RTX 4090・RTX 3090)は短いコンテキストか一部CPUオフロードが前提になる(いずれも本記事の推定)。NVIDIAが2026年10月15日に公開し、ライセンスはOpenMDW-1.1で、モデルカードには商用・非商用の両方で利用可能と記載されている。
74Bのモデルが2bit級の量子化と量子化対応蒸留(QAD)によって約22GBまで小さくなったのが最大の特徴である。ただし、速度やベンチマークの多くはNVIDIAなど開発元の公表値で、独立した検証はまだ少ない。本記事では開発元の公表値と第三者の実測を分けて示し、情報源どうしで食い違う点(コンテキスト長など)はその旨を明記する。メモリの推定値は、公表されているファイルサイズと第三者の実測から組み立てたものである。
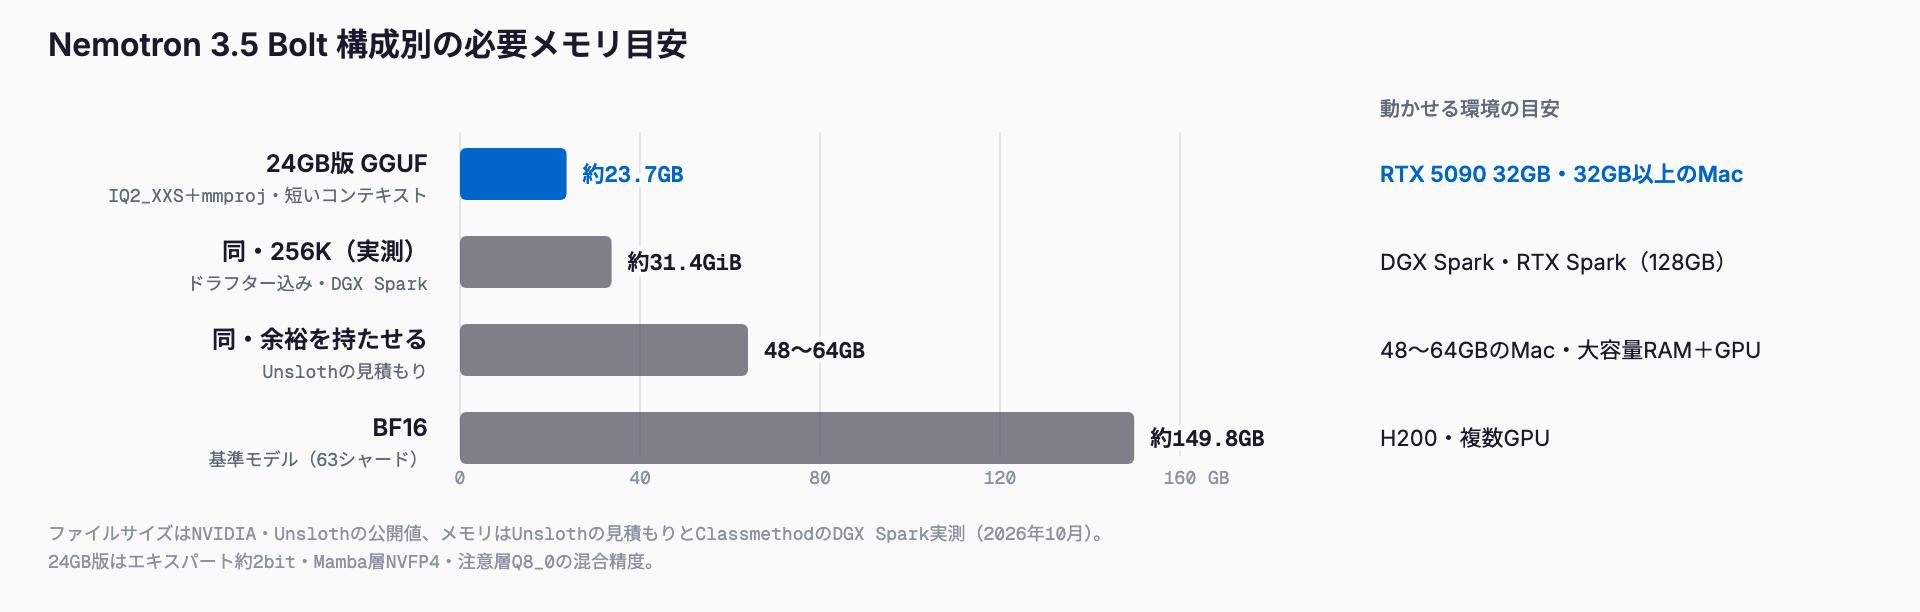
必要スペック早見表
| 構成 | ファイルサイズ | 必要メモリの目安 | 目安のハードウェア |
|---|---|---|---|
| 24GB版 GGUF(IQ2_XXS)+mmproj、短いコンテキスト | 約22.0GB+約1.73GB(計約23.7GB) | 24〜32GB(Unslothの見積もり。短いコンテキスト時) | RTX 5090 32GB、32GB以上のMac |
| 同、余裕を持たせた運用 | 同上 | 48〜64GB(Unslothの見積もり) | 48〜64GBのユニファイドメモリのMac、大容量RAM+GPU |
| 同、256Kコンテキスト(第三者の実測) | 同上 | 約27.9GiB(ドラフター無し)/約31.4GiB(ドラフター有り) | DGX Spark・RTX Spark(128GB) |
| 24GB版 safetensors(vLLM向け) | 約24.12GB(90ファイル) | 約24GB超+KVキャッシュ(推定) | 32GB以上のGPU、DGX Spark |
| BF16(基準モデル) | 約149.8GB(63シャード) | 150GB超(推定) | 128GBのDGX Sparkには載らない。H200や複数GPU |
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。ただしBoltは層ごとにビット幅が違う混合精度なので、単純な「総パラメータ数×ビット数」の試算より、上の表の実ファイルサイズを優先してほしい。
Nemotron 3.5 Boltとは
Nemotron 3.5 Bolt 74B-A9Bは、NVIDIAが2026年10月15日に公開したビジョン言語モデルである。入力はテキスト・画像・動画で、ツール呼び出しとハイブリッドな推論(思考モード)に対応する。総パラメータは74B、1トークンあたりの活性パラメータは9Bで、MoE(Mixture of Experts)らしく、メモリ容量は総パラメータ数で、計算量は活性パラメータ数でほぼ決まる。
| 項目 | 内容 |
|---|---|
| 開発元 | NVIDIA |
| 公開日 | 2026年10月15日 |
| 総パラメータ/活性 | 74B/9B |
| 入力 | テキスト、画像、動画 |
| アーキテクチャ | ハイブリッドLatentMoE(Mamba-2・アテンション・MoEの組み合わせ) |
| 派生元 | Nemotron 3.5 Super VL(Star Elastic圧縮) |
| コンテキスト長 | モデルカード上は256K(vLLMレシピでは262,144)。Unslothの案内は128K |
| ライセンス | OpenMDW-1.1 |
Boltは、親モデルのNemotron 3.5 Super VLを「Star Elastic」と呼ばれる手法で圧縮して作られている。公開情報で確認できる具体的な違いの一つが、エキスパートの上位K(トークンごとに選ばれるエキスパート数)で、親モデルの22に対してBoltは9になっている。選ばれるエキスパートが減るぶん、1トークンあたりの計算が軽くなる。
構造面ではMamba-2(状態空間モデル)、アテンション、MoEを組み合わせたハイブリッドで、従来の純粋なTransformerより長い入力でのメモリ増加が緩やかになりやすい。前世代の関連モデルはNemotron 3.5 Lightning Switchyardの記事やNemotron 3の必要スペック記事で整理している。
74Bがなぜ24GBに収まるのか
単純計算では、74Bのパラメータを2bitで持つと約18.5GBになる。実際のファイルが約22GBなのは、全部を2bitにしているわけではなく、品質への影響が大きい部分は高い精度で残しているためである。NVIDIAの説明にもとづく内訳は次のとおり。
| 部位 | 精度 |
|---|---|
| エキスパートの重み(容量の大部分) | IQ2_XXS(2.0625 bit/要素) |
| Mambaレイヤー | NVFP4 |
| 埋め込み・出力ヘッド・アテンション・LatentMoEの重み | Q8_0 |
容量の大半を占めるエキスパートだけを極端に圧縮し、数が少なく影響の大きい部分を8bit級で残す設計である。そのうえでNVIDIAは、量子化したあとに丸めるだけでなく、量子化対応蒸留(QAD)で品質を回復させたと説明している。2bitを後から機械的に当てはめた場合に起こりがちな品質低下を、学習側で埋めている点が、この24GB版の位置づけである。ただし品質がどこまで保たれているかは、現時点では開発元の公表値と少数の第三者テストでしか確認できない。
配布物はGGUF本体が約22.0GB(20.51GiB)、画像・動画用のビジョンプロジェクタ(mmproj)が約1.73GB、vLLM向けのsafetensors版が約24.12GB(90ファイル)、基準となるBF16が約149.8GB(63シャード)である。推測的デコーディング用のドラフター「LiLiCorr」は1.13Bパラメータで、GGUFは約0.93〜1GB、実行時に1〜2GB程度のメモリが追加される。受理長はNVIDIAの公表値でグリーディ4.68、サンプリング4.25である。
コンテキスト長とメモリ
コンテキスト長は情報源で食い違っている。モデルカードは256K(vLLMレシピでは262,144トークン)とし、Unslothのガイドは128Kと記載している。なお、NVIDIAの「24GB」という目標は、バッチサイズ1・128Kコンテキストを前提にしたものである。長い入力を使う場合は、利用するランタイムの最新ドキュメントとモデルカードを確認してほしい。
メモリの目安は次のとおり。Unslothは、短いコンテキストなら最低24〜32GBのRAM、余裕を持たせるなら48〜64GBを推奨しており、長いコンテキストや画像・動画を扱うならさらに必要としている。独立した測定としては、クラスメソッドがDGX Spark(128GB)で262Kコンテキストを設定した状態の常駐メモリを、ドラフター無しで約27.9GiB、ドラフター有りで約31.4GiBと報告している。重みの約22GBに対して追加分が小さいのは、Mambaレイヤーが固定サイズの状態を持つためKVキャッシュが膨らみにくいという構造の影響と考えられる(これは推定)。
実際の運用では、まず4K程度の小さいコンテキストで起動し、メモリに余裕があれば段階的に増やすのが安全である。画像や動画を入力するとビジョンエンコーダの処理とトークンぶんの追加メモリが必要になる。
速度の実測値
| 環境・条件 | 出典 | 速度 |
|---|---|---|
| 24GB目標 | NVIDIA(目標値) | 80 tok/s以上 |
| RTX Spark(Surface Laptop Ultra 128GB、Windows 11 ARM)、llama.cpp+ドラフター、AIPerfのコーディング | NVIDIA(開発元の公表値) | 83.99 tok/s |
| DGX Spark、llama.cpp、推測無し | クラスメソッド(第三者) | 39.47 tok/s |
| DGX Spark、llama.cpp、ドラフター有り | クラスメソッド(第三者) | 61.61 tok/s(約1.56倍) |
| DGX Spark、vLLM、単一リクエスト | クラスメソッド(第三者) | 31.46 tok/s(llama.cppより約20%遅い) |
| DGX Spark、vLLM、同時実行8 | クラスメソッド(第三者) | 合計102.45 tok/s(1リクエスト13.26 tok/s) |
開発元の83.99 tok/sはRTX Spark上の条件で、第三者のDGX Sparkの結果とは機材が違うため、数字を直接比べることはできない。DGX Sparkでの実測では、ドラフターを使うと約1.56倍に伸びた。一方、vLLMは単一リクエストではllama.cppより遅く、同時実行を8に増やすと合計スループットは上がるが1リクエストあたりは13.26 tok/sまで下がる。そのため、1人が自分のマシンで使う用途に向いたモデルで、多人数に同時提供するサーバー用途には向きにくい。
ベンチマークと既存モデルとの比較
ベンチマークは開発元の公表値が中心である。NVIDIAはTerminal-Bench 2.1で50.98、BrowseCompで66.75を報告し、同じメモリクラスではPinchBenchで1位としている。第三者のArtificial Analysisでは、Artificial Analysis Intelligence Indexが21で、同クラス67モデル中4位である。
| 項目 | Nemotron 3.5 Bolt 74B-A9B | Qwen3.6 35B-A3B | Gemma 4 26B-A4B | Qwen3.8 27B |
|---|---|---|---|---|
| AA-AgentPerf ローカル再生時間(短いほど速い) | 600.80秒 | 453.97秒 | 480.68秒 | 1,043.28秒 |
| AA-Omniscience 正答率 | 16.90 | — | 22.17 | — |
| 総/活性パラメータ | 74B/9B | 35B/3B | 26B/4B | 27B |
表の「—」は、本記事の根拠資料で確認していない項目である。注意点が二つある。第一に、AA-AgentPerfの再生時間ではQwen3.6 35B-A3BやGemma 4 26B-A4Bのほうが速く、AA-Omniscienceの正答率でもGemma 4 26B-A4Bのほうが高い。第二に、Artificial Analysisの測定ではBoltの出力トークン数が2億3,000万と、中央値の1億に対して多く、思考が冗長になりやすい。クラスメソッドの試験でも、要約タスクの一つがデフォルトの思考設定でトークン上限を使い切った。ベンチマークの順位だけでなく、実際の所要時間とトークン消費で比較することを勧める。Gemma 4側のスペックはGemma 4のハードウェア要件記事に整理している。
GPU・Mac・DGX Sparkの推奨構成
以下は、ファイルサイズ(GGUF約22GB+mmproj約1.73GB)と上記の実測から導いた推定である。
- RTX 5090(32GB):テキスト中心なら余裕がある。画像・動画を入れても、コンテキストを抑えれば収まる見込み
- RTX 4090/RTX 3090(24GB):重みとmmprojで約23.7GBあり、短いコンテキストでもほぼ満杯になる。コンテキストを小さくするか、一部をCPUへオフロードする運用が前提で、画像入力は厳しい
- Mac(ユニファイドメモリ):32GBが最小の目安で、OSや他アプリを考えると48〜64GBが快適。メモリ帯域が速度を左右する
- DGX Spark/RTX Spark(128GB):256K級のコンテキストやドラフター併用でも余裕があり、第三者の実測もこのクラスで行われている。BF16(149.8GB)はファインチューニングを含めて載らない
- 予算を抑える場合:RAMを多く積んだPCでCPUオフロードを併用すれば動く可能性はあるが、速度は大きく落ちる(推定)
DGX Sparkをローカル推論に使う例は、DGX Sparkで機密コードを解析する記事も参考になる。
使い方(llama.cpp・Unsloth・vLLM・Ollama・LM Studio)
対応ランタイムはllama.cpp、Ollama、LM Studio、vLLM、Unslothである。llama.cppは10月15日にBolt対応がmasterへ取り込まれたので、必ず最新のmasterからビルドする。まず、UnslothのGGUFと画像用のmmprojをダウンロードする。
hf download unsloth/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-GGUF --local-dir models/nemotron-bolt --include "*IQ2_XXS*.gguf" "*mmproj*.gguf"テキストだけで試す場合は、コンテキストを4Kに抑えて起動する。MODEL_FILEにはダウンロードしたGGUFのパスを入れる。
./llama.cpp/llama-cli --model "$MODEL_FILE" --ctx-size 4096 --prompt "こんにちは。自己紹介してください。"画像を使う場合はllama-mtmd-cliに--mmprojと--imageを指定する。動画はllama-mtmd-cliの中で /video にパスを渡して読み込む。ffmpegとffprobeが必要で、MP4は2分まで、1080pなら最大1FPS・128フレーム、720pなら最大2FPS・256フレームが上限とされている。
OpenAI互換のローカルサーバーとして動かすには、Unslothのコマンドが手軽である。
unsloth run --model unsloth/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-GGUF:IQ2_XXS --ctx-size 4096 --parallel 1 --alias nemotron-bolt --host 127.0.0.1 --port 8001vLLMは、DGX Spark向けに量子化チェックポイントを使う手順が公開されており、KVキャッシュのfp8化と最大同時シーケンス数1(max-num-seqs 1)が指定されている。対応GPUはAmpere・Hopper・Blackwell世代が挙げられている。起動オプションの詳細は、モデルカードのレシピを確認してほしい。UnslothはファインチューニングとUnsloth Desktopにも対応している。OllamaとLM Studioも対応しているが、タグ名は変わりうるので、各ライブラリでモデル名を検索して確認してほしい。
ライセンスと商用利用
ライセンスはOpenMDW-1.1で、モデルカードには商用・非商用の両方で利用可能(ready for commercial and non-commercial use)と記載されている。ただし、再配布や派生モデルの条件は個別に定められているため、業務で使う前に公開時点のモデルカードとライセンス本文を必ず読んでほしい。また、ライセンスが寛容でも、入力する画像や文書に個人情報・機密情報が含まれる場合の取り扱いは別問題で、保存先や社内ルールは自社で決める必要がある。
トラブルシューティング
- 起動時にメモリ不足(OOM):コンテキスト長を4K程度まで下げる。画像・動画の入力を外す。ドラフターを外して1〜2GBを空ける。それでも足りなければCPUオフロードを使う
- 24GBのGPUでぎりぎり動かない:重みとmmprojで約23.7GBあるため、mmprojを読み込まずテキスト専用にするか、レイヤーの一部をCPUへ逃がす
- 思考が終わらず、トークンを使い切る:デフォルトの思考設定では出力が非常に長くなることがある。最大トークン数を十分に確保するか、思考の強さを抑える設定を使う
- モデルが読み込めない・変な出力になる:llama.cppのビルドが古い可能性が高い。10月15日以降のmasterから再ビルドする
- vLLMで遅い:単一リクエストではllama.cppより遅いという実測がある。1人で使うならllama.cppを優先する
- 動画が読み込めない:ffmpeg・ffprobeの導入、MP4で2分以内、解像度とフレーム数の上限を確認する
まとめ
Nemotron 3.5 Bolt 74B-A9Bの24GB版は、GGUFで約22GB、mmprojを足して約23.7GBの74B・活性9Bのマルチモーダルモデルで、32GBのGPUやMacが現実的な下限である。2bit級の混合精度と量子化対応蒸留で小型化されているが、速度や品質の根拠は開発元の公表値に偏っている。
実測では、DGX Sparkでドラフター併用時に約61.6 tok/s、同時実行には向かないという傾向が出ている。同クラスのQwen3.6 35B-A3BやGemma 4 26B-A4Bより遅く、出力トークンも多い点も踏まえ、導入前に自分の用途で所要時間とメモリを実測するのが確実である。
よくある質問
Nemotron 3.5 Boltを動かすのに必要なメモリはどれくらいですか。
24GB版のGGUFが約22.0GB、画像用のmmprojが約1.73GBで、合計約23.7GBです。Unslothは短いコンテキストで最低24〜32GB、余裕を持たせるなら48〜64GBの目安を示しています。第三者の実測では、DGX Sparkで262Kコンテキストを設定して約27.9GiB(ドラフター有りで約31.4GiB)でした。
RTX 4090(24GB)で動きますか。
重みとmmprojだけで約23.7GBあるため、短いコンテキストでもほぼ満杯になります。コンテキストを小さくするか、一部をCPUへオフロードする前提で、画像入力は難しいというのが本記事の推定です。余裕を持って使うならRTX 5090(32GB)や32GB以上のMacが現実的です。
コンテキスト長は128Kと256Kのどちらですか。
情報源で食い違っています。モデルカードは256K(vLLMレシピでは262,144)、Unslothのガイドは128Kと記載しています。NVIDIAの24GBという目標は、バッチサイズ1・128Kコンテキストを前提にしたものです。まず小さいコンテキストで起動し、段階的に増やしてください。
速度はどれくらいですか。
NVIDIAは24GBで80 tok/s以上を目標とし、RTX Sparkのllama.cpp+ドラフターで83.99 tok/sを公表しています(開発元の値)。第三者のDGX Sparkでは、llama.cppで39.47 tok/s、ドラフター有りで61.61 tok/s、vLLM単一リクエストで31.46 tok/sでした。環境が違うため直接は比べられません。
商用利用できますか。
ライセンスはOpenMDW-1.1で、モデルカードには商用・非商用の両方で利用可能と記載されています。ただし再配布や派生モデルの条件は別に定められているため、利用前に公開時点のモデルカードとライセンス本文を確認してください。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ