Fish Audio Drama 3 とは — 必要スペック・ライセンス・使い方【35B MoE TTS】
2026年10月公開のFish Audio Drama 3を解説。35B MoEのオープンウェイトTTSで、公式の最小要件は未公表、自前運用はVRAM48GB級が目安。年間売上50万ドル未満なら商用無料のライセンス、API料金、SGLang-Omniでの起動とAPI呼び出しの使い方まで詳しく整理した。
Fish Audio Drama 3 は、Fish Audio が2026年10月13日に公開したテキスト読み上げ(TTS)モデルである。総パラメータ35B・1トークンあたりの活性は約3BのMoE構成で、重みは Hugging Face(fishaudio/drama-3)で公開されている。感情や間の演技指示を [whispering] のようなタグで書き込めること、最大16人の話者を1回の生成で扱えることが特徴だ。
結論から先に整理する。①必要スペック:公式の最小要件は未公開で、公式ベンチマークはすべて NVIDIA H200 上。自前運用の目安は VRAM 48GB 以上の GPU 1枚(第三者ガイドの推奨)。24GB のコンシューマーGPUは想定外だ。②ライセンス:Fish Audio Community License v1.0。研究・非商用は無料、自社と関連会社の年間売上が US$500,000 未満なら商用も無料。それ以上、または Drama 3 を他者向けの TTS/API として提供する場合は別途ライセンスが必要。③料金:ホストAPIは定価 $50 / 100万文字、2026年11月12日までは発売記念で $10 / 100万文字。④使い方:SGLang-Omni で起動し /v1/tts に POST する。以下、順に見ていく。
なお本記事は公式ブログ、Hugging Face のモデルカード、報道で確認できた情報だけを根拠にしている。公式に書かれていない点は「未公表」と明記し、筆者の推定は「目安」と記す。
Drama 3 とは — 演技指示を書ける35B MoEのTTS
Drama 3 は、従来の Fish Audio の S2 系(S2、S2.1 Pro)に続く新世代の音声生成モデルである。fish.audio の Web、iOS/Android アプリ、API で使えるほか、重みが公開されているため自前のサーバーでも動かせる。技術レポートは arXiv 2610.18010、コードは github.com/fishaudio/fish-speech、ドキュメントは docs.fish.audio にまとまっている。
Fish Audio 社は2026年7月に 5,200万ドルのシード調達を発表しており、年間経常収益は2,100万ドル、ユーザー数は800万人超と報じられている。商用の音声プロダクトを持つ会社が、旗艦級モデルの重みを公開した点が今回のニュースの核心だ。ただし後述のとおり、オープンウェイトであってオープンソースではない。
何ができるか — 演技・多話者・声のクローン
Drama 3 の主な機能は次のとおりである。
- 演技指示(direction):行頭に角括弧で指示を書く。言語は問わない。行の途中に括弧を置くと、その位置から話し方が切り替わる
- 非言語表現:[shaky breath] [small laugh] [whispering] [sighs] [laughs] のようなタグで息づかいや笑いを入れられる
- 範囲タグ:<emphasis>…</emphasis> や <whisper>…</whisper> で、選んだ語句だけ強調・ささやきにできる
- 多話者:<|speaker:0|> から <|speaker:15|> までのタグで、最大16人の登場人物を1つのテキストに書ける。掛け合いの場面を1回の生成で出力できる
- 長文対応:長いテキストは自動で分割され、ストリーミング出力にも対応する
- ボイスクローン:参照音声とその書き起こしを渡して声を再現する
- 続きからの編集:previous_takes で直前のテイクを渡し、継続する形で編集する
なお、音声の一部だけを差し替えるオーディオ・インペインティング(対話的編集)は招待制のテスト段階で、編集APIは「coming soon」とされている。現時点で誰でも使えるとは書かれていないので、編集機能を前提にした設計は避けたほうがよい。
対応言語は83言語と発表されている。ただし、確認できたページには公式の言語一覧が載っていない。公式ブログには日本語の演技指示の例が示されているものの、日本語の品質や対応範囲は、公式の言語一覧と実際の試聴で必ず確認してほしい。
スペック — アーキテクチャと速度
Drama 3 の構造は、前世代からかなり変わっている。公開情報を表にまとめる。
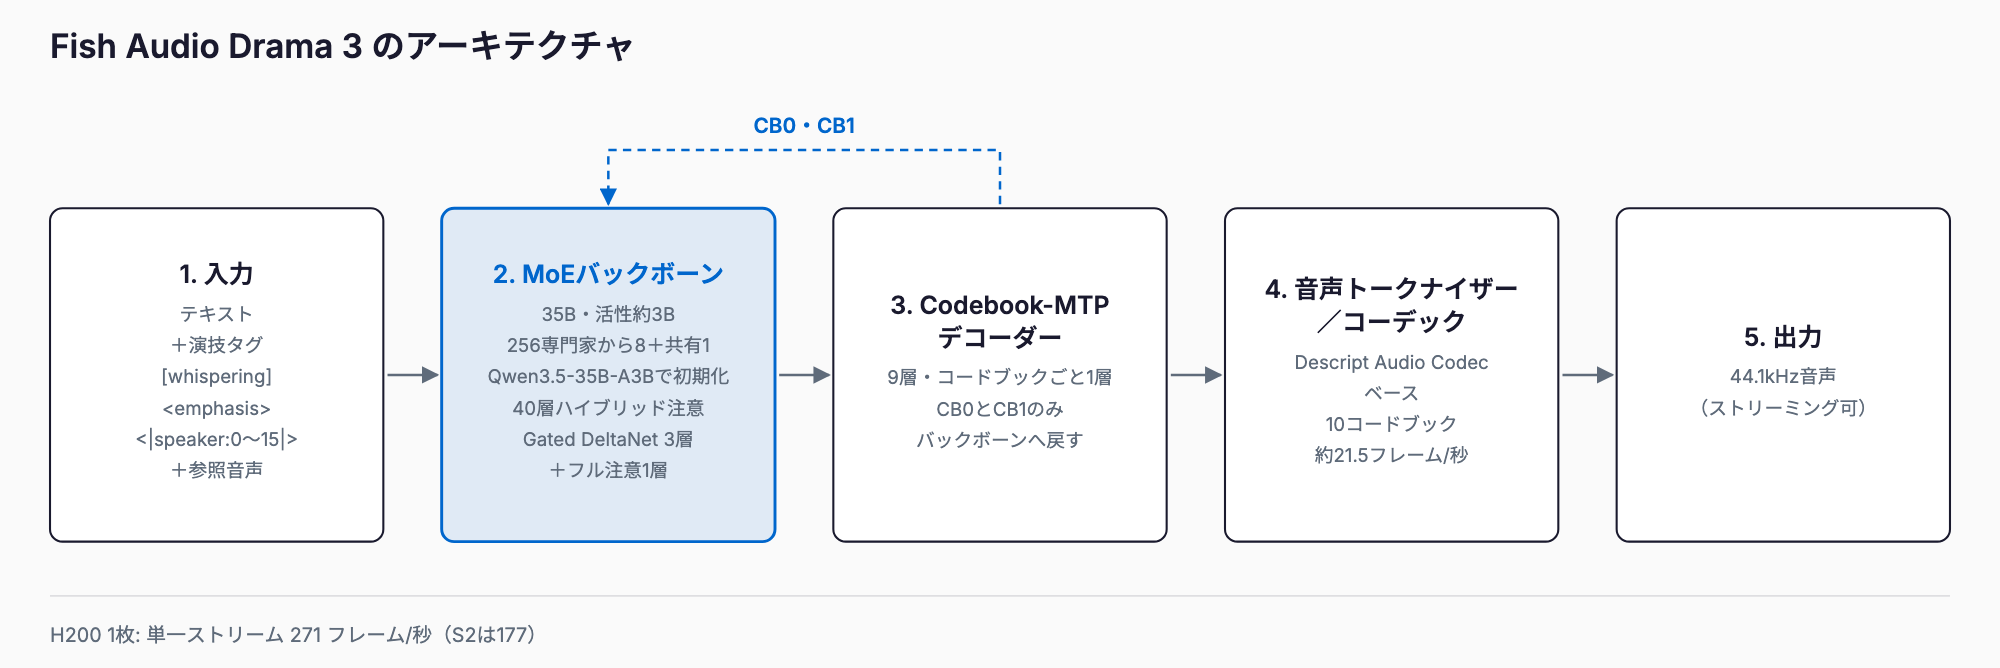
| 項目 | 内容 |
|---|---|
| 総パラメータ | 35B(Hugging Face 表記は36B) |
| 構成 | MoE。256の専門家から8つ+共有1つを使い、1トークンあたり約3Bが活性 |
| バックボーン | Qwen3.5-35B-A3B の言語モデルで初期化 |
| アテンション | ハイブリッド。40層、Gated DeltaNet 3層+ゲート付きフルアテンション1層の繰り返し |
| デコーダー | Codebook-MTP(9層、音響コードブックごとに1層)。S2 の Fast AR を置き換え |
| トークナイザー | S2 と同じ。Descript Audio Codec ベース、44.1 kHz、10コードブック、約21.5フレーム/秒、完全因果 |
| 重みの形式 | safetensors。MoE の専門家は FP8(F8_E4M3)、その他は BF16 |
| 学習 | 事前学習3段階、指示ファインチューニング、人間の好みを学習した報酬モデルによるRL(KLペナルティなしのGRPO) |
バックボーンの出発点が Qwen3.5-35B-A3B の言語モデルである点は、ローカルLLMに親しんだ読者には馴染み深いだろう。同系統のモデルを自前運用する際の考え方は、Qwen3.5 27B/35B のローカル運用の記事も参考になる。ただし音声生成ではコードブックの生成とボコーダーが加わるため、メモリの見積もりはLLMと同じ感覚では済まない。
速度については、公式が H200 1枚での数値を出している。単一ストリームのデコードは Drama 3 が毎秒271フレーム、S2 が177フレームだ。モデルカードのストリーミング計測(H200 1枚)は次のとおりである。
| 同時接続数 | フレーム/秒 | 初回音声までの時間(p50) | RTF |
|---|---|---|---|
| 1 | 166.7 | 88.9 ms | 0.131 |
| 16 | 927.6 | 210.1 ms | 0.373 |
| 64 | 1,687.3 | 450.9 ms | 0.801 |
RTF(実時間比)が1未満なら、生成が再生より速いことを意味する。64並列でも RTF 0.801 を保つので、H200 級の GPU があれば対話サービスにも使える水準だ。さらに256ストリームでボコーダーを2枚目の GPU に載せると、同一 GPU の場合(2,422フレーム/秒、初回音声まで3,403 ms)に対し、4,160フレーム/秒、2,146 ms に改善したと報告されている。大規模運用ではGPUの分割が効くという示唆である。
品質 — 発音の堅牢性ベンチマーク
Artificial Analysis の「Pronunciation Robustness」(英語)では、Drama 3 が 93.2% で1位となり、ElevenLabs の Eleven v4 と v4 Turbo を上回ったと報じられている。Fish S2.1 Pro は88.1%だった。サブスコアは次のとおりだ。
| 区分 | Drama 3 | Fish S2.1 Pro |
|---|---|---|
| ブランド名・地名・専門用語 | 95.9 | 87.3 |
| 文脈で読みが変わる語 | 95.3 | 86.1 |
| 略記(数字・日付・単位) | 93.6 | 92.7 |
| 厳密な並び(コード・パス・メールアドレス) | 86.3 | 79.4 |
Artificial Analysis の TTS リーダーボードでは、オープンウェイトモデルの中で最上位とも報じられている。ただしこれは英語の発音テストであり、日本語の読み間違いの少なさを直接示すものではない。日本語で使う予定なら、自社の固有名詞や数字表現で試聴するのが確実だ。日本語に特化したオープンモデルとしては、Irodori-TTS-v4-Large が比較対象になる。
必要スペック — 公式の最小要件はない
ここが最も誤解されやすい点なので、はっきり書く。Drama 3 に公式の最小動作要件は示されていない。公式ベンチマークはすべて NVIDIA H200 で取られており、それ以外の GPU での動作や速度は公式には保証されていない。
一方、第三者のガイドでは、FP8 での自前運用に VRAM 48GB 以上の GPU 1枚(RTX 6000 Ada、L40S、A6000 48GB クラス、H100、H200 など)を推奨している。重みだけで約35Bのパラメータの大半が FP8 なので、30GB台半ばになると見積もれる。これに KV キャッシュやボコーダーの領域が加わるため、48GB が現実的な下限という筋書きだ。以下は筆者の目安であり、公式値ではない。
| GPU の区分 | 目安 | 備考 |
|---|---|---|
| H200 / H100 | 公式ベンチの環境(H200)。余裕あり | 多並列の本番運用向け |
| 48GB 級(L40S、RTX 6000 Ada、A6000) | 動作が見込める下限の目安 | 第三者ガイドの推奨。並列数は絞る |
| 24GB(RTX 4090 など) | 想定外 | 公式の量子化版なし |
| 32GB(RTX 5090) | 想定外 | 重みだけで収まらない見込み |
| Mac | 公式に記載なし | 未確認 |
発売時点で、公式の GGUF やコンシューマー向けの量子化版は提供されていない。Hugging Face 上にはコミュニティによる量子化版が存在するとされているが、品質は未検証である。ローカルPCで気軽に動かすモデルではなく、サーバー用GPUで運用する前提のモデルと考えたほうがよい。PCで手軽に使いたいなら、後述のホストAPIか、より小型の代替を選ぶのが現実的だ。
ライセンス — 商用可否の整理
Drama 3 の重みは Fish Audio Community License v1.0 で公開されている。これはオープンウェイトのライセンスであり、OSI が定義するオープンソースではない。条件は次のとおりだ。
- 研究・非商用:無料
- 商用(小規模):あなたと関連会社の年間売上が US$500,000 未満なら、商用利用も無料
- 商用(大規模):年間売上が US$500,000 以上なら、Fish Audio からライセンスを取得する必要がある
- サービス提供:売上の大小にかかわらず、Drama 3 を TTS・ボイスクローン・推論サービスや API として他者に提供する場合はライセンスが必要(問い合わせ先は business@fish.audio)
- 禁止事項:本人の同意なく実在の人物の声をクローンすることは禁止
注意したいのは、Hugging Face のライセンス表示が fish-audio-research-license となっている点だ。S2 は引き続き Fish Audio Research License の下にあるため、表示の混在かもしれない。実際に商用利用を決める前に、リポジトリ同梱の LICENSE ファイルの全文を必ず確認してほしい。特に「自社サービスの裏側で使う」と「他社に API として売る」の境目は、契約上の解釈が分かれやすい。法務の確認を挟むのが安全だ。
料金 — ホストAPIとアプリ
自前で GPU を用意しない場合は、Fish Audio のホストAPIを使う。エンドポイントは S2.1 Pro と同じ https://api.fish.audio/v1/tts で、ヘッダーに model: drama-3 を指定し、タグは text にそのまま書く。
| 項目 | 価格 |
|---|---|
| API 定価 | $50 / 100万文字 |
| 発売記念価格(2026年10月13日〜11月12日) | $10 / 100万文字(80%オフ) |
| アプリ | Drama 3 は S2.1 Pro と同じクレジットを消費。新しい Plus/Pro/Max プランは11月12日まで50%オフ |
たとえば発売記念価格なら、1万文字の原稿を1本生成しても約 $0.10 の計算になる($10 ÷ 100万文字 × 1万文字)。定価の $50 でも約 $0.50 だ。ただし、これは単純な文字数換算であり、再生成やリトライ、無音区間の扱いによる増減は公式に明記されていない。自前運用は GPU の費用が固定でかかるため、月間の文字数が少ないうちはAPIのほうが安いと見ておくのが無難だ。
使い方 — SGLang-Omni での起動とAPI呼び出し
自前で動かす公式の手順は SGLang-Omni を使う。vLLM での起動方法は、確認できた情報には書かれていなかった。
git clone https://github.com/sgl-project/sglang-omni.git && cd sglang-omni
uv pip install --prerelease=allow -v -e ".[fishaudio]"
sgl-omni serve --model-path fishaudio/drama-3 --port 8000
起動すると、ポート 8000 で /v1/tts が待ち受ける。リクエストは text、references(audio_path と text の組のリスト)、任意で previous_takes を含む JSON を POST する。以下は多話者と演技指示を組み合わせた例である(パスやテキストは仮のもの)。
curl -X POST http://localhost:8000/v1/tts \
  -H "Content-Type: application/json" \
  -d '{
    "text": "<|speaker:0|>[whispering] 今日は大事なお知らせがあります。\n<|speaker:1|>[small laugh] えっ、なんですか?",
    "references": [
      {"audio_path": "/path/to/ref_a.wav", "text": "参照音声の書き起こし"}
    ]
  }' --output out.wav
ホストAPIを使う場合は、エンドポイントとヘッダーが変わるだけで、タグの書き方は同じだ。
curl -X POST https://api.fish.audio/v1/tts \
  -H "Authorization: Bearer $FISH_API_KEY" \
  -H "Content-Type: application/json" \
  -H "model: drama-3" \
  -d '{"text": "[sighs] やっと終わった。<emphasis>本当に</emphasis>長かった。"}' \
  --output out.mp3
書き方のコツを3点挙げる。
- 指示は短く、行頭に置く:まず [whispering] のような1語の指示から試し、効果を聴いて足していく
- 強調は範囲タグで:全体の指示を重ねるより、<emphasis> で必要な語だけ囲むほうが破綻しにくい
- 話者は番号で固定:同じ番号には同じ参照音声を対応させ、台本全体で声の一貫性を保つ
声の再現には参照音声と正確な書き起こしが必要だ。他人の声を使う場合は、前述のとおり本人の同意が必須になる。
既存TTSとの違い
主要な音声生成サービスとの位置づけを整理する。他社の項目は公開済みの性質(オープンか、自前運用できるか)に絞り、価格や性能の数字は載せていない。
| モデル | 公開形態 | 自前運用 | 特徴 |
|---|---|---|---|
| Fish Audio Drama 3 | オープンウェイト(Community License) | 可(48GB級GPUが目安) | 35B MoE、演技指示、最大16話者、83言語 |
| Fish S2 / S2.1 Pro | S2 は Research License、S2.1 Pro は API 提供 | S2 は可 | Drama 3 の前世代。発音ベンチは S2.1 Pro が88.1% |
| ElevenLabs Eleven v4 | クローズド | 不可(API のみ) | 発音ベンチで Drama 3 に次ぐと報じられている |
| Irodori-TTS-v4-Large | オープン | 可 | 3.29Bの日本語TTS。詳しくはこちらの記事 |
| xAI Grok TTS | クローズド | 不可(API のみ) | 詳しくはGrok TTSの記事 |
選び方の目安は単純だ。日本語の自然さを最優先し、軽く動かしたいなら日本語特化のオープンモデル、多話者の掛け合いや演技指示を重視し、サーバー用GPUを用意できるなら Drama 3、インフラを持たずに使いたいならAPIとなる。ローカルで手軽に音声合成を試す方向なら、VoiceStudio のような手段もある。
導入時の注意点
- 日本語品質は自分の耳で確認する:公式の高スコアは英語の発音テストの結果。日本語の読み・アクセント・演技指示への追従は別途検証が必要
- ハードウェアは余裕を見る:最小要件が未公表のため、48GB で動いても並列数や長文で詰まる可能性がある。実際に負荷をかけて確かめる
- ライセンスの線引きを先に決める:売上基準と「サービス提供」の条項を、導入前に社内で整理する
- 声の権利:クローンは本人の同意が前提。社員や取引先の声を使う場合も書面で残す
- 編集機能は期待しすぎない:インペインティングは招待制、編集APIは未提供
- 価格は期間限定:$10 / 100万文字は2026年11月12日まで。以降は定価 $50 を前提に試算する
- 新しいモデルである:発売直後は不具合や仕様変更が起こりやすい。本番投入は評価期間を置く
よくある質問
Fish Audio Drama 3 は商用利用できますか?
条件付きで可能です。Fish Audio Community License v1.0 では、あなたと関連会社の年間売上が US$500,000 未満なら商用利用も無料です。それ以上の場合、または Drama 3 を TTS・ボイスクローン・推論サービスや API として他者に提供する場合は、Fish Audio からライセンス(business@fish.audio)を得る必要があります。Hugging Face のライセンス表示が別名になっているため、LICENSE ファイルの全文を確認してください。
Drama 3 の必要スペックは? RTX 4090 で動きますか?
公式の最小要件は公開されておらず、公式ベンチマークはすべて NVIDIA H200 です。第三者ガイドは VRAM 48GB 以上の GPU 1枚(L40S、RTX 6000 Ada、A6000 48GB、H100、H200 など)を推奨しています。重みは FP8 主体で30GB台半ばと見積もれるため、24GB の RTX 4090 は想定外です。公式の量子化版(GGUF など)も発売時点ではありません。
Drama 3 は日本語に対応していますか?
83言語に対応すると発表されており、公式ブログには日本語の演技指示の例が示されています。ただし、確認できたページに公式の言語一覧はありません。発音ベンチマークの高スコアも英語での結果です。日本語で使う場合は、公式の言語一覧を確認したうえで、自社の文章で試聴して判断してください。
APIの料金はいくらですか?
定価は100万文字あたり $50 です。2026年10月13日から11月12日までは発売記念価格の $10 / 100万文字(80%オフ)になります。エンドポイントは https://api.fish.audio/v1/tts で、ヘッダーに model: drama-3 を指定します。アプリでは S2.1 Pro と同じクレジットを消費します。
まとめ
Fish Audio Drama 3 は、演技指示と最大16話者の掛け合いを1回の生成で扱える、35B MoE のオープンウェイトTTSである。英語の発音ベンチマークでは首位と報じられ、H200 では64並列でも RTF 0.801 を保つ。一方で、公式の最小要件はなく、自前運用は48GB級のサーバー用GPUが目安で、ローカルPC向けではない。ライセンスは年間売上 US$500,000 未満なら商用も無料だが、他者へのサービス提供は別契約になる。
導入の順序としては、まず発売記念価格の期間中にホストAPIで日本語の品質を試し、納得できたら自前運用のGPUとライセンスの線引きを検討するのが無駄がない。発売直後で情報は更新されやすいため、最新の条件は公式ドキュメントとモデルカードで確認してほしい。
お気軽にご相談ください
お問い合わせ