Raon-1 mini(KRAFTON)必要スペック早見表
総28.8B・活性4.3BのMoEは4bitで約20GB、24GB GPUに収まる【2026年版】
KRAFTONのRaon-1 mini previewは総28.8B・活性約4.3BのMoE。4bitの重みは約16〜20GBで24GBのGPUに収まる。量子化別のサイズ、動かし方、ベンチマーク、同クラスとの比較を整理。2026年10月更新。
Raon-1 mini preview は、4bit量子化なら重みが約16〜20GB、動かすのに必要なメモリは約18〜23GB前後で、24GBのGPU(RTX 3090・4090)に収まる。 総28.8B・活性約4.3BのMoEで、262,144トークンの全コンテキストを使う場合はKVキャッシュ分が加わり24GBでは余裕がなくなるが、短〜中程度のコンテキストなら24GBで足りる(必要メモリはファイルサイズと公式のKV情報からの推定)。
Raon-1 mini preview は、ゲーム会社KRAFTONのAI部門が2026年10月21日にHugging Faceで公開した、Apache 2.0のオープンウェイトモデルである。ゼロから学習され、独自の線形attentionを組み合わせている。名前のとおりpreview(試作版)で、仕様や結果は正式版までに変わり得ると公式が明記している。正式版は技術レポートとともに後日公開される予定だ(2026年10月時点)。
必要スペック早見表
| 精度(配布形式) | 重みのサイズ | 必要メモリの目安(推定) | 載せ方の例 |
|---|---|---|---|
| BF16(理論値) | 約57.6GB(28.8B×2バイト、推定) | 60GB超 | H100 80GB・A100 80GB |
| 公式リポジトリ(MXFP8、BF16・F8混在) | 32.7GB(実ファイル) | 約34〜38GB | 48GB級のGPU、32GBのGPUならCPUオフロード(公式の案内) |
| 8bit(Q8_0 GGUF) | 30.7GB(実ファイル) | 約33〜36GB | 48GB級のGPU・Mac、RTX 5090 32GBは短いコンテキストのみ |
| 6bit(Q6_K GGUF) | 25.8GB(実ファイル) | 約28〜31GB | RTX 5090 32GB、36GB以上のMac |
| 5bit(Q5_K_M GGUF) | 22.2GB(実ファイル) | 約24〜27GB | 32GBのGPU・Mac(24GBは厳しい) |
| 4bit(Q4_K_M GGUF) | 19.7GB(実ファイル) | 約21〜23GB | RTX 3090・4090 24GB(コンテキストは中程度まで)、32GBのMac |
| 4bit(NVFP4/MLX) | 17.6GB(実ファイル) | 約19〜22GB | RTX 5090 32GB(公式のvLLM構成)、24GB級GPU、Apple Silicon 32GB |
| 4bit(IQ4_XS GGUF) | 16.1GB(実ファイル) | 約18〜20GB | 24GBのGPU、16GBのGPUは一部をCPUへ |
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。Raon-1 miniもモデル一覧から選択できる。
「重みのサイズ」のBF16以外はHugging Face上の実ファイルの合計で、「必要メモリの目安」はそこにKVキャッシュと実行時の余裕を足した推定である。KRAFTONは、7層あるfull attention層のKVキャッシュを1トークンあたり約8KiB(BF16)としており、262,144トークンでも約2GiB(推定)にとどまる。線形attention層は状態が固定サイズのため、長いコンテキストでもメモリが増えにくい。3bit以下は公式のGGUFがなく、コミュニティ製のQ2K_Q4が1件あるが、サイズも品質も確認できていない。量子化の選び方はGGUF量子化の選び方も参照してほしい。
モデルの概要
| 項目 | 内容 |
|---|---|
| 提供元 | KRAFTON(韓国のゲーム会社)、2026年10月21日にpreviewを公開 |
| パラメータ数 | 総28.8B(Hugging Face表示は29B)/活性約4.3B |
| 構造 | MoE(ルーティング対象128エキスパートのうち6個+共有1個が活性)、25層 |
| アテンション | 線形attention(Raon Delta Attention)18層+full attention(Gated MLA)7層のハイブリッド |
| コンテキスト長 | 262,144トークン(ネイティブ) |
| 言語 | 韓国語が強く、英語は堅実とされる。モデルカードには日本語・中国語・スペイン語・フランス語・タイ語も列挙 |
| 機能 | 思考(thinking)モード内蔵、ツール呼び出し(Hermes Agent・Pi・OpenCode向けの設定例あり) |
| ライセンス | Apache 2.0(商用利用可。ホスト型APIは別規約) |
| リポジトリ | KRAFTON/Raon-1-mini-preview(量子化版は -gguf/-mlx/-nvfp4/-dflash2) |
| 公式配布の精度 | BF16・F32・F8_E4M3(Safetensors) |
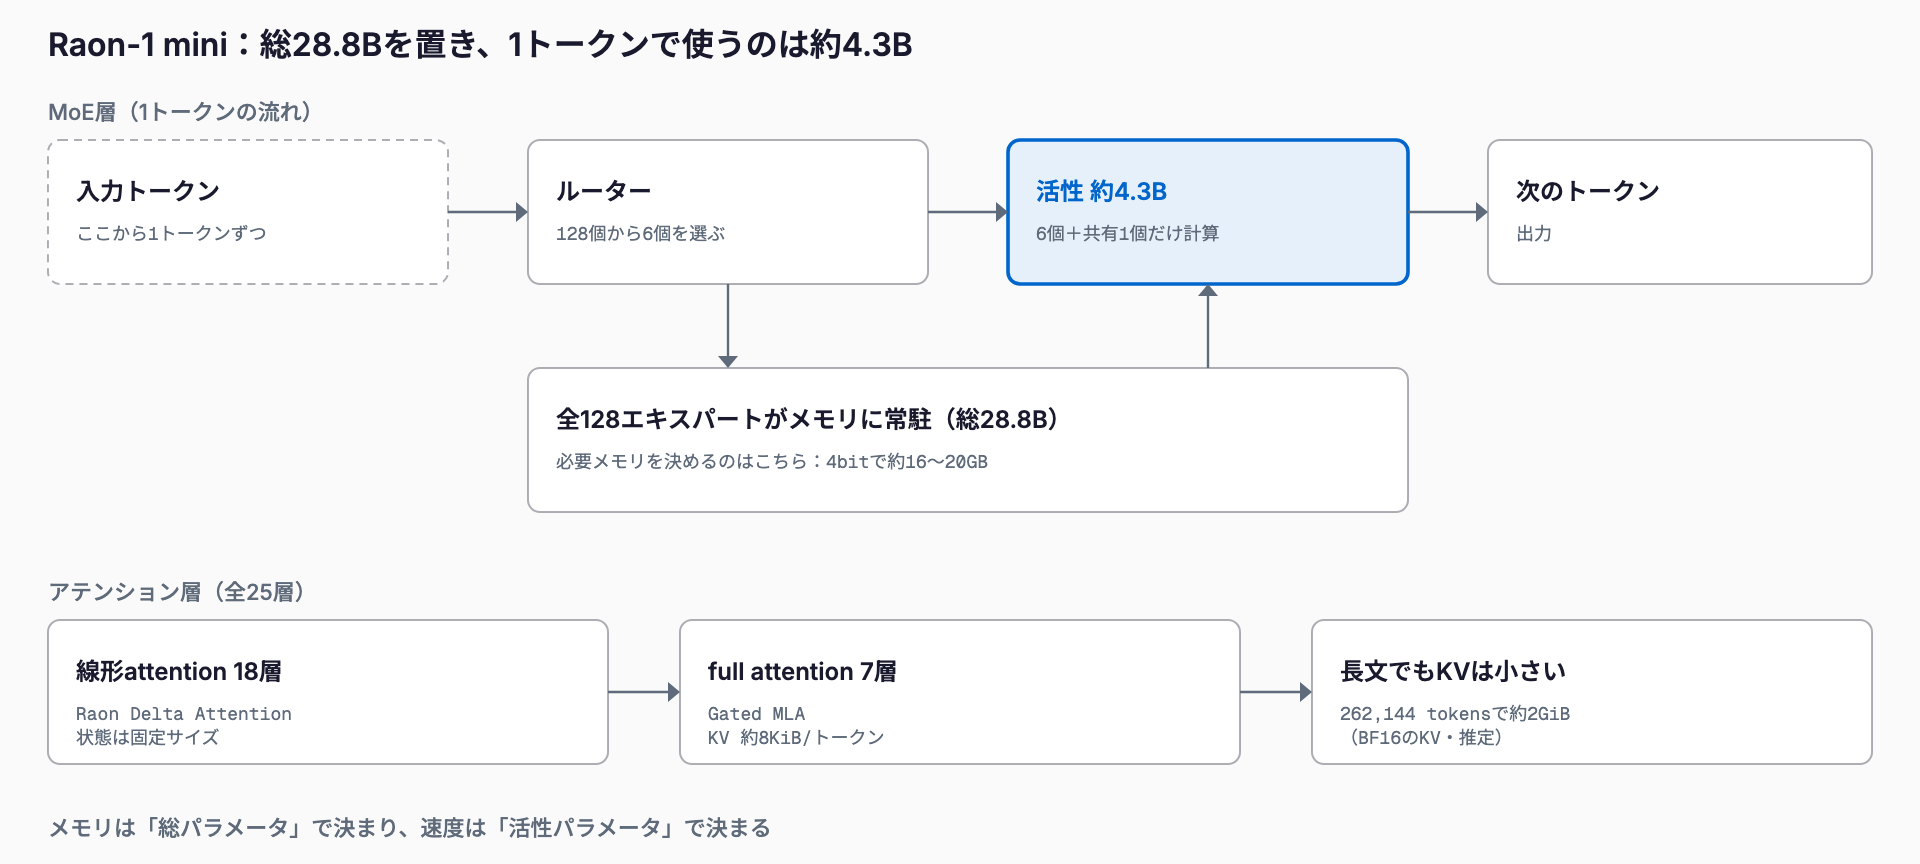
MoEなので、必要メモリを決めるのは活性の4.3Bではなく総パラメータの28.8Bである。活性パラメータは1トークンあたりの計算量(速度)に効くだけで、使われないエキスパートも全てメモリかRAMに置く必要がある。同じ考え方はGemma 4 必要スペックの記事でも説明している。
ベンチマーク
| ベンチマーク | Raon-1 mini | Qwen3.6-35B-A3B | Gemma 4 26B-A4B |
|---|---|---|---|
| MMLU Pro(知識) | 76.5 | 85.9 | 82.9 |
| GPQA Diamond(推論) | 84.3 | 83.2 | 80.7 |
| AIME 2026(数学) | 93.3 | 92.9 | 87.1 |
| IFBench(指示追従) | 84.2 | 66.6 | 80.9 |
| LiveCodeBench v6(コード) | 81.6 | 81.2 | 83.4 |
| SWE-Verified(コード修正) | 70.8 | 63.2 | 61.6 |
| Terminal-Bench Lite | 47.0 | 63.3 | 52.0 |
| BFCL v4(ツール呼び出し) | 59.8 | 64.7 | 65.8 |
| BrowseComp Plus(エージェント) | 55.7 | 34.8 | 32.2 |
| AA-LCR(長文) | 67.3 | 69.3 | 67.0 |
| Chatbot Korean(内部指標) | 92.9 | 74.5 | 90.6 |
数値は全てKRAFTONの公表値で、評価の判定にはgpt-5.6-lunaが使われている。独立した検証はまだ少ない。モデルカードの比較にはQwen3.8-27B(dense)とMuse Glimmer 30B(dense)も含まれ、MMLU Proは5モデル中で最も低い(Raon 76.5に対し、他は82.9〜85.9)。Terminal-Bench LiteやBFCL v4でも比較対象のMoEに負けており、全面的に勝っているわけではない。Chatbot Koreanは非公開の内部指標である点にも注意してほしい。なおモデルカードは、リポジトリへのアクセス申請(自動承認)を求める記載があるが、確認時点のAPI上では非ゲートと表示されていた。
日本語での実用性
日本語の実力は、確かめられる材料がほとんどない。KRAFTONの発表は韓国語と英語を主眼としており、モデルカードは日本語を対応言語に挙げているものの、日本語のベンチマークは示していない。知識系の指標(MMLU Pro)が比較モデルより低いことも踏まえると、日本語の事実関係を問う用途では自社データで試してから採用するのが安全である。韓国語・英語の業務や、ツール呼び出しを含むエージェント用途の方が、公表値の裏付けがある。日本語中心なら、まず同クラスで実績のあるモデルと並べて検証したい。
動かし方(vLLM・llama.cpp・Ollama等)
いずれも2026年10月時点で、vLLMとllama.cppはKRAFTONのフォーク版が必要である(本家への取り込みは待ち)。llama.cppはGGUF(-gguf)を使い、フォークをビルドして起動する。
git clone -b raon-1-mini-preview https://github.com/krafton-ai/llama.cpp
cd llama.cpp
cmake -B build -DGGML_CUDA=ON   # Apple siliconでは -DGGML_CUDA=ON を外す
cmake --build build --config Release -j

./build/bin/llama-server \
  -hf KRAFTON/Raon-1-mini-preview-gguf:Q4_K_M \
  --host 127.0.0.1 --port 8000 \
  --ctx-size 32768 \
  --temp 1.0 --top-p 0.95 --top-k 20 --presence-penalty 1.5 \
  --reasoning on
公式例は --ctx-size 262144 だが、24GBのGPUでは小さめ(上の32768など)から始めるのが無難である。vLLMはNVFP4版を使い、RTX 5090(32GB)では次の構成が公式に案内されている。インストールにはCUDA Toolkit 13(nvcc)が必要で、初回起動はカーネルのコンパイルに約10分かかる。
VLLM_USE_PRECOMPILED=1 uv pip install \
  "vllm @ git+https://github.com/krafton-ai/vllm.git@raon-1-mini-preview"

vllm serve KRAFTON/Raon-1-mini-preview-nvfp4 \
  --served-model-name Raon-1-mini-preview \
  --max-model-len 32768 --max-num-seqs 8 \
  --gpu-memory-utilization 0.85 --kv-cache-dtype fp8_e4m3 \
  --reasoning-parser raon_1 \
  --enable-auto-tool-choice --tool-call-parser raon_1
- Ollama:モデルカードに ollama run hf.co/KRAFTON/Raon-1-mini-preview-gguf:Q4_K_M が載っているが、本家llama.cppが未対応のため標準のOllamaで動くかは未確認。動かなければフォーク版llama.cppを使う
- LM Studio・Jan:カード上は対応をうたうが、設定の記載はなく未確認
- Apple Silicon(MLX):-mlx(NVFP4、17.6GB)を使い、公式の動作確認バージョンは mlx 0.32.4・mlx-lm 0.32.2・transformers 5.20.1
- Transformers:transformers 5.16.1・accelerate 1.15.0 固定で trust_remote_code=True が必要。32GBのGPUではMXFP8版+CPUオフロードを案内
- 推奨サンプリング:temperature 1.0・top_p 0.95・top_k 20。presence_penaltyは対話・エージェントで1.5、コードと数学で0。thinkingは無効化しない方がよいとされる
- 投機的デコード:DFlash2(-dflash2)で、B300上のvLLMで最大約2.18倍の出力速度と公表(環境依存)
同クラスのモデルとの比較
| モデル | 総/活性 | ライセンス | 4bitのメモリ目安(推定) |
|---|---|---|---|
| Raon-1 mini preview | 28.8B/約4.3B | Apache 2.0 | 実ファイル16.1〜19.7GB、必要約18〜23GB |
| Qwen3.6-35B-A3B | 約36B/約3B | Apache 2.0 | 重み約18GB、必要約20〜22GB |
| Gemma 4 26B-A4B(必要スペック) | 約25.8B/約4B | Apache 2.0(Hugging Faceの表示) | 重み約13GB、最小目安16GB |
| Holo4-35B-A3B | 約35B/約3B | Apache 2.0 | 重み約17.5GB、必要約20GB |
| Recursive Flint 40B-A2.5B | 39.8B/約2.5B | Apache 2.0 | 重み23〜26GB、必要24〜30GB前後 |
Raon-1 miniは、活性パラメータが約4.3Bと比較対象で最も大きく、メモリはFlintより小さく、Gemma 4 26B-A4Bよりやや大きい。GPQAやIFBench、SWE-Verifiedでは公表値で優位だが、知識系とツール呼び出しは弱い。同じApache 2.0同士なので、ライセンスより用途(韓国語、エージェント、日本語の知識Q&A)で選ぶことになる。
トラブルシューティング
- 標準のllama.cpp・Ollamaで読み込めない:独自アーキテクチャ(raon1_mini)の対応が本家に未反映のため。KRAFTONのフォーク(branch raon-1-mini-preview)をビルドする
- vLLMの初回起動が遅い:カーネルのコンパイルに約10分かかる。止まったと誤解しやすいのでログを待つ
- メモリ不足になる:コンテキスト長を262,144から32,768などに下げる、KVキャッシュをfp8にする、より小さい量子化(IQ4_XS)にする
- 回答が冗長・繰り返しが出る:presence_penaltyの設定を確認する。Transformersには標準のpresence_penaltyがなく、モデルのremote codeが処理する
- 推論過程が出力に混ざる/出ない:vLLMはmessage.reasoning、llama.cppはmessage.reasoning_contentに分かれて返る
- ダウンロードが拒否される:モデルカードにアクセス申請と hf auth login が必要とある(承認は自動)
- previewなので結果が変わる:重みや仕様が正式版で変わり得る。本番導入は正式版を待つか、差し替え前提で組む
よくある質問
Raon-1 miniは24GBのGPUで動きますか。
4bit(Q4_K_M 19.7GB、IQ4_XS 16.1GB)なら動く見込みである。ただし全262,144トークンのコンテキストを使うとKVキャッシュも加わり余裕がなくなるため、32,768〜128,000程度から始め、必要メモリは実機で確認してほしい(本記事の必要メモリは推定)。
総30Bなのに、なぜ活性は約4.3Bなのですか。
MoE(Mixture of Experts)構造で、1トークンごとにルーターが128個のエキスパートから6個(と共有1個)だけを選んで計算するためである。ただし未使用のエキスパートも含めて全重みをメモリに置く必要があるので、必要メモリは総パラメータ数で決まる。
商用利用できますか。
モデルの重みはApache 2.0で、商用利用が認められている。ただしKRAFTONのホスト型APIやプレイグラウンドは別の利用規約で、学習データや学習手法はライセンスの対象外とされている。
日本語で使えますか。
モデルカードは日本語を対応言語に挙げているが、日本語のベンチマークは公表されておらず、KRAFTONの発表は韓国語と英語が中心である。実用性は自社のデータで確認する必要がある。
Ollamaや普通のllama.cppで動かせますか。
2026年10月時点で、llama.cppは本家への対応が未反映で、KRAFTONのフォーク版のビルドが必要とされている。Ollamaの起動コマンドはモデルカードにあるが、標準版での動作は確認できていない。vLLMもKRAFTONのフォーク版を使う。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ