Reflection Beam 必要スペック早見表
501B MoE(FP8 約501GB / H100×8〜)【2026年版】
Reflection Beam(総パラメータ501B・アクティブ23BのMoE・Apache 2.0)の必要メモリは推定でFP8約501GB、4bit約250〜290GB。H100×8やMac 512GB、CPUオフロードでの可否と予算別の構成例を整理。2026年10月時点で重みは未公開のため推定値。
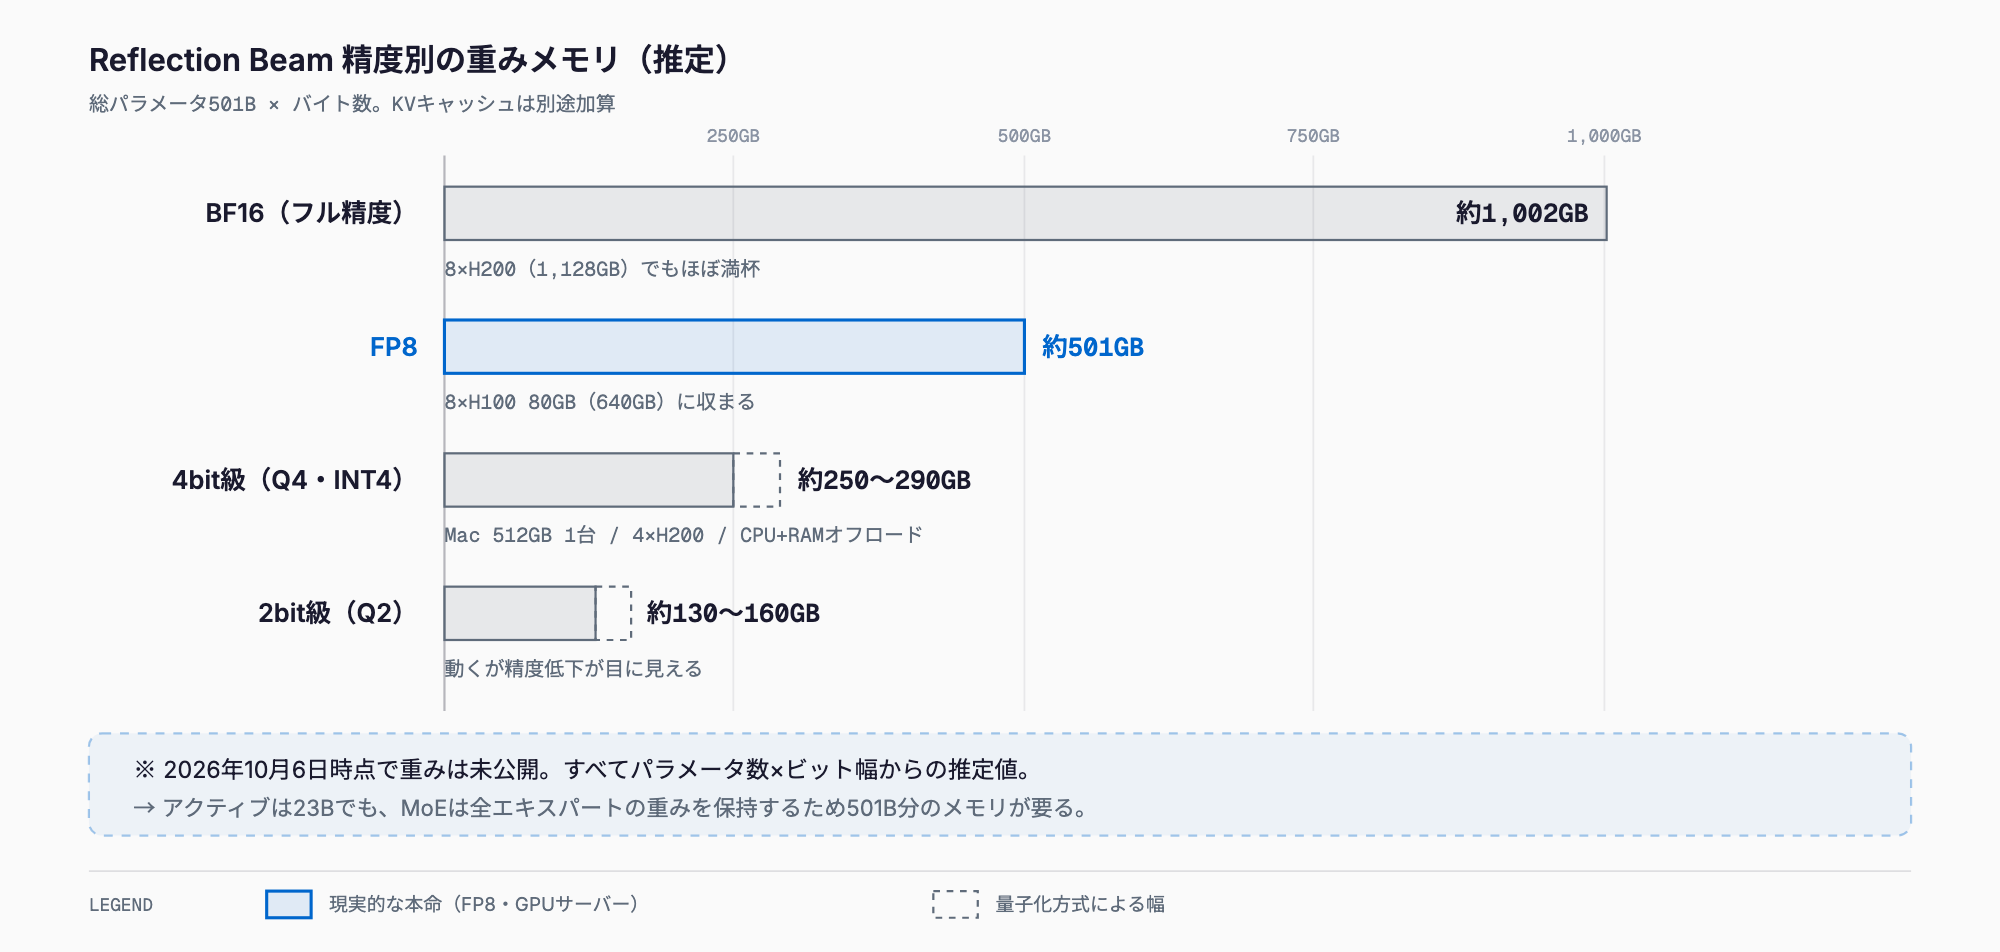
Reflection AIのBeamをローカルで動かす場合、重みだけでBF16は約1,002GB、FP8は約501GB、4bit級は約250〜290GB、2bit級は約130〜160GBが目安になる(すべて推定値)。総パラメータ501B・アクティブ23BのMoEで、ライセンスはApache 2.0。ただし2026年10月6日時点で重み・技術レポート・モデルカードはまだ公開されておらず、Hugging Faceのリポジトリ名や公式のVRAM値も出ていない。本稿は公式ブログの公開情報から計算した事前の見積もりであり、重み公開後に実測値へ更新する前提で読んでほしい。
Beamは2026年10月5日に発表された。公式ブログによれば最終のレッドチーミング中で、早期アクセスの申し込みを受け付けており、重み・技術レポート・モデルカードなどは「10月中に公開」とされている。数値の出どころを混同しないよう、本文では公式ブログに書かれた事実と当サイトによる推定値を明確に分けて記載する。
必要スペック早見表(推定)
計算式は「総パラメータ501B × 1パラメータあたりのバイト数」で重み容量を出し、そこにKVキャッシュ・アクティベーション等のオーバーヘッドを上乗せしたものだ。当サイトの他のrequirements記事と同様に、短いコンテキスト(8K前後)で約15%を上乗せして実運用の目安とした。Beamの層数・KVヘッド数などの内部構成は未公表のため、KVキャッシュは個別に計算できていない。
| 精度 | 重みのみ(推定) | 実運用の目安(推定・短コンテキスト) | 精度劣化の目安 |
|---|---|---|---|
| BF16(フル精度) | 約1,002GB | 約1,150GB | なし |
| FP8 | 約501GB | 約580GB | ほぼなし |
| 4bit級(Q4系・INT4) | 約250〜290GB | 約290〜330GB | 小さい(実用範囲) |
| 2bit級(Q2・1.58bit級) | 約130〜160GB | 約150〜185GB | 目に見えて低下 |
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。Reflection Beamもモデル一覧から選択できる(重み公開前のため推定値)。
4bit級に幅があるのは、ブロックごとのスケール係数などのメタデータが上乗せされ、量子化方式によって実効ビット数が4.0〜4.6bit程度に変わるためだ。2bit級も同様に方式で差が出る。1Mトークンまでコンテキストを伸ばす場合は、この表にKVキャッシュが大きく加算される。KVキャッシュはコンテキスト長にほぼ比例して増えるため、長文を使うほど必要メモリは表の数字から離れていく。仕組みの詳細はKVキャッシュとコンテキスト長のVRAM解説で整理している。
Reflection Beamとは — 公式ブログで確認できる事実
Beamは米Reflection AIが発表したオープンウェイト予定の大規模言語モデルで、総パラメータ501B、トークンあたりのアクティブパラメータ23Bのスパース(疎)MoEだ。細粒度のルーテッドエキスパートと、ローカル注意とグローバル注意を交互に配置する構成を採用している。コンテキスト長は、RL学習時の256Kからミッドトレーニングで1Mトークンまで拡張されたと説明されている。
| 項目 | 内容 | 出典・状態 |
|---|---|---|
| 総パラメータ | 501B | 公式ブログ |
| アクティブパラメータ | 23B | 公式ブログ |
| 構成 | スパースMoE(細粒度ルーテッドエキスパート、ローカル/グローバル注意の交互配置) | 公式ブログ |
| コンテキスト長 | 1Mトークン(RL学習時は256K) | 公式ブログ |
| ライセンス | Apache 2.0 | 公式ブログ |
| 事前学習 | 23.8Tトークン、NVIDIA GB300を6,144基使用し4週間未満 | 公式ブログ |
| 強化学習 | NVIDIA GB300を約10.5K基使用 | 公式ブログ |
| 重み・技術レポート・モデルカード | 2026年10月中に公開予定 | 未公開 |
| Hugging Faceリポジトリ名 | 未公表(公開時に追記予定) | 未公表 |
| API料金 | 未公表(公開時に追記予定) | 未公表 |
| 公式のVRAM値 | 未公表(公開時に追記予定) | 未公表 |
| 対応推論フレームワーク | 未公表(公開時に追記予定) | 未公表 |
ブログには「GLM-5.2と比べて推論時の計算量が3〜4分の1で済む」という趣旨の主張もある。これは推論(reasoning)タスクでの開発元の主張であり、第三者による検証は確認できていない。なお、これが効くのは主に生成時の計算量であって、必要メモリを減らすわけではない点は次章で説明する。
ベンチマーク(すべて開発元の自己申告値)
以下は公式ブログに掲載された数値で、開発元による自己申告であり、独立した第三者検証は確認できていない。重み公開後に追試が出れば、順位や差は変わりうる。
| ベンチマーク | スコア | 領域 |
|---|---|---|
| AIME 2026 | 97.8 | 数学・推論 |
| GPQA Diamond | 90.5 | 大学院レベルの科学QA |
| SWE-bench Verified | 80.9 | ソフトウェアエンジニアリング |
| Terminal-Bench v2.1 | 80.1 | ターミナル操作・エージェント |
| DeepSearchQA | 80.1 | 調査・検索型QA |
なぜ「総パラメータ501B」でメモリを見積もるのか
MoEは1トークンの計算に一部のエキスパートしか使わないが、次にどのエキスパートが選ばれるかは入力で変わる。そのため原則として全エキスパートの重みをメモリ上に置く必要があり、必要容量は総パラメータ数(501B)で決まる。アクティブ23Bが効くのは速度の側だ。1トークンあたりに読み出す重みは、4bit級なら理論上おおむね12GB前後(23B × 0.5byte)に収まるため、メモリ帯域が足りる環境では密な501Bモデルよりはるかに速く動く。この性質が、後述するCPU+大容量RAMへのエキスパートオフロードを現実的な選択肢にする。
量子化とは — 何bitを選ぶべきか
量子化は、重みを表すビット数を減らしてメモリを圧縮する技術だ。BF16(16bit)を8bitにすれば半分、4bitにすれば約4分の1になる。代わりに計算精度は下がるが、8bitはほぼ無損失、4bit級は多くの用途で実用範囲とされる。2bit級や1.58bit級まで落とすと出力品質が目に見えて下がるため、動作確認や軽い用途向けと考えたほうがよい。MoEは小さなエキスパートが多数あるため、量子化の影響の出方がモデルごとに異なる。Beamについては実際の量子化版が出るまで品質は判断できない。
方針としては、品質を優先できるならFP8、ローカル実行の現実解は4bit級、メモリが足りないときの最後の手段が2bit級、という順になる。BF16は重みだけで約1,002GBあり、学習や研究目的でない限り選ぶ理由は薄い。
GPU構成別の目安(推定)
下表は「重みが載るか」を基準にした事前の見積もりで、KVキャッシュとオーバーヘッドを含めた余裕度を併記した。実際に動くかどうかは、使うフレームワークの並列化方式(テンソル並列・エキスパート並列)とコンテキスト長で変わる。
| GPU構成 | 合計VRAM | BF16 | FP8 | 4bit級 | 2bit級 |
|---|---|---|---|---|---|
| H100 80GB × 4 | 320GB | 不可 | 不可 | ぎりぎり(短コンテキストのみ) | 余裕あり |
| H100 80GB × 8 | 640GB | 不可 | 載るが余裕は小さい(長文は厳しい) | 余裕あり | 余裕あり |
| H200 141GB × 4 | 564GB | 不可 | 重みのみぎりぎり | 余裕あり | 余裕あり |
| H200 141GB × 8 | 1,128GB | 重みは載るが余裕ほぼなし | 余裕あり(長文も視野) | 余裕あり(長文向き) | 過剰 |
| B200 192GB × 8 | 1,536GB | 余裕あり | 余裕あり | 過剰 | 過剰 |
推奨の目安は次のとおりだ。FP8を快適に動かすならH200×8、コストを抑えるならH100×8でFP8(コンテキストは控えめに)、4bit級ならH200×4またはH100×8で余裕が出る。BF16をH200×8に載せるのは重みが約1,002GBで総量1,128GBに対して残りが約126GBしかなく、KVキャッシュを積むとほぼ余裕がない。
Apple Siliconで動かす場合
Apple Siliconは統合メモリをGPUからも使えるため、大型MoEを手元で動かす現実的な選択肢になる。512GB統合メモリ構成(M3 Ultra搭載のMac Studioなど)であれば、4bit級の重み約250〜290GBは載る。ただしOS・アプリ分とKVキャッシュを引くと、4bit級でもコンテキストを長くすると余裕は小さい。3bit級や2bit級まで落とせば余裕は広がるが、品質とのトレードオフになる。
FP8の約501GBは512GB機では載らない。2台のMacをクラスタ化して合計メモリを増やす構成は研究事例があるものの、安定運用のハードルは高い。なお、Apple Silicon向けの実行基盤(llama.cppのMetal、MLX等)がBeamのアーキテクチャに対応するかは未確認で、対応は重み公開後に確認が必要だ。同規模の別モデルでの考え方はGLM-5.2の必要スペック記事も参考になる。
CPU+大容量RAMでのMoEオフロード
アクティブ23Bという小ささを活かし、エキスパートの重みを大容量のシステムRAMに置き、GPUには注意層や共有部分だけを載せる構成が考えられる。384〜512GBのDDR5を積んだサーバーがあれば、4bit級の重み約250〜290GBはRAMに収まる。ここにGPU 1〜2枚を足すと、頻繁に使う層をGPU側に置けて速度が改善する。
速度の見当はメモリ帯域で付けられる。4bit級で1トークンあたり約12GBを読むなら、帯域が約300GB/s前後のサーバーでは理論上の上限が数十トークン/秒になる。実際にはオフロードの転送や並列化の効率で、この数分の一にとどまるのが普通だ(これも推定)。会話用途なら成立するが、大量処理や長いエージェントループには向かない。デスクトップ向けのRAM(128〜256GB程度)では4bit級の重みが収まらないため、2bit級でもぎりぎりという水準になる。
予算別の構成例(推定)
| 予算感 | 構成例 | 現実的な精度 | 向いている用途 |
|---|---|---|---|
| 数十万〜100万円台 | 384〜512GB DDR5サーバー+GPU 1枚(CPUオフロード) | 4bit級(遅い) | 個人の検証・低頻度の利用 |
| 数百万円 | Mac Studio 512GBクラス | 3〜4bit級(コンテキスト短め) | 開発者の手元検証 |
| 数千万円 | H100 80GB × 8 | FP8(短〜中コンテキスト)/4bit級 | 部署単位の自前運用 |
| 数千万円〜 | H200 141GB × 8 | FP8(長文も視野) | 本格運用・長コンテキスト |
| 従量課金 | クラウドGPUを時間借り | 任意 | 短期評価(総コストはAPIと比較) |
金額は構成によって大きく変わるため目安にとどめる。継続的に使うのでなければ、まずはクラウドGPUの時間課金か、公開されればAPI利用で評価するほうが投資判断を誤りにくい。Beam公式のAPI料金は未公表(公開時に追記予定)だ。
他の大型オープンMoEとの比較
当サイトの既存記事で確認できる数値と並べる。アクティブパラメータに対する総パラメータの比が小さいほど、メモリは大きいのに1トークンの計算は軽い、というMoEらしい性格になる。
| モデル | 総パラメータ | アクティブ | コンテキスト長 | ライセンス | 4bit時のメモリ目安 |
|---|---|---|---|---|---|
| Reflection Beam | 501B | 23B | 1M | Apache 2.0 | 約250〜290GB(推定・重みのみ) |
| GLM-5.2 | 753B | 約40B | 1M | MIT | 約430GB |
| DeepSeek V4-Pro | 1.6T | 49B | 1M | MIT | 約920GB |
| DeepSeek V4-Flash | 284B | 13B | 1M | MIT | 約160GB |
| K-EXAONE 2.0 | 750B | 37B | 262,144 | Apache 2.0 | 約375〜420GB |
| Atria Dawn Preview | 744B | 公式未公表 | 256K | MIT | 約400GB(推定) |
Beamは総パラメータがGLM-5.2やK-EXAONE 2.0より小さく、アクティブも23Bと軽い。同じ4bit級で比べると必要メモリは約3分の2程度に収まる計算だ。一方でDeepSeek V4-Flash(284B)よりは大きく、個人のPCで気軽に動かせる規模ではない。ベンチマークの優劣は各社の自己申告に基づくため、この表では比較していない。
今すぐできること(weights公開前)
- 公式ブログを読み、早期アクセスの申し込み状況を確認する(API提供や条件は未公表)
- 重み公開に備えて、保存先のディスク空き容量を確保する(FP8で約501GB、4bit級で約250〜290GB、BF16で約1,002GB)
- 手元の構成が4bit級に届くか、上の表で事前に当たりを付ける
- 同規模の既存モデルで推論環境(vLLM、SGLang、llama.cpp等)の動作を先に検証しておく
- 長いコンテキストを使う予定なら、KVキャッシュ分の余裕を別枠で見積もる
- 公開後に確認する項目をメモしておく(リポジトリ名、公式量子化版の有無、対応フレームワーク、最小構成)
公開されたHugging Faceのリポジトリ名・API料金・対応フレームワーク・公式のVRAM値は、いずれも未公表(公開時に追記予定)だ。重みが出た時点で、本稿の推定値を実測値に置き換える。
トラブルシューティング(メモリ不足・OOM)
- 起動時にOOMになる: 重みが載っていない。精度を一段下げる(FP8→4bit級)か、GPU枚数を増やす
- 途中からOOMになる: KVキャッシュが原因の可能性が高い。コンテキスト長の上限を下げる、同時リクエスト数を減らす、KVキャッシュの量子化を検討する
- 長文だけ落ちる: 1Mトークンを使う設定は大量のKVキャッシュを要する。まず32K〜128Kで動作を確認する
- オフロード構成が遅い: メモリ帯域が律速。DDR5のチャネル数を確認し、エキスパート配置とGPUに載せる層の割り当てを見直す
- GPUは空いているのに載らない: 並列化方式の制約で、均等分割できない枚数だと使い切れないことがある。枚数と並列設定を確認する
- 品質が極端に悪い: 2bit級は劣化が大きい。3bit以上を試す
まとめ
Reflection Beamは総パラメータ501B・アクティブ23BのApache 2.0 MoEで、ローカル実行の目安は4bit級で約250〜290GB、FP8で約501GB、BF16で約1,002GB(いずれも重みのみの推定値)だ。FP8を快適に動かすならH200×8、4bit級ならH200×4やH100×8、512GBのMacや大容量RAMサーバーなら4bit級以下が射程に入る。アクティブ23Bの軽さはMoEオフロードの現実性を高めるが、必要メモリ自体は総パラメータで決まる。重み・技術レポートの公開後に、実測値で本稿を更新する。大型MoEの比較はGLM-5.2、DeepSeek V4、Atria Dawn Previewの各記事も参照してほしい。
FAQ
Reflection Beamを動かすのに必要なVRAMはどれくらいですか。
総パラメータ501Bからの推定で、重みだけならBF16が約1,002GB、FP8が約501GB、4bit級が約250〜290GB、2bit級が約130〜160GBです。ここにKVキャッシュとオーバーヘッドが加わり、1Mトークンの長いコンテキストではさらに増えます。公式のVRAM値は未公表で、重み公開後に追記予定です。
Beamの重みはもう公開されていますか。
2026年10月6日時点では未公開です。公式ブログによれば最終のレッドチーミング中で、重み・技術レポート・モデルカードは10月中に公開予定とされています。Hugging Faceのリポジトリ名も未公表です。
アクティブ23Bなら、23B相当のVRAMで動きますか。
動きません。MoEは次にどのエキスパートが選ばれるか分からないため、原則として全エキスパートの重みをメモリに置く必要があります。必要容量は総パラメータ501Bで決まり、アクティブ23Bは主に生成速度に効きます。ただしエキスパートをCPU側RAMに置くオフロード構成なら、VRAMを小さくして動かせる可能性があります。
Mac Studio(512GB)でBeamは動きますか。
4bit級の重み約250〜290GBは載る見込みですが、OSとKVキャッシュの分を引くと余裕は小さく、長いコンテキストは厳しくなります。FP8(約501GB)は載りません。ただしBeamのアーキテクチャにllama.cppやMLXが対応するかは未確認で、重み公開後の確認が必要です。
BeamはGLM-5.2より軽く動かせますか。
重みのメモリは軽くなる計算です。GLM-5.2(753B)の4bit目安が約430GBなのに対し、Beamは約250〜290GB(推定)です。また公式ブログは推論タスクで計算量が3〜4分の1と主張していますが、これは開発元の主張で、独立した検証は確認できていません。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ