DeepSeek V4.1 Flash 必要スペック早見表
重み約510GB・4bit級で約430GB、H200×8かMac 512GB級【1017版・2026年版】
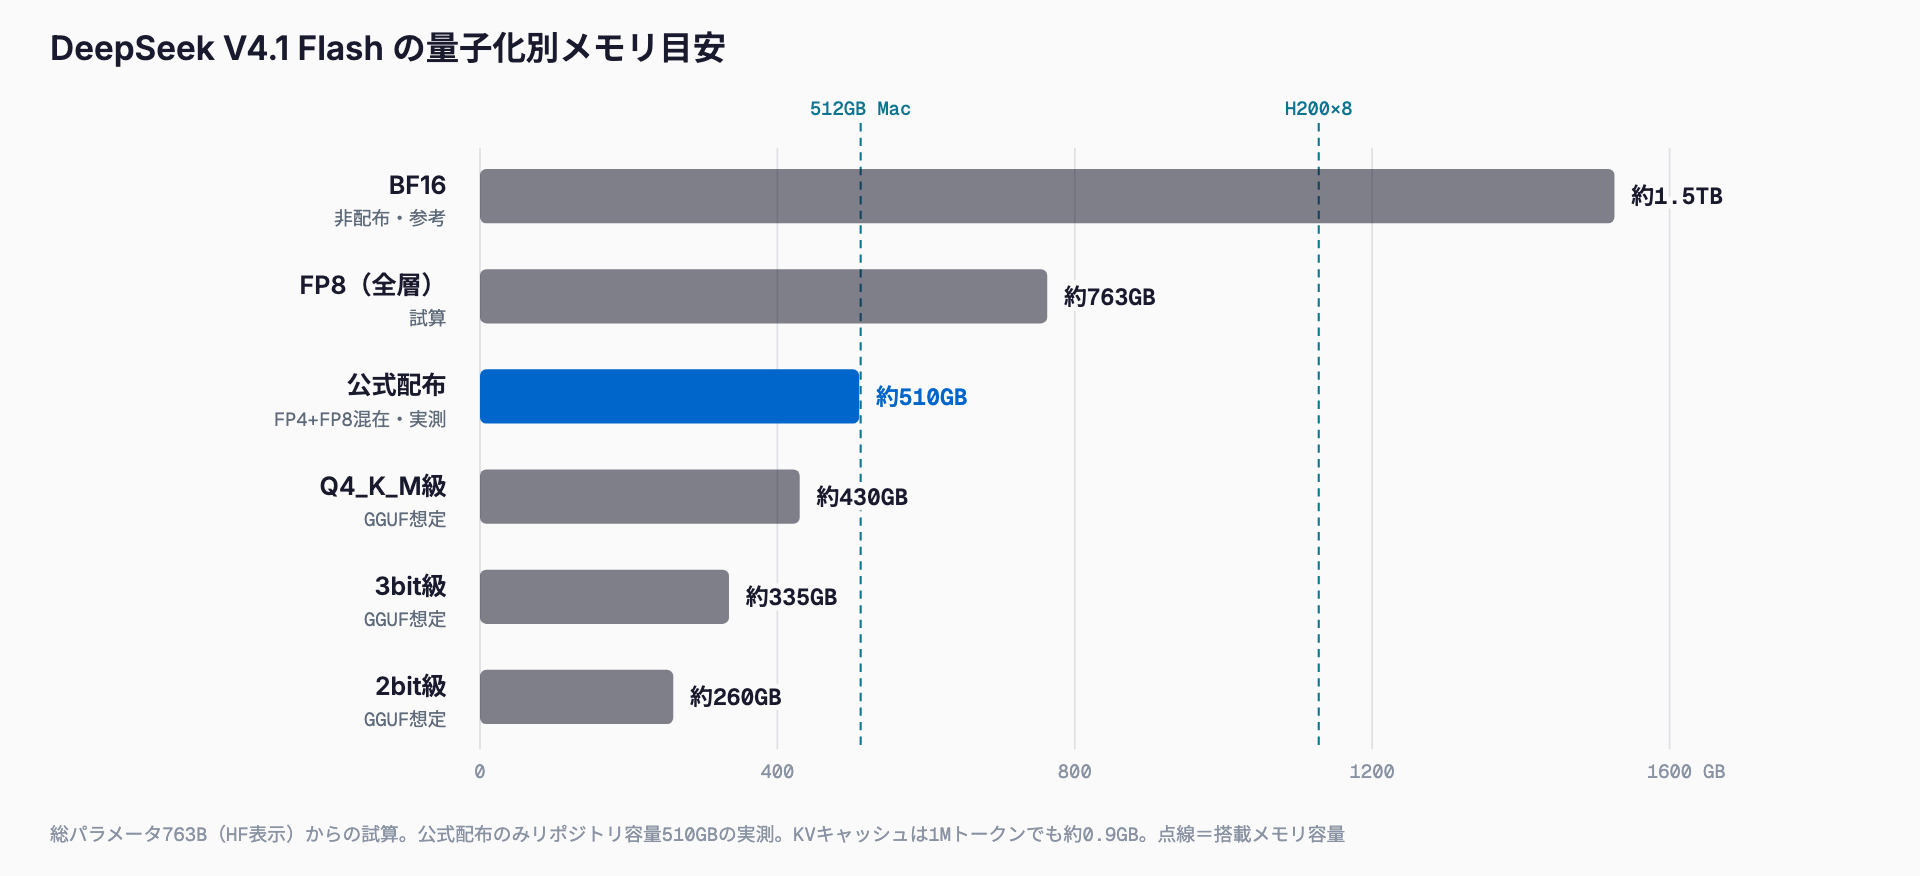
DeepSeek V4.1 Flash(1017版)の必要スペックは、公式配布の重みで約510GB、4bit級で約430GB。H200×8か512GB級のMacが前提。総パラメータ763B/552Bの食い違いの理由、量子化別メモリ、KVキャッシュ約0.9GB、9/10版からの変更点、API料金まで解説する。
DeepSeek V4.1 Flash(最新チェックポイント V4.1-Flash-1017、2026年10月17日公開)をローカルで動かすために必要なメモリは、公式配布の重みそのままで約510GB、一般的な4bit級の再量子化で約430GBが目安である。24GB程度のGPUを1枚積んだ個人PCでは動かせず、H200×8のようなサーバー、または512GB級のユニファイドメモリを持つMacが前提になる。総パラメータ数はHugging Faceの表示で763B、論文・モデルカード本文のバックボーンは552Bと食い違っており、本稿はメモリ見積もりの基準に763Bと実測の510GBを使う。ローカルにこだわらないなら、公式APIの料金は100万トークンあたり出力$1.20(ピーク時)と安価で、現実的な選択肢になる。
必要スペック早見表
| 精度/量子化 | 重みのメモリ目安 | 推奨環境(試算) |
|---|---|---|
| BF16(参考・非配布) | 約1.5TB | H200×12以上。現実的でない |
| FP8(全層・試算) | 約763GB | H200×8(1,128GB)、B200×6以上 |
| 公式配布(FP4+FP8混在) | 約510GB(リポジトリ実測) | H200×8、H100 80GB×8(640GB)、B200×4(720GB) |
| Q4_K_M級(約4.5bit) | 約430GB | H200×4(564GB)、512GB級のMac |
| 3bit級 | 約335GB | 512GB級のMac、RTX PRO 6000(96GB)×4 |
| 2bit級 | 約260GB | 384GB級のMac、RTX PRO 6000×4 |
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。DeepSeek V4.1 Flashもモデル一覧から選択できる。
上の表のうち、公式配布の約510GBだけがHugging Faceのリポジトリ表示に基づく値で、残りは763Bのパラメータ数から一般的な量子化サイズ(FP8=1バイト、Q4_K_M級≒4.5bit、3bit級≒3.5bit、2bit級≒2.7bit)で当サイトが算出した推定値である。公式モデルカードにGPU構成や必要メモリの記載はない。実際の使用量は推論エンジン・量子化の種類・同時リクエスト数で変わる。KVキャッシュは後述のとおり極めて小さいが、実行時のバッファに数GB〜十数GBの余裕は見ておきたい。量子化形式の選び方はGGUF量子化ガイド(Q4・Q5・Q8の選び方)で整理している。
パラメータ数が763B・552B・748Bと食い違う理由
同じモデルでも資料によって総パラメータ数が異なる。確認できた事実は次のとおりである。
| 数値 | 出どころ | 内容 |
|---|---|---|
| 763B | Hugging Faceのモデルページ(Safetensorsメタデータ) | 重みファイル全体のテンソル数の合計 |
| 552B | モデルカード本文・論文(arXiv 2609.19969) | バックボーン(MoE本体)のパラメータ数 |
| 196B | モデルカード本文 | Engram条件付きメモリ。バックボーンとは別勘定 |
| 748B | 552B+196Bの単純和 | 一部の報道が使う合計値 |
552Bと196Bを足すと748Bで、Hugging Faceが示す763Bとは約15Bの差が残る。この差についてモデルカードに説明はない。config.jsonにはビジョンエンコーダ(32層)、3層のNext-Token Prediction層、投機的デコード用のdsparkヘッドなどが記載されており、これらが差分を構成している可能性はあるが、公式の説明ではなく当サイトの推測である。メモリ見積もりの観点では、実際にダウンロードされるファイルを数える763B側を基準にするのが安全だ。Engramの196Bは疎にアクセスされるとモデルカードに書かれているが、ローカル環境でSSDやCPUメモリへ逃がせるかどうかは公式に示されていない。
DeepSeek V4.1 Flashとは — 重みと速度の関係
V4.1 Flashは、DeepSeekが2026年9月10日に発表したオープンウェイトのMoEモデルである。詳しい紹介はV4.1-Flash最速解説に譲り、ここでは必要スペックに関わる点に絞る。
- 活性パラメータ: prefill時に約8B、decode時に約16B。メモリには全重みが必要だが、1トークンあたりの計算量は小さい
- 層構成: 40層(20層のエンコーダ+20層のデコーダ)。config.jsonでは隠れ層5,120、アテンション64ヘッド、KVヘッドは1
- MoE: 共有エキスパート1+ルーティング対象384、トークンごとに6つを選択
- 重みの精度: Safetensorsの型はBF16・F32・F8_E4M3・I8の混在。configではFP8(32×32ブロック)が基本で、エキスパートはFP4
- コンテキスト: 最大1,048,576トークン(1M)。APIの最大出力は384K、モデルカードの推奨max_tokensは256K以上
- ライセンス: MIT(コード・重みとも)
- 推奨サンプリング: temperature 1.0、top_p 1.0
リポジトリの総容量は510GBで、763Bで割ると1パラメータあたり平均約5.3bit。FP4のエキスパートとFP8のそれ以外が混在している構成と整合する。つまり公式配布の時点で、すでに「約4〜5bit」に近い圧縮がかかっている。一般的なQ4_K_M級に再量子化しても約430GBで、削減幅は2割弱にとどまる点に注意したい。本格的に容量を落とすには3bit以下が必要で、その分品質は下がる。
KVキャッシュは1Mトークンでも約0.9GB
ローカル運用で重みの次に効くのがKVキャッシュだが、V4.1 Flashはここが異例に小さい。論文によると、常にHBMに置くグローバルKVキャッシュは1トークンあたり約890バイトで、前世代V4-Flashの約4分の1である。単純計算で890バイト×100万トークン≒約0.9GBに収まる。さらにSSDやホストメモリに置く永続側のキャッシュも、SWA Bounded Replayという手法でV4-Flashの約8分の1になる。長いコンテキストの追加メモリをほぼ無視できる点は、重みが巨大なこのモデルの数少ない運用上の利点である。ただし論文値は理論上のキャッシュ表現で、推論エンジンの実装やバッチ数が増えた場合の実使用量は別に確認が必要だ。
1017版(V4.1-Flash-1017)での変更点
V4.1-Flash-1017は、9月10日公開のV4.1 Flashに対するマイナーアップデートで、アーキテクチャ・総パラメータ・ライセンス・API単価は変わっていない。変更は事後学習の改善で、モデルカードは推論・コーディング・エージェント・視覚ベンチマークの向上と、タスク実行時間・出力長の短縮(結果としてコスト低下)を挙げている。DeepSeek Harness、Tencent CodeBuddy、WorkBuddy向けに調整されており、DeepSeek Harnessは0.2.1-rc.1以降が推奨されている。APIのモデル名は引き続きdeepseek-flashで、公式のWebとアプリも同時に更新された。したがって、必要メモリの数値は9月10日版と同じ前提でそのまま使える。
| ベンチマーク | 1017版 | 9/10版 | 差分 |
|---|---|---|---|
| HLE(ツールなし) | 42.6 | 36.8 | +5.8 |
| Terminal-Bench 4.0 | 42.3 | 31.2 | +11.1 |
| DeepSWE v1.1 | 77.0 | 74.2 | +2.8 |
| ProgramBench | 29.1 | 20.3 | +8.8 |
| NL2Repo-Bench | 68.2 | 65.4 | +2.8 |
| Automation-Bench v1.0.6 | 60.5 | 54.8 | +5.7 |
| Agents' Last Exam | 35.4 | 31.8 | +3.6 |
| Apex Bench v1.1 | 72.1 | 64.6 | +7.5 |
| Chartography(ツールあり) | 83.0 | 78.9 | +4.1 |
| BabyVision(ツールあり) | 92.5 | 89.6 | +2.9 |
| ZeroBench-main(ツールあり) | 51.0 | 49.0 | +2.0 |
数値はいずれも公式が公表した値で、第三者による再現は確認していない。モデルカードは他社モデルとの比較も載せており、たとえばTerminal-Bench 4.0ではGPT-5.6 Solが39.9、Opus 5が51.8、DeepSWE v1.1ではGPT-5.6 Solが73.0、Opus 5が74.0とされる。コーディングの一部ではクローズドモデルに並ぶか上回る一方、HLEのような知識・推論ではOpus 5(56.3)が大きく上回る。用途によって優劣が分かれるため、導入前に自社タスクで比べたい。
V4-Flash・V4-Proとの比較
| 項目 | V4-Flash(284B-A13B) | V4.1-Flash(1017) | V4-Pro |
|---|---|---|---|
| 総パラメータ | 284B | 763B(HF表示)/ 552B(バックボーン) | 1.6T |
| 活性パラメータ | 約13B | prefill 約8B / decode 約16B | 約49B |
| 重みの目安(4bit級) | 約160GB | 約430GB | 約920GB |
| コンテキスト | 1M | 1M | 1M |
| KVキャッシュ | 基準 | 約1/4(890バイト/token) | — |
| マルチモーダル | 別途Vision-Exp版 | 標準で画像入力対応 | — |
| ライセンス | MIT | MIT | MIT |
V4-Flashは4bitで約160GBに収まり、512GB未満のMacやマルチGPUワークステーションでも現実味があった。V4.1 Flashは重みが2.5倍以上に膨らんだため、ローカル実行のハードルは明確に上がった。代わりに画像入力が標準になり、エージェント系ベンチマークでは大きく伸びている。V4-Flashの必要スペックはDeepSeek V4 必要スペック早見表、V4-Proの運用はV4-Pro 0813 GA、ビジョン実験版はV4-Flash ビジョン対応にある。
予算別の推奨構成
| 選択肢 | 構成の例 | 目安・注意 |
|---|---|---|
| APIで使う | 公式API(deepseek-flash) | 初期投資ゼロ。下記の料金参照。最も現実的 |
| クラウドGPUを借りる | H200×8、またはH100 80GB×8のノード | 公式配布510GBがそのまま載る。時間課金のため検証向き |
| 自社サーバー | H200×4(564GB)に4bit級、H200×8に公式配布 | 4bit級でも余裕は約130GB。同時利用が多いならH200×8 |
| Mac Studio(512GB級) | 3bit級〜Q4級 | 動かせる容量はあるが、後述のとおりランタイム未対応の報告がある |
| ワークステーションGPU | RTX PRO 6000(96GB)×4=384GB | 2〜3bit級の範囲。品質低下と引き換え |
| 一般向けGPU(24〜32GB) | RTX 4090・5090など | 単体・少数枚では不可。重みの置き場が足りない |
上の構成はすべて重みの容量だけからの見積もりで、実機検証値ではない。MoEは活性パラメータが小さい分、重みをCPUメモリやSSDに逃がしても動くことがあるが、その場合の速度は大きく落ちる。報告された極端な例として、16GBのM1 Mac mini上でSSDからの重みストリーミングにより動かした実験があり、速度は1トークンあたり約22.8秒だったという(第三者ブログの報告。実用速度ではない)。
動かし方 — vLLM・SGLang・Transformers
モデルカードに記載のあるコマンドは次のとおりである。いずれも公式に推奨GPU構成の記載はないため、--tensor-parallel-sizeなどはGPU台数に合わせて調整する必要がある。
# vLLM
pip install vllm
vllm serve "deepseek-ai/DeepSeek-V4.1-Flash-1017"

# SGLang
pip install sglang
python3 -m sglang.launch_server --model-path "deepseek-ai/DeepSeek-V4.1-Flash-1017" --host 0.0.0.0 --port 30000

# Docker Model Runner
docker model run hf.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
- チャットテンプレート: Jinjaテンプレートは同梱されず、リポジトリのencodingフォルダにPythonの参照実装(encoding.py)がある。本番用にはRustライブラリのdeepseek-recipeが案内されている
- Transformers: AutoModelForCausalLM.from_pretrained(..., device_map="auto")で読み込めるが、510GB規模のため実運用には向かない
- llama.cpp・Ollama・LM Studio・MLX: モデルカードは量子化版の存在に触れているが、2026年10月19日時点で当サイトが実際に使える重みファイルを確認できたものはない。9月下旬の第三者分析では、これらのランタイムがエンコーダ・デコーダ構成に未対応とされていた。有志のGGUFやMLX版のサイズは確認できていないため、本稿の3bit級以下の数値は理論値として読んでほしい
ローカルが難しい人向け — API料金での代替
公式APIのモデル名はdeepseek-flash(V4.1-Flash-1017)で、コンテキスト1M、最大出力384K、思考モードと非思考モードの両方、画像入力に対応する。同時実行上限は2,500である。料金は100万トークンあたり次のとおり。ピーク時間はUTCの平日01:00〜04:00と06:00〜10:00(日本時間では平日10:00〜13:00と15:00〜19:00)で、それ以外はオフピークとして半額になる。中国の祝日は終日オフピークである。
| トークン種別 | オフピーク | ピーク |
|---|---|---|
| 入力(キャッシュヒット) | $0.003 | $0.006 |
| 入力(キャッシュミス) | $0.15 | $0.30 |
| 出力 | $0.60 | $1.20 |
たとえば入力1,000万トークン(キャッシュミス)と出力200万トークンを処理すると、ピーク時で約$5.40、オフピークなら約$2.70である。8枚のH200ノードを借りる費用と比べれば、月間の処理量がよほど多くない限りAPIの方が安い。機密データを外部に出せない、オフライン運用が必要、といった理由がない限りは、まずAPIで挙動を確かめるのが堅実だ。なお、9月10日の更新でAPI価格は引き下げられたとされるが、公式ページに旧価格の記載はなく、以前のV4-Flash(キャッシュミス入力$0.14・出力$0.28)とは単純比較できない点に注意したい。
よくある失敗とトラブルシューティング
- OOM(メモリ不足): 重みだけでなく実行時バッファが必要。510GBの重みを640GBのノードに載せる場合、同時リクエスト数とバッチサイズを絞る
- Macで読み込めない: ランタイムの未対応が原因の可能性が高い。サイズが足りていても動かない場合がある
- 出力が途中で切れる: 推奨のmax_tokens(256K以上)に満たない設定になっていないか確認する
- 応答が遅い: 思考モードが既定。不要なら非思考モードに切り替える
- ダウンロードが終わらない: リポジトリは510GBある。ディスクの空きと帯域を事前に確認する
FAQ
DeepSeek V4.1 Flashをローカルで動かすのに必要なメモリはどのくらいですか。
公式配布の重みは約510GB(Hugging Faceのリポジトリ表示)で、Q4_K_M級に再量子化して約430GB、3bit級で約335GB、2bit級で約260GBが目安である。公式配布以外は763Bからの当サイトの試算で、KVキャッシュは1Mトークンでも約0.9GBだが、実行時に数GB以上の余裕が必要になる。
総パラメータ数は763B、552B、748Bのどれが正しいですか。
Hugging Faceの表示は763B、モデルカード本文と論文のバックボーンは552B、これにEngramメモリ196Bを足すと748Bになる。763Bとの約15Bの差は公式に説明がない。メモリ見積もりには実際のファイル全体を数える763Bを基準にするのが安全である。
RTX 4090や5090で動きますか。
単体や少数枚のGPUでは動かない。最も小さい2bit級でも約260GBの重みが必要で、24〜32GBのGPUでは置き場がない。手元で試すなら、より小型のモデルか公式APIを使うほうが現実的である。
Macで動かせますか。
512GB級のユニファイドメモリなら容量的には3bit級〜Q4級が収まる見込みだが、llama.cpp・MLX・Ollamaがエンコーダ・デコーダ構成に未対応との分析が出ており、実際に使える量子化版は確認できていない。容量が足りても動かない可能性がある。
API料金はいくらですか。
deepseek-flashの料金は100万トークンあたり、ピーク時が入力(キャッシュミス)$0.30・出力$1.20、オフピークはその半額(入力$0.15・出力$0.60)である。キャッシュヒット入力は$0.006(ピーク)/ $0.003(オフピーク)。
商用利用はできますか。
コードも重みもMITライセンスで公開されており、商用利用が可能である。ただし使用前にリポジトリのLICENSE本文を自分で確認してほしい。
まとめ
DeepSeek V4.1 Flash(1017版)は、アーキテクチャと重みの規模が9月10日版と同じまま、事後学習でベンチマークを引き上げたマイナーアップデートである。ローカル運用の必要メモリは公式配布で約510GB、4bit級で約430GBと大きく、H200×8クラスのサーバーか512GB級のMacが入口になるが、Macではランタイム対応が未確認だ。まずは安価な公式APIで挙動を確かめ、必要になった時点でローカル構成を検討するのが無難だろう。自分の環境の試算にはVRAM計算ツールを使える。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ