LFM2.5-24B-A2B 必要スペック早見表
VRAM 14GB〜/RTX 16GB・Mac 24GBで動く【2026年版】
LFM2.5-24B-A2Bの必要スペックは、Q4_K_Mで約14〜15GB。VRAM 16GBのGPUか24GB以上のMacで動く。2026年10月公開の24B MoE(活性約2.45B)について、量子化別のメモリ、GPU・Mac別の推奨構成、実測速度、ベンチマーク、商用ライセンスまで詳しく解説する。
LFM2.5-24B-A2Bは、Liquid AIが2026年10月13日にHugging Faceでオープンウェイト公開した、総パラメータ約24.0B・1トークンあたりの活性パラメータ約2.45BのMoE(Mixture of Experts)モデルである。Q4_K_M量子化で約14〜15GBに収まる見込みで、VRAM 16GBのGPUや24GB以上のユニファイドメモリを積んだMacで動かせる。公式モデルカードにメモリ要件の明記はないため、本稿の数値はパラメータ数から算出した当サイトの試算である点に注意されたい。前世代のLFM2-24B-A2Bの後継であり、コンテキスト長は32Kから131,072トークンへ拡張されている。
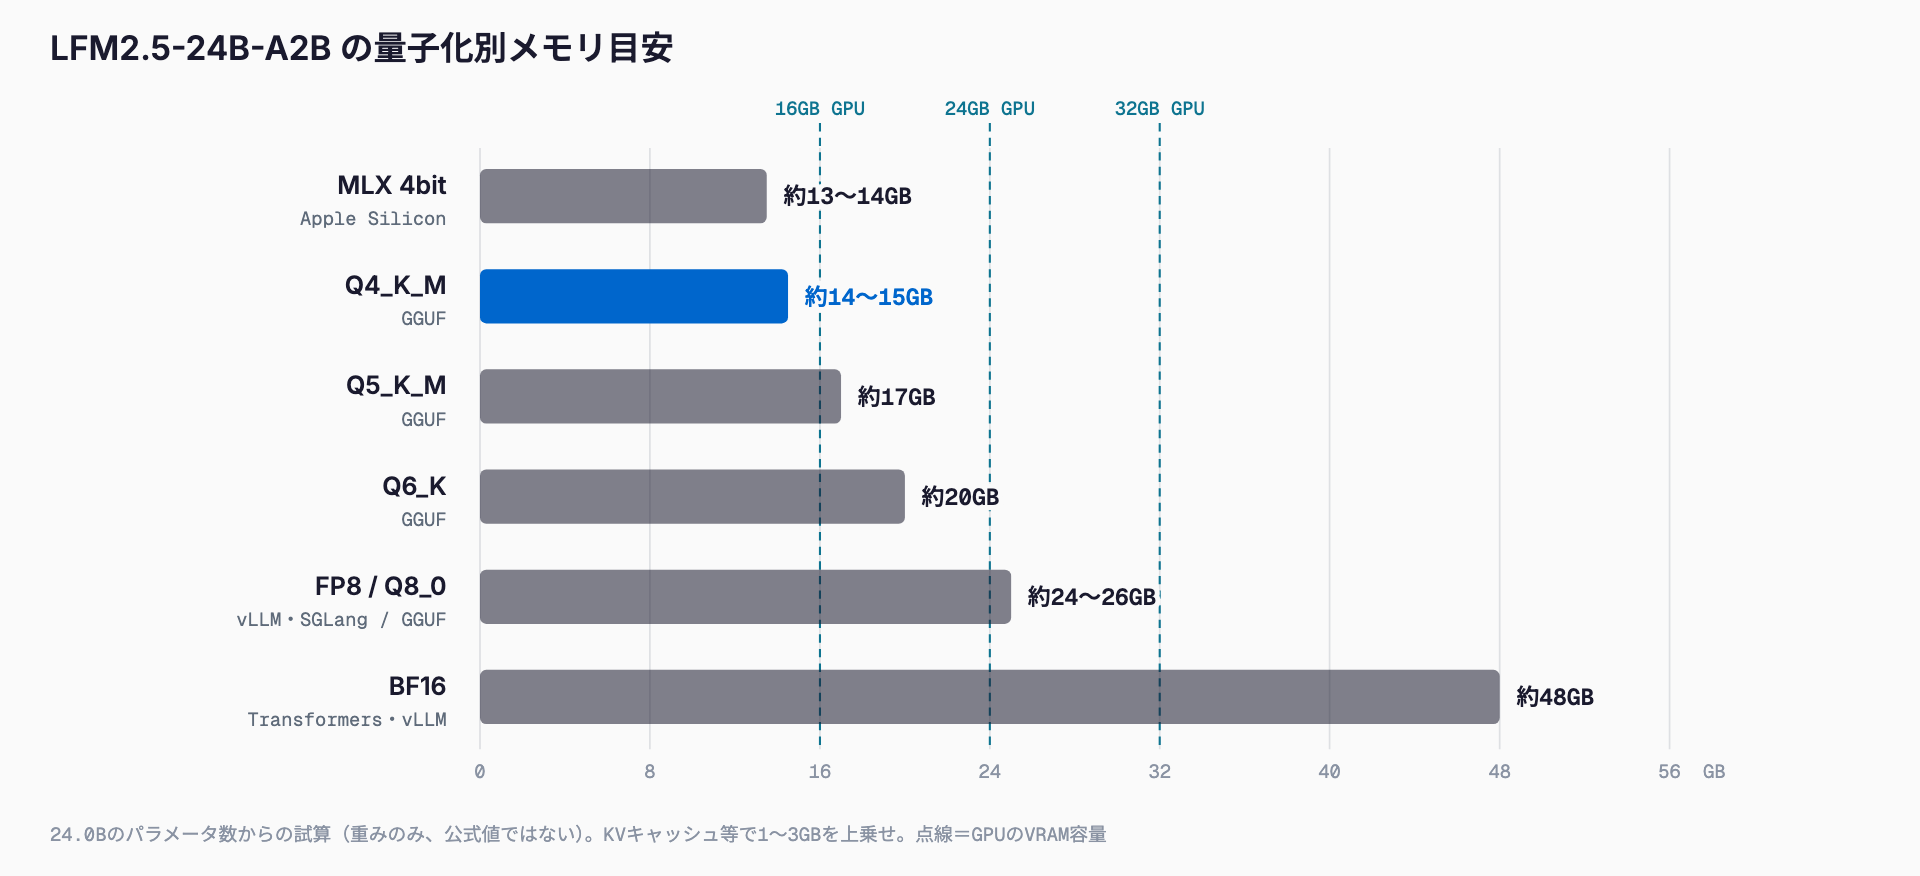
必要スペック早見表
| 精度/量子化 | 重みのメモリ目安 | 推奨環境 |
|---|---|---|
| BF16 | 約48GB | 2枚の24GB GPU、RTX PRO 6000、64GB以上のMac |
| FP8 / Q8_0 | 約24〜26GB | RTX 5090(32GB)、64GBのMac |
| Q6_K | 約20GB | RTX 3090 / 4090(24GB)、32GBのMac |
| Q5_K_M | 約17GB | 24GB GPU、32GBのMac |
| Q4_K_M | 約14〜15GB | RTX 4060 Ti 16GB / RTX 5060 Ti 16GB、24GB以上のMac |
| MLX 4bit | 約13〜14GB | 24GB以上のApple Silicon Mac(32GB推奨) |
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。LFM2.5-24B-A2Bもモデル一覧から選択できる。
上の表は、公式が公表した情報ではなく、パラメータ数24.0Bから一般的な量子化サイジングで算出した推定値である。実際の使用量は推論エンジン、量子化の種類、コンテキスト長で変わる。重みに加えてKVキャッシュとランタイムのオーバーヘッドが必要になるが、後述のとおり注意(アテンション)層は10層しかないため、KVキャッシュは同規模の全層アテンションモデルより小さい。長いコンテキストを使う場合は、重みの数値に1〜3GB程度を上乗せして見積もるのが無難だ(これも当サイトの目安である)。量子化ごとの品質差はGGUF量子化ガイド(Q4・Q5・Q8の選び方)で整理している。
LFM2.5-24B-A2Bとは — 短畳み込み主体のMoE
モデル名の「A2B」は、1トークンの処理で実際に使われる活性パラメータが約2.45Bであることを示す。総パラメータは24.0Bだが、推論時の計算量は2〜3B級の密モデルに近い。メモリには24B分の重みを載せる必要がある一方、トークン生成の速さは活性パラメータ数に強く左右される。これがMoEの基本的な性質であり、本モデルでは「メモリは24B級、速度は2B級」という特徴になる。
- 層構成: 全40層のうち30層が二重ゲート付き短畳み込み(double-gated short-convolution)ブロック、10層がGQA(Grouped Query Attention)ブロックである
- MoE: 各ブロックに64のエキスパートがあり、トークンごとにtop-4で選択される
- KVキャッシュ: アテンション層が10層のみのため、長いコンテキストでもKVキャッシュの増え方が穏やかである
- 語彙: 128K(従来の65Kから拡張)
- コンテキスト長: 131,072トークン(従来の32Kから拡張)
- 推論専用モデル: 常に思考するReasoningモデルで、チャットテンプレートが<think>タグを付与する
- 対応言語: 日本語・英語・中国語・韓国語・アラビア語・ヒンディー語・ロシア語・タイ語を含む16言語
学習は約33兆トークンの事前学習(前世代は約17兆)に加え、32Kで2兆トークン、131Kで3,000億トークンのミッドトレーニングを実施し、その後SFT、オンポリシー蒸留、エージェント向け強化学習を行っている。Liquid AIの小型モデルの流れはLFM2.5日本語特化2モデルの解説やLFM2.5-2.6Bの必要スペックでも扱っており、本モデルはそのラインを24B規模のMoEに広げたものと位置付けられる。
前世代LFM2-24B-A2Bからの変更点
| 項目 | LFM2-24B-A2B | LFM2.5-24B-A2B |
|---|---|---|
| 総パラメータ / 活性 | 24B / 約2B(名称のA2B) | 24.0B / 約2.45B |
| コンテキスト長 | 32K | 131,072 |
| 語彙サイズ | 65K | 128K |
| 事前学習トークン | 約17兆 | 約33兆 |
最大の変化はコンテキスト長の4倍化と、学習データ量のほぼ倍増である。語彙が倍近くに広がったことで、日本語を含む多言語のトークン効率の改善も期待できる。ただし、日本語での具体的な効率や品質は公式に数値が示されていないため、導入前に自社データでの確認を勧める。
ベンチマーク — エージェント系と指示追従に強み
公式モデルカードに掲載されたベンチマークを、同規模のオープンモデル3種と並べる。数値が大きいほど良い。
| ベンチマーク | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning 30B-A3B |
|---|---|---|---|---|
| AutomationBench | 27.69 | 8.72 | 5.46 | 2.61 |
| BFCLv4 | 65.01 | 65.00 | 57.09 | 53.78 |
| ToolSandbox | 80.71 | 75.02 | 72.09 | 75.13 |
| LiveClaw | 48.09 | 38.19 | 41.25 | 37.72 |
| PinchBench | 83.18 | 89.93 | 77.12 | 84.20 |
| WebArena Verified | 26.75 | 37.62 | 25.62 | 28.69 |
| GPQA Diamond | 74.42 | 83.69 | 74.90 | 72.42 |
| IFEval | 96.75 | 93.06 | 92.00 | 94.19 |
| IFBench | 74.69 | 64.21 | 47.44 | 71.67 |
| MATH-500 | 96.04 | 96.73 | 95.66 | 96.40 |
| SWE-Bench Verified(OpenCode) | 51.00 | 66.20 | 25.80 | 53.40 |
AutomationBench、ToolSandbox、LiveClaw、IFEval、IFBenchで比較対象を上回る一方、GPQA Diamond、WebArena Verified、SWE-Bench Verifiedではまだ総パラメータの大きいQwen3.6-35B-A3Bが優位である。ツール呼び出しと指示追従を軸にしたエージェント用途に向く傾向が読み取れる。なお公式は、知識量が問われるタスクでは検索(リトリーバル)やWeb検索と組み合わせて使うよう案内している。24Bという総パラメータの制約から、知識の網羅性は大型モデルに及ばないと理解しておくとよい。
実測スループット
| 環境 | 条件 | 速度 |
|---|---|---|
| Apple M5 Max | llama.cpp、Q4_K_M、入力4K | 184 tok/s(デコード) |
| AMD Ryzen AI Max+ 395 | llama.cpp、Q4_K_M、入力4K | 114 tok/s(デコード) |
| NVIDIA B300 1基 | SGLang、BF16、高い同時実行数 | 出力21,000 tok/s超(合計) |
活性パラメータが約2.45Bと小さいため、専用GPUがなくても実用的な速度が出る点が特徴である。Ryzen AI Max+ 395のような統合GPU搭載機で114 tok/sという公式値は、GPUを持たない環境でもローカル運用の候補になることを示す。ただし本モデルは常に思考してから回答するため、体感の応答時間は出力されるトークン数にも左右される。B300の数値は高い同時実行数でのサーバー合計スループットであり、単一リクエストの速度ではない。
GPU別・Mac別の推奨構成
- VRAM 16GB(RTX 4060 Ti 16GB / RTX 5060 Ti 16GB): Q4_K_Mで動作する見込み。重みだけで約14〜15GBのため、コンテキストは控えめにするか、一部をCPUへオフロードする
- VRAM 24GB(RTX 3090 / 4090): Q4〜Q6で余裕がある。長めのコンテキストも扱いやすい
- VRAM 32GB(RTX 5090): Q8_0(約24〜26GB)を載せられる
- BF16(約48GB): 24GB GPU 2枚、RTX PRO 6000、または64GB以上のユニファイドメモリのMacが目安
- Mac(Apple Silicon): MLX 4bitやQ4_K_Mなら24GB以上、余裕を見て32GB以上を推奨。Q8なら64GBが目安
- GPUなし・統合GPU: 活性パラメータが小さいため、CPUや統合GPUでも比較的速い。24B分の重みを載せるメモリ(Q4で約14〜15GB以上の空き)が前提になる
Macではユニファイドメモリのすべてをモデルに使えるわけではなく、OSやほかのアプリの分を差し引く必要がある。24GB機でQ4を動かすと余裕が小さいため、実用上は32GB以上が安心だ。ハードウェア選びの考え方はGemma 4のハードウェア要件の記事とも共通する。
動かし方 — llama.cpp・Ollama・LM Studio・vLLM・MLX
公式が対応を挙げているランタイムは、Transformers(5.0.0以上)、vLLM、SGLang、llama.cpp、MLX、LM Studio、Docker Model Runnerである。配布形式はBF16、FP8(ブロック単位、vLLM・SGLang向け)、GGUF、ONNX、MLX 4bitが用意されている。
- llama.cpp / Ollama / LM Studio: GGUF形式を使う。個人のPCやMacで最も手軽な選択肢で、Q4_K_Mから試すのがよい
- vLLM: vllm serve LiquidAI/LFM2.5-24B-A2B のようにモデルIDを指定してAPIサーバーとして起動する。FP8形式も利用できる
- SGLang: 高い同時実行数でのサーバー運用向け。公式のB300での数値もSGLang・BF16で計測されている
- MLX: Apple Silicon向け。MLX 4bit形式を使えばMacのユニファイドメモリで効率よく動く
- Transformers: バージョン5.0.0以上が必要。検証や微調整の入口に向く
推奨のサンプリング設定は、temperature 0.1、top_k 50、repetition_penalty 1.05である。温度がかなり低い点は一般的なチャットモデルと異なるため、既存のクライアント設定をそのまま流用しないよう注意したい。蒸留用のドラフトモデル「DSpark」による投機的デコードは、公式が「近日公開」としている段階で、現時点では利用できない。
ライセンスと商用利用
ライセンスはApache 2.0ではなく、独自の「LFM Open License v1.0」(lfm1.0)である。年間売上が1,000万米ドル未満の企業は商用利用が無償で、1,000万ドル以上の企業は商用ライセンスの取得が必要となり、窓口はsales@liquid.aiとされている。研究目的や非営利での利用は無償である。ファインチューニングした成果物をオープンソースにする義務はない。一方で、ライセンス本文の同梱、著作権などの表示の維持、改変したファイルへの変更表示は求められる。社内で本番利用する前に、自社の売上規模がどちらに該当するかと、ライセンス本文を必ず自分で確認してほしい。
他モデルとの比較
| モデル | 総 / 活性パラメータ | 特徴 |
|---|---|---|
| LFM2.5-24B-A2B | 24.0B / 約2.45B | 短畳み込み主体、131Kコンテキスト、指示追従とツール利用に強い |
| Qwen3.6-35B-A3B | 35B / 約3B | GPQA Diamond・SWE-Bench Verifiedで上回る。メモリは大きめ |
| Gemma 4 26B A4B | 26B / 約4B | 活性が大きく、LFMより計算量が多い |
| Nemotron 3.5 Lightning | 30B / 約3B | 同規模の比較対象。詳細は別記事 |
| LFM2.5-2.6B | 約2.69B | スマートフォン級の小型エージェント向け。2.5GB未満 |
コーディング支援や高難度の推論ではQwen3.6-35B-A3Bに分があり、ツール呼び出しや指示追従を重視するワークフローではLFM2.5-24B-A2Bが有力という使い分けが考えられる。同系統の比較対象についてはNemotron 3.5 Lightningの解説、メモリを極限まで抑えたい場合はLFM2.5-2.6Bを参照されたい。
トラブルシューティング
- メモリ不足(OOM): 量子化をQ4_K_Mまたはそれ以下に下げる、コンテキスト長を縮める、GPUに載せる層数を減らして残りをCPUに置く、の順で試す
- 思考が長すぎて応答が遅い: 常に<think>で思考する仕様のため、最大出力トークン数を設定し、思考部分を表示から除外する処理をアプリ側に入れる
- 出力が不安定・繰り返す: 推奨のtemperature 0.1、top_k 50、repetition_penalty 1.05に揃える
- Transformersで読み込めない: バージョンが5.0.0以上か確認する
- 知識系の質問で誤りが多い: 公式の案内どおり、検索やリトリーバルと組み合わせる
- GGUFが見つからない: 公式はGGUF形式の提供を挙げている。ファイルサイズは本稿の試算と異なる場合があるため、取得元の表記を確認する
FAQ
LFM2.5-24B-A2Bを動かすのに必要なメモリはどのくらいですか。
重みのメモリはQ4_K_Mで約14〜15GB、Q8_0で約24〜26GB、BF16で約48GBが目安である。いずれも公式の明記値ではなく、24.0Bのパラメータ数からの試算で、KVキャッシュなどに1〜3GB程度の上乗せを見込むとよい。
VRAM 16GBのGPUで動きますか。
Q4_K_Mなら重みが約14〜15GBで収まる見込みなので、RTX 4060 Ti 16GBやRTX 5060 Ti 16GBで動かせる。ただし余裕は小さく、コンテキストを短くするか一部をCPUにオフロードする運用が現実的である。
GPUがなくても使えますか。
活性パラメータが約2.45Bと小さいため、CPUや統合GPUでも比較的速い。公式はAMD Ryzen AI Max+ 395でllama.cpp・Q4_K_M・入力4Kのデコード114 tok/sを報告している。ただし24B分の重みを載せるメモリは必要である。
商用利用はできますか。
LFM Open License v1.0により、年間売上が1,000万米ドル未満の企業は無償で商用利用できる。1,000万ドル以上の企業は商用ライセンスが必要で、sales@liquid.aiが窓口とされている。ライセンス本文の確認は必須である。
日本語は使えますか。
日本語を含む16言語に対応している。ただし日本語での品質を示す公式の個別ベンチマークは提示されていないため、実務で使う前に自社の業務データで検証することを勧める。
まとめ
LFM2.5-24B-A2Bは、重みこそ24B級でQ4なら約14〜15GBに収まる一方、活性パラメータは約2.45Bと小さく、M5 Maxで184 tok/s、Ryzen AI Max+ 395で114 tok/sという速度が公式に示されている。VRAM 16GBのGPUか、24GB以上(できれば32GB以上)のMacがあれば試せる。ツール利用と指示追従に強い反面、常に思考する仕様と知識量の限界があるため、検索との併用と出力長の管理が運用の要になる。自分の環境での必要メモリはVRAM計算ツールで確認できる。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ