EmbeddingGemma 2 必要スペック早見表
RAM 191MB〜・GPU不要で動く【メモリ表・使い方・RAG組み込み・2026年版】
EmbeddingGemma 2の必要スペックは、テキストのみで実測191MB(推定重み約0.54GB)、全モダリティでBF16約1.5GB。GPU不要。メモリ表・使い方・RAG組み込みを解説【2026年10月】
EmbeddingGemma 2の必要スペック — テキストのみなら数百MB、全モダリティでもBF16で約1.5GB
EmbeddingGemma 2は、Google DeepMindが2026年10月6日に公開した、テキスト・コード・画像・動画・音声を1つの768次元ベクトル空間に変換できるオープンな埋め込みモデルです(Apache 2.0)。GPUは必須ではなく、テキストのみなら重みはBF16で約0.54GB(推定)、画像と音声も載せた全構成でも約1.5GB(推定)に収まります。Googleの公式の実測では、量子化したPixel 11 Proでテキストのみ約191MB、全マルチモーダルで約567MBのRAMです。本稿ではメモリの目安、CPU・Mac・スマホ・ブラウザでの動作、最短の使い方、ローカルRAGへの組み込みまでを整理します。数値は公式値と筆者の試算(推定)を分けて記載します。
EmbeddingGemma 2とは — 初代との違い
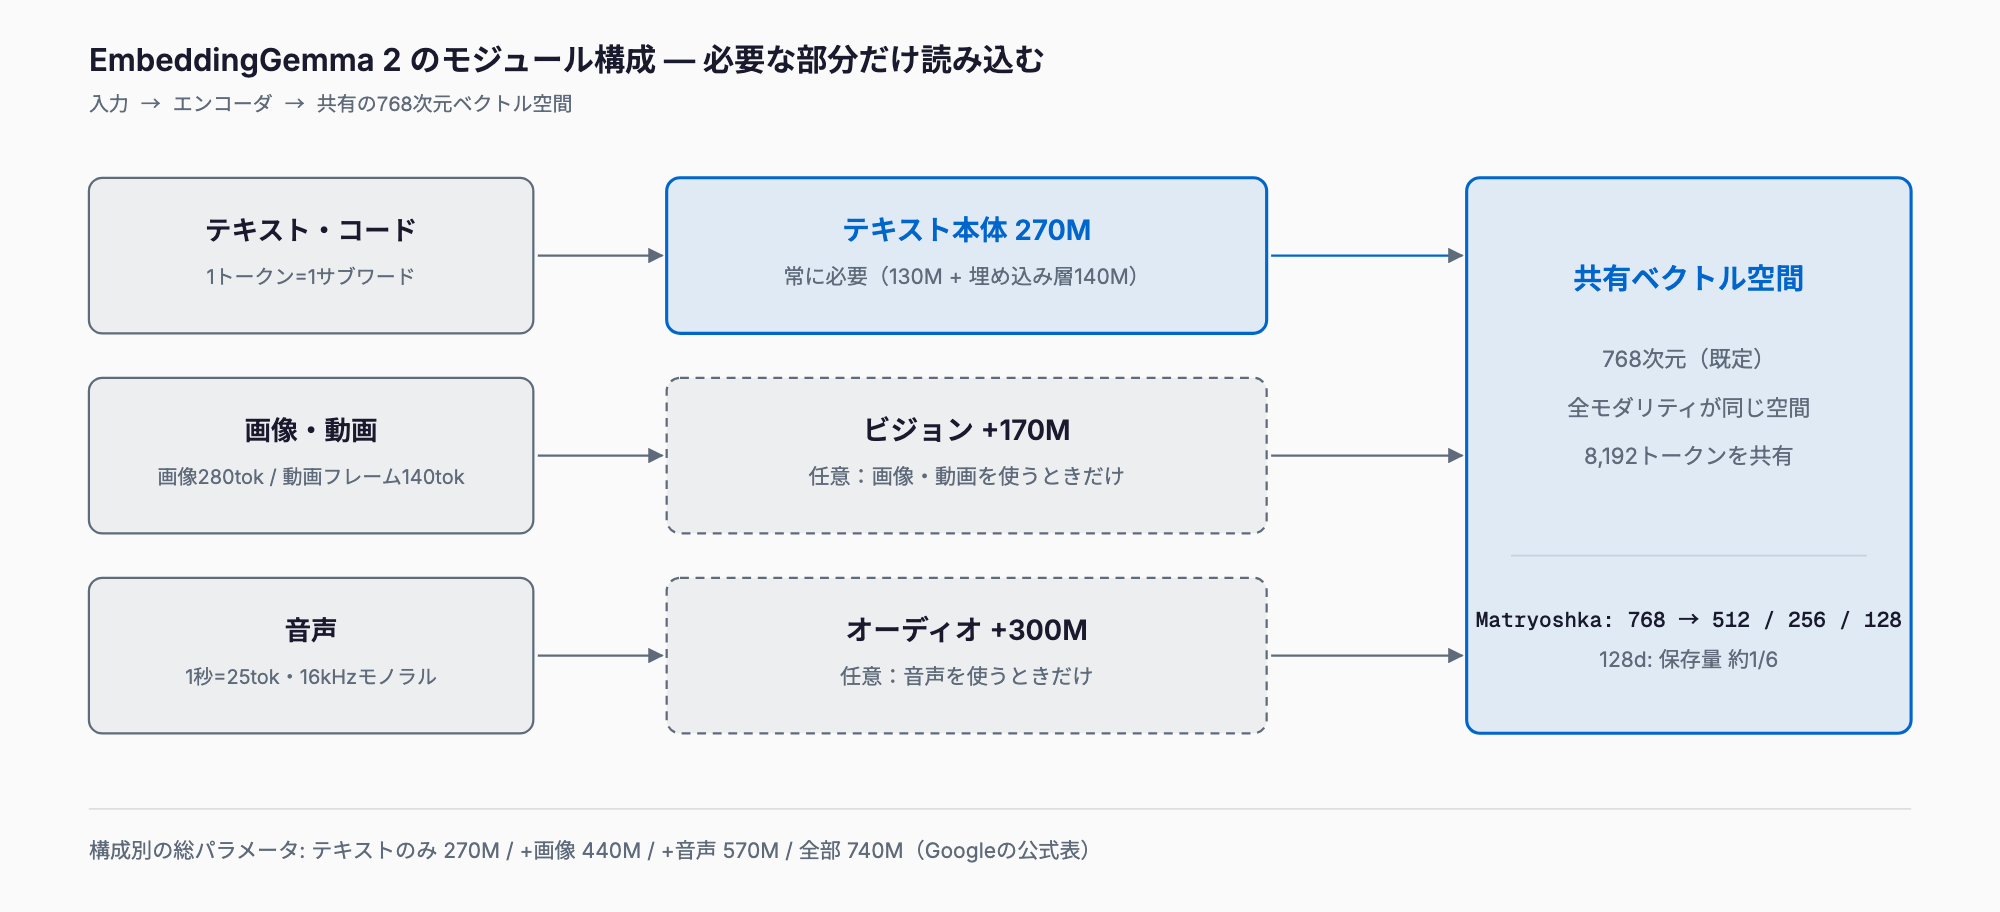
総パラメータは740Mで、テキスト本体(270M)に、ビジョンエンコーダ(170M)とオーディオエンコーダ(300M)を必要な分だけ足すモジュール構成です。使わないモダリティは読み込まなくてよいので、テキスト検索だけなら270M相当の軽さのまま使えます。
| 項目 | EmbeddingGemma 2 | 初代 EmbeddingGemma |
|---|---|---|
| 対応する入力 | テキスト・コード・画像・動画・音声 | テキスト |
| 総パラメータ | 740M(構成により270M〜740M) | 約300M規模(初代公開時の値) |
| ベクトル次元 | 768(512/256/128へ短縮可) | 768(同様に短縮可) |
| コンテキスト | 8,192トークン(全モダリティで共有) | 2,048トークン(初代公開時の値) |
| MTEB多言語 v2 | 61.36 | 61.15 |
| MTEBコード v1 | 78.68 | 68.76 |
| ライセンス | Apache 2.0 | Gemma利用規約 |
テキスト性能の多言語スコアはほぼ横ばいで、伸びたのはコード検索(NDCG@10が68.76から78.68)とマルチモーダル対応です。画像・動画・音声の公式スコアは、MMEB v2 の画像57.28・ビジュアル文書67.84・動画50.67、MSEB検索69.54、MAEB 49.39などが公表されています(いずれもGoogleの数値で、独立した検証は今後)。
必要スペック早見表(メモリの目安)
モデルの重みのメモリは「パラメータ数 × 1パラメータあたりのバイト数」で見積もれます(FP32=4バイト、BF16=2バイト、8bit=1バイト、4bit=0.5バイト)。下表はこの式による推定で、重みのみの値です。実行時には入力長に応じた作業領域やランタイムの分が加わるため、余裕を見て1.2〜1.5倍程度で考えると安全です。
| 構成(推定・重みのみ) | パラメータ | FP32 | BF16 | 8bit | 4bit |
|---|---|---|---|---|---|
| テキストのみ | 270M | 約1.08GB | 約0.54GB | 約0.27GB | 約0.14GB |
| テキスト+画像 | 440M | 約1.76GB | 約0.88GB | 約0.44GB | 約0.22GB |
| テキスト+音声 | 570M | 約2.28GB | 約1.14GB | 約0.57GB | 約0.29GB |
| 全モダリティ | 740M | 約2.96GB | 約1.48GB | 約0.74GB | 約0.37GB |
公式の実測値は、量子化したPixel 11 Proでのテキストのみ約191MB、全マルチモーダル約567MB(アクティブRAM)です。上の4bit・8bit列とおおむね整合する水準で、スマホでも常駐させられる大きさです。
CPU・Mac・スマホ・ブラウザでの動作
- CPU / Mac: テキストのみなら数百MBなので、メモリ8GBのPCでも動かせます。GPUがなければFP32(約1.1GB・推定)で動かすのが安全です。Apple SiliconはMLXやllama.cppでの利用が報じられています。
- GPU: 必須ではありません。大量の文書を一括でベクトル化するときに速度面で効く程度です。vLLMやSGLangも対応が報じられています。
- スマホ: MediaPipeとLiteRT経由で端末内実行でき、公式は量子化版が単一のファイルでCPU・GPUで動くと説明しています(実測は上記のPixel 11 Pro)。
- ブラウザ: transformers.jsとWebGPUでの動作が報じられています。ただしHugging Faceの公式モデルカードには記載がなく、ブラウザ向けのモデルIDは本稿では確認できていません。
使い方 — 最短コード
Python(sentence-transformers)では、モデルID google/embeddinggemma-2 を読み込みます(報道ではsentence-transformers 6.1.0以降)。検索クエリには SearchQuery、保存する文書には Document のプロンプト名を付けるのが公式の使い方で、付けないとエラーなしで精度が落ちます。テキストだけ使う場合は、config_kwargs でビジョンとオーディオを外します。
import torch
from sentence_transformers import SentenceTransformer

# float16は使わない。GPUがbf16対応ならbfloat16、それ以外はfloat32
dtype = torch.bfloat16 if torch.cuda.is_available() and torch.cuda.is_bf16_supported() else torch.float32

model = SentenceTransformer(
    "google/embeddinggemma-2",
    model_kwargs={"torch_dtype": dtype},
    config_kwargs={"vision_config": None, "audio_config": None},  # テキストのみ(270M)
    truncate_dim=256,  # Matryoshka: 768 / 512 / 256 / 128
)

q = model.encode("返品の手順を教えて", prompt_name="SearchQuery", normalize_embeddings=True)
d = model.encode("返品は商品到着後14日以内に受け付けます。", prompt_name="Document", normalize_embeddings=True)
print(model.similarity(q, d))
Ollamaの公式ライブラリには embeddinggemma-2 として登録されています。タグはモダリティ構成ごとに 270m(テキストのみ・378MB)、440m(テキスト+画像・714MB)、570m(テキスト+音声・990MB)、740m(全構成・1.3GB、latest と同じ)が用意されており、テキスト検索だけなら 270m を選ぶのが最も軽量です。埋め込みAPIは次のように呼び出します。LM Studio、llama.cpp(GGUF)も対応が報じられています。
# テキストのみなら最軽量の 270m タグ(378MB)
ollama pull embeddinggemma-2:270m

curl http://localhost:11434/api/embed -d '{
  "model": "embeddinggemma-2:270m",
  "input": ["task: search result | query: 返品の手順", "title: none | text: 返品は14日以内です。"]
}'
画像・動画・音声には、テキスト用のプレフィックスは付けません。プレースホルダは <|image|> <|video|> <|audio|> です。入力の目安は、画像が既定で1枚280トークン(約29枚)、動画が1フレーム140トークン(約58フレーム)、音声が1秒25トークン(約5.5分、16kHzモノラル)で、合計8,192トークンまでです。
ローカルRAGへの組み込み例とMatryoshka次元の選び方
ベクトルDBにはQdrantなどが使えます。下は、256次元に短縮して保存・検索する最小の例です(前節の model を使用)。RAG全体の組み立ては、Qwen3.5-9BでつくるローカルRAGや、WeKnoraのRAGナレッジプラットフォームの解説も参考になります。
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, VectorParams, PointStruct

client = QdrantClient(":memory:")  # 本番ではURLやパスを指定
client.create_collection("docs", vectors_config=VectorParams(size=256, distance=Distance.COSINE))

texts = ["返品は商品到着後14日以内に受け付けます。", "送料は全国一律800円です。"]
vecs = model.encode(texts, prompt_name="Document", normalize_embeddings=True)
client.upsert("docs", points=[PointStruct(id=i, vector=v.tolist(), payload={"text": t}) for i, (v, t) in enumerate(zip(vecs, texts))])

qv = model.encode("送料はいくら?", prompt_name="SearchQuery", normalize_embeddings=True)
hits = client.query_points("docs", query=qv.tolist(), limit=3).points
for h in hits:
    print(h.score, h.payload["text"])
次元の選び方は、用途で変わります。公式の数値では、MTEB多言語 v2 が768次元で61.36、512次元で61.17、256次元で60.41、128次元で57.89です。テキストのみなら256次元で精度低下は1ポイント程度、128次元は保存量が小さい代わりに約3.5ポイント下がります。画像などを含むマルチモーダル(MMEB overall)は768次元59.01、256次元56.24、128次元45.65と下がり方が大きく、公式も128次元はテキストのみ向けとしています。保存量の目安は、100万件で768次元BF16が約1.5GB、128次元が約250MBです。
他の埋め込みモデルとの比較
| モデル | 入力 | 次元 | 最大入力 | 提供形態 |
|---|---|---|---|---|
| EmbeddingGemma 2 | テキスト・コード・画像・動画・音声 | 768(短縮可) | 8,192トークン | オープンウェイト(Apache 2.0)・ローカル |
| 初代 EmbeddingGemma | テキスト | 768(短縮可) | 2,048トークン | オープンウェイト・ローカル |
| Qwen3-Embedding(0.6B/8B) | テキスト | 最大1024 / 4096(短縮可) | 32Kトークン | オープンウェイト(Apache 2.0)・ローカル |
| OpenAI text-embedding-3-large | テキスト | 3072(短縮可) | 8,191トークン | API(従量課金・クラウド) |
| Gemini Embedding 2 | テキスト・画像・文書・音声・動画 | 3072(短縮可) | テキスト8,192トークン | API(公開時はパブリックプレビュー) |
一言でいえば、画像や音声まで同じ空間で検索したい、かつ手元・端末内で完結させたいならEmbeddingGemma 2、テキストだけで長文(32K)を扱いたいならQwen3-Embedding、運用を任せてAPIで済ませたいならOpenAIやGeminiが選択肢になります。各社のモデル仕様・価格は更新されるため、採用前に公式の最新情報を確認してください。
注意点
- float16は使わない: 公式がNaNや精度劣化が静かに起きると警告しています。bfloat16かfloat32を使います。
- 日本語の精度は自分のデータで確認する: 100以上の言語に対応しますが、公式も言語間で性能が均等とは限らないとしています。日本語単独の公式スコアは今回確認できず、実際の社内文書での検証が確実です。
- 8,192トークンはモダリティで共有: 画像29枚と長文を同時には入れられません。長い文書はチャンクに分けます。
- プレフィックスの付け忘れ: クエリと文書で書式が違います。タイトル付きの文書は title: {title} | text: {content} を自分で組み立てます。
- ベンチマークはGoogleの発表値: 独立した追試は今後の確認事項です。
よくある質問
EmbeddingGemma 2はGPUなしで動きますか?
動きます。テキストのみの構成なら重みはBF16で約0.54GB、FP32でも約1.08GB(いずれも推定)で、CPUとメモリ8GB程度のPCで実行できます。公式はスマホ(量子化したPixel 11 Pro)でテキストのみ約191MBと説明しています。
必要なメモリはいくつですか?
公式の実測は、量子化したPixel 11 Proでテキストのみ約191MB、全マルチモーダル約567MBです。PC向けの重みのみの推定は、テキストのみBF16で約0.54GB、全モダリティBF16で約1.48GBです。実行時の作業領域として1.2〜1.5倍を見込むと安全です。
日本語は使えますか?
100以上の言語に対応しています。ただし日本語単独の公式スコアは今回確認できていません。社内文書など自分のデータで検索精度を試してから採用するのが確実です。
Matryoshka次元は何を選べばよいですか?
テキストのみなら256次元がバランス良く、MTEB多言語 v2 で768次元との差は約1ポイントです。128次元は保存量が小さい反面、画像などのマルチモーダルでは大きく精度が下がるため、テキストのみ向けです。
初代EmbeddingGemmaから乗り換えるべきですか?
テキストのみの多言語検索なら、スコアはほぼ同じ(61.36と61.15)で、必須ではありません。コード検索(68.76から78.68)、長い入力(8,192トークン)、画像・音声も同じ空間で扱いたい場合に乗り換える意味があります。
float16で動かしてもよいですか?
避けてください。公式はfloat16でNaNや劣化した埋め込みが静かに出ると警告しており、bfloat16かfloat32を使うよう案内しています。
まとめ
EmbeddingGemma 2は、必要なモダリティだけ読み込む構成で、テキストのみなら数百MB、全部入りでもBF16で約1.5GB(推定)に収まり、GPUなしのPCやスマホ、ブラウザでも動かせる点が最大の特徴です。使い始めは、sentence-transformersでテキストのみを読み込み、SearchQuery と Document を付けて、256次元で試すのが手堅い入口です。モデルサイズ別のハードウェア選びの考え方は、Gemma 4のハードウェア要件の記事でも整理しています。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ