Muse Spark Open 必要スペック早見表
4bitで約700GB・Mac Studio M5 Ultra×2で動作(816B MoE)
Meta Muse Spark Open(総816B・アクティブ42B)の必要VRAMは公式でBF16約2TB、4bit最低700GB。Mac Studio M5 Ultra 2台でのMLX動作、H200構成、1MコンテキストのKVキャッシュ推定、ライセンスの商用条件まで整理。2026年10月16日更新。
Metaが2026年10月15日に公開したオープンウェイトモデル「Muse Spark Open」(総816B・アクティブ42BのMoE)をローカルで動かす場合、公式の目安はBF16で約2TB、NVFP4(4bit)で最低700GBのVRAMだ。Metaは「米国発のオープンウェイトモデルとして現時点で最高性能」と位置づけ、公式にはMac Studio(M5 Ultra・統合メモリ512GB)2台でMLX経由の動作が最適化されている。GGUFの2bit級なら合計約300GBのメモリに収まるという報告もある。
つまり個人のPCや単体GPUで動かす規模ではなく、現実的な選択肢はMac Studio 2台、H200やB200を8枚前後積んだサーバー、あるいは各社のAPIだ。本稿ではMetaの公式情報、報告ベースの数値、当サイトによる推定を分けて記載する。FP8やKVキャッシュなど公式値のない箇所は「推定」と明記し、モデルカードに載っていない事項は「未公表」とする。
必要スペック早見表
重みの容量は「総パラメータ816B × 1パラメータあたりのバイト数」で見積もれる。公式の700GBや2TBにはKVキャッシュと実行時のオーバーヘッドを含む余裕が見込まれているため、下表は公式値・報告値・推定値を分けて並べた。
| 精度 | 必要メモリの目安 | 根拠 |
|---|---|---|
| BF16 | 約2TB | 公式(Hugging Faceモデルカード) |
| FP8 | 約816GB(重みのみ)、実運用は約900GB前後 | 推定(816B × 1byte) |
| NVFP4(4bit) | 最低700GB | 公式 |
| 2bit級(Unsloth Dynamic GGUF) | 合計約300GB | 報告ベース |
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。Muse Spark Openもモデル一覧から選択できる。
| ハード構成の例 | 合計メモリ | 4bit(700GB級) | FP8 | BF16 |
|---|---|---|---|---|
| Mac Studio M5 Ultra 512GB × 2 | 約1,024GB | 公式対応 | 余裕が小さい | 不可 |
| H100 80GB × 8 | 640GB | 不足 | 不可 | 不可 |
| H200 141GB × 5 | 705GB | ぎりぎり | 不可 | 不可 |
| H200 141GB × 8 | 1,128GB | 余裕あり | 載る(長文は厳しい) | 不可 |
| B200 192GB × 4 | 768GB | 載る(余裕は小さい) | 不可 | 不可 |
| B200 192GB × 8 | 1,536GB | 余裕あり | 余裕あり | 不可 |
構成例の合否は、合計メモリを公式の700GBと推定のFP8容量に照らした当サイトの判断で、実機での検証値ではない。BF16は約2TBで、B200×8でも1,536GBに届かない。
Muse Spark Openとは — モデル仕様
Muse Spark Openは、Metaのモデルファミリー「Muse」のオープンウェイト版だ。MoE構造のTransformerにPerception Encoderを組み合わせ、テキスト・画像・動画・音声を入力できる(出力はテキスト)。100以上の言語で学習されているが、すべての言語が評価されているわけではない。Hugging Faceのリポジトリは meta-models/Muse-Spark-Open-816B-A42B で、Amazon SageMaker AI、Google Cloud Model Garden、Microsoft Foundry Modelsでも提供される。
| 項目 | 内容 |
|---|---|
| 総パラメータ | 816B |
| アクティブパラメータ | 42B |
| 層数 | 62 |
| 隠れ層サイズ | 8192 |
| エキスパート | 256(トークンあたり8を選択) |
| アテンション | クエリヘッド128・KVヘッド16(GQA)・ヘッド次元64、ゲート付きアテンション+QK-norm |
| 語彙サイズ | 202,048 |
| Perception Encoder | 1.8B |
| 入力/出力 | テキスト・画像・動画・音声/テキスト |
| コンテキスト長 | 1Mトークン |
| 推論の強度 | low / medium / high / xhigh(既定はxhigh) |
なぜ総パラメータ816Bでメモリを見積もるのか
MoEは1トークンごとに256エキスパートのうち8つしか使わないが、どれが選ばれるかは入力次第で変わる。そのため原則として全エキスパートを常駐させる必要があり、必要メモリは総パラメータ(816B)で決まる。アクティブ42Bが効くのは速度の側で、4bitなら1トークンあたり読み出す重みは約21GB(42B × 0.5byte)にとどまる。メモリ要求は800B級、計算量は40B級という二面性を持つ。
量子化とメモリ — 公式NVFP4と2bit級GGUF
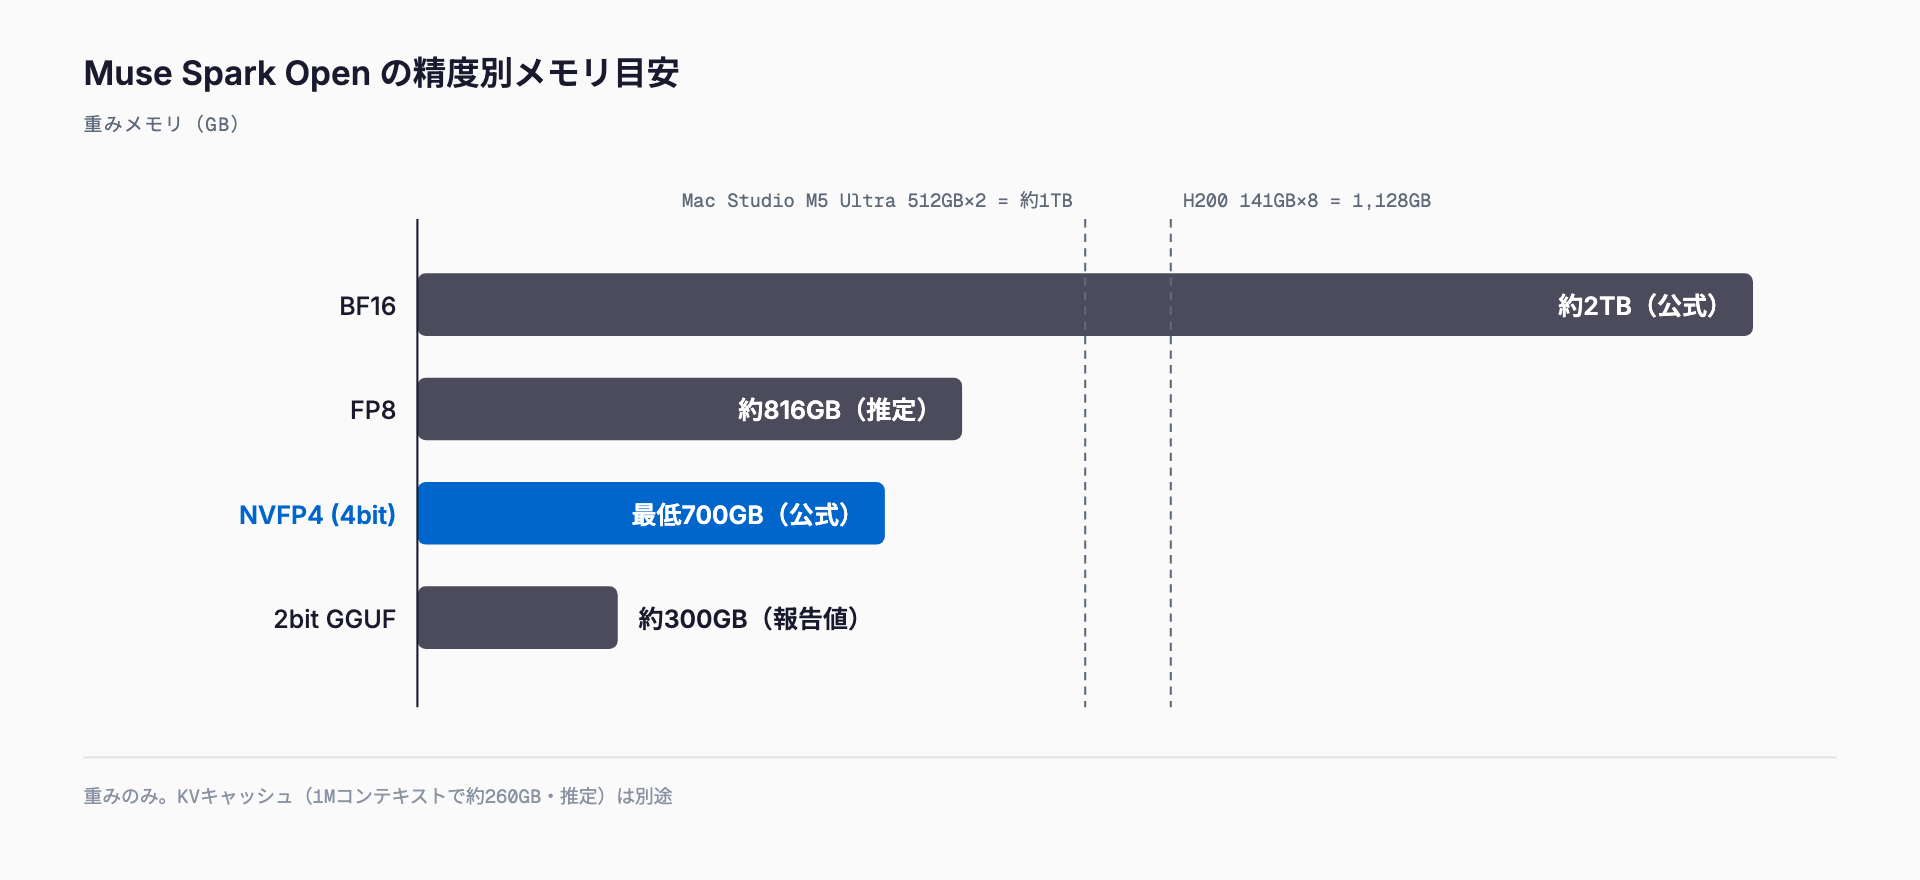
公式が示す4bit形式はNVFP4で、MetaとAppleがMLX向けに用意した形式とされる。重みだけなら816B × 0.5byte ≒ 408GBだが、スケール係数などのメタデータとKVキャッシュ、実行時の領域を見込んで公式は最低700GBとしている。2bit級はUnsloth Dynamic GGUFで合計約300GBに収まると報告されており、llama.cpp、Ollama、LM Studio、Janで量子化版を使える。ただし2bit級は品質低下が大きくなりやすく、推論を使う用途では4bit以上が無難だ。
量子化の基本はMistral Large 4の必要スペック記事でも整理している。同じ1T級でも、Muse Spark Openは4bitで700GB級と公式値があるぶん、見積もりの誤差を気にせず構成を決めやすい。
Mac Studio 2台構成(MLX)で動かす
Metaは、M5 Ultra搭載のMac Studio(統合メモリ512GB)2台、合計約1TB・メモリ帯域1.2TB/sの構成で動かすことを公式に最適化している。MLX(mlx-lm)経由でNVFP4を使い、2台合計で毎秒約15.7〜25トークンの生成速度が報告されている(報告ベース、条件によって変わる)。1台あたり512GBでは4bit版(最低700GB)は載らないため、2台を分散推論で束ねるのが前提だ。
デモとしては、Metaのコーディング用ターミナル「Muse Code」が、オープンソースのiOS向けMastodonクライアント「Ice Cubes」でのバグ修正と機能追加、DaVinci Resolveを操作した映像の確認・クロップをオンデバイスで実行する様子が公開された。台数間の接続方式や必要なネットワーク帯域、長コンテキスト時の速度は公式情報として確認できておらず、本稿では未公表とする。
NVIDIA・AMD GPU構成で動かす
GPUサーバーでは、4bit(NVFP4)ならH200×5〜8、B200×4〜8が候補になる。FP8(約816GB)はH200×8の1,128GBに載るが、残りは約300GBで、後述の長コンテキストでは余裕が小さい。BF16はB200×8でも不足する。並列化の方式(テンソル並列・エキスパート並列)によっては枚数が2の累乗に制約されるため、H200×5のような構成が使えるかはフレームワーク次第だ。
MetaはカスタムのHelionカーネルをSGLangに提供しており、カーネル単位でNVIDIAとAMDで1.03〜3.95倍の高速化、AMD MI350ではエンドツーエンドで3%の改善が報告されている。端から端までの高速化は限定的なので、導入の決め手にするよりは、AMDでも動かせる選択肢が増えた程度に見ておくのがよい。
KVキャッシュと1Mコンテキストの見積もり
KVキャッシュは、層数62 × KVヘッド16 × ヘッド次元64 × 2(KとV)× 2byte(BF16)で、1トークンあたり約254KBと推定できる(当サイトの計算で、公式値ではない)。
| コンテキスト長 | KVキャッシュ(BF16・推定) | FP8 KVの場合(推定) |
|---|---|---|
| 8K | 約2GB | 約1GB |
| 32K | 約8GB | 約4GB |
| 128K | 約33GB | 約17GB |
| 1M | 約260GB | 約130GB |
GQA(KVヘッド16)のおかげで、128Kなら約33GBに収まる。一方、1Mを使い切ると約260GBが重みに上乗せされ、4bitの700GBに足すと960GB前後になる。同時リクエスト数に比例して増えるため、1Mを本格運用するならH200×8やB200×8級が現実的だ。仕組みはKVキャッシュとコンテキスト長のVRAM解説を参照してほしい。
起動手順 — vLLM・SGLang・Docker Model Runner・MLX
対応フレームワークは、SGLang、vLLM、Transformers(AutoModelForMultimodalLM)、TensorRT-LLM、MLX(mlx-lm)、llama.cpp、Unsloth。ファインチューニングはPyTorchとTorchTitanで行える。以下はMetaが示すコマンドだ。まずvLLM。
pip install vllm
vllm serve "meta-models/Muse-Spark-Open-816B-A42B"
次にSGLangで、OpenAI互換のサーバーをポート30000で起動する。
python3 -m sglang.launch_server \
  --model-path "meta-models/Muse-Spark-Open-816B-A42B" \
  --host 0.0.0.0 --port 30000
Dockerを使う場合は、Docker Model Runnerで1行で起動できる。
docker model run hf.co/meta-models/Muse-Spark-Open-816B-A42BMac Studio 2台のMLX構成は、mlx-lmの分散実行機能を使う。2台をつなぐ具体的なコマンドと設定はMetaのモデルカードおよびmlx-lmのドキュメントで確認してほしい(本稿の時点で当サイトは実機検証していない)。推奨のサンプリング設定はtemperature 1.0、top_p 1.0、top_kは無効で、推論強度はlow/medium/high/xhighから選ぶ(既定はxhigh)。
API利用という選択肢
APIで使えるプロバイダーは、Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter、Together AIだ。トークン単価は確認できていないため、各社の料金ページで入力・出力の単価を比べてほしい。上記のハードを揃えるとMac Studio 2台でも数百万円規模、H200×8なら桁が一つ上がるため、多くの中小企業ではまずAPIで品質を評価するほうが投資判断を誤りにくい。自前運用が向くのは、機密データを社外に出せない、毎日大量に処理するなど明確な理由がある場合だ。
同じMetaのクローズドなAPIモデルについてはMuse Spark 1.3の料金とベンチマーク記事、手元で動かせる小型モデルはMuse Glimmer 30Bの必要スペック記事にまとめている。
ライセンス — 商用利用の条件
ライセンスはMetaの独自ライセンス「Muse Model License」で、OSI定義のオープンソースではない。利用、改変、ファインチューニング、蒸留、再配布、販売が認められる。主な条件は次のとおりだ。
- 製品などに「Built with Muse Spark Open」の表示が必要
- 直近12か月のいずれかで総収益が2,000万米ドルを超え、かつ第三者にAPIで提供する(Model-as-a-Service)場合は、Metaへの通知と別途の契約が必要
- 社内利用、研究、自社製品への組み込みは上記の対象外
- 出力の所有権をMetaは主張しない
- 利用ポリシーで、兵器、マルウェア、重要インフラの運用、詐欺・偽情報・なりすましを禁止。18歳未満は対象外
Kimi K3のライセンスと似ていると報じられている。自社サービスに組み込む中小企業なら、通常は2,000万ドル級の収益条項に当たらないが、契約形態によって解釈が変わりうるため、事業で使う前にライセンス全文を確認してほしい。
ベンチマーク — 得意と苦手
以下はMetaのモデルカードに載るxhighでのベンチマーク値で、開発元による発表だ。独立した第三者の追試はまだ確認できず、完全な評価レポートも「近日公開」とされている。
| ベンチマーク | Muse Spark Open | 比較(開発元の表より) |
|---|---|---|
| AA Intelligence Index | 39 | Kimi K3 44、GLM 5.3 45、Qwen3.8-2.4T 40、Mistral Large 4 38 |
| MCP-Atlas | 89.2 | Kimi K3 82.3、Qwen3.8 84.5、Beam 78.7 |
| OSWorld Verified | 80.4 | Kimi K3 84.8 |
| Terminal-Bench 2.1 | 76.4 | Kimi K3 85.0、GLM 5.3 83.9、Beam 80.1 |
| DeepSWE 1.1 | 60 | Kimi K3 68、GLM 5.3 67、Mistral Large 4 62、Beam 44 |
| SWE-Atlas-QnA | 58 | Kimi K3 66 |
| GPQA Diamond | 89.0 | Kimi K3 93.5 |
| HLE(ツールあり) | 61.0 | GLM 5.3 62.5、Kimi K3 56.0 |
| JobBench | 61.8 | GLM 5.3 61.4 |
| StrongREJECT v2 | 0.5(低いほど良い) | 他モデルは62〜87 |
読み取れる傾向は、エージェントのツール利用(MCP-Atlas)と有害依頼の拒否(StrongREJECT)が強く、コーディング系ではKimi K3やGLM 5.3に及ばないという点だ。総合指標のAA Intelligence Indexは39で、Qwen3.8-2.4Tの40とほぼ並び、Mistral Large 4の38をわずかに上回る。コーディングエージェント用途ならKimi K3、ツール連携や安全性重視ならMuse Spark Openという使い分けが考えられるが、自社データでの検証が前提だ。
他の大型オープンウェイトとの比較
| モデル | 総パラメータ | アクティブ | ライセンス | 備考 |
|---|---|---|---|---|
| Muse Spark Open | 816B | 42B | Muse Model License(独自) | 4bitで最低700GB(公式) |
| Mistral Large 4 | 1T | 49B | 重み公開時に確認 | FP8約1TB(推定) |
| Reflection Beam | 501B | 23B | Apache 2.0 | 4bitは約250〜290GB(推定) |
| Qwen3.8-2.4T | 2.4T | 95B | 要確認 | AA Index 40 |
| Kimi K3 | 2.8T | 非公表 | 独自(Muse Model Licenseに類似と報道) | コーディング系で上位 |
メモリの軽さでは、501BのReflection Beamが大きく優位だ。Muse Spark Openはその約1.6倍の重みを持ち、1T級のMistral Large 4よりは軽い。ライセンスの自由度ではApache 2.0のBeamが上で、Muse Spark Openは表示義務と収益条件がある。
予算別の選び方
- メモリ0に近い・まず試したい: プロバイダーのAPI(OpenRouter、Together AI、Fireworks AIなど)。単価は各社で確認
- Mac環境で自前運用したい: Mac Studio M5 Ultra 512GB × 2台(MLX・NVFP4、公式対応)
- GPUサーバーで本格運用: H200×8またはB200×4〜8。1Mコンテキストを使うならH200×8以上
- 品質より動作を優先: 2bit級GGUFを合計約300GBのメモリで(品質低下は覚悟)
- クラウドの管理基盤に載せたい: Amazon SageMaker AI、Google Cloud Model Garden、Microsoft Foundry Models
トラブルシューティング(メモリ不足・OOM)
- 起動時にOOM: 重みが載っていない。精度を一段下げる(FP8から4bitへ)か、台数・枚数を増やす
- 途中からOOM: KVキャッシュが原因の可能性が高い。コンテキスト長の上限を下げる、同時リクエストを減らす、KVのFP8化を検討する
- 画像・動画・音声入力で落ちる: Perception Encoder(1.8B)と入力トークン分が加わる。解像度や同時入力数を減らす
- Macで遅い・不安定: 台数間の接続がボトルネックになりやすい。他のアプリを閉じ、メモリ圧縮が発生していないか確認する
- 出力が乱れる: サンプリングをtemperature 1.0、top_p 1.0、top_k無効に戻す。2bit級は劣化が大きいので4bitを試す
- フレームワークが非対応と言われる: vLLM・SGLangなどを最新版に更新する
まとめ
Muse Spark Openは総816B・アクティブ42BのMoEで、公式の目安はBF16が約2TB、NVFP4が最低700GBだ。Mac Studio M5 Ultra 512GB×2台がMLXで公式に最適化されており、2bit級GGUFなら約300GBという報告もある。ライセンスは独自で、2,000万ドル超の収益とAPI提供を同時に満たす場合のみ別契約が必要になる。ベンチマークはツール利用が強く、コーディング系ではKimi K3などに劣る。多くの利用者はまずAPIで評価し、必要なら自前運用を検討する順序が合理的だ。
FAQ
Muse Spark Openを動かすのに必要なVRAMはどれくらいですか。
公式の目安はBF16で約2TB、NVFP4(4bit)で最低700GBです。FP8は重みだけで約816GBと推定されます(当サイトの計算)。2bit級のGGUFなら合計約300GBのメモリに収まるという報告があります。
Mac Studio 1台やRTX 5090で動きますか。
4bit版(最低700GB)はMac Studio 512GB 1台には載らず、公式は2台構成(合計約1TB)をMLXで最適化しています。RTX 5090のような単体の消費者向けGPUでは、2bit級でも約300GBが必要なため現実的ではありません。
商用利用はできますか。
Muse Model Licenseの下で、利用、改変、ファインチューニング、蒸留、再配布、販売が認められています。「Built with Muse Spark Open」の表示が必要です。直近12か月で総収益が2,000万ドルを超え、かつ第三者へAPI提供する場合は、Metaへの通知と別途の契約が必要です。社内利用や自社製品への組み込みは対象外です。
APIの料金はいくらですか。
Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter、Together AIが提供していますが、トークン単価は確認できていません。各プロバイダーの料金ページで確認してください。
他のオープンウェイトより優れていますか。
Metaのモデルカードでは、エージェントのツール利用(MCP-Atlas 89.2)と有害依頼の拒否で強く、コーディング系ではKimi K3やGLM 5.3を下回ります。いずれも開発元の発表値で、独立した追試は確認できていないため、自社の用途で検証することをおすすめします。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ