Nanbeige4.3-33B 必要スペック早見表
Q4で約21GB、RTX 4090・Mac 48GB推奨【2026年版】
Nanbeige4.3-33B(密33B)は4bit(Q4_K_M)で約20.8GB、24GB GPUに短い文脈で載る。BF16は約66GB。量子化別サイズ、KVキャッシュ、GPU・Mac別の構成、ベンチマーク、Ollama・llama.cppでの使い方、トラブル対処まで解説。2026年10月公開。
Nanbeige4.3-33B は、Nanbeige LLM Lab が公開した総33.1B・全パラメータ稼働の密(dense)なオープンウェイトモデルで、4bit量子化(Q4_K_M)のファイルサイズは約20.8GB。RTX 3090・4090(24GB)に短めの文脈で載せられ、BF16の原本は約66GBで80GB級のGPUか96GB以上のMacが必要になる。 コンテキストは最大524,288トークン(512K)まで対応するが、KVキャッシュの分だけメモリが増えるため、長い文脈を使うなら余裕を見込む必要がある。
2026年10月下旬にHugging Faceで公開され、ライセンスはApache 2.0(商用利用可)。コーディングと、オフィス業務・エージェント作業(cowork)に強い約30Bクラスのモデルとして位置づけられている。本記事では、公開されているモデル構成とbartowskiのGGUFファイルサイズから必要スペックを整理する。ベンチマークは開発元の公表値で、独立した検証はまだ少ない(2026年10月26日時点)。
必要スペック早見表
| 量子化(bartowski GGUF) | ファイルサイズ | 必要メモリの目安 | 載せ方の例 |
|---|---|---|---|
| BF16 | 66.24GB | 72GB以上 | 80GB級GPU、Mac 96GB以上 |
| Q8_0 | 35.20GB | 40GB前後 | Mac 64GB、48GB級GPU |
| Q6_K | 29.02GB | 33〜36GB | RTX 5090(短い文脈)、Mac 48GB |
| Q5_K_M | 25.07GB | 28〜31GB | RTX 5090(32GB)、Mac 48GB |
| Q4_K_M(推奨) | 20.79GB | 24〜26GB | RTX 3090・4090(短い文脈)、Mac 48GB |
| IQ4_XS | 18.64GB | 21〜23GB | 24GB GPUで文脈に余裕を持たせる |
| Q3_K_M | 15.92GB | 19〜21GB | 24GB GPU、16GB GPU+一部オフロード |
| IQ3_XXS | 14.49GB | 17〜19GB | 16GB GPU+一部オフロード(品質低下あり) |
| Q2_K | 13.53GB | 16〜18GB | 16GB GPU+一部オフロード(品質低下あり) |
| IQ2_XXS | 10.07GB | 12〜14GB | 12GB GPU+RAMオフロード(品質は大きく低下) |
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。Nanbeige4.3-33Bもモデル一覧から選択できる。
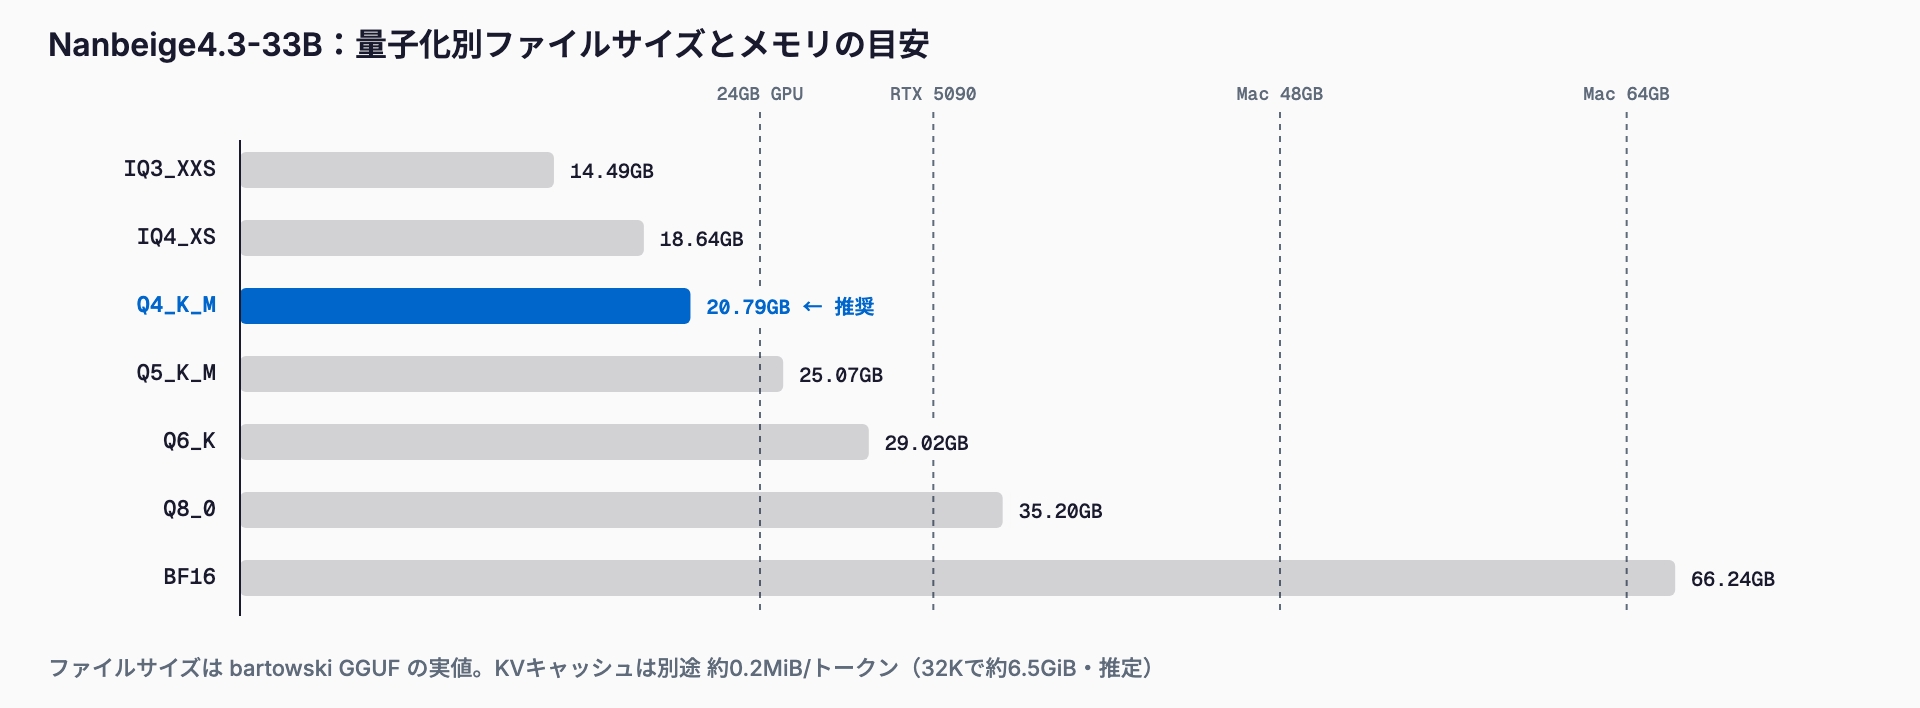
ファイルサイズはbartowskiのGGUFの値。「必要メモリの目安」はファイルサイズにKVキャッシュ(8K文脈で約1.6GiB)と実行時の作業領域を加えた推定で、実測ではない。文脈を長くするほど増えるため、下限に近い目安として扱ってほしい。
Nanbeige4.3-33Bとは
Nanbeige4.3シリーズのフラッグシップ(教師)モデルで、ベースモデルのNanbeige4.3-33B-Baseも同時に公開されている。従来は3Bクラスの Nanbeige4.1-3B・4.2-3B(ループ型トランスフォーマーのエージェントモデル)が中心で、今回は33Bまで拡大した形になる。MoEではなく密なモデルなので、1トークンごとに全パラメータを使う。同じファイルサイズのMoEより生成は遅くなりやすい点は覚えておきたい。
| 項目 | 内容 |
|---|---|
| リポジトリ | Nanbeige/Nanbeige4.3-33B(Base版もあり) |
| ライセンス | Apache 2.0(商用利用可) |
| 構造 | 密(dense)、LlamaForCausalLM |
| パラメータ数 | 計算上 約33.1B |
| 層数・隠れ次元 | 52層、hidden 7168、intermediate 22016 |
| アテンション | クエリ56ヘッド / KV 8ヘッド(GQA)、head_dim 128 |
| 語彙数 | 166,912(入出力埋め込みは非共有) |
| 重みの精度 | BF16 |
| コンテキスト長 | 最大524,288トークン(RoPE theta 1.2e8、スケーリングなし) |
| 思考モード | enable_thinking が既定でオン(Falseで非思考) |
パラメータ数は構成値からの計算で約33.1B。GQAでKVヘッドが8に絞られているため、33B級の密モデルとしてはKVキャッシュが軽い部類に入る。
コンテキスト長とKVキャッシュ
KVキャッシュは構成値から計算できる。FP16で 2(K・V)×52層×8ヘッド×128次元×2バイト=212,992バイトで、1トークンあたり約0.2MiB。以下は推定値で、実装による上乗せがある。KVキャッシュをq8_0にすると概ね半分になる。
| コンテキスト長 | KVキャッシュ(FP16) | KVキャッシュ(q8_0) |
|---|---|---|
| 8K | 約1.6GiB | 約0.8GiB |
| 32K | 約6.5GiB | 約3.3GiB |
| 64K | 約13GiB | 約6.5GiB |
| 128K | 約26GiB | 約13GiB |
| 512K | 約104GiB | 約52GiB |
Q4_K_M(20.8GB)に32KのFP16 KVキャッシュを足すと約27GBになり、24GBのGPUには載らない。24GBカードなら8〜16K程度に抑えるか、IQ4_XSとq8_0 KVキャッシュを組み合わせるのが現実的。512K全体を使う用途は、重みと合わせて100GB台後半が必要になる。KVキャッシュの仕組みはKVキャッシュとコンテキスト長のVRAM解説で詳しく扱っている。
GPU別・Apple Silicon別の構成目安
以下は上記のファイルサイズとKVキャッシュからの推定による目安で、実測ではない。
| 環境 | 載せ方の目安 |
|---|---|
| 12GB GPU | IQ2_XXS程度+RAMへオフロード。品質低下が大きく実用は厳しい |
| 16GB GPU | IQ3_XXS・Q2_Kで一部オフロード、または短い文脈。品質は下がる |
| RTX 3090・4090(24GB) | Q4_K_M+8〜16K文脈。文脈を稼ぐならIQ4_XS |
| RTX 5090(32GB) | Q5_K_M・Q6_Kを16〜32K、またはQ4_K_MをKVキャッシュq8_0で32K超 |
| 48GB級GPU | Q8_0が載る。長い文脈にも余裕 |
| 80GB級GPU | BF16の重みが載る。長い文脈は複数枚が必要 |
| Mac 32GB | Q4は厳しい(macOSがメモリを確保するため)。小さめの量子化向け |
| Mac 48GB | Q4・Q5が余裕を持って動く |
| Mac 64GB | Q8_0が載る |
| Mac 96〜128GB | BF16、または長い文脈 |
密な33Bは、同じファイルサイズのMoEより1トークンあたりの計算が重い。本記事では生成速度の数値を示していない(実測の裏付けがないため)。Mac向けにはMLX 4bit版も公開から1日以内に出ている。
ベンチマーク
以下は開発元が公表した値で、第三者による再現はまだ少ない。比較対象はQwen3.8-27B、Muse-Glimmer-30B、Gemma4-31B。
| ベンチマーク | Nanbeige4.3-33B | Qwen3.8-27B | Muse-Glimmer-30B | Gemma4-31B |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 80.9 | 73.0 | 61.8 | 47.2 |
| DeepSWE | 65.5 | 42.5 | 4.4 | 2.7 |
| SWE-Bench Pro | 60.3 | 61.7 | 36.9 | 51.2 |
| SkillsBench | 61.1 | 56.4 | 39.7 | 28.9 |
| Toolathlon-Verified | 70.4 | 68.5 | 47.2 | 27.8 |
| Claw-Eval(pass^3) | 78.3 | 75.2 | 57.3 | 44.2 |
| GDPval | 84.8 | 86.4 | 75.8 | 71.4 |
| GPQA Diamond | 89.5 | 89.2 | 83.5 | 91.3 |
| AIME 2026 | 95.2 | 94.5 | 94.7 | 89.2 |
| AA-LCR | 84.0 | 82.0 | 83.3 | 72.0 |
ターミナル操作やツール利用などエージェント系の指標で上回る一方、SWE-Bench ProとGDPvalはQwen3.8-27Bが、GPQA DiamondはGemma4-31Bが上になっている。比較モデルの必要スペックは、Qwen3.8-27B、Muse-Glimmer-30B、Gemma 4の各記事を参照してほしい。
使い方(llama.cpp・Ollama・vLLM)
GGUF版はllama.cppのb11845以降が必要。古いビルドでは読み込めない可能性がある。llama.cppでは、Hugging Faceから直接取得して起動できる。
llama-server -hf bartowski/Nanbeige_Nanbeige4.3-33B-GGUF:Q4_K_M -c 16384 -ngl 99Ollamaでは、hf.co のGGUFを指定して実行する。
ollama run hf.co/bartowski/Nanbeige_Nanbeige4.3-33B-GGUF:Q4_K_M公式の推論例はTransformers、SGLang、vLLMで、vLLMの例ではテンソル並列4・gpu-memory-utilization 0.8が使われている。BF16と長い文脈を前提に4枚のGPUを想定したレシピと読める。LM StudioとDocker Model Runnerでも動く。
vllm serve Nanbeige/Nanbeige4.3-33B --tensor-parallel-size 4 --gpu-memory-utilization 0.8推奨設定は次のとおり。
- 思考モード: enable_thinking は既定でオン。非思考にしたい場合はFalseにする
- preserve_thinking: 通常のチャットはFalse、複数ターンのツール利用・エージェント・オフィス作業ではTrueを推奨
- ツール呼び出し: tool_call_format="xml" を推奨(jsonも可)
- エージェント・ツール利用: temperature 1.0、top_p 0.95、max_new_tokens 65,536
- 推論・チャット: temperature 0.6、top_p 0.95、max_new_tokens 262,144
量子化の選び方
迷ったらQ4_K_M(20.79GB)が出発点になる。24GBのGPUで文脈を稼ぎたいならIQ4_XS(18.64GB)、32GBのGPUや48GBのMacで品質を優先するならQ5_K_M(25.07GB)かQ6_K(29.02GB)。Q3以下は容量の逼迫を逃れる手段で、思考の長いエージェント用途では精度低下の影響が出やすい。量子化の種類ごとの違いはGGUF量子化ガイドに、実行ツールの選び方はOllamaとLM Studioの比較にまとめている。
FP8、NVFP4、EXL3、AutoRound W4A16などのコミュニティ量子化も公開から1日以内に多数出ている(派生リポジトリは約89件)。ただし品質は配布者ごとに異なるため、最初は公式の評価に近いBF16と、広く使われているGGUFから試すのが安全。
トラブルシューティング
- メモリ不足(OOM): コンテキスト長を下げる、KVキャッシュをq8_0にする、一段小さい量子化にする、の順に試す。GPUに載り切らない分は -ngl を下げてCPUへ逃がせるが速度は落ちる
- モデルが読み込めない: llama.cppがb11845より古い可能性が高い。最新版に更新する
- 思考が長すぎる: enable_thinking=False で非思考にするか、max_new_tokens を制限する。推論用の262,144は上限が非常に大きい
- ツール呼び出しが安定しない: tool_call_format="xml" を使い、エージェント用途ではtemperature 1.0・top_p 0.95、preserve_thinking=True に揃える
- 複数ターンで文脈が崩れる: preserve_thinking の設定を用途に合わせる(チャットはFalse、エージェントはTrue)
FAQ
Nanbeige4.3-33Bは24GBのGPUで動きますか?
Q4_K_M(20.79GB)なら、RTX 3090・4090の24GBに短めの文脈(8〜16K程度)で載る見込み。IQ4_XS(18.64GB)にすると文脈に余裕が出る。これらはファイルサイズからの推定で、環境により異なる。
BF16で動かすにはどのくらい必要ですか?
重みだけで約66GB。KVキャッシュと作業領域を加えると72GB以上が必要で、80GB級のGPUか96GB以上のMacが目安。公式のvLLM例はテンソル並列4で、長い文脈を使う前提の構成。
Ollamaで使えますか?
Hugging FaceのGGUFを指定して使える。例: ollama run hf.co/bartowski/Nanbeige_Nanbeige4.3-33B-GGUF:Q4_K_M。llama.cppはb11845以降が必要で、Ollamaが取り込む内部のllama.cppが新しいかも確認したい。
商用利用はできますか?
ライセンスはApache 2.0で、商用利用が可能。利用前に最新のライセンス表記をHugging Faceのモデルカードで確認してほしい。
最大の文脈長は?KVキャッシュはどれくらい増えますか?
最大524,288トークン。FP16のKVキャッシュは1トークンあたり約0.2MiBで、32Kで約6.5GiB、128Kで約26GiB、512Kで約104GiB(いずれも推定)。q8_0にすると概ね半分になる。
ベンチマークの結果は信頼できますか?
本記事の数値はすべて開発元の公表値で、独立した検証はまだ少ない。SWE-Bench ProやGDPvalではQwen3.8-27Bが、GPQA DiamondではGemma4-31Bが上回るなど、項目ごとに優劣が分かれる。自分の用途で試すのが確実。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ