Holo4 必要スペック早見表
35B-A3BはVRAM約20GB(4bit)/Apache-2.0で商用可【2026年版】
Holo4-35B-A3B(Apache-2.0)の必要VRAMを推定で解説。4bitは約20GB、BF16は約80GBでRTX 4090/5090や32GB Macが目安。27Bは非商用。vLLM・GGUFでの使い方、API費用、安全な運用、メモリ不足(OOM)の対処も整理。2026年10月更新。
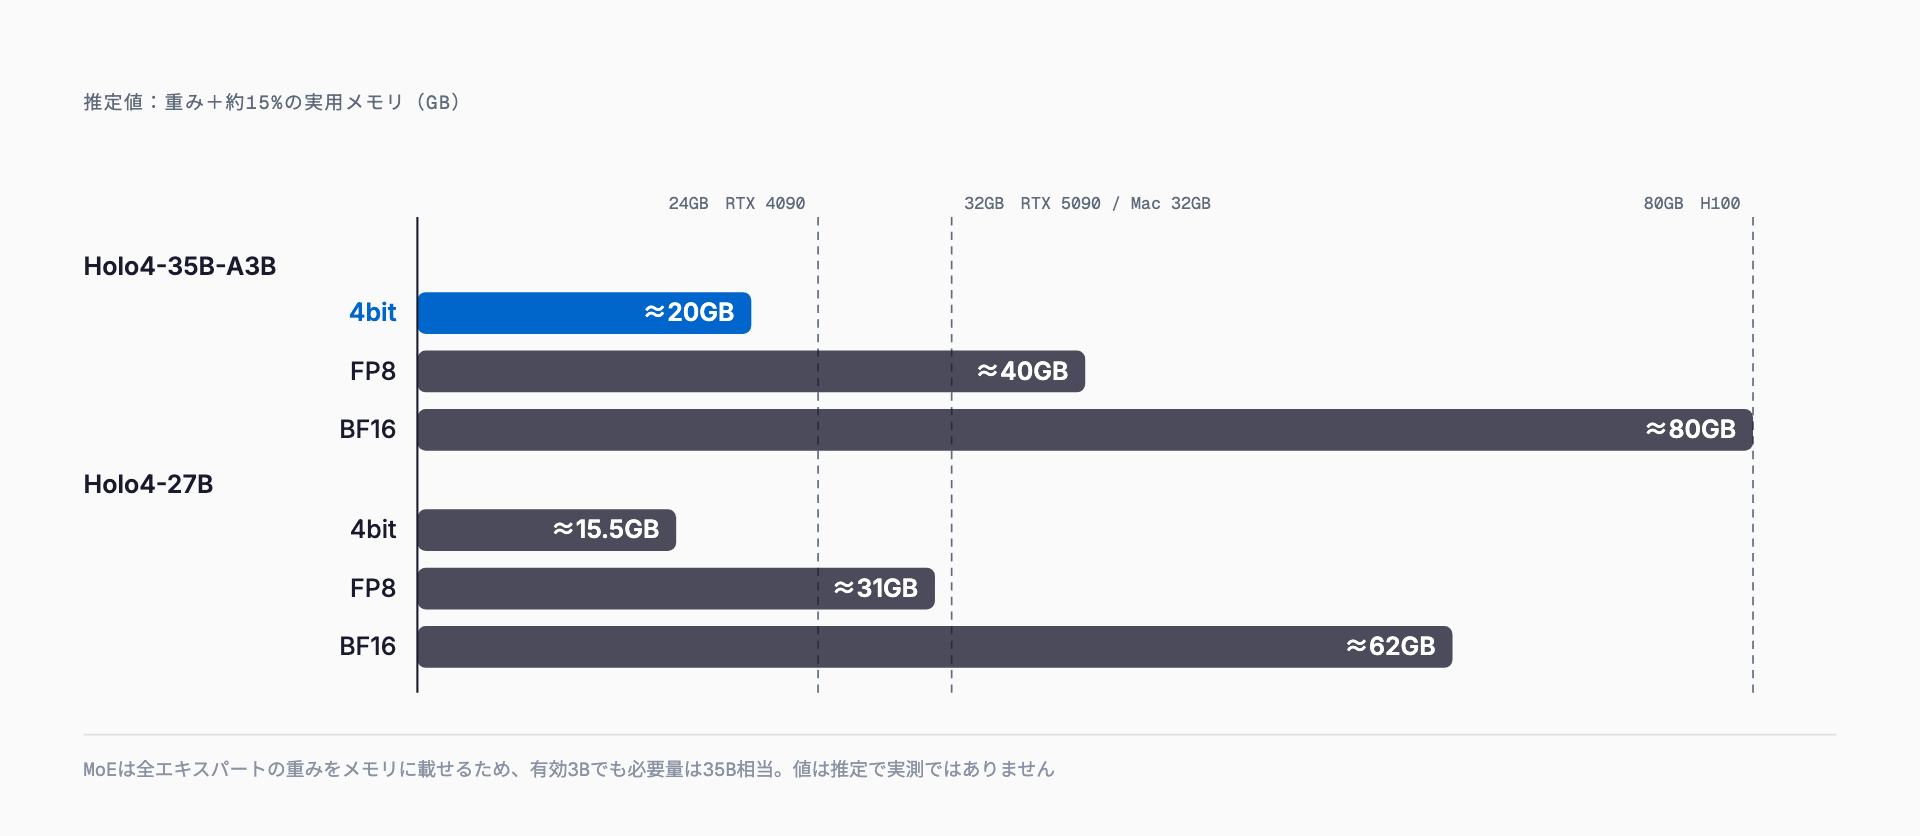
Holo4-35B-A3Bは、画面を見てPCを操作するcomputer-use(PC操作)向けのオープンウェイトモデルで、4bit量子化なら必要メモリは推定20GB前後。 RTX 4090(24GB)やRTX 5090(32GB)、あるいは32GB以上のユニファイドメモリを積んだMacで動かせる見込みだ。BF16のままなら推定80GB前後で、H100 80GBクラスが必要になる。H Company(フランス)が2026年9月28日にHugging Faceで公開し、ライセンスはApache-2.0で商用利用できる。
ただし、VRAMやメモリ要件は公式に明記されていない。本記事の数値はすべて推定値であり、「パラメータ数 × 1パラメータあたりのバイト数 + 約15%(KVキャッシュ・アクティベーション等の余裕)」で算出している。計算の根拠は各表に示した。computer-useは画面のスクリーンショットを何枚も積み上げながら長いステップを実行するため、文章生成より多めの余裕を見ておく必要がある。
必要スペック早見表
Holo4-35B-A3B(MoE、総35B・活性約3B)と、比較用のHolo4-27B(dense)の推定値を以下にまとめる。「重みのみ」は パラメータ数 × バイト数、「実用目安」はそこに約15%を上乗せした値である(いずれも推定)。
| モデル | 精度 | 重みのみ(推定) | 実用目安(推定) | 目安の環境 |
|---|---|---|---|---|
| Holo4-35B-A3B | BF16(2バイト/param) | 約70GB | 約80GB | H100 80GB、または複数GPU |
| Holo4-35B-A3B | FP8(1バイト/param) | 約35GB | 約40GB | A6000 48GB、RTX 6000 Ada 48GB |
| Holo4-35B-A3B | 4bit(0.5バイト/param) | 約17.5GB | 約20GB | RTX 4090 24GB、RTX 5090 32GB、32GB Mac |
| Holo4-27B | BF16 | 約54GB | 約62GB | 80GBクラス、または複数GPU |
| Holo4-27B | FP8 | 約27GB | 約31GB | RTX 5090 32GB(余裕は小さい)、48GB GPU |
| Holo4-27B | 4bit | 約13.5GB | 約15.5GB | 16GB GPUはぎりぎり、24GB GPUが無難 |
4bit列は実際のGGUF(Q4系)がレイヤーごとに異なるビット幅を使うため、実ファイルは上記より数GB大きくなることがある。ダウンロード前に配布ファイルの実容量を確認してほしい。さらに、スクリーンショットを画像トークンとして長く保持する運用では、コンテキストが伸びるぶんKVキャッシュも増える。
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。Holo4もモデル一覧から選択できる。
Holo4とは
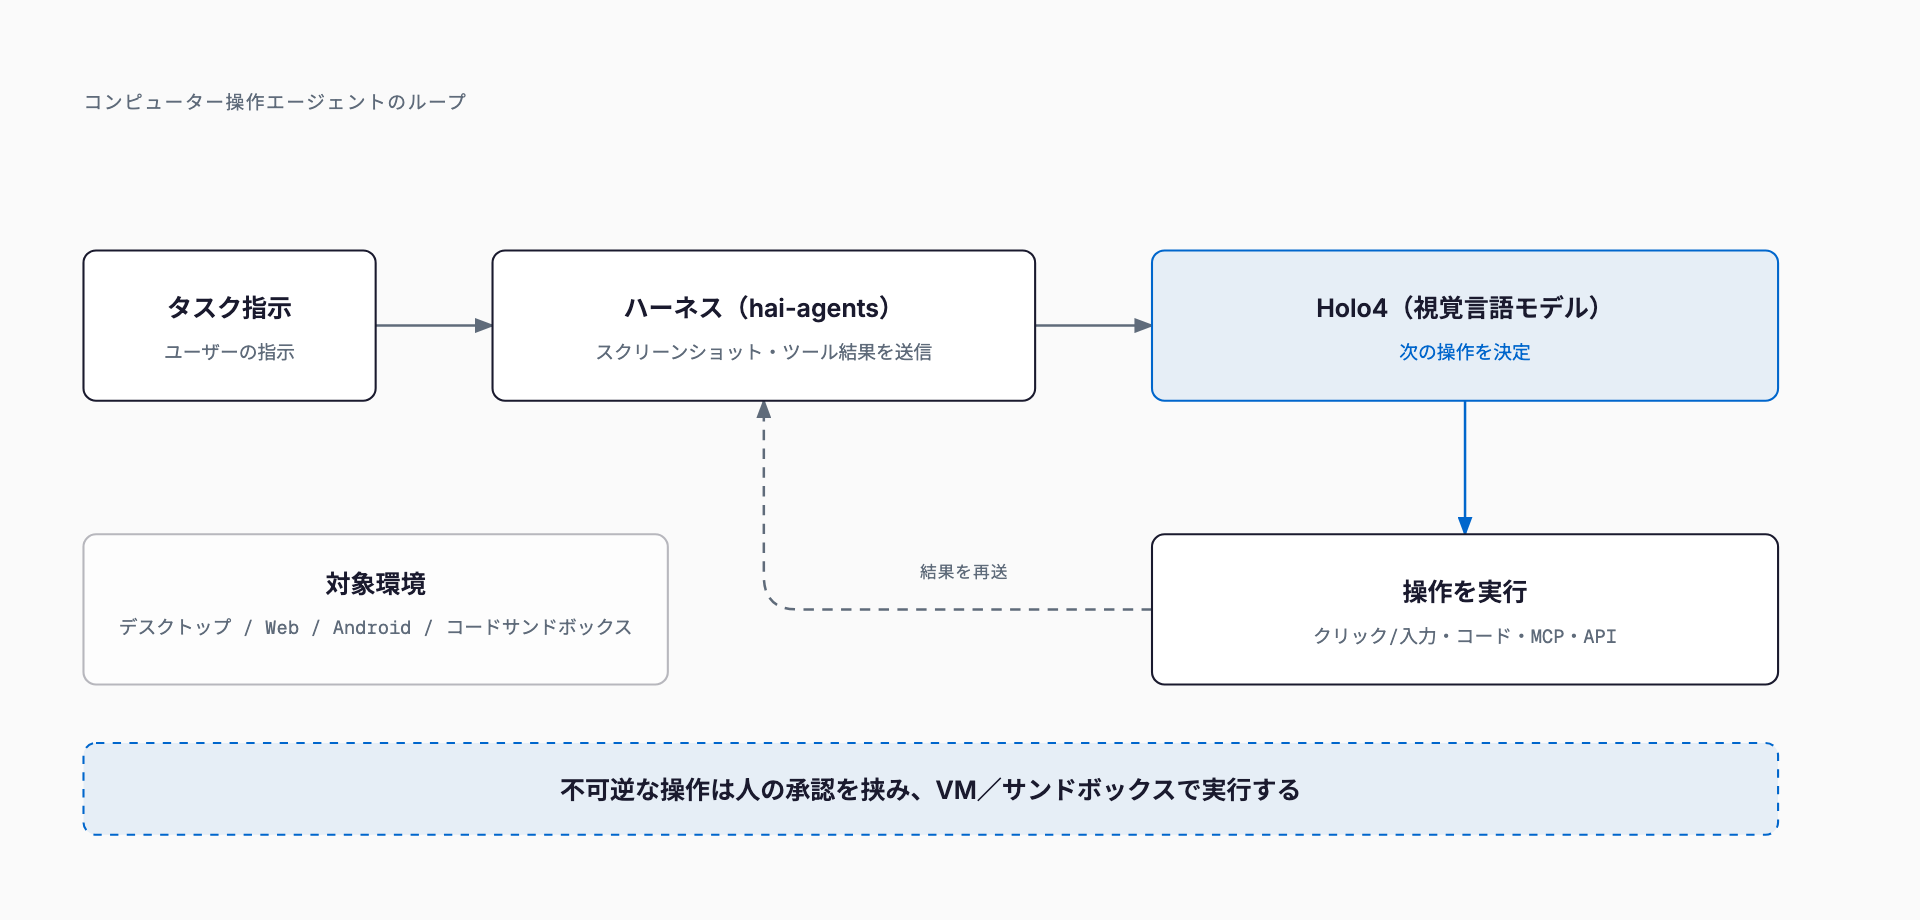
Holo4は、H Companyが公開したcomputer-use向けのビジョン・ランゲージモデル群である。画面のスクリーンショットを入力に、クリックやキー入力といったGUI操作を出力するだけでなく、コード実行、MCP、APIの呼び出しも使い分けられる。対象環境はデスクトップ、Web、Android、コードのサンドボックスと幅広い。H Company自身のエージェント実行基盤「hai-agents」を前提に設計されており、ハーネスがスクリーンショットやツールの結果をモデルへ渡し、モデルの出力した行動を実行する。
| 項目 | Holo4-35B-A3B | Holo4-27B |
|---|---|---|
| 構造 | MoE(総35B/活性約3B) | dense(27B) |
| ベース | Qwen/Qwen3.6-35B-A3Bをファインチューニング | Qwen3.8 27Bベース |
| ライセンス | Apache-2.0(商用利用可) | CC BY-NC 4.0(非商用) |
| 商用で使う場合 | そのまま自社運用できる | H Models API経由 |
| コンテキスト長 | 262,144トークン(256K) | 262,144トークン(256K) |
| 配布形式 | BF16/FP8/NVFP4/Q4 GGUF | 同左 |
最も注意すべきは、27Bの方が高性能なのにライセンスが非商用(CC BY-NC 4.0)である点だ。 業務で使うなら、自社運用できるのは35B-A3B(Apache-2.0)であり、27Bを商用で使うにはH Models APIを経由する形になる。このほか、NVIDIA Nemotron 3 Nano Omniをベースにした「Holotron4-30B-A3B(Holotron4 Nano)」も同時に公開されているが、本記事では扱わない。
ベンチマーク(開発元の報告値)
以下は開発元が公表した数値であり、第三者による検証は確認できていない。1タスクあたりのコストも開発元の報告値である。
| ベンチマーク | Holo4-27B | Holo4-35B-A3B | Claude Opus 5.5 |
|---|---|---|---|
| OSWorld 2.0 | 61.7%($1.22/タスク) | 30.9%($0.61/タスク) | 81.8% |
| AutomationBench | 45.4%($0.05/タスク) | 34.5%($0.02/タスク) | 記載なし |
| OSWorld(v1) | 85.2%($0.08/タスク) | 記載なし | 記載なし |
読み取れるのは、27Bが35B-A3Bの約2倍のスコアを出している一方、1タスクあたりの費用も約2倍になっている点だ。OSWorld 2.0でOpus 5.5(81.8%)との差は大きく、35B-A3Bはあくまで「安く自社運用できる選択肢」という位置づけで考えるのが現実的である。自社の業務画面での成功率は、必ず自分たちで測ってほしい。
MoEなのに総35B分のメモリが要る理由
35B-A3Bは、推論1トークンあたりに活性化するパラメータが約3Bと小さい。そのため計算量は小さく、同じGPUでも速度が出やすい。だが、どのエキスパートが選ばれるかはトークンごとに変わるため、全エキスパートの重みをメモリ(VRAM)に置いておく必要がある。必要メモリを決めるのは活性パラメータではなく総パラメータ(35B)で、速度を決めるのが活性パラメータ(約3B)だ、と覚えておくとよい。
量子化は、重みの精度を下げてメモリを減らす手法である。BF16を1とすると、FP8でおよそ半分、4bitでおよそ4分の1になる。4bitでは品質劣化が出ることがあるが、computer-useでは画面上の小さなボタンの位置を正確に当てる必要があるため、座標精度に影響が出ないか実際の画面で確かめたい。量子化の考え方そのものは、Gemma 4の必要スペック記事でも詳しく説明している。
GPU別・Apple Silicon・CPUオフロード
以下は上の推定値にもとづく可否の目安である。実測ではないため、余裕を持って選んでほしい。
| 環境 | メモリ | 35B-A3B 4bit(約20GB) | 備考 |
|---|---|---|---|
| RTX 4070 Ti SUPER等 16GB | 16GB | 載らない | CPUオフロードが前提。27B 4bitなら可 |
| RTX 4090 | 24GB | 載る(余裕は小) | スクリーンショットを溜めるとKVで逼迫しやすい |
| RTX 5090 | 32GB | 余裕あり | 27B FP8も視野に入る |
| A6000 / RTX 6000 Ada | 48GB | 余裕あり | 35B-A3B FP8(約40GB)が載る |
| H100 | 80GB | BF16(約80GB)はぎりぎり | 長コンテキストは余裕が小さい |
- Apple Silicon: ユニファイドメモリがそのままVRAMの制約になる。32GBでは4bit(約20GB)が動くが、OSや他のアプリと競合するため、実用的には48GB以上が望ましい。64GB以上あればFP8(約40GB)も視野に入る。
- CPUオフロード: llama.cpp系ではレイヤーの一部をCPU側のRAMに逃がせる。MoEは活性パラメータが小さいため、dense 27Bより低速化の影響が小さい見込みだが、computer-useは1ステップごとに画像を処理するため、対話的な速度は期待しにくい。
- CPUのみ: バッチ的な用途以外はおすすめしない。スクリーンショットの処理が重く、1ステップの待ち時間が長くなる。
使い方:vLLM・SGLang・GGUF・Docker
公式の案内にある起動方法をまとめる。いずれもOpenAI互換のAPIとして起動し、エージェント側のハーネスから呼び出す形になる。vLLMの例は以下のとおり。
pip install vllm
vllm serve "Hcompany/Holo4-35B-A3B"
# OpenAI互換API: http://localhost:8000/v1
SGLangを使う場合は次のとおり。
python3 -m sglang.launch_server \
  --model-path "Hcompany/Holo4-35B-A3B" \
  --host 0.0.0.0 --port 30000
Docker Model Runnerなら1行で起動できる。Transformersで直接読み込む場合は、AutoProcessorとAutoModelForMultimodalLMを使い、device_map="auto"を指定する。
docker model run hf.co/Hcompany/Holo4-35B-A3BQ4のGGUFが配布されているため、llama.cpp、Ollama、LM Studioでも読み込める。画像(スクリーンショット)を入力に使う場合は、GGUFでも画像側の投影ファイルが別途必要になることがあるので、各ツールのマルチモーダル対応の手順を確認してほしい。ローカル推論エンジン全般の選び方は、Qwen3.8-27Bの必要スペック記事も参考になる。
API利用とローカル運用のコスト比較
H Companyは「H Models API」を提供している。OpenAI互換のエンドポイント(https://api.hcompany.ai/v1)で、料金は入力$0.30/出力$2.00(いずれも100万トークンあたり)と報じられている(報道ベースで、公式ページでの確認が望ましい)。
| 方式 | 初期費用 | 変動費 | 向いている場面 |
|---|---|---|---|
| H Models API | なし | 従量課金 | まず試す、27Bを商用で使う、利用が散発的 |
| ローカル運用(35B-A3B) | GPUまたはMacの購入 | 電気代・運用の手間 | 画面データを社外に出したくない、常時大量に回す |
目安として、1タスクで入力20万トークン・出力2万トークンを使うと仮定すると、API料金は 0.2M×$0.30+0.02M×$2.00=約$0.10(仮定にもとづく試算)になる。社内の業務画面を外部に送れない場合はローカル一択だが、そうでなければ最初はAPIで成功率とトークン量を測り、そのうえで機材を買うか判断する順序が無駄が少ない。
既存モデルとの違い
| 項目 | Holo4-35B-A3B | Holo4-27B | Qwen3.6-35B-A3B(ベース) | Claude Opus 5.5(API) |
|---|---|---|---|---|
| 位置づけ | computer-use特化の派生 | computer-use特化(dense) | 汎用モデル(派生元) | クローズドなAPIモデル |
| ライセンス | Apache-2.0 | CC BY-NC 4.0 | 派生元(本記事では未確認) | 商用API |
| OSWorld 2.0 | 30.9% | 61.7% | 記載なし | 81.8% |
| 自社運用 | 可 | 非商用のみ | 可(想定) | 不可 |
Holo4-35B-A3Bは、汎用モデルのQwen3.6-35B-A3Bをcomputer-use向けに追加学習した派生モデルである。同じ土俵の汎用モデルと比べてGUI操作に特化している点が違いだが、本記事ではベース側のベンチマーク数値を確認できていないため、直接の優劣は断定しない。computer-useをクラウドのデスクトップアプリとして使う方法は、Manus Studioのデスクトップアプリ解説も参考になる。
使う際の注意点
computer-useは、モデルが実際にマウスやキーボードを操作する。誤操作はそのまま業務データやアカウントに影響するため、運用上の注意が通常のチャットよりはるかに重い。
- サンドボックスやVMで動かす: 本番の業務PCではなく、使い捨てのVMやコンテナ上のデスクトップで実行する。
- 不可逆な操作は人間の承認を挟む: 削除、送信、購入、送金などは、実行前に人が確認する。
- 権限を最小にする: 専用アカウントを使い、必要なサイトとファイルにだけ触れるようにする。
- 画面上の指示を鵜呑みにさせない: Webページやメール内の文言(プロンプトインジェクション)に従って操作してしまうリスクがあるため、重要な操作の前に確認を入れる。
- ログを残す: 各ステップのスクリーンショットと行動を保存し、後から追えるようにする。
トラブルシューティング(メモリ不足)
- 起動時にOOMになる: 量子化を一段下げる(BF16→FP8→4bit)。または35B-A3Bから27B 4bitに変える。
- 途中のステップでOOMになる: スクリーンショットの蓄積でKVキャッシュが増えている可能性が高い。コンテキスト長を短く設定し、古いステップの画像を破棄する。
- スクリーンショットの解像度を下げる: 画像トークンが減り、メモリと速度の両方が改善する。ただし小さい文字やボタンの判別精度が落ちるため、実画面で確認する。
- ほかのGPU利用アプリを閉じる: ブラウザのハードウェアアクセラレーションなども、VRAMを数百MB単位で消費する。
- CPUオフロードで極端に遅い: GPUに載せるレイヤー数を増やす、または機材のメモリを増やす。
- Macで他アプリと競合する: 32GB機では4bitがぎりぎりのため、他のアプリを閉じるか、より小さい構成を選ぶ。
まとめ
Holo4-35B-A3Bは、Apache-2.0で商用利用できるcomputer-use向けのオープンウェイトモデルで、4bit量子化なら推定20GB前後(RTX 4090/5090、32GB以上のMac)、BF16なら推定80GB前後で動く。27Bはスコアが高いが非商用ライセンスで、商用ならH Models API経由になる。VRAMは公式に明記されておらず、本記事の数値はすべて推定である。まずはAPIまたは4bitで自社の業務画面の成功率を測り、サンドボックスで安全に運用する、という順序で導入を進めてほしい。
よくある質問
Holo4-35B-A3Bの必要VRAMはどのくらいか?
公式には明記されていないため推定になる。総パラメータ35Bに対し、4bit(0.5バイト/param)で約17.5GB、約15%の余裕を加えて約20GB。FP8で約40GB、BF16で約80GBが目安だ。computer-useはスクリーンショットでコンテキストが伸びやすいため、余裕を多めに見てほしい。
Holo4は商用利用できるか?
35B-A3BはApache-2.0で商用利用できる。一方、27BはCC BY-NC 4.0(非商用)で、商用で使う場合はH Models API経由になる。27Bのスコアの方が高いが、ライセンスの違いに注意が必要だ。
RTX 4090(24GB)でHolo4-35B-A3Bは動くか?
4bit量子化なら約20GBの推定なので動く見込みだが、余裕は小さい。スクリーンショットを多く保持するとKVキャッシュが増えて逼迫しやすい。コンテキスト長を短くする、画像解像度を下げるといった調整が有効だ。16GB GPUでは載らないため、27Bの4bitやCPUオフロードを検討する。
Ollamaで動かせるか?
Q4のGGUFが配布されているため、llama.cpp、Ollama、LM Studioで読み込める見込みだ。画像入力を使う場合は追加の投影ファイルが必要になることがある。公式の起動手順はvLLM、SGLang、Docker Model Runner、Transformersである。
computer-useモデルを安全に使うにはどうすればよいか?
本番のPCではなく、使い捨てのVMやコンテナ上で動かし、権限を最小にした専用アカウントを使う。削除・送信・購入などの不可逆な操作は必ず人が承認する。Webページ内の文言に従って誤操作するリスクもあるため、各ステップのログを残してほしい。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ