Janas-LLMとは — 32GB RAMで80B MoEをSSD経由で動かすC製エンジン【必要スペック】
Janas-LLMは重みをSSDに置き必要なMoEエキスパートだけを読み込むC製エンジン。RAM 32GBで80B級のQwen3-Nextが生成24トークン/秒で動作(作者実測)。必要スペック早見表、llama.cpp比較、導入手順と使い方、注意点、HNの評価まで解説します(2026年10月13日時点)。
Janas(Janas-LLM)は、MoE(Mixture of Experts)型の大規模言語モデルを、重みをSSDに置いたまま動かすC言語製のローカル推論エンジンです。トークンごとに必要なエキスパートだけをNVMe SSDから読み込み、よく再利用されるものをRAMにキャッシュする方式で、作者は「RAM 32GBのノートPCで800億パラメータ級のモデルが動く」と説明しています。GitHub(prabanta-dev/janas)で公開され、2026年10月13日にHacker Newsのフロントページ(143ポイント・48コメント)に載りました。
本稿では、公式リポジトリの記述と作者のベンチマーク、HNの議論に基づいて、Janasの仕組み、必要スペック早見表、llama.cppとの速度比較、導入手順、使い方、類似ツールとの違い、注意点を整理します。なお開発初期の実験的ソフトウェアで、数字はすべて作者が1台のマシンで測った値です。同じ発想のツールはcolibriやEdge0-35B-A3Bの記事でも扱っています。
Janasとは — SSDからエキスパートを流し込むC製エンジン
Janasは、外部ライブラリに依存せずC標準ライブラリだけで書かれたAIツール群で、最初のコンポーネントが推論エンジンのJanas-LLMです。作者はMaurizio “camauri” Cammalleri氏。GPUの有無を問わず、普通のPCで大型のMoEモデルを動かすことを目指しています。
仕組みの要点は2つです。1つ目は、モデルの重みをディスク上に置いたまま、トークンごとに必要なエキスパートだけをNVMe SSDからストリーミングすること。2つ目は、繰り返し使われるエキスパートをRAM上のキャッシュに残し、SSDへの読み込みを減らすことです。重みの読み込みにはO_DIRECTを使い、統合GPUがあればVulkanでプロンプト処理(prefill)を担当させ、スレッド数は自動調整されます。
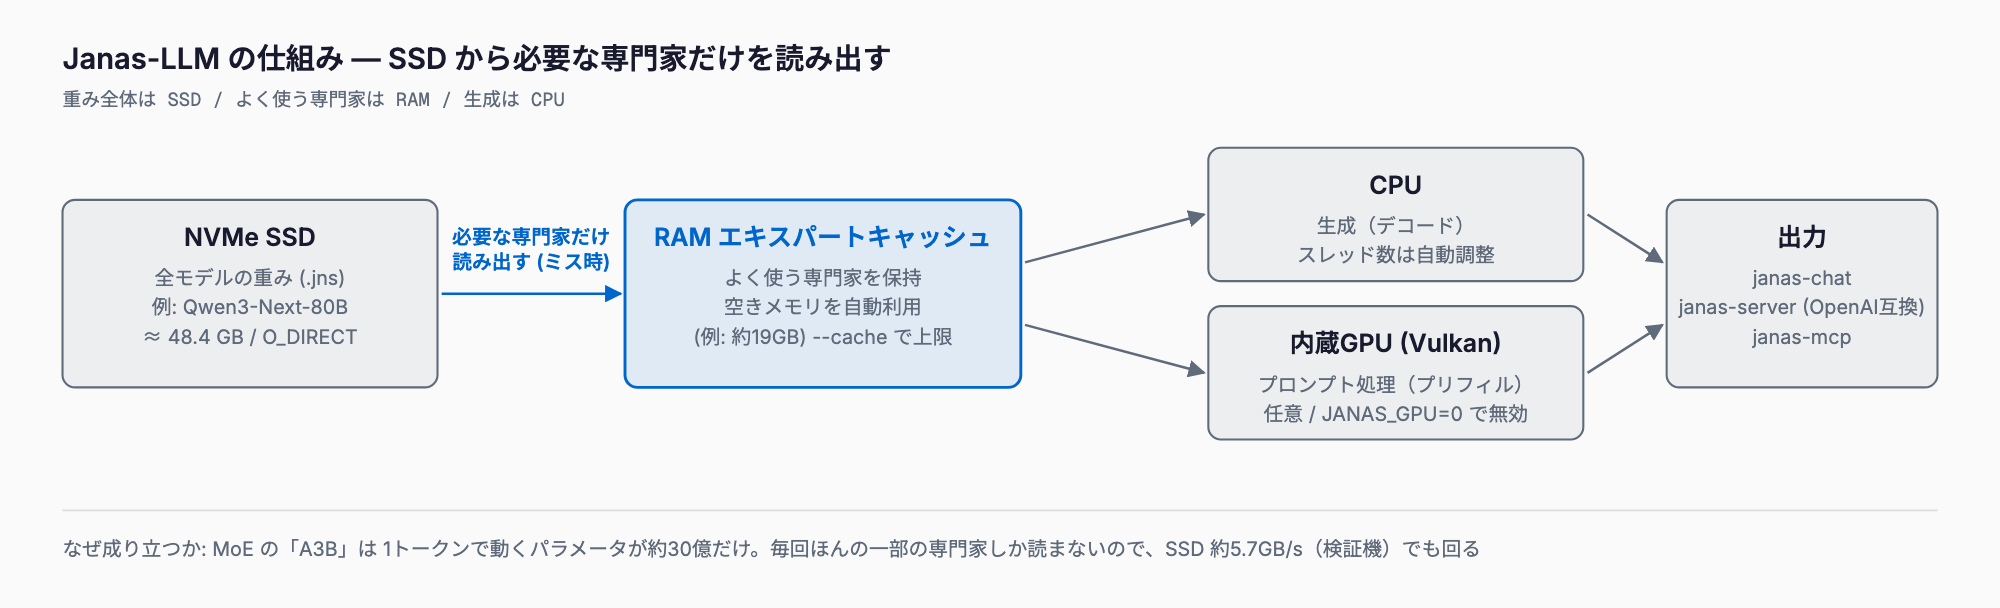
なぜMoEだと成立するのか
MoEモデルは、総パラメータ数が大きくても、1トークンの処理で実際に使うパラメータ(アクティブパラメータ)はごく一部です。たとえばQwen3-Next-80B-A3Bは総計80Bでも、1トークンあたりに動くのは約3B分(名前の「A3B」)です。そのため全体をRAMに載せなくても、必要な部分だけを都度SSDから取れば計算が成り立ちます。逆に、全パラメータを毎回使う通常(dense)モデルではこの手が使えません。
ここで性能を左右するのが、どのエキスパートをRAMに残すかというキャッシュの戦略です。HNでも、このアルゴリズムはモデル依存で重要だが未解決の領域だという指摘がありました。Janasは起動時に空きメモリをエキスパートキャッシュとして使い、--cache <GiB> で上限を指定できます。
必要スペック早見表
公式が明記している対応環境と、作者の検証環境を分けて整理します。「推奨」としている構成は作者の検証環境をもとにした目安で、それ以外の構成は動作未確認です。
| 項目 | 対応・要件 | 作者の検証環境 |
|---|---|---|
| OS | Linux x86-64(Ubuntu 22.04、Debian 12以降)、Windows 10(1903以降)/ 11 x86-64 | Debian 13(カーネル6.12) |
| CPU | x86-64(AVX-VNNIなしは未検証) | Intel Core Ultra 9 185H |
| RAM | 80B級(約48.4GB)で32GB・キャッシュ約19GB | 32GB DDR5 |
| ストレージ | NVMe SSD(読み出し速度が性能に直結) | 1TB NVMe(約5.7GB/s) |
| GPU | 任意(なしでも動作)。Vulkan対応の統合GPUはprefillに利用 | 内蔵Arc GPU(Mesa 26.1 Vulkan) |
| ビルド環境 | GCC 14.2(ソースから作る場合) | GCC 14.2 |
macOS・Apple Siliconは対応環境に挙げられておらず、ARMへの言及もありません。AMD CPU、単体GPU、より遅いディスク、AVX-VNNIのないCPUは作者が試していない構成です。モデルは変換済みの.jns形式で、Qwen3、Qwen3.5、Qwen3.6、Qwen3-Next、Qwen3-Coder-Next、Gemma 4の各ファミリーが用意されています。
ベンチマーク — llama.cpp(Vulkan)との速度比較
作者は、1,024トークンのプロンプトを読み込んでから生成する条件で、Janasとllama.cpp(Vulkanビルド 2b18470、Q4_K_M)を比較しています。測定は2026年10月9〜11日(Windowsは10月12日)で、数値はtokens/秒です。read=プロンプト読み込み、write=生成です。
| モデル | read Janas / llama.cpp | write Janas / llama.cpp |
|---|---|---|
| Qwen3-Next-80B-A3B(48.4GB) | 62 / 16 | 24 / 2.8 |
| Qwen3-Coder-Next(48.4GB) | 66 / 14 | 22 / 2.2 |
| Qwen3.6-35B-A3B | 104 / 79 | 19 / 12 |
| Qwen3-30B-A3B | 135 / 122 | 32 / 15 |
| Gemma-4-26B-A4B-it | 84 / 76 | 18 / 12 |
| Gemma-4-12B-it | 65 / 46 | 9.9 / 7.1 |
| Qwen3.5-9B | 111 / 78 | 14 / 8.7 |
| Gemma-4-E4B-it | 122 / 109 | 20 / 15 |
| Qwen3-4B | 193 / 164 | 27 / 18 |
| Gemma-4-E2B-it | 191 / 150 | 38 / 19 |
| Qwen3.5-2B | 441 / 323 | 52 / 28 |
| Qwen3.5-0.8B | 799 / 519 | 109 / 32 |
| Qwen3-0.6B | 939 / 670 | 130 / 45 |
48.4GBの80B級モデルでは、生成がJanasで24 tokens/s、llama.cppで2.8 tokens/sと大きな差が出ています。RAMに収まる小型モデルでは差は縮まります。例外として、Qwen3-30BのUD-Q3_K_XL量子化では読み込みはJanasのほうが遅い(100対112)一方、生成は約3倍速い(36対11)という結果でした。
比較には注意点があります。Qwen3-Next-80Bはllama.cppの標準ビルドではエキスパートをCPUに置いてもメモリ不足になり、GGML_CPU_REPACK=OFFと --no-host 1 -lm mmap を付けてようやく動いた一方、Janasは追加オプションなしで動きました。また1台のマシンでの比較であり、測定方法も完全には揃っていません。
推測デコード(ドラフト)をchatで有効にすると、生成はさらに伸びます。Qwen3-Next-80B-A3Bで37 tokens/s(なしは22)、Qwen3.6-35B-A3Bで34、Gemma-4-26B-A4Bで26、Qwen3.5-9Bで24 tokens/sでした。受理率はQwen系と大きめのGemmaで74〜89%です。
導入手順
バイナリ配布を使うのが最短です。Linuxは最新リリースから janas-linux-x86_64.tar.gz を取得して展開し、janas-chat を起動します。
tar xzf janas-linux-x86_64.tar.gz
cd janas
./janas-chat
Windowsは janas-windows-x86_64.zip を展開し、PowerShellで次のように起動します。
.\janas-chatソースからビルドする場合は、build-essentialが必要です(GPUを使うなら libvulkan-dev、glslang-tools、vulkan-tools も任意で追加)。出力は bin/x86_64-linux/ に作られます。
./build.sh
# テスト付きリリースビルド
./build.sh release test
モデルは、Hugging Faceのprabanta-devで配布されている変換済み.jnsを使います。janas-chat上で一覧表示、ダウンロード、検証ができ、単独の janas-get も使えます。自分でGGUFから変換することも可能です。書き込みは ~/.cache/janas と指定した出力先だけで、GPUを無効化したいときは環境変数 JANAS_GPU=0 を設定します。
使い方 — chat・server・mcp・bench
| ツール | 役割 |
|---|---|
| janas-chat | 対話CLI。--draft / --mtp で推測デコード、MCPツール利用、天気・航空便・地震・地図・価格・GitHub・git・Wikipediaの内蔵サービス。Ctrl-Cで停止、Ctrl-Dで終了 |
| janas-mcp | モデルをツールとしてClaude Codeやエディタ、MCPクライアントに提供 |
| janas-server | OpenAI互換のHTTP API、ブラウザチャット、コード補完(/v1/completions のsuffix対応と、llama.cpp互換の /infill。VS Code / VSCodium向け) |
| janas-bench | 速度レポートを書き出す |
| ライブラリ | CとFreeBASICから利用可能。hf2jns_mtpなどの変換ツールも同梱 |
Claude Codeなどとの連携は、janas-mcpでローカルモデルをMCPツールとして呼び出す形になります。ローカルのモデルを調べ物や下書きに回し、判断が必要な部分は手元のエージェント本体に任せる、といった使い分けが現実的です。OpenAI互換APIが必要なツールにはjanas-serverを使います。
メモリとディスクの使い方
エキスパートキャッシュは、モデルを開く時点の空きメモリを使います。48.4GBのQwen3-Next-80Bを32GBのノートPCで動かしたときは、約19GBがキャッシュに回りました。ブラウザとエディタを開いたままだと速度は約3/4に維持された一方、ディスク待ちは5倍に伸びたと作者は報告しており、アイドル状態のマシンでの利用を勧めています。
llama.cpp・colibri・Edge0との違い
同系統のGPU中心の推論エンジンとして、StrataのようにVRAMとRAMを階層で使い分ける方式もあります。Janasは「GPUがなくてもSSDが速ければ大型MoEを動かす」という方向で、狙いどころが異なります。
注意点 — 向いている人・向かない人
- 実験段階: 開発初期で、APIとCLIは予告なく変わり、週に数回変わることもあります。例外は.jns形式バージョン2で、Hugging Faceのモデルは読めなくならないよう維持される方針です。正式な版番号もありません。
- 安定性は未検証: 作者自身が安定性は検証していないと明記しています。メモリとディスクを積極的に使うため、デスクトップがスワップに入ることがあり、GPU使用中にドライバがリセットされて画面が固まった例もありました。
- SSDの速度が効く: 検証は約5.7GB/sのNVMeのみです。遅いディスクでは大きく落ちると予想されます。S3のようなリモートストレージは遅すぎます(HNでの指摘)。
- エージェント用途は要検討: prefillが60 tokens/s前後(80B級)だと、入力トークンが膨大になるエージェント作業には厳しいという意見がHNでありました。
- Macは未対応: macOS / Apple Siliconは対応環境として挙げられていません。
- ライセンス: 本体はGPL-3.0-or-later。GNU libmicrohttpd(LGPL 2.1以降)、yyjson(MIT)、HTTPS MCP用のMbed TLSを同梱します。変換済みモデルは元のライセンスを引き継ぎます(MODELS.md)。
向いているのは、RAM 32GB前後・NVMe搭載のx86-64 PCで、普段使いと切り離して大型MoEを試したい人です。常用のメインマシン、Mac、エージェントで長大な入力を扱う用途、安定性が必須の本番用途には、現時点では向きません。
Hacker Newsでの評価
- 「llama.cppのmmapがすでにやっていることの再発見ではないか」という指摘。
- 一方で、特定のケースでは大きな高速化が出ているという評価。
- 約60 tokens/sのprefillがエージェント用途で足りるかについて議論。エージェントは桁違いに多くの入力トークンを消費します。
- エキスパートキャッシュのアルゴリズムは、モデル依存で重要だが未解決の領域だという見方。
- ドキュメントの質への批判。
よくある質問
MacやApple Siliconで動きますか?
現時点では動作対象に含まれていません。公式の対応環境はLinux x86-64(Ubuntu 22.04、Debian 12以降)とWindows 10(1903以降)/ 11 x86-64で、macOSやARMへの言及はありません。Apple Siliconで同種の方式を試したいなら、MLX向けのEdge0-35B-A3Bなどがあります。
SSDが劣化しませんか?
Janasが行うのは主に読み込みで、SSDの寿命を縮める主因は書き込みです。そのため通常の読み込み中心の運用で大きく劣化する可能性は低いと考えられますが、作者はこの点を検証していません。注意すべきは、メモリ不足でスワップが頻発した場合で、スワップは書き込みを伴います。キャッシュ上限は --cache <GiB> で抑えられます。
何GBのRAMが必要ですか?
モデル次第です。作者の検証では、48.4GBのQwen3-Next-80Bを32GBのノートPCで動かし、約19GBをエキスパートキャッシュに使いました。RAMが少ないほどSSDからの読み込みが増えて遅くなります。小型モデルはRAMに収まるため、より少ないメモリでも動きます。
商用利用できますか?
Janas本体はGPL-3.0-or-laterで、ソースの提供などGPLの条件に従えば商用利用も可能です。ただしモデルは別で、変換済みの.jnsは元モデルのライセンスを引き継ぎます(MODELS.md参照)。Qwen系・Gemma 4系それぞれの条件を確認してください。
llama.cppと何が違いますか?
作者のベンチマークでは、RAMに収まる小型モデルでは差が小さく、RAMを超える80B級でJanasが大きく上回りました(生成24対2.8 tokens/s)。ただし1台のマシンでの比較で、llama.cppは広い環境で安定して動く汎用ツールです。
GPUがなくても使えますか?
使えます。GPUの有無を問わず動作し、JANAS_GPU=0 で無効化もできます。統合GPUがあればVulkanでprefillを処理しますが、作者の検証では統合GPU(Arc)のみで、単体GPUは未検証です。
まとめ
Janasは、MoEの「1トークンで使う部分は少ない」性質を利用し、エキスパートをSSDから流し込んでRAMを超えるモデルを動かすC製エンジンです。作者の1台のマシンでは、32GB RAMで48.4GBのQwen3-Next-80Bが生成24 tokens/s(推測デコードで37)で動き、同条件のllama.cppを大きく上回りました。一方で、実験段階であること、検証が1台のみであること、macOS非対応、prefill速度とGPL-3.0という条件は押さえておく必要があります。まずは使っていないx86-64マシンで、小さめのモデルから試すのが無難です。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ