Kimi K3.1 Pro 必要スペック早見表
2.8T MoEは4bitで約1.4TB(推定)・API料金は入力$2/出力$10【重み11/4公開予定・2026年版】
Kimi K3.1 Proの必要スペックを整理。約2.8T MoEは4bitで約1.4TB(推定)、API料金はK3より1/3安い入力$2/出力$10。重みは11月4日までに公開予定で数値は推定。2026年10月更新。
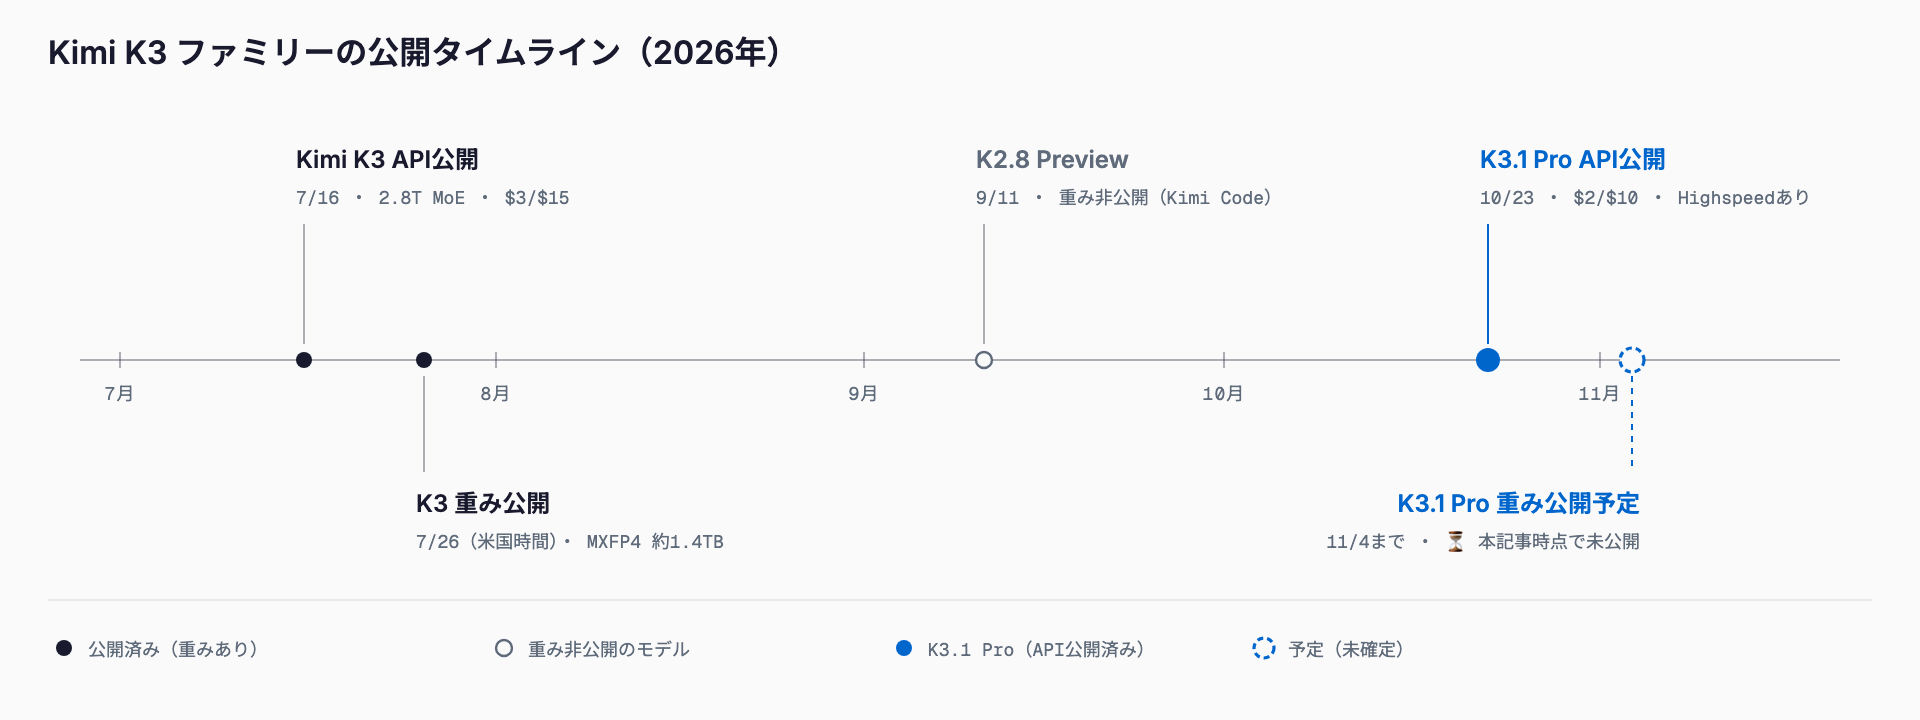
Kimi K3.1 Proは、Moonshot AIが2026年10月23日(米国時間)に発表した約2.8T(2.8兆)パラメータのMoE(Mixture of Experts)モデルで、7月に公開されたKimi K3のポストトレーニング強化版である。自前でホストする場合、4bit量子化でも重みだけで約1.4TB(推定)⏳重み公開待ち が必要で、実質的に複数ノードのGPUクラスタが前提になるため、ほとんどの利用者にとって現実的な選択肢は公式APIであり、料金は入力$2/出力$10(100万トークンあたり)である。
この記事で ⏳重み公開待ち と付けた値は、K3の公開値をもとにした推定であり、11月4日までに予定されている重みとモデルカードの公開後に確定値へ差し替える。一方、API料金やMoonshot自身が報告したベンチマークは公式発表の値で、マーカーは付けていない。前世代の整理は Kimi K3とは と Kimi K3 のweights公開と自前ホストの条件 も参照してほしい。
必要スペック早見表
| 精度 | 重みサイズ(推定) | 必要な構成の目安 | 確度 |
|---|---|---|---|
| BF16 | 約5.6TB | H100 80GB換算で70枚以上(理論値) | ⏳重み公開待ち |
| 8-bit | 約2.8TB | H100 80GB換算で35枚以上(理論値) | ⏳重み公開待ち |
| 4-bit(MXFP4想定) | 約1.4TB | K3では64枚のH100(8ノード、合計5.12TB)が実用上の下限 | ⏳重み公開待ち |
| 2-bit | 約700GB | 512GB Macを2台、またはH100 80GB換算で12〜16枚前後(理論値。品質・速度は未知) | ⏳重み公開待ち |
上記はパラメータ数2.8Tから算出した理論値で、実際にはKVキャッシュ、ルーティング、バッファ、画像エンコーダの分が加わる。
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。Kimi K3.1 Proもモデル一覧から選択できる(数値は重み公開前の推定)。
Kimi K3.1 Proの基本スペック
| 項目 | 値 | 確度 |
|---|---|---|
| 発表日 | 2026年10月23日(米国時間。日本時間では24日とする報道もある) | 公式発表 |
| 位置づけ | K3.1シリーズの第1弾。K3のポストトレーニング強化版 | 公式発表 |
| 総パラメータ数 | 約2.8T(「3T級」と表現する報道もある) | 報道値 |
| アーキテクチャ | MoE、エキスパート896個、トークンごとに16個が活性(K3と同系統) | 報道値 |
| アクティブパラメータ | 約104Bとの報道。K3は約50B相当と報じられており食い違いがある | ⏳重み公開待ち |
| コンテキスト長 | 100万トークン(1,048,576) | 公式発表 |
| 入出力 | 入力はテキスト+画像、出力はテキスト | 公式発表 |
| 注意機構 | Kimi Delta Attention(KDA)+Attention Residuals をK3から継承と推定 | ⏳重み公開待ち |
| 重みの形式 | K3はMXFP4重み/MXFP8活性化で約1.4TB。K3.1 Proも同形式かは未確認 | ⏳重み公開待ち |
| 重みの公開時期 | 2026年11月4日までに公開と予告 | 公式発表 |
| ライセンス | 未公表(K3は修正MIT系と報じられた) | ⏳重み公開待ち |
| APIモデルID | kimi-k3.1-pro / kimi-k3.1-pro-highspeed | 公式発表 |
発表と同時に、Kimiアプリ、Kimi Code、APIですぐ利用できる。APIにはゼロデータ保持(Zero Data Retention)オプションがあり、無料プランは利用量に制限がある。Highspeedの利用にはKimi CodeのProプラン以上、100万トークンのコンテキストもKimi CodeではProプラン以上が条件である。
K3からの変更点
| 項目 | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| API入力料金(100万トークン) | $3 | $2(約1/3安い) |
| API出力料金(100万トークン) | $15 | $10 |
| Kimi Code Bench 3.0 | 55.95% | 61.2% |
| Kimi Hallu Bench Hard(主張単位の誤り率、低いほど良い) | 23.4% | 8.3% |
| 社内サイバー攻撃テスト(xdev-bench-hard pass@3) | 33.3% | 81.0% |
| アクティブパラメータ(報道値) | 約50B相当 | 約104B ⏳重み公開待ち |
| 重みの状況 | 公開済み | 11月4日までに公開予定 |
K3.1 Proは、K3に対してポストトレーニングの計算量を大幅に増やし、コーディング、ナレッジワーク、エージェントタスクに焦点を当てた強化学習を追加したものとされる。なお、Moonshotはオープン公開に先立ち、悪用を抑えるためサイバー攻撃関連のデータを学習から除外した。除外前は同テストで90.5%だったが、公開版は81.0%である。ここで重要なのは、K3のリポジトリとK3.1 Proのチェックポイントは別物であり、K3のファイルは流用できない点である。
ベンチマーク
| ベンチマーク | Kimi K3.1 Pro | 比較 | 出典 |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | Claude Opus 5.5が66.4%、GPT-6 Astraが58.2% | 公式発表(自社計測) |
| Terminal-Bench 4.0(独立計測) | 67% | — | Artificial Analysis |
| Kimi Code Bench 3.0(長期タスク) | 61.2% | K3は55.95% | 公式発表(自社計測) |
| BenchCAD(ツールあり) | 92.7% | GPT-6 AstraとClaude Opus 5.5の約4ポイント以内 | 公式発表(自社計測) |
| OfficeQA Pro v2 | 64.4 | MoonshotはAstraとOpus 5.5を上回ると主張 | 公式発表(自社計測) |
| Kimi Hallu Bench Hard(誤り率) | 8.3% | K3は23.4%(低いほど良い) | 公式発表(自社計測) |
| xdev-bench-hard pass@3(サイバー) | 81.0% | 除外前90.5%、K3は33.3%、DeepSeek V4.1-Flashは85.7%(Moonshot集計) | 公式発表(自社計測) |
| Artificial Analysis Intelligence Index | 55(215モデル中4位) | 重み公開後はオープンウェイトで最上位になる見込みと報じられている | Artificial Analysis |
ベンチマークの多くはMoonshot自身の計測値で、独立した検証はArtificial Analysisの数値が中心である。サイバー関連のベンチマークはClaude Opus 5.5やGPT-6 Astraに及ばない。また、VentureBeatは、一部のインフルエンサーが有償関係を開示せずにこのモデルを宣伝していたという指摘を報じている。こうした点からも、導入判断には自社の業務データでの検証と、独立ベンチマークの参照が欠かせない。出力速度は現時点でKimi API上で毎秒約57.5トークン、最初のトークンまで約3.07秒(10月26日時点)である。
API料金
| モデル | 入力 | 出力 | キャッシュ書き込み | キャッシュヒット |
|---|---|---|---|---|
| Kimi K3.1 Pro | $2 | $10 | $2 | $0.20 |
| Kimi K3.1 Pro Highspeed | $4 | $20 | $4 | $0.20 |
| Kimi K3(前世代) | $3 | $15 | $3 | $0.30 |
単位は100万トークンあたり、Kimi公式API。
K3.1 ProはK3より約1/3安い。Artificial Analysisの試算では、ブレンド価格(入力・キャッシュ・出力を7:2:1とした場合)が100万トークンあたり$1.54、Intelligence Indexの1タスクあたりの費用が$2.11である。ただしこのモデルは冗長で、同指標で出力が約1億5,000万トークンと、中央値の約8,700万トークンを大きく上回る。出力が多い用途では、表の単価から想像するより実コストが膨らむ点に注意したい。Highspeedは入出力とも2倍の単価で、Moonshotは2〜3倍高速としている。対話型のコーディング支援など待ち時間が体験に直結する用途に限定し、バッチ処理は通常版を使うのが妥当である。
重みサイズの考え方(なぜ1.4TBになるのか)
MoEモデルは、トークンごとに896個のうち16個のエキスパートしか使わないため、計算量はアクティブパラメータ数で決まる。しかし、どのエキスパートが選ばれるかは入力次第なので、メモリには全エキスパートを常駐させる必要がある。つまりアクティブパラメータの少なさは計算コストを下げるが、必要なメモリは減らさない。2.8Tパラメータを4bit(0.5バイト)で持てば約1.4TBになる、というのが推定の根拠である。K3は量子化を考慮した学習(QAT)でMXFP4重みを前提にしており、約1.4TBの配布サイズもこの形式による。K3.1 Proが同じMXFP4形式で配布されるかは ⏳重み公開待ち であり、別形式なら実際のサイズは大きく変わる。
NVIDIA GPU構成の目安
| 構成 | 合計メモリ | 可否 | 確度 |
|---|---|---|---|
| RTX 5090 ×1 | 32GB | 不可能 | ⏳重み公開待ち |
| H100 80GB ×8 | 640GB | 重みすら載らない | ⏳重み公開待ち |
| H100 80GB ×16 | 1.28TB | 4bitの重みに対して不足 | ⏳重み公開待ち |
| H100 80GB ×64(8ノード) | 5.12TB | K3での実用上の下限。4bit重み+KVキャッシュに余裕あり | ⏳重み公開待ち |
| H200 / B200 クラスタ | 構成次第 | 1枚あたりのメモリが大きい分、必要枚数は減る見込み。台数は公開後に要確認 | ⏳重み公開待ち |
MoonshotはK3で、エキスパート並列とテンソル並列を組み合わせた64基以上のアクセラレータからなる「スーパーノード」構成を推奨し、InfiniBandやNVLink級の相互接続を前提としていた。K3.1 Proでも同様と見るのが自然だが、これも ⏳重み公開待ち である。
Apple Silicon(Mac)での動作
M3 Ultraの512GBメモリでも、1.4TB(推定)⏳重み公開待ち の4bit重みは載らない。512GBのMacを2台つないだ合計1TBでも、4bitには足りない。2bit相当(約700GB)なら2台に収まる可能性はあるが、その品質や速度は未知であり、実用になるかは公開後の検証を待つ必要がある。現時点では、MacでK3.1 Proをローカル実行する現実的な道はないと考えるのが妥当である。
推論エンジン(vLLM・SGLang)の対応
K3の際は、MoonshotがKDAの実装(prefillキャッシュを含む)をvLLMコミュニティに提供し、重みと併せて出す形をとった。K3.1 Proも同じ注意機構を使うなら同様に動く可能性が高いが、対応バージョンの確認が必須である ⏳重み公開待ち。KDAに対応していないエンジンでは、起動はしても出力が不正になる危険がある。また、K3のチェックポイントとK3.1 Proのチェックポイントは別物なので、K3用に用意した変換済みファイルや設定をそのまま使い回すことはできない。公開直後はエンジン側の対応が追いつかない場合もあるため、リリースノートとイシューを確認してから構成を決めたい。
自前ホスト・ホスティング・APIの選び方
| 選択肢 | 特徴 | 向いているケース | 確度 |
|---|---|---|---|
| 公式API | 即日利用可。$2/$10、ゼロデータ保持オプションあり | まず試す、通常の業務利用 | 公式発表 |
| 公式API(Highspeed) | 2〜3倍高速、単価は2倍 | 対話型の開発支援など遅延が重要な用途 | 公式発表 |
| 第三者ホスティング | K3ではTogether AIやModalなどが公開初日に対応した。K3.1 Proの対応は未確認 | 自前クラスタなしでオープンウェイトを使いたい場合 | ⏳重み公開待ち |
| 自社クラスタ | 64基級のGPUと高速相互接続が前提 | データ主権や完全な管理が必要な場合 | ⏳重み公開待ち |
自前ホストを選ぶ最大の理由はデータ主権であり、コストではない。64基級のGPUクラスタの調達・運用費は、API利用料と比べて桁違いになりやすい。データを外部に出せない事情がなければ、まずAPIで品質と実コストを検証し、そのうえで自前運用の必要性を判断する順序が現実的である。
同時期の大型オープンウェイトモデルとの比較
| モデル | 規模 | 重みサイズの目安 | 備考 |
|---|---|---|---|
| Muse Spark Open | 816B-A42B | 約700GB(NVFP4) | — |
| DeepSeek V4.1 Flash | 763B | — | 重み公開済み、MIT |
| MiniMax M3.1 Flash | 428B-A23B | 約250GB(4bit) | — |
| Reflection Beam | 501B | — | — |
| Kimi K3.1 Pro | 約2.8T | 約1.4TB(4bit推定) | ⏳重み公開待ち |
ローカルで動かすことが目的なら、手元のVRAMに収まるモデルを選ぶのが近道である。量子化の選び方は GGUF量子化の選び方 にまとめた。参考として、WASTE推論エンジン はSSDからのストリーミングでK3を29GBのRAMで動かした実験的な取り組みだが、速度は非常に遅く、本番利用には向かない。K3.1 Proで同様に動くかは ⏳重み公開待ち である。
重み公開(11月4日まで)で確認すべき項目
- ライセンス全文(商用利用の可否、再配布、利用制限の条件)
- アクティブパラメータ数(約104Bか、K3並みの約50B相当か)
- 重みの形式とファイルサイズ(MXFP4か、他の形式か)
- vLLM・SGLangのKDA対応バージョン
- 公開初日にホスティングを提供するプロバイダの顔ぶれ
- 画像エンコーダのサイズと、画像入力時の追加メモリ
トラブルシューティング
- ロード時にOOM(メモリ不足)になる場合: 重みが合計メモリに収まっているかを先に確認する。KVキャッシュと画像エンコーダの分の余裕も必要で、コンテキスト長を短くして再試行する
- KDA非対応のエンジンで出力がおかしい場合: エンジンのバージョンを確認し、KDA対応版へ更新する。K3用の設定やチェックポイントは流用しない
- ノード間帯域が足りず遅い場合: エキスパート並列の通信がボトルネックになる。InfiniBandやNVLink級の相互接続を前提に構成を見直す
- 冗長な出力でコストが膨らむ場合: 出力長の上限を設け、プロンプトで簡潔な回答を指示する。出力トークン数を計測して実コストを把握する
- 無料プランで制限に当たる場合: 利用量の上限に達している。Highspeedや100万トークンのコンテキストはKimi CodeのProプラン以上が必要
社内で中国系モデルのAPIを使う際のデータの扱いや、オープンウェイトモデルの自社運用を検討する場合は、AIコンサルティングでも相談を受け付けている。
よくある質問
いつ手元で動かせるようになりますか?
重みは2026年11月4日までに公開すると予告されている。ただし、公開されても4bitで約1.4TB(推定)⏳重み公開待ち が必要で、手元のPCで動かせるわけではない。64基級のGPUクラスタが実用上の下限になる見込みである。
RTX 5090やMacで動きますか?
動かない。RTX 5090の32GBでは重みの一部も載らず、512GBのMac(M3 Ultra)でも4bitの重みは入らない。2台を合わせた1TBでも不足し、2bit(約700GB)なら入る可能性はあるが、品質と速度は未知である ⏳重み公開待ち。
K3との違いは?乗り換えるべきですか?
K3.1 ProはK3のポストトレーニング強化版で、Kimi Code Bench 3.0が55.95%から61.2%に、ハルシネーション率が23.4%から8.3%に改善した。料金も入力$3から$2、出力$15から$10へ下がった。APIで使うなら基本的に乗り換えてよいが、出力が冗長になりやすい点は自社データで確認したい。
API料金はK3より安いですか?実コストの注意点は?
単価はK3の約1/3安い(入力$2、出力$10)。ただしArtificial Analysisの計測では、このモデルは同指標で出力が約1億5,000万トークンと、中央値の約8,700万トークンより多い。出力が多い用途では、単価の差ほど安くならない可能性がある。
Highspeedとの違いは?
Highspeed(kimi-k3.1-pro-highspeed)は、Moonshotによれば2〜3倍高速で、単価は入力$4、出力$20と通常版の2倍である。Kimi CodeではProプラン以上が必要。対話型の用途に絞り、バッチ処理は通常版を使うのが妥当である。
商用利用できますか?
APIの商用利用は規約の範囲で可能だが、オープンウェイトとしてのライセンスは未公表である ⏳重み公開待ち。K3は修正MIT系と報じられたが、K3.1 Proも同じとは限らない。重み公開時にLICENSEの全文を必ず確認すること。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ