MiniCPM-V 4.7 必要スペック早見表
35B-A3BはVRAM約20GB(4bit)、iPhoneで3GB動作【2026年版】
MiniCPM-V 4.7 35B-A3B(Apache-2.0)の必要VRAMを推定で解説。4bitは約20〜22GBでRTX 4090/5090や32GB Macが目安、BF16は70GB超。iPhone3GB動作の仕組み、vLLM・GGUFでの使い方、メモリ不足(OOM)の対処も整理。2026年10月更新。
MiniCPM-V 4.7 35B-A3Bは、画像・複数画像・文書・動画を理解するオープンウェイトのマルチモーダルモデルで、4bit量子化なら必要メモリは推定20〜22GB前後。 RTX 4090(24GB)やRTX 5090(32GB)、32GBのユニファイドメモリを積んだMacで動かせる見込みだ。BF16なら推定70GB超でH100 80GBクラス、FP8なら推定36GB前後で48GBクラスのGPUが目安になる。OpenBMBが2026年10月12日に公開し、ライセンスはApache-2.0で商用利用できる。
ただし、公式のモデルカードにはPC向けのVRAM要件もコンテキスト長も明記されていない。本記事のメモリ数値は、公式が公開している事実(35B総パラメータ・活性約3B、配布形式、ライセンス、公式コマンド)をもとにした「推定」であり、パラメータ数 × 1パラメータあたりのバイト数に、ビジョンエンコーダとKVキャッシュの余裕を加えて算出している。iPhoneで3GB動作という公式の主張は特殊な仕組みによるもので、PCで同じメモリ量に収まるわけではない点も後半で整理する。
必要スペック早見表
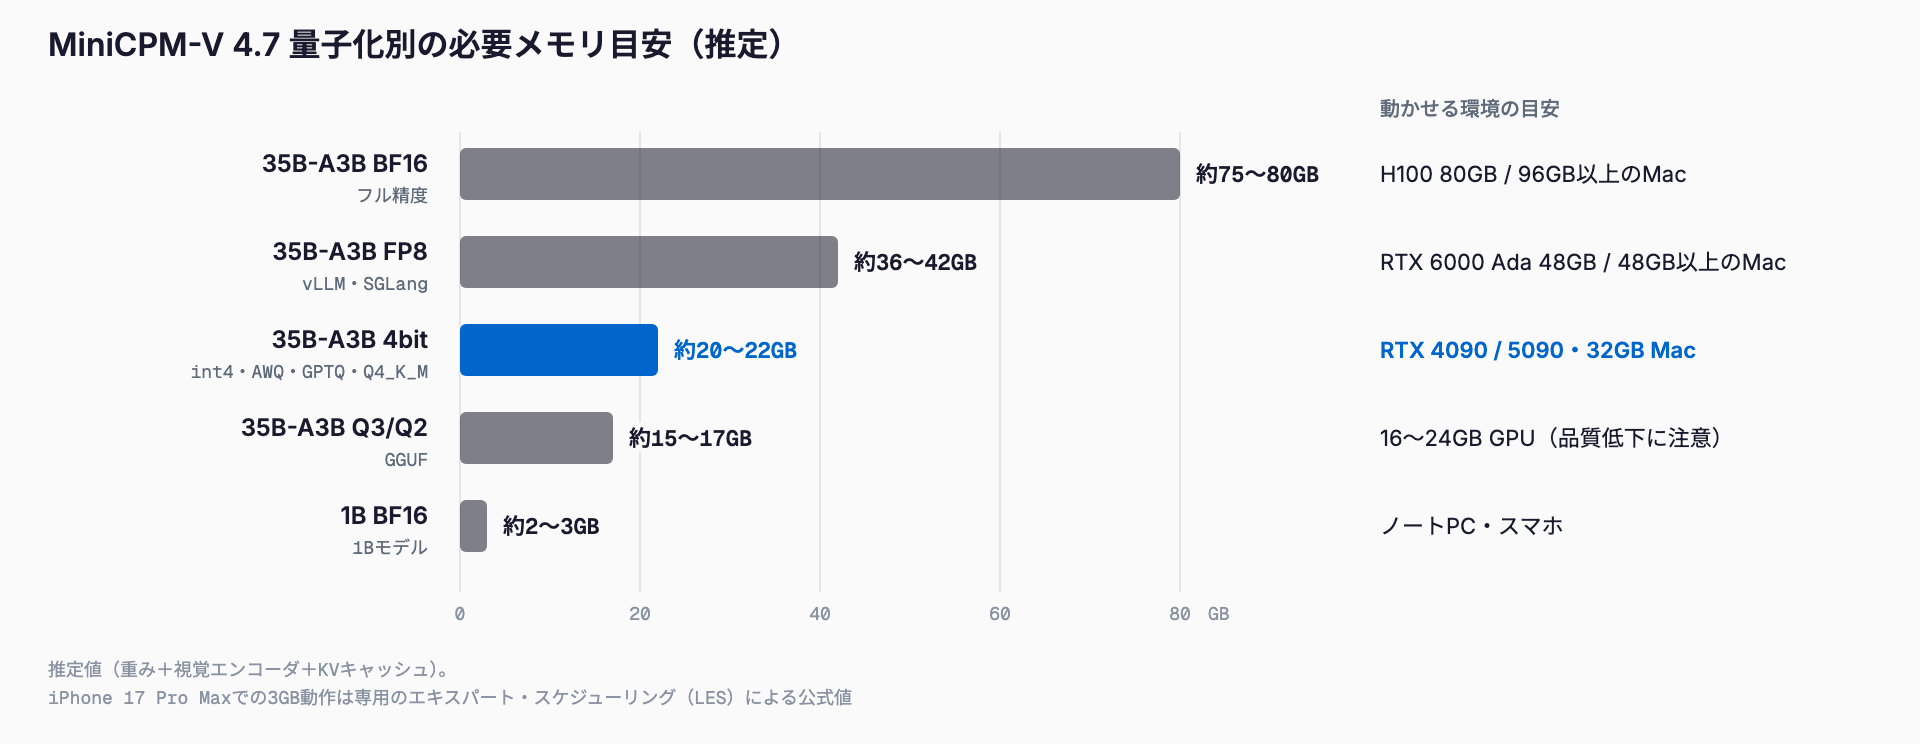
35B-A3Bと1Bモデルの推定値をまとめる。「重みのみ」はパラメータ数 × バイト数、「実用目安」はそこにビジョンエンコーダ(mmproj)約1GBと、KVキャッシュ・画像トークンの数GBを加えた値である(いずれも推定)。
| モデル | 精度 | 重みのみ(推定) | 実用目安(推定) | 目安の環境 |
|---|---|---|---|---|
| 35B-A3B | BF16 | 約70GB | 約75〜80GB | H100 80GB、96GB以上のMac、複数GPU |
| 35B-A3B | FP8 | 約35GB | 約36〜42GB | RTX 6000 Ada 48GB、24GB×2、48GB以上のMac |
| 35B-A3B | 4bit(int4・AWQ・GPTQ・GGUF Q4_K_M) | 約18〜20GB | 約20〜22GB(推定) | RTX 4090 24GB、RTX 5090 32GB、32GB Mac |
| 35B-A3B | GGUF Q3/Q2系 | 約13〜16GB | 約15〜17GB(推定) | 16〜24GBのGPU(品質低下に注意) |
| 1B | BF16 | 約2GB | 約2〜3GB | 一般的なノートPC、スマートフォン |
| 1B | 4bit | 1GB未満 | 1GB前後 | スマートフォン、CPU推論 |
手元のGPU・Macで動くかをすぐ確かめたい場合は、モデル・量子化・コンテキスト長を選ぶだけで必要VRAMを試算できるVRAM計算ツール(無料・登録不要)も用意している。MiniCPM-V 4.7もモデル一覧から選択できる。
4bit行の数値はあくまで目安である。GGUFのQ4系はレイヤーごとにビット幅が異なるため、実ファイルは上の計算より数GB大きくなることがある。ダウンロード前に配布ファイルの実容量を確認してほしい。また、公式にコンテキスト長が示されていないため、長い文書や多数の画像、動画を一度に入力する運用ではKVキャッシュがさらに増える前提で余裕を見ておく必要がある。
MiniCPM-V 4.7とは
MiniCPM-V 4.7は、中国のOpenBMBが公開しているマルチモーダルモデル「MiniCPM-V」シリーズの最新世代である。2026年10月12日に公開され、10月15日には推測的デコーディング(speculative decoding)用のドラフトヘッド「DSpark」が追加された。サイズは35B-A3Bと1Bの2種類で、35B-A3Bはシリーズ初のMoE(Mixture of Experts)モデルであり、総パラメータ約35B、1トークンあたりの活性パラメータは約3Bとされる。
| 項目 | 内容 |
|---|---|
| 開発元 | OpenBMB |
| 公開日 | 2026年10月12日(DSparkヘッドは10月15日追加) |
| サイズ | 35B-A3B(MoE、総35B/活性約3B)、1B |
| 入力 | 画像、複数画像、文書、動画 |
| ビジョンエンコーダ | SigLIP2 |
| 視覚トークン圧縮 | 4倍/16倍の混合圧縮、ViT内の早期圧縮(LLaVA-UHD v4由来) |
| 言語バックボーン | Qwen3.5/Qwen3.6系とされる(どちらかは明記なし) |
| ライセンス | Apache-2.0 |
| コンテキスト長 | 公式には明記なし |
特徴は視覚トークンの圧縮である。画像や動画をそのままトークン化すると入力長が膨れ上がるが、MiniCPM-V 4.7は4倍と16倍の圧縮を混ぜて使い、さらにビジョンエンコーダ(ViT)の内部で早期に圧縮することで、画像理解にかかる計算量とKVキャッシュを抑える設計になっている。これは文書や動画のように視覚トークンが多くなる用途で、メモリと速度の両面に効く。
さらに、OpenBMBはSRFT(Self-Replay Fine-Tuning)と呼ぶ学習手法をオープンソースとして公開している。本記事ではSRFTの中身には立ち入らないが、重みだけでなく学習手法も公開されている点は、自社データで調整したい場合の材料になる。
開発元の主張とベンチマーク
OpenBMBは、35B-A3B(Instruct)がQwen3.6 35B-A3Bより短い推論時間で高い総合スコアを出すと主張している。また1Bモデルは、Qwen3.5 0.8Bを大きく上回ると説明している。ただし、これらの比較は公式ページのチャート画像で示されており、テキストの表としては数値が公開されていない。そのため、本記事では公式の具体的なスコアを引用しない。
参考として、第三者の集約サイトDataLearnerは、MMStar 80.67、OCRBench 91.20、MMMU 80.22という数値を掲載している。これは非公式の集計値であり、評価条件や設定が開発元の主張と一致するとは限らない。自社の用途(帳票、図面、スクリーンショットなど)で必ず自分のデータを使って検証してほしい。
iPhoneで3GB動作の仕組み(LES)とPCでの違い
公式は、35B-A3BがiPhone 17 Pro Maxで、わずか3GBのメモリで毎秒13トークン以上のデコード速度を出すと主張している。これを可能にしているのが、Lookahead Expert Scheduling(LES)と呼ばれる仕組みで、実機で約5倍の高速化になるとされる。対応プラットフォームはiOS、Android、HarmonyOSで、チップはIntel、AMD、Arm、Rockchip、Houmoが挙げられ、OpenVINOはday-0で対応している。
ここで重要なのは、これが通常の「重みを全部メモリに載せて動かす」推論ではないことだ。MoEでは1トークンごとに使われるエキスパートは一部だけなので、先読みして必要なエキスパートだけをストレージからメモリへ読み込み、使い終わったものを手放すというスケジューリングを行えば、常駐メモリを大きく減らせる。LESはこの種の特殊なエキスパート・スケジューリング(ストリーミング)技術であると理解するのが妥当で、本記事では内部の詳細までは公式情報がないため踏み込まない。
したがって、PCでllama.cppやvLLMを使う通常の運用では、全重みを載せる前提で計画するのが安全である。3GBという数字をPCのVRAM要件と読み替えてはいけない。ストレージからの読み出し帯域に依存する方式なので、PC側で同様の挙動を得るには、公式が提供する対応ランタイムが必要になると考えるのが自然だ(この点は推定である)。
MoEなのに総35B分のメモリが要る理由
MoEは1トークンあたり約3B分の計算しかしないため、速度は3Bクラスのdenseモデルに近づく。しかしどのエキスパートが選ばれるかはトークンごとに変わるため、通常の運用ではすべてのエキスパートをすぐ使える場所に置いておく必要がある。結果として、メモリ容量は総パラメータ数(35B)で決まり、計算速度は活性パラメータ数(約3B)で決まる、という二つの軸で考えることになる。
この性質のおかげで、GPUに載り切らない分をCPUメモリへ逃がす「CPUオフロード」が実用になりやすい。エキスパートの重みをメインメモリに置き、注意機構などの共通部分だけをGPUに置けば、1トークンあたりに転送・計算するのは約3B分で済む。16GB級のGPUと64GB程度のメインメモリの組み合わせでも、速度を犠牲にして動かせる可能性がある(推定)。
GPU別・Apple Silicon・CPUオフロードの目安
- RTX 4090(24GB):4bit(推定20〜22GB)が収まるが、コンテキストや画像が増えると余裕は小さい。長い入力ではQ3系かCPUオフロードの併用を検討する
- RTX 5090(32GB):4bitなら画像・文書を複数入れても余裕がある。FP8(推定36GB前後)は載らない
- RTX 6000 Ada/A6000(48GB):FP8が収まる。品質重視で単体GPU運用をしたい場合の目安
- H100 80GB:BF16(推定70GB超)が収まるが、KVキャッシュの余裕は大きくない
- 24GB×2枚:FP8をテンソル並列で分割する構成が考えられる
- Apple Silicon:ユニファイドメモリ32GBで4bit、64GBで余裕のある4bit〜FP8、96GB以上でBF16が目安(推定)。OSや他アプリの分を差し引くこと
- CPU推論:GGUFはCPU推論に対応する。メインメモリに全重みが載ればよいが、速度は大幅に落ちる
他のモデルでの同様の見積もりは、Holo4-35B-A3Bの必要スペック記事やGemma 4のハードウェア要件記事にもまとめている。同じ35B-A3Bクラスなので、メモリの感覚は近い。
使い方(vLLM/SGLang/Transformers/Docker/Ollama/llama.cpp)
モデルカードに掲載されている公式の起動方法は次のとおりである。なお、ここに示すコマンドは起動の入口であり、GPUメモリに合わせたオプション調整は別途必要になる。
- vLLM:pip install vllm のあと vllm serve "openbmb/MiniCPM-V-4.7-35B-A3B"
- SGLang:python3 -m sglang.launch_server --model-path "openbmb/MiniCPM-V-4.7-35B-A3B" --host 0.0.0.0 --port 30000
- Transformers:pip install "transformers[serving]>=5.18.0" のあと transformers serve openbmb/MiniCPM-V-4.7-35B-A3B --port 8000 --host 0.0.0.0
- Docker Model Runner:docker model run hf.co/openbmb/MiniCPM-V-4.7-35B-A3B
- Ollama:ollama.com/openbmb/minicpm-v4.7 に公式ページがある。具体的なタグは本記事執筆時点で確認できていないため、公式ページのタグを確認してほしい
- llama.cpp:GGUF形式で対応している。公式のコマンド例は示されていない
llama.cppで使う場合の例(公式の記載ではなく一般的な書き方の例)として、画像入力にはGGUF本体に加えてmmprojファイルが必要になる。たとえば llama-server -m MiniCPM-V-4.7-35B-A3B-Q4_K_M.gguf --mmproj mmproj.gguf -ngl 99 のように起動し、メモリが足りなければ -ngl を下げる、あるいはエキスパートのCPUオフロード系オプションを併用する。ファイル名やオプションは使用するllama.cppのバージョンと配布ファイルに合わせて確認してほしい。
ローカルLLMの動かし方に慣れていない場合は、GUIで扱えるOllamaとLM Studioの比較記事も参考になる。DSparkのドラフトヘッドはBF16とGGUFで配布されており、推測的デコーディングで生成を速めたい場合に使える。ただしドラフトヘッドぶんのメモリが追加で必要になる点に注意してほしい。
配布形式は、35B-A3BがBF16、FP8、int4、AWQ、GPTQ、GGUFで、Hugging Face上に量子化派生が54件ある。1BはBF16、int4(bitsandbytes)、AWQ、GPTQ、GGUFである。AWQとGPTQはいずれもW4A16(重み4bit・活性16bit)方式である。
1Bモデルの位置づけ
1Bモデルは、スマートフォンやCPUのみの環境、組み込み機器での利用を想定したサイズである。重みはBF16で約2〜3GB、4bitなら1GB未満の見込み(推定)で、一般的なノートPCやスマートフォンでも動かしやすい。公式は、Qwen3.5 0.8Bを大きく上回ると主張している。
35B-A3Bは精度重視、1Bは端末内で完結させたい用途という使い分けになる。画像を外部に送りたくない現場写真の仕分けや、オフラインでの簡易な文書読み取りでは1Bを、複雑な文書や図表の読解では35B-A3Bを試す、といった形だ。小型モデルの要件は、MiniCPM5 2Bの記事でも整理している。
既存モデルとの違い
| 項目 | MiniCPM-V 4.7 35B-A3B | Qwen3.6 35B-A3B | Holo4-35B-A3B | Gemma 4 | MiniCPM-V 4.7 1B |
|---|---|---|---|---|---|
| 構造 | MoE(総35B/活性約3B) | MoE(35B-A3B) | MoE(総35B/活性約3B) | — | 1B |
| 主な用途 | 画像・文書・動画理解 | — | computer-use(PC操作) | — | 端末内の軽量マルチモーダル |
| ライセンス | Apache-2.0 | — | Apache-2.0(35B-A3B) | — | Apache-2.0 |
| コンテキスト長 | 非公表 | — | 262,144トークン | — | 非公表 |
| 4bitの必要メモリ(推定) | 約20〜22GB | — | 約20GB | — | 1GB未満 |
表の「—」は、本記事で確かな根拠を確認していない項目である。比較の要点は、同じ35B-A3Bクラスでも用途が異なることだ。Holo4は画面を見てPCを操作するcomputer-use向けで、MiniCPM-V 4.7は画像・文書・動画の理解に重きを置き、さらにスマートフォンでの動作を前面に出している。メモリの感覚はほぼ同じなので、用途で選ぶのがよい。
商用利用・ライセンス
MiniCPM-V 4.7のライセンスはApache-2.0で、モデルカードに追加の利用条件は書かれていない。Apache-2.0は商用利用、改変、再配布を認める寛容なライセンスで、著作権表示とライセンス文の同梱などが求められる。社内システムへの組み込みや自社サービスでの利用に使いやすい。
ただし、ライセンスが寛容でも、入力する画像や文書に個人情報・機密情報が含まれる場合の扱いは別問題である。クラウドAPIに送らずローカルで完結できる点はこのモデルの利点だが、保存先や社内の取り扱いルールは自社で決める必要がある。最終的な利用条件は、公開時点のモデルカードで必ず確認してほしい。
トラブルシューティング(メモリ不足)
- 起動時にOOM:精度を一段下げる(BF16→FP8→4bit)。それでも載らなければQ3系GGUFか、エキスパートのCPUオフロードを使う
- 画像を入れると落ちる:画像の解像度や枚数を減らす。ビジョンエンコーダ分と画像トークンのKVキャッシュが追加で必要になる
- 長い文書や動画で落ちる:コンテキスト長の上限を下げて起動する(vLLMなら --max-model-len など)。公式にコンテキスト長の記載はないため、実機で上限を探る
- 速度が極端に遅い:重みの一部がCPUやストレージに逃げている可能性がある。GPU常駐の割合を確認する
- iPhoneの数値と合わない:3GBはLESによる特殊な動作で、通常のPC推論の要件ではない
- 品質が落ちた:Q2系は劣化が目立ちやすい。可能なら4bit以上を使う
まとめ
MiniCPM-V 4.7 35B-A3Bは、4bitなら推定20〜22GB、FP8なら約36GB、BF16なら70GB超が目安のマルチモーダルMoEモデルである。RTX 4090/5090や32GB Macで実用圏に入り、Apache-2.0で商用利用もできる。活性が約3Bなのでdenseの35Bより速い一方、メモリは総パラメータ分が必要になる点は忘れないでほしい。
iPhoneで3GBという公式の数字は、LESという特殊なエキスパート・スケジューリングによるもので、PC運用の要件ではない。1Bモデルは端末内完結の用途に向く。いずれも公式にコンテキスト長が書かれていないため、導入前に自分の入力で実測し、余裕を持った構成を選ぶのが確実である。
よくある質問
MiniCPM-V 4.7 35B-A3Bを動かすのに必要なVRAMはどれくらいですか。
公式にPC向けの要件は明記されていないが、推定ではBF16が70GB超、FP8が約36GB、4bit(int4・AWQ・GPTQ・GGUF Q4_K_M)が約20〜22GBである。4bitならRTX 4090(24GB)やRTX 5090(32GB)、32GBのMacが目安になる。
iPhoneで3GBで動くなら、PCでも3GBで動きますか。
動かない。公式の主張は、Lookahead Expert Scheduling(LES)というエキスパートを先読みして入れ替える特殊な仕組みによるもので、通常の推論ではない。llama.cppやvLLMで使う場合は全重みを載せる前提で計画する。
MoEで活性が約3Bなら、メモリも3B分で足りますか。
足りない。計算量は活性パラメータ(約3B)で決まるが、どのエキスパートが選ばれるかはトークンごとに変わるため、通常は総パラメータ(35B)分をメモリに置く必要がある。CPUオフロードで一部をメインメモリに逃がす方法はある。
商用利用はできますか。
ライセンスはApache-2.0で、モデルカードに追加条件は書かれていないため、商用利用できる。ただし著作権表示などApache-2.0の条件は守る必要があり、最終的な条件は公開時点のモデルカードで確認してほしい。
コンテキスト長はいくつですか。
公式のモデルカードには明記されていない。長い文書や動画を入れる場合はKVキャッシュが増えるため、実機で上限を確かめ、余裕を持ったメモリ構成にするのが安全である。
この記事に関連する無料ツール(登録不要・その場で結果)
お気軽にご相談ください
お問い合わせ